数据与环境
Agentic RL 的数据不是静态问答对,而是带环境版本、状态变化、工具结果和终止原因的轨迹。若这些信息不可重放,训练集就无法审计。
轨迹模式
episode_id
task_spec
environment_image / commit / seed
policy_version
observation_0
action_0
tool_result_0
...
terminal_state
reward_components
verifier_version
cost
工具返回的完整原始内容可能很大,也可能含敏感信息。训练存储应保留可重建的结构化字段、必要哈希与脱敏摘要,而不是无边界复制日志。
任务来源
| 来源 | 优点 | 风险 |
|---|---|---|
| 人工编写 | 目标清晰、可控 | 规模小、风格单一 |
| 真实历史任务 | 分布真实 | 隐私、许可与不可重复状态 |
| 模板生成 | 覆盖系统化 | 容易被模板特征泄漏 |
| 模型自生成 | 扩展快 | 错误累积、难度虚假 |
| 程序化环境 | 自动验证 | 任务空间可能过窄 |
| curriculum | 可控制难度 | 难度指标不一定等于能力 |
合成数据应使用独立 verifier,并保留生成模型与筛选规则,否则 student 可能只学习 teacher 的格式偏差。
用知识图谱扩展任务覆盖
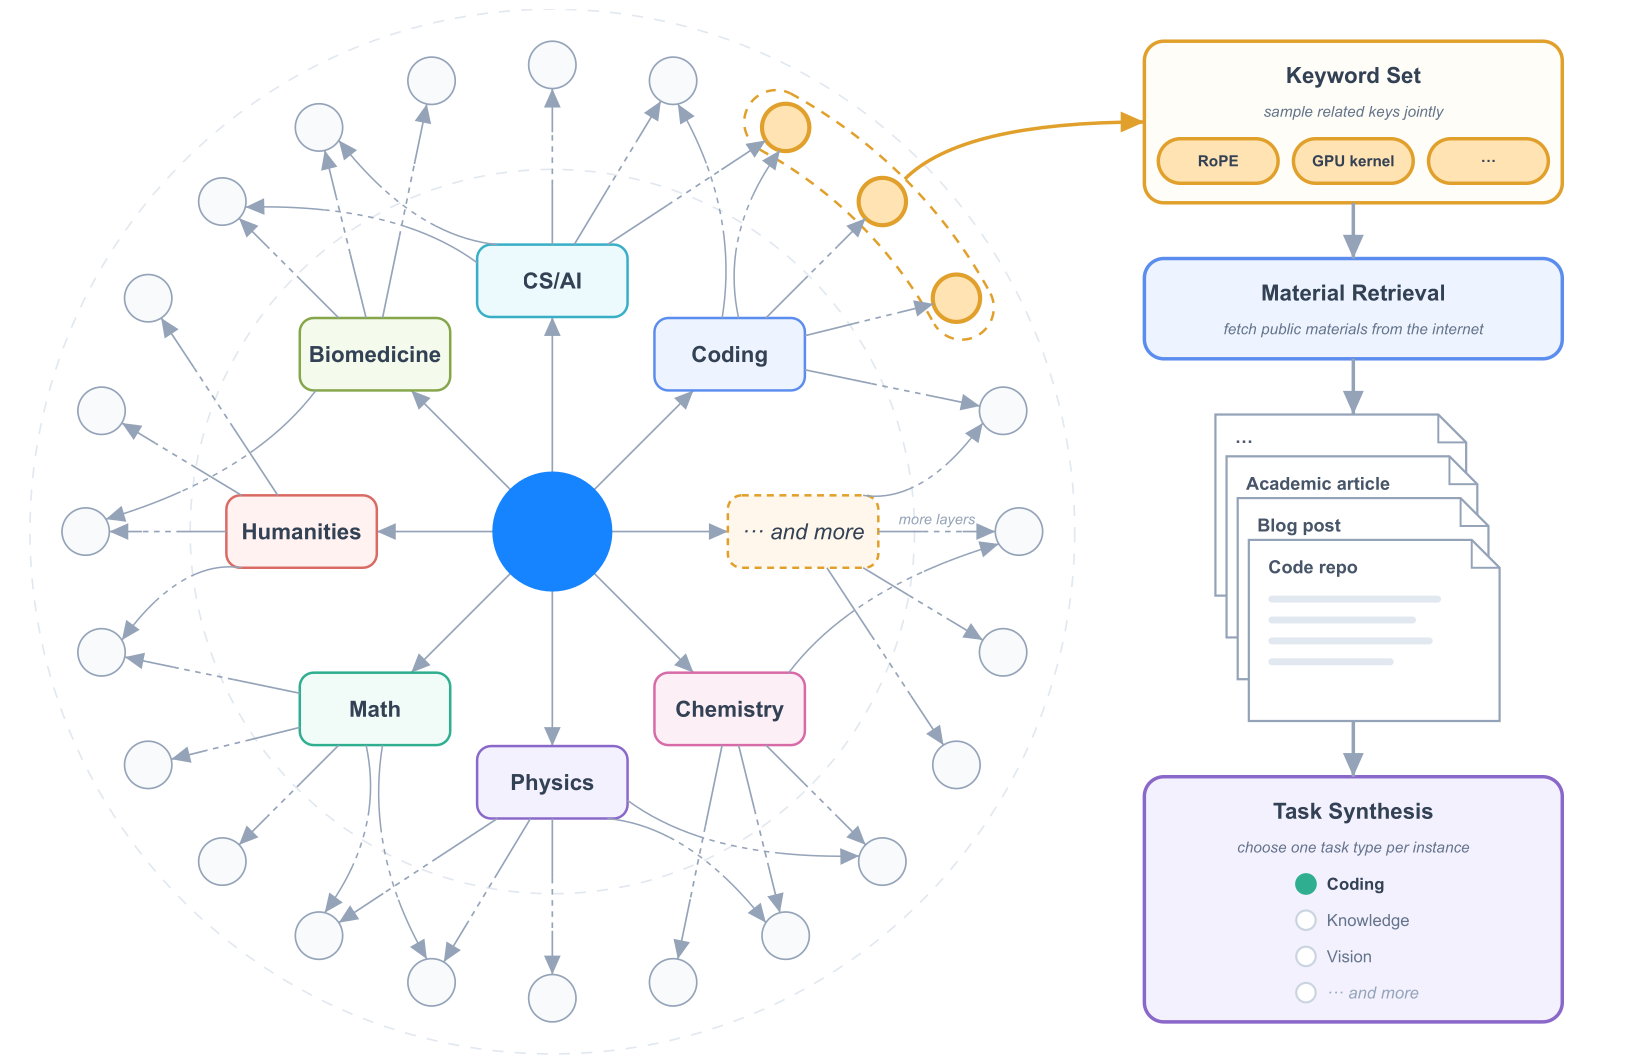
开放域任务若只从独立关键词采样,很容易得到主题重复、依赖关系浅的样本。一个更系统的合成管线可以先构造层级知识图谱:
seed domain
  -> search and propose coarse concepts
  -> deduplicate nodes and edges
  -> recursively expand non-atomic nodes
  -> stop at independently testable concepts
  -> sample related nodes with ancestor context
  -> retrieve public evidence
  -> synthesize task and independent verifier
这相当于在概念 DAG 上结合 breadth-first 的覆盖与 depth-first 的细化;停止条件应由“是否能独立提出并验证任务”决定,而不是固定深度。Kimi K3 技术报告披露了这种 coarse-to-fine、递归多 agent 的知识图谱合成实例。可迁移的是节点去重、祖先上下文、公开证据和独立验证四个边界,不能把生成图自身当成事实源。整体方法见 Kimi K3。
环境的四类状态
- 静态状态:代码仓库、文档、数据库快照;
- 可变状态:文件编辑、进程、浏览器页面、游戏局面;
- 外部状态:API、网络服务、时间和第三方数据;
- 权限状态:可读、可写、需确认与禁止动作。
只有静态快照通常可完全重放。外部服务应使用版本化模拟器、录制回放或明确的在线评测窗口。
持久环境
个人助理、项目协作和长时软件任务的状态会跨轮次、跨天变化。此类环境不应每个 episode 都重置为同一空壳,而应把 mock 邮件、知识库、消息、画布或文件系统作为有版本的 persistent state,并让日历事件、用户消息和后台变化按 seed 注入。训练记录必须区分:
- agent 产生的副作用;
- 模拟器自主产生的事件;
- evaluator 的只读观察;
- checkpoint/fork 后继承或隔离的状态。
K3 报告描述了一组可跨模拟天、数千次工具调用和百万级上下文推进的持久助理环境。这些量级是团队报告的工程实例,不等于公开 benchmark;真正可复用的是环境状态机、确定性事件源和跨 checkpoint 的终态验证。
DSec:按任务选择隔离基底
DeepSeek-V4 披露的 DSec 以 Rust Apiserver、Edge、Watcher 和 3FS 协调四类执行环境:
| 基底 | 适合 | 主要边界 |
|---|---|---|
| Function Call / 预热容器 | 受控轻任务 | 最快,但自由度与隔离最低 |
| Docker + EROFS | 常规 Linux 工具链 | 容器边界、只读镜像按需取块 |
| Firecracker microVM | 多租户高风险执行 | 更强隔离与 snapshot 成本 |
| QEMU full VM | 完整 OS / 特殊内核 | 兼容性强,资源成本最高 |
镜像 metadata 可本地驻留,数据块从 3FS 按需获取;microVM 通过 OverlayBD 共享远端只读 base layer,只把 copy-on-write 增量留在本地。chainable snapshot 让后续环境基于已有状态继续。
DSec 用全序 trajectory log 记录状态变更与结果。所谓 deterministic replay 不是假设外部命令每次都产生同一输出,而是在重放时复用已提交结果,避免重复执行非幂等动作;同一日志还支持 client fast-forward 和细粒度 provenance。报告给出数十万并发与毫秒级恢复的内部系统描述,但没有公开完整实现、故障注入或安全审计结果。系统链见 MegaMoE、TileLang 与 DSec。
工具契约
动作空间最好是结构化 schema,而不是从自然语言中猜测命令:
训练时需统一:
- 工具名、参数类型与错误码;
- stdout/stderr 截断规则;
- 超时、重试与幂等语义;
- 路径、网络和写权限;
- 结果是否进入下一轮上下文。
工具 schema 变更会造成 environment drift,应与模型和轨迹共同版本化。
White-box harness
Agent 的可观察行为由模型与 scaffold 共同生成。若训练系统能够组合 system prompt、工具集合、context management、skills、memory 和 subagent,就可以在 rollout 时显式采样 harness,而不是把某个前端固化成唯一环境。K3 报告称其同一训练框架可实例化 Kimi Code、Claude Code、Codex、OpenClaw 与 Hermes 一类界面;这支持的结论是“harness 应成为版本化实验变量”,不代表这些实现拥有相同协议或能力。
每条轨迹除模型 revision 外,还要记录 harness component digest。训练集可在若干合理 scaffold 间变化,held-out 则保留未见组合,以测量模型是否依赖某个 prompt、tool alias 或压缩器的偶然特征。
Verifier
强 verifier 直接判断目标状态,如单元测试、形式证明、棋局结果或数据库约束。弱 verifier 依赖模型评分或启发式。
Verifier 至少要测试:
- soundness:通过是否真的意味着正确;
- completeness:正确解是否可能被误拒;
- isolation:agent 能否读取答案或修改评分器;
- determinism:相同状态是否得到一致结果;
- coverage:是否只测到表面格式。
若 agent 可以修改测试文件,奖励函数就必须从受保护环境运行;否则“全部通过”可能只是 reward hacking。
Agent Evaluation Task
可验证 agent 任务可以抽象为五元组
其中 \(s_0\) 是初始状态,\(g\) 是受约束目标,\(\mathcal A\) 是工具动作空间,\(B\) 是 token/步骤/提交预算,\(V\) 是独立 verifier。关键不是提供一条参考轨迹,而是让 agent 在预算内自行探索,再由 \(V\) 读取终态。K3 报告将其称为 Agent Evaluation Task(AET),并强调 verifier 与 agent 隔离、公开测试与隐藏测试并存、限制提交次数;这些约束同样适用于训练环境。
Kernel 生成是强 verifier 的一个代表:任务可跨 CUDA、Triton、CuTe 等 DSL 和 BF16/FP8/FP4 dtype,先以数值阈值判定正确,再按相对专家实现或 roofline 给效率奖励。必须防止 agent 通过复用输入缓存、降低精度或操纵计时绕过目标;CUDA Graph replay、随机输入与隐藏 shape 应在 agent 权限之外。
数据筛选
轨迹质量不等于最终奖励。应同时考虑:
- 成功轨迹提供正例,失败轨迹可训练恢复和批判;
- 极短成功可能是答案泄漏,极长成功可能包含大量无效探索;
- 相似任务与相似推理应去重;
- 同一任务保留多种策略有助于组相对训练;
- 工具或环境故障应与策略失败分开标注。
Curriculum
难度可以由最短操作数、依赖深度、状态空间、工具数量或基线成功率定义。实用 curriculum 往往按当前策略成功率采样:
其中 \(\hat s_i\) 是任务 \(i\) 的近期成功率,\(g\) 提高“既非必胜也非全败”的任务权重。过度追逐边界样本可能遗忘基础能力,因此需保留 replay mixture。
数据切分与污染
- 按仓库、题族、时间或生成模板分组切分,而非随机切轨迹;
- 防止同一 issue 的修复、fork 或镜像跨 train/test;
- 检查 benchmark 答案、隐藏测试和 verifier 源码是否进入上下文;
- 时间切分必须冻结依赖与外部服务,否则难度变化不可归因;
- 报告模型是否能访问互联网、包管理器和历史 commit。
token/action mask、旧策略概率和终止字段见轨迹与策略契约,训练算法见数学与算法,过程数据生成见搜索、过程奖励与验证,安全与评测见评测与安全。
GLM-5:三条环境扩展线
GLM-5 把环境扩展拆成三种互补来源:
- 基于真实 issue–PR 与 RepoLaunch 构建超过 10K 个可执行 SWE 环境,覆盖九种语言;
- 从真实种子或高质量网页合成 Harbor terminal task,经构建、测试与 refine agent 自验证;
- 从超过两百万网页构造 Web Knowledge Graph,生成多跳搜索问题,再用无工具模型、早期 Agent 与 verification agent 三层过滤。
真实任务提供自然分布,合成任务补覆盖,知识图任务增加关系深度;三者的 provenance、去重和 verifier 信任边界不能合并。尤其“Docker 构建准确率超过 90%”只说明构建管线表现,不证明题意、测试与隐藏捷径全部正确。环境到训练的完整闭环见 GLM Agentic Engineering。
Reference
- RLDS: an Ecosystem to Generate, Share and Use Datasets in Reinforcement Learning
- AgentBench: Evaluating LLMs as Agents
- SWE-bench: Can Language Models Resolve Real-World GitHub Issues?
- Datasheets for Datasets
- AgentENV
- Kimi K3 Technical Report
- Fire-Flyer File System (3FS)
- Firecracker: Lightweight Virtualization for Serverless Applications
- EROFS: A Compression-friendly Readonly File System
- DADI / OverlayBD
- DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
- RepoLaunch
- Harbor
- GLM-5: from Vibe Coding to Agentic Engineering