状态、动作与策略
机器人策略的神经网络可以很复杂,真正决定它能否落地的却常是更基础的接口:模型看到了哪一刻的状态,动作在哪个坐标系里,以什么频率执行,一次输出一步还是一段轨迹。动作 loss 只有在这些语义固定后才有意义。
状态不是一张图
部分可观测环境中,策略需要 belief 或历史:
其中视觉给出对象与空间,本体感知 \(q_t\) 给出关节和执行器状态,历史动作帮助区分“物体自己移动”和“机器人刚刚推动了它”。触觉、力矩与深度是否必要取决于任务;折叠、插接和抓取接触通常无法只靠单帧外部相机可靠判断。
时间必须来自 timestamp 而不只是数组下标。若训练为 10 Hz、部署为 30 Hz,同一个 delta action 会产生不同速度;若图像比本体状态晚 100 ms,拼接后的“状态”可能从未真实存在过。
先写清 action contract
一个连续动作块可写为
但 shape 远远不够。每个维度还要声明:
- 控制量:absolute pose、delta pose、joint position、velocity、torque;
- 坐标系:world、robot base、end-effector、camera、object-relative;
- 单位:m、rad、m/s、rad/s;
- 时间:控制周期、timestamp、chunk 中每一步的间隔;
- 范围:训练 normalization 与部署物理边界;
- 离散维:gripper、mode、terminate 的编码;
- 执行:整块执行还是 receding horizon;
- 中止:新观察、碰撞、通信超时怎样取消旧 chunk。
齐次坐标变换
只是起点。旋转表示、左/右乘、四元数顺序和 delta 所在 frame 都要版本化。固定方向偏差通常是标定或坐标错误,不是模型“不够聪明”。
Behavior cloning:把示范变成策略
离散动作的 behavior cloning 为
连续 MSE
等价于固定方差、单峰高斯的负对数似然。若“从左抓”和“从右抓”都能成功,平均动作可能正好撞到物体中间;多峰任务需要 mixture、离散 token、diffusion 或 flow 等分布模型。
Behavior cloning 的更深问题是 covariate shift:训练观察来自 expert,部署观察来自 learner。一步错误率为 \(\epsilon\) 时,朴素分析中的长程代价可能按 \(O(T^2\epsilon)\) 累积,而不只是 \(O(T\epsilon)\)。
DAgger:训练模型处理自己造成的状态
DAgger 反复执行:
- rollout 当前策略 \(\pi_i\);
- 在 learner 实际访问的状态上查询 expert;
- 把新样本并入聚合数据集;
- 训练下一策略 \(\pi_{i+1}\)。
它把监督分布向 learner occupancy 移动,在论文假设下把序列损失降到线性量级。代价是 expert 必须安全地标注 learner 诱发的异常状态;真实机器人上通常需要人工接管、仿真或受约束 rollout。
DAgger 不是“把所有失败轨迹直接当负样本”。失败状态仍需要可执行的纠正动作,且采集过程不能越过安全边界。
把连续动作写成 token
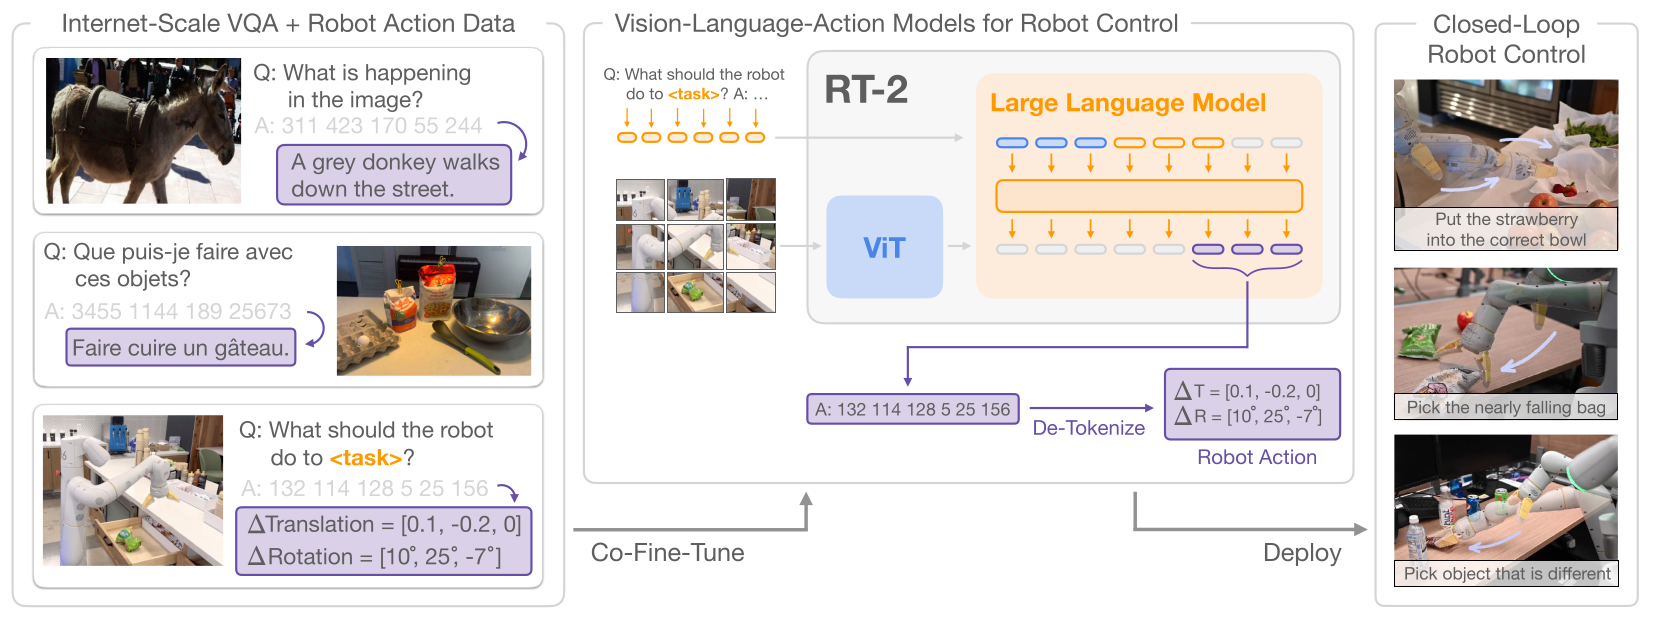
RT-1 把每个动作维度离散成 256 个 bin。一般地,对范围 \([l_i,u_i]\):
这样可用 categorical cross-entropy,并与语言自回归接口共享。但 bin 只在原始 bounds、单位、频率和 embodiment 下有物理意义;把另一个机器人的 token id 直接复用,可能造成静默缩放错误。
动作量化最小实现
import torch
def encode_action(action, low, high, bins=256):
    low, high = torch.as_tensor(low), torch.as_tensor(high)
    if bins < 2 or torch.any(high <= low):
        raise ValueError("invalid action bounds")
    unit = ((action - low) / (high - low)).clamp(0, 1)
    return (unit * (bins - 1)).round().long()
def decode_action(token, low, high, bins=256):
    low, high = torch.as_tensor(low), torch.as_tensor(high)
    if torch.any((token < 0) | (token >= bins)):
        raise ValueError("action token out of range")
    return low + token.to(low.dtype) / (bins - 1) * (high - low)
low, high = torch.tensor([-1., 0.]), torch.tensor([1., 2.])
action = torch.tensor([.2, 1.4])
restored = decode_action(encode_action(action, low, high), low, high)
assert torch.all((restored - action).abs() <= (high - low) / 255 / 2 + 1e-6)
这个往返测试只验证量化。生产数据还应把 bounds 与 normalization statistics 绑定到 dataset/embodiment version,并测试 clipping rate;大量样本落在边界说明 action schema 或分布已经漂移。
Action chunking:在流畅与反馈之间取舍
一次输出未来 \(H\) 步:
若只执行前 \(h\le H\) 步再观察,就是 receding horizon。增大 \(H\) 可表达连贯动作并减少模型调用;增大 \(h\) 却会让环境变化后仍执行旧计划。必须分别报告:
- chunk horizon \(H\);
- execution horizon \(h\);
- action/control frequency;
- policy inference frequency;
- observation-to-action latency。
ACT 使用 CVAE 风格的 action chunking,并用 temporal ensembling 融合相邻时刻预测的重叠动作。它针对示范的非平稳性和误差累积,不意味着 chunk 越长越好。
Diffusion Policy:为多峰连续动作去噪
Diffusion Policy 对动作轨迹加噪:
再条件于观察预测 noise、score 或 clean action。推理得到动作块后仍以 receding horizon 执行。它能表达多峰轨迹,但 iterative sampling、schedule、prediction type 与 control latency 必须一起评测。
Flow matching:从噪声沿速度场走向动作
\(\pi_0\)用条件 flow matching 建模动作块。设 expert action 为 \(A\)、噪声 \(\epsilon\sim\mathcal N(0,I)\):
从 \(\tau=0\) 的噪声走向 \(\tau=1\) 的动作,其目标速度为
训练目标:
推理用数值积分:
π0 论文实例输出长度 50 的 action chunk,并以 10 个 Euler step 采样;“可支持 50 Hz 动作”来自 chunking 与控制接口,不等于 3.3B 模型每秒完整前向 50 次。
下面只验证线性 flow 的方向约定。若把 \(A-\epsilon\) 写反,loss 仍能下降,却会在推理时从噪声走得更远。
import torch
def flow_matching_pair(action, tau):
    noise = torch.randn_like(action)
    while tau.ndim < action.ndim:
        tau = tau.unsqueeze(-1)
    noisy = tau * action + (1 - tau) * noise
    return noisy, action - noise
torch.manual_seed(0)
action = torch.tensor([[1., -2.]])
noisy, target = flow_matching_pair(action, torch.tensor([.25]))
torch.testing.assert_close(noisy + .75 * target, action)
完整 diffusion 与 flow 原理见生成建模。
FAST:先压缩时间,再做自回归
简单做法每个时间步、每个维度各产生一个 token,高频灵巧动作会形成很长序列。FAST 对动作块的每个维度沿时间做 Discrete Cosine Transform:
再量化频域系数、交错序列化并用 BPE 压缩。平滑动作的能量集中在低频,因此比逐时刻 binning 更短。
FAST 解决的是序列压缩,不是语义 grounding。强冲击、接触切换和高频抖动可能需要更多系数;不同控制率下频率含义也不同。FAST+ 的官方模型卡称其在一百万条真实机器人动作序列上训练,这属于发布方数据说明。
状态和动作在哪里对齐
常见数据记录有两种语义:
如果相机曝光、网络传输和控制器队列没有同步,监督 action 可能对应错误图像。至少检查:
- timestamp 单调且来自同一时钟或已校准;
- action command 与实际执行反馈分开;
- dropped frame、repeated frame 与 padding 有 mask;
- episode boundary 不跨轨迹拼接;
- gripper/terminate 等事件没有被插值成连续中间值;
- train/eval 使用同一坐标、归一化和频率定义。
失效与评测
| 失效 | 开放环表现 | 闭环探针 |
|---|---|---|
| 多峰平均 | MSE 可能不高 | 左/右两种路径与碰撞 |
| Covariate shift | expert split 良好 | 扰动物体、偏离轨迹、恢复 |
| 时间错位 | loss 有时仍下降 | 改变延迟、交叉相关与回放 |
| 坐标错误 | 固定方向偏差 | 相机/基座旋转与已知位姿 |
| 量化饱和 | token accuracy 尚可 | clipping rate、边界动作 |
| chunk 过时 | 静态任务良好 | 中途移动目标、缩短 replan |
| 采样太慢 | 离线 action 好 | latency、jitter、deadline miss |
| 动作越界 | 平均指标掩盖尾部 | workspace/joint/velocity violations |
开放环应报告 NLL、action error、calibration 与 clipping;闭环应报告 success、progress、recovery、intervention、碰撞和端到端时间。所有指标必须附 robot、action schema、control rate、reset 与 trial 数。
这些动作怎样与互联网预训练和跨机器人数据结合,见 VLA 与数据谱系;运行时怎样拒绝过期或危险动作,见规划、评测与安全。
动作分布、轨迹与策略目标的组合练习见强化学习手撕实现。
Reference
- Ross et al., A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning
- Brohan et al., RT-1: Robotics Transformer for Real-World Control at Scale
- Zhao et al., Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware
- Chi et al., Diffusion Policy: Visuomotor Policy Learning via Action Diffusion
- Black et al., \(\pi_0\): A Vision-Language-Action Flow Model for General Robot Control
- Pertsch et al., FAST: Efficient Action Tokenization for Vision-Language-Action Models
- Physical Intelligence, FAST+ Model Card