内存、数值与硬件
训练是否能运行由峰值内存决定,运行是否高效由计算、内存带宽和通信的关键路径决定。
显存账本
设参数量为 \(N\)。以 BF16 权重、BF16 梯度、FP32 master weight 和 Adam FP32 一二阶矩为例,仅静态模型状态就可能接近:
实际实现可能没有 master weight,或使用分片、低精度 optimizer;还需加入激活、KV、中间 buffer、通信 bucket、allocator 碎片和 kernel workspace。
静态字节只是下界。真正决定 OOM 的是时间轴上的峰值:
两个各占 20 GB 的 buffer 若生命周期不重叠,可以复用同一地址;两个平均只占 5 GB 的异步 collective 若偶然重叠,也可能击穿峰值。内存分析因此要记录 tensor shape、dtype、owner、创建/最后使用时刻和 stream event,而不是只把 profiler 分类相加。
Activation
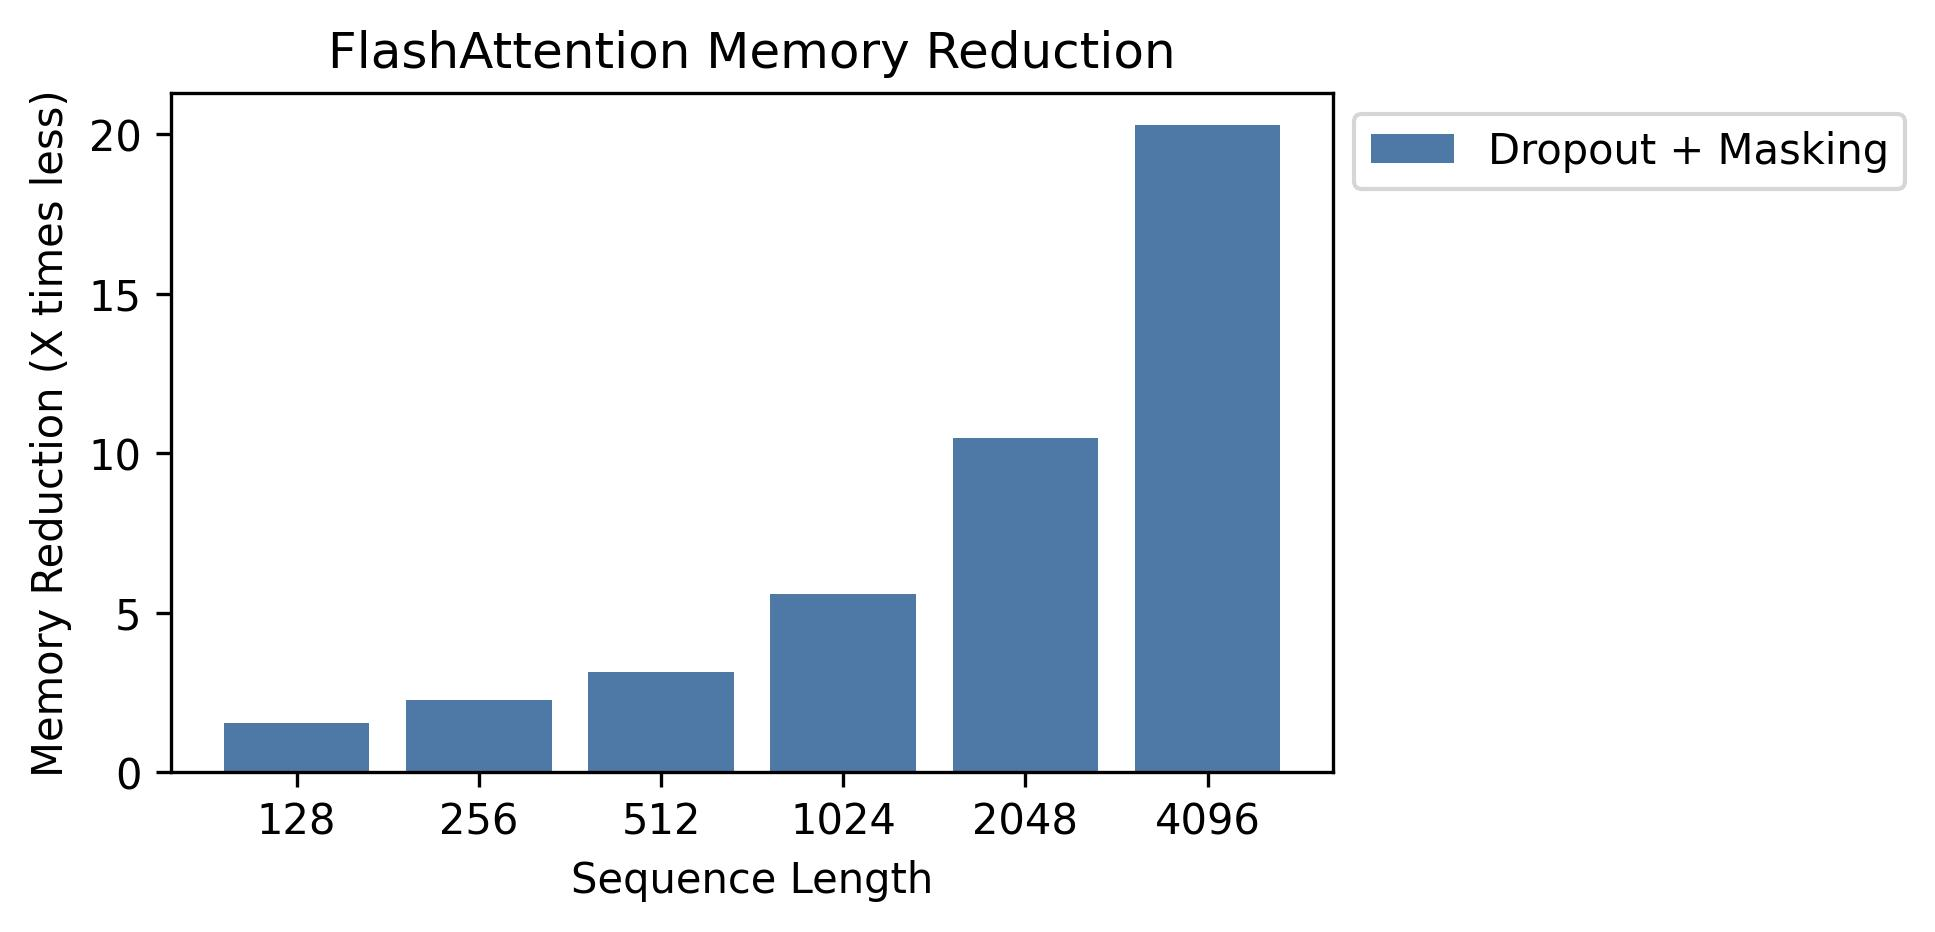
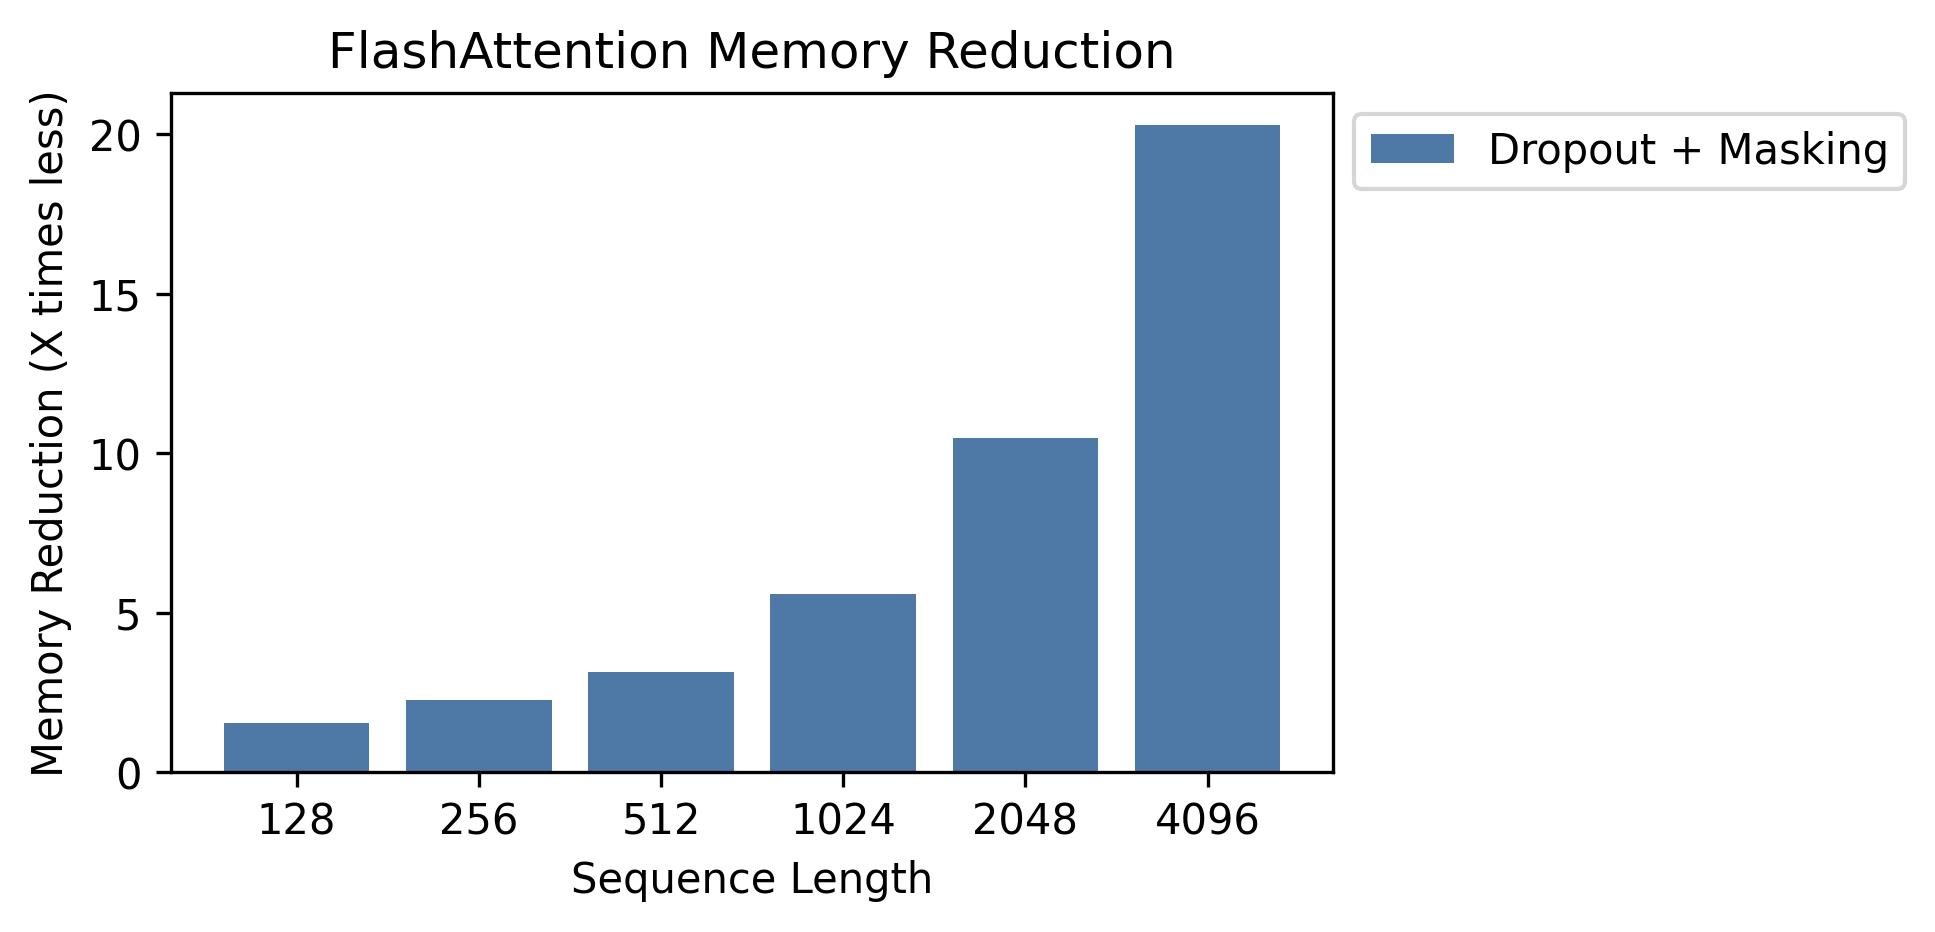
激活随 batch、序列长度、层数和 hidden size 增长。activation checkpointing 只保存部分边界,反向时重算中间结果,以计算换内存。选择 checkpoint 粒度时要测 wall-clock,而不只看理论重算 FLOPs。
逐 tensor 的存储策略
统一写成“开启 checkpointing”会掩盖不同 activation 的成本。更细的 planner 应为每类 tensor 在以下策略中选择:
| 策略 | 节省设备内存 | 新成本 | 适用条件 |
|---|---|---|---|
| recompute | 高 | 额外 forward FLOPs | 重算便宜、依赖可重放 |
| quantize | 中到高 | 量化误差与 pack/unpack | 有稳定 scale 与快 kernel |
| CPU offload | 高 | PCIe/CXL 传输 | 可提前预取 |
| remote offload | 高 | 网络与远端容量 | 其他并行 rank 有空闲窗口 |
选择目标应最小化关键路径时间,而不是单 tensor 字节。一个统一 activation pool 还需跟踪生命周期、prefetch deadline、stream event、量化 schema 与 fallback;不同策略共享 allocator,才能避免每种路径各自预留造成碎片。
Kimi K3 技术报告披露了一项具体实现:按 tensor 选择重算、blockwise FP8、CPU offload 或向其他 pipeline rank 远端 offload,并统一管理存储;梯度采用 CPU ZeRO-2,Muon 更新则通过点对点通信组织。这说明空闲显存、网络和 CPU 内存可以成为同一规划问题,但最佳策略依赖 pipeline 空泡、拓扑与 tensor 生命周期。完整系统组合见 Kimi K3。
Roofline 视角
算术强度:
当 \(I\) 低时更可能受内存带宽限制;高时更可能受计算峰值限制。prefill 的大 GEMM 往往更接近 compute-bound,逐 token decode 的小 batch 与权重/KV 读取往往更接近 bandwidth-bound。
可达到的性能上界近似为
它解释“为什么慢”,不直接给出优化方案。若 kernel 已经位于带宽屋顶,继续减少 FLOPs 可能没有收益,应减少 bytes、融合中间结果或提高复用;若远低于两个屋顶,还要检查 launch、shape、占用率和同步。分布式训练则需要把网络带宽与 collective 延迟加入同一关键路径,不能用单 GPU roofline 解释全部 step time。
精度是一条端到端路径
- softmax 需要减去行最大值以避免指数溢出。
- 大规模归约的顺序会改变浮点舍入,分布式结果不必 bitwise 相同。
- loss scaling 只能缓解 FP16 梯度下溢,不能修复错误 loss 或坏数据。
- FP8 训练需追踪每类张量的缩放与 amax,不应只报告“开启 FP8”。
- optimizer state、norm 与 residual 路径常保留更高精度。
同名 dtype 也不足以确定结果。矩阵输入、乘法、累加、输出、下一算子读入和通信压缩可以使用不同格式;某些 kernel 还允许 TF32 或 stochastic rounding。复现应记录每条关键路径的输入/累加/输出 dtype、scale 粒度和 saturation 计数。更完整的格式与误差分析见精度与数值。
数值错误常在不同阶段显现:
| 现象 | 可能根因 | 最小对照 |
|---|---|---|
| softmax 出现 NaN | score overflow、全 mask 行 | FP32 reference 与逐行可见数 |
| loss 正常但梯度为零 | underflow、错误 loss scaling | 未缩放 FP32 gradient |
| 多卡与单卡缓慢漂移 | reduction 顺序、低精度通信 | 固定 batch 的逐层 checksum |
| 量化吞吐无提升 | cast/scale 开销、shape 不合 kernel | 端到端 trace 而非算子峰值 |
硬件账本必须能解释拓扑
需要联合记录:
- 加速器型号、显存、计算格式与实际频率;
- 节点内拓扑、PCIe、NVLink/NVSwitch;
- 节点间 NIC 数、带宽、RDMA、交换结构与超额订阅;
- CPU、NUMA、内存、数据盘与远端对象存储;
- 驱动、runtime、collective library、kernel 与框架版本。
只说“用了多少张 GPU”无法复现性能。训练框架的代表性参考包括 Megatron-LM 与 PyTorch FSDP。状态怎样切分见集合通信与状态分片,算术强度怎样落到 kernel 见 Kernel 与性能。
同样数量的设备可能形成完全不同的系统:八卡在一个 NVSwitch 域内,与跨八个节点各取一张卡,all-reduce 的带宽、延迟和故障域都不同。并行维度应映射到实际 rank topology,性能报告则同时给出有效 batch、sequence shape、step time 分解、峰值显存和失败重试;只报理论 TFLOP/s 会隐藏数据与通信空泡。