从共享参数到多维并行
大模型训练系统的演进不是一条按缩写接力的路线,而是多个正交瓶颈长期共存。Data parallel 通过复制模型、拆分 batch 扩展训练吞吐;parameter server 与 collective 选择不同的状态所有权和同步语义;ZeRO/FSDP 消除数据并行副本中的状态冗余;tensor parallel 切分单层计算与参数;pipeline parallel 切分层并引入调度。它们可以组合,也可能争用同一网络和显存;每一种机制都只降低局部成本,同时增加通信、调度或恢复约束。
起点:一张卡上的四本账
训练峰值显存至少包含
\(M_{\text{state}}\) 包括参数、梯度、master weights 与 optimizer states;\(M_{\text{activation}}\) 随 microbatch 和序列长度变化;后两项包括通信 bucket、临时物化参数、kernel workspace 与 allocator 碎片。只按“参数量乘 dtype”估算,无法解释许多真实 OOM。
一步训练的时间也不只由 FLOPs 决定:
这个下界说明了后续工作的共同目标:减少驻留字节、减少跨层级搬运,或把不可避免的搬运隐藏在计算后面。统一的成本记法见性能模型。
Parameter server:先把共享状态独立出来
Parameter Server 让 worker 持有数据与局部计算,server 节点维护全局参数。它支持稠密或稀疏参数、异步通信、弹性成员和多种一致性模型,特别适合参数访问稀疏、worker 异构或需要弱同步的工作负载。
若 \(D\) 个 worker 每轮各上传并取回 \(S\) 字节稠密状态,集群总流量约为
使用 \(K\) 个均衡 server shard 时,每个 server 承担约 \(2DS/K\),但网络总量仍是同一量级。异步执行可以隐藏等待,却会让 worker 在不同参数版本上计算;staleness 因而进入优化算法语义,而不只是系统延迟。
Parameter server 不是“较慢的 all-reduce”。前者给参数指定所有者并允许灵活一致性,后者让每个 rank 对同一 collective 共同负责,通常保持严格同步。
Collective data parallel:去掉中心所有者
稠密同步训练中,每个 rank 保存模型副本、计算不同数据上的梯度,再通过 all-reduce 得到相同结果。PyTorch DDP 的设计研究展示了 gradient bucketing、反向计算与通信重叠等关键机制;collective 的精确定义可对照 NCCL 官方文档。
对 \(D\) 个 rank、\(S\) 字节梯度,ring all-reduce 每个 rank 的发送与接收量近似
在简单的 \(\alpha\)–bandwidth 模型下,
ring 消除了单个 reducer 的带宽热点,却增加了随 rank 数增长的启动轮次。小 bucket 被 latency 主导;大 bucket 又要等更多梯度就绪,导致通信暴露在反向末尾。实际系统还会按节点拓扑选择 tree、ring 或 hierarchical collective。
同步梯度不自动保证正确的损失口径。对于有效 token 数不同的 rank,正确均值是
而不是先求每卡均值再平均。紧凑 reference 见分布式与容错。
ZeRO 与 FSDP:副本显存成为新瓶颈
DDP 分散了计算和通信,却仍在每卡复制参数、梯度和 optimizer states。设三者字节数分别为 \(W,G,O\),数据并行度为 \(D\),ZeRO 的静态状态近似为
Stage 3 的最后一个式子不是峰值:模块执行前仍需 all-gather 参数 shard,反向还需 reduce-scatter 梯度,并产生 prefetch 与 allocator transient。分片把“永久复制”改成“按需物化”,因此 wrap 粒度同时决定峰值显存、消息大小与 overlap。
PyTorch FSDP 把这一执行语义集成进模块、dispatcher 与 allocator。它和 ZeRO 共享“消除数据并行冗余”的核心思想,但公开 API、wrap 单位、prefetch 与 state-dict 语义并不相同。具体内存和通信推导见集合通信与状态分片,TP 与 ZeRO 的组合见 Megatron-LM 与 ZeRO。
Tensor parallel:状态分片仍救不了一层
当单个 Transformer layer 的权重或 workspace 仍无法在一张卡上计算,需要沿矩阵维度切分。对线性层 \(Y=XW\),column parallel 写成
若下一算子能消费分片输出,边界暂时不需要归约。row parallel 写成
局部结果需要 all-reduce 或 reduce-scatter。Megatron-LM 通过相邻 column/row parallel 设计,把 Transformer block 的通信集中到少数边界。
TP 切的是层内计算,频繁交换的是 activation 或局部结果,规模通常随 batch tokens 与 hidden size 增长。并行度过大时,本地 GEMM 变小、算术强度下降、collective 启动变多;因此 TP 通常放在 NVLink/NVSwitch 等最快互联内,而不是无限扩到整个集群。
Pipeline parallel:切层以后,空泡成为成本
将连续层分给 \(p\) 个 stage,再把 batch 切成 \(m\) 个 microbatch,可以让不同 stage 同时工作。理想平衡的 GPipe 式 schedule 利用率约为
但这里存在三条不同语义路线:
| 路线 | 调度与一致性 | 缓解的问题 | 新成本 |
|---|---|---|---|
| GPipe | 一批 forward 后统一 backward,batch 边界同步 | 模型跨设备、接口通用 | flush bubble、在途 activation |
| PipeDream | 不同输入的 forward/backward 异步交错,保存权重版本 | 提高流水利用率、减少 DP 通信压力 | weight stashing、版本内存、跨 stage staleness |
| 同步 1F1B | warmup 后交错一前一后,仍在统一 optimizer step 边界同步 | 降低在途 activation 峰值 | 仍有 warmup/drain bubble 与 stage 不均 |
因此,“用了 1F1B”不能推出“采用 PipeDream 语义”。现代大模型训练常用同步 1F1B 保持与数据并行相近的更新边界,同时借鉴流水调度降低内存。
吞吐最终受最慢 stage 限制:
只优化平均 stage 时间会留下周期性空闲。完整切分与 schedule 见模型并行。
三维并行:组合不等于相乘
Megatron 的大规模训练研究组合 tensor、pipeline 与 data parallel:
这个等式只验证设备计数,不证明映射高效。TP 每层通信且对 latency 敏感,通常留在节点内;PP 交换 stage boundary activation,适合稳定点对点链路;DP collective 粒度较大,可跨更广的 fabric。加入 context 或 expert parallel 后,不同 collective 还可能在同一链路相互阻塞。
模型结构也会反向改变系统选择:长上下文增加 activation 与 attention IO,MoE 把 dense all-reduce 转为 token all-to-all,GQA 减少推理 KV 却不等比例减少训练中的所有通信。组合并行应从 tensor shape 和拓扑出发,而不是从框架配置名出发。
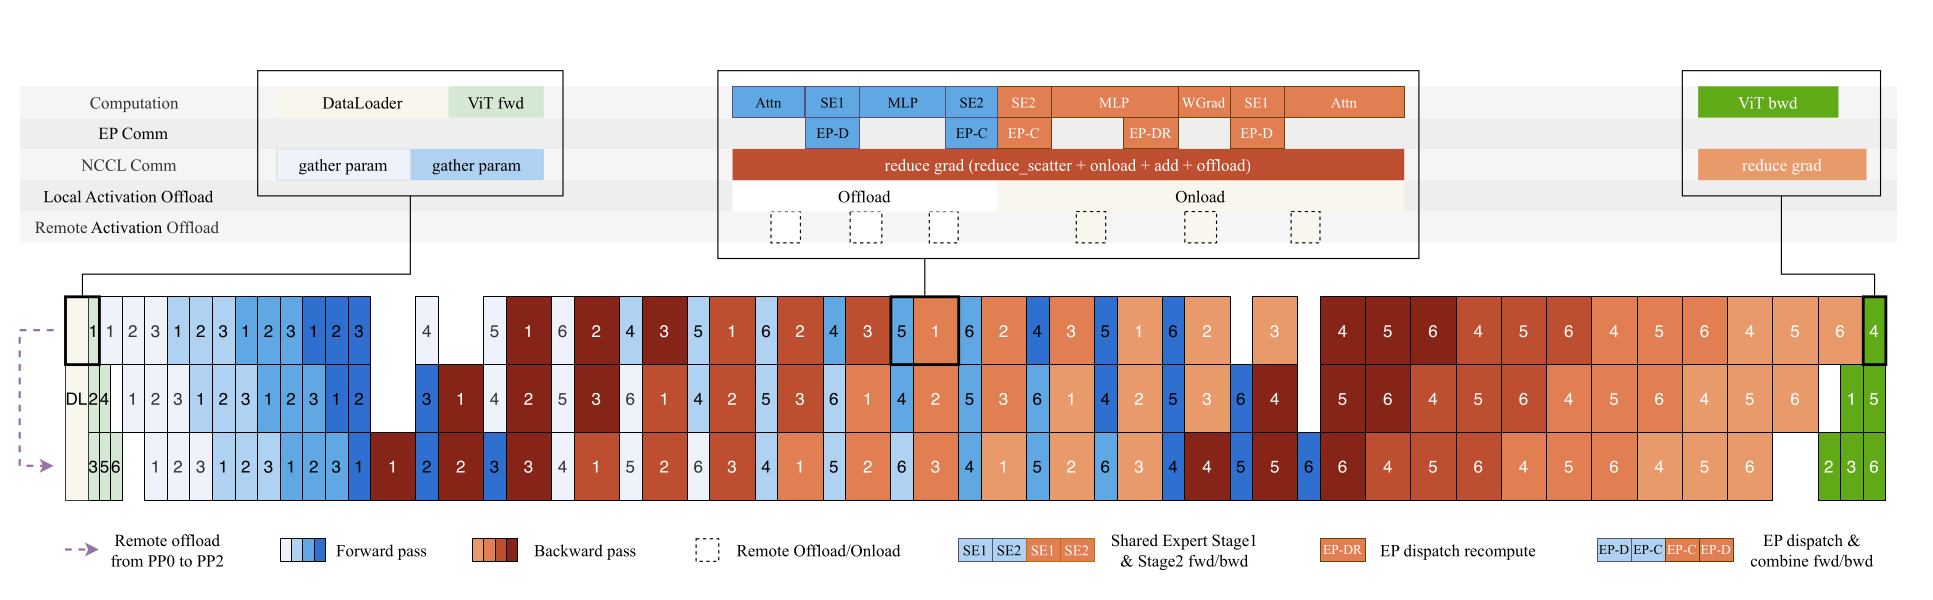
数值与 kernel:显存释放后,瓶颈继续转移
Mixed Precision Training 用低精度保存和计算大部分 tensor,并以 FP32 master weights 与 loss scaling 处理 FP16 范围不足。它同时改变显存、HBM traffic、collective bytes 与数值稳定性;“checkpoint 是低比特”不代表运行时执行低比特 GEMM。
Activation checkpointing 则保存少数边界并在反向重算中间 activation。亚线性内存算法展示了以额外 forward 计算换取 \(O(\sqrt n)\) activation memory 的构造。两种技术释放的显存常被更大 batch 或更长 context 立即吃掉,随后 attention 的 HBM IO 可能成为主导,FlashAttention 正从这里接续。
长作业:故障从例外变成稳态成本
若单节点平均故障间隔为 \(M_{\text{node}}\),在独立指数故障的简化假设下,\(N\) 节点系统的 MTBF 约为
训练时间与集群规模增长后,只保存参数不足以恢复计算轨迹。checkpoint 还需包含 optimizer、RNG、loss scaler、scheduler、数据游标和并行布局。设一次不可隐藏保存耗时为 \(C\)、系统 MTBF 为 \(M\),Young 近似给出
它忽略恢复时间、相关故障和存储拥塞,只适合作为起点。安全的分布式 checkpoint 应以逻辑 tensor range 描述状态,先写不可变 shard 与 checksum,最后原子提交 manifest;异步 staging 只有在 durable commit 完成后才算成功。PyTorch DCP 提供分布式 state dict 与 planner,ByteCheckpoint 进一步研究并行度无关表示和 load-time reshard。恢复契约见检查点与容错和韧性与可观测性。
用瓶颈选择机制
| 首个硬约束 | 优先检查 | 不应忽略的反作用 |
|---|---|---|
| 数据规模与训练时间 | data parallel、输入流水 | 梯度口径、网络暴露 |
| optimizer state 复制 | ZeRO/FSDP | all-gather 峰值、checkpoint reshard |
| 单层放不下 | tensor parallel | activation collective、小 GEMM |
| 层数与设备规模 | pipeline parallel | bubble、版本语义、stage balance |
| activation 过高 | recomputation、sequence/context split | 额外计算与持续 K/V 通信 |
| attention IO | tiled online softmax | mask、dropout、ragged layout |
| 长作业频繁失败 | async/sharded checkpoint | staging 内存、存储与网络争用 |
正确顺序是先重建峰值显存和关键路径,再加入最少的并行维度。每加一种机制,都重新验证单步数值、通信暴露、峰值显存、故障恢复和端到端有效 token throughput。