FlashAttention:让精确注意力服从内存层次
FlashAttention 的关键贡献不是改变
的数学结果,而是重排计算,使中间 score 和 probability tile 尽量停留在片上存储,不把完整 \(N\times N\) 矩阵反复写入 HBM。它把“复杂度看 FLOPs”推进到“性能还要看数据在内存层次间搬了几次”。
前序瓶颈:算完又搬走
标准实现通常分为:
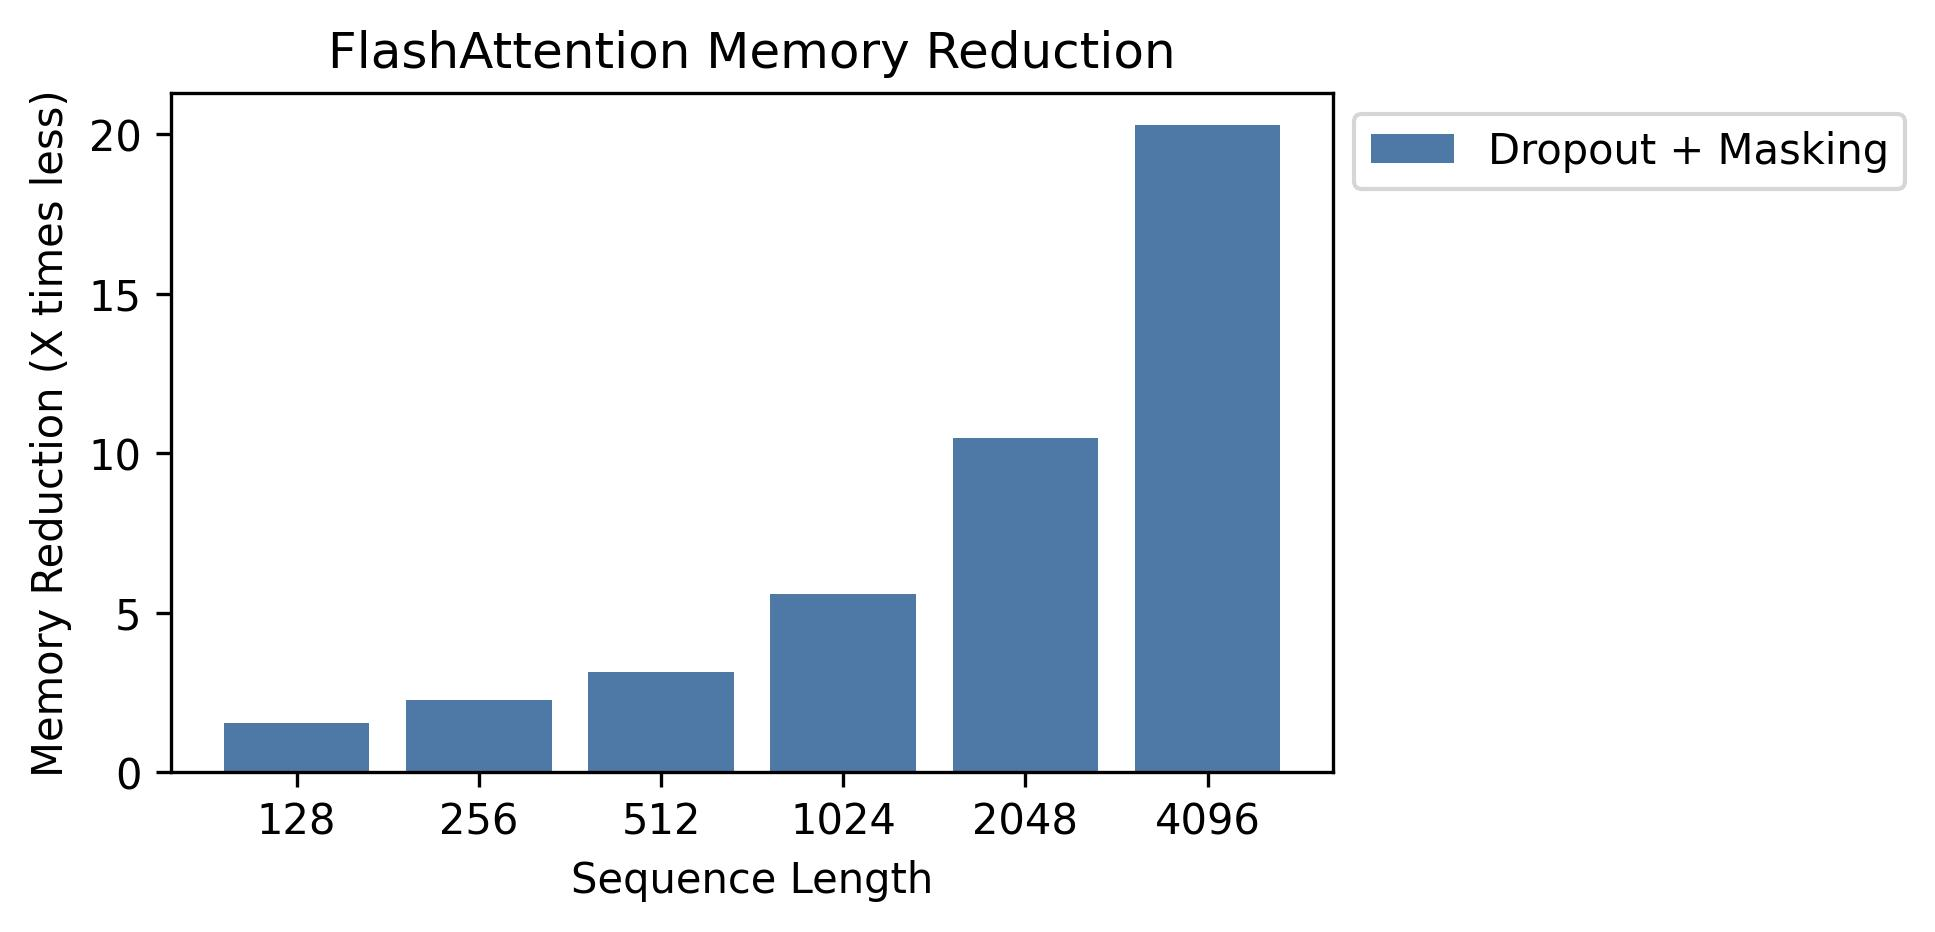
对序列长度 \(N\)、head dimension \(d\),计算量仍为 \(O(N^2d)\);若显式物化 \(S\) 或 \(P\),额外存储和大块 HBM traffic 为 \(O(N^2)\)。长序列时,即使矩阵乘使用高吞吐单元,中间结果的写回、读取和 kernel 边界仍可能成为主导。
Roofline 下界写成
只减少 FLOPs 而增加不规整访存的近似 attention 未必更快;反过来,保持 FLOPs 不变但减少 HBM traffic 也可能显著降低 wall-clock。
Online softmax:tile 可以独立计算后合并
对一组 score,保存三项统计:
最终输出为 \(o=u/\ell\)。两个 tile 的统计 \((m_a,\ell_a,u_a)\)、\((m_b,\ell_b,u_b)\) 可稳定合并:
这组结合式让实现逐块加载 K/V、立即消费局部 score,并只保留每个 query 的 running statistics。
CPU reference
下面按 key/value block 流式计算完整 attention。它不模拟 GPU tile、反向或 causal mask,只验证 online merge 与一次性 softmax 的语义一致。
import math
def dot(left, right):
    return sum(a * b for a, b in zip(left, right))
def blockwise_attention(q, k, v, block_size):
    scale = 1.0 / math.sqrt(len(q[0]))
    maximum = [-math.inf] * len(q)
    normalizer = [0.0] * len(q)
    numerator = [[0.0] * len(v[0]) for _ in q]
    for start in range(0, len(k), block_size):
        kb, vb = k[start:start + block_size], v[start:start + block_size]
        for row, query in enumerate(q):
            score = [dot(query, key) * scale for key in kb]
            new_max = max(maximum[row], max(score))
            old_scale = math.exp(maximum[row] - new_max)
            probability = [math.exp(value - new_max) for value in score]
            normalizer[row] = old_scale * normalizer[row] + sum(probability)
            numerator[row] = [
                old_scale * old + sum(p * value[j] for p, value in zip(probability, vb))
                for j, old in enumerate(numerator[row])
            ]
            maximum[row] = new_max
    return [[value / normalizer[row] for value in output]
            for row, output in enumerate(numerator)]
def dense_attention(q, k, v):
    scale = 1.0 / math.sqrt(len(q[0]))
    output = []
    for query in q:
        score = [dot(query, key) * scale for key in k]
        maximum = max(score)
        weight = [math.exp(value - maximum) for value in score]
        total = sum(weight)
        output.append([sum(p * value[j] for p, value in zip(weight, v)) / total
                       for j in range(len(v[0]))])
    return output
q = [[1.0, 0.5, -1.0], [0.0, 2.0, 1.0]]
k = [[1.0, 0.0, 1.0], [-1.0, 2.0, 0.5], [0.5, 1.0, -2.0],
     [2.0, -1.0, 0.0], [0.0, 0.5, 1.5]]
v = [[1.0, 0.0], [0.0, 2.0], [2.0, -1.0], [1.5, 1.0], [-0.5, 3.0]]
reference = dense_attention(q, k, v)
actual = blockwise_attention(q, k, v, block_size=2)
error = max(abs(a - b) for rows in zip(actual, reference) for a, b in zip(*rows))
assert error < 1e-12 and all(math.isfinite(x) for row in actual for x in row)
用于生产语义时还要加入 causal/padding/document mask、dropout RNG、GQA head mapping、ragged offsets 与 backward。对应 tensor reference 见 Tensor 原语。
IO 模型
FlashAttention 原论文在片上 SRAM 容量为 \(M\) 个元素、\(d\le M\le Nd\) 的模型中,将 attention 核心的 HBM access 分析为
并证明在相应范围内的 IO optimality;标准 materialized attention 则需要写读 \(N^2\) 级中间矩阵。实际字节数还取决于 tile shape、dtype、mask、head 数、forward/backward 与是否重算统计。
FlashAttention 的额外中间存储随 \(O(Nd)\) 而不是 \(O(N^2)\) 增长,但计算仍是精确 dense attention 的 \(O(N^2d)\)。因此它解决的是 IO 与 activation memory,不是把长上下文的计算复杂度变成线性。
从 FA1 到硬件协同
FlashAttention-2 减少非矩阵乘法工作,并重新划分 thread block 与 warp 的任务,让更多执行时间落在高吞吐矩阵单元上。FlashAttention-3 进一步利用 Hopper 的 TMA、warp specialization 和异步流水,把数据搬运、GEMM 与 softmax 更深地重叠。
这里的稳定思想与硬件结论应分开:
- 稳定思想:tiling、online softmax、避免完整 score materialization;
- 硬件相关:tile 大小、warp 分工、TMA、FP8 路径、shared-memory layout;
- workload 相关:短/长序列、causal mask、GQA、训练或 decode。
新一代 kernel 在特定 GPU 上更快,不表示旧硬件或所有 shape 都应采用同一 schedule。
训练与推理的形状不同
训练 forward/backward、推理 prefill 与增量 decode 即使都计算 attention,也有不同状态和约束:
| 路径 | 典型形状 | 首要约束 |
|---|---|---|
| 训练 forward/backward | 多 query × 多 key | tile reuse、activation 与梯度重算 |
| 推理 prefill | 多 query × 多 key | prompt 长度、KV 写入与首 token 延迟 |
| decode | 少 query × 长 key | KV bandwidth、分页寻址、batch raggedness |
| speculative verify | 多个候选 query | branch mask、事务式 KV |
| prefix/tree attention | 共享或分叉历史 | block ownership、非规则 mask |
因此“使用 FlashAttention”不足以描述推理 kernel。Paged KV、连续虚拟地址和 contiguous KV 会产生不同访存路径,见 Attention Kernel 和 vLLM 与 PagedAttention。
数值与正确性
Online softmax 使用全局 running maximum 保持稳定,但浮点加法顺序随 tile 改变,低精度结果不必逐 bit 相同。验证应分层:
- FP64 小 shape 对齐显式 attention;
- FP32/BF16/FP16 记录绝对与相对误差;
- 覆盖全 mask 行、极端 logits 与非整 tile 尾部;
- forward、backward、dropout replay 分别测试;
- activation checkpoint 前后保持 RNG 语义;
- 使用真实长序列检查 NaN、峰值显存和 wall-clock。
降低 dtype 只有在 load/store、计算和 accumulator 路径确实采用对应格式时才减少关键路径成本。精度边界见精度与数值。
Reference
- FlashAttention 原论文是算法与 IO 分析的一手来源。
- FlashAttention-2 和 FlashAttention-3 分别代表工作划分与 Hopper 异步流水的后续演进。
- Dao-AILab 官方仓库提供 CUDA/ROCm 路径与具体支持矩阵;支持的 GPU、dtype、head dimension、dropout 和 backward 能力必须按目标 commit 核验。
- PyTorch SDPA、编译器生成 kernel 或其他 fused attention 可以实现相同数学语义,但不能仅凭 API 名称推断它们采用了论文中的同一 tile 与 IO schedule。
评测需要固定 GPU、软件版本、dtype、batch、head layout、mask、序列长度分布、forward/backward,并同时报告 kernel time、端到端 step time、HBM traffic 和峰值显存。单一方形 shape 的 microbenchmark 不能代表完整训练或在线服务。