音频与语音模型
音频模型同时面对高采样率连续信号、语义内容、说话人和声学细节。理解任务希望压缩无关声学变化,生成任务却需要恢复音色、韵律和环境;一个 tokenization 很难同时最优。
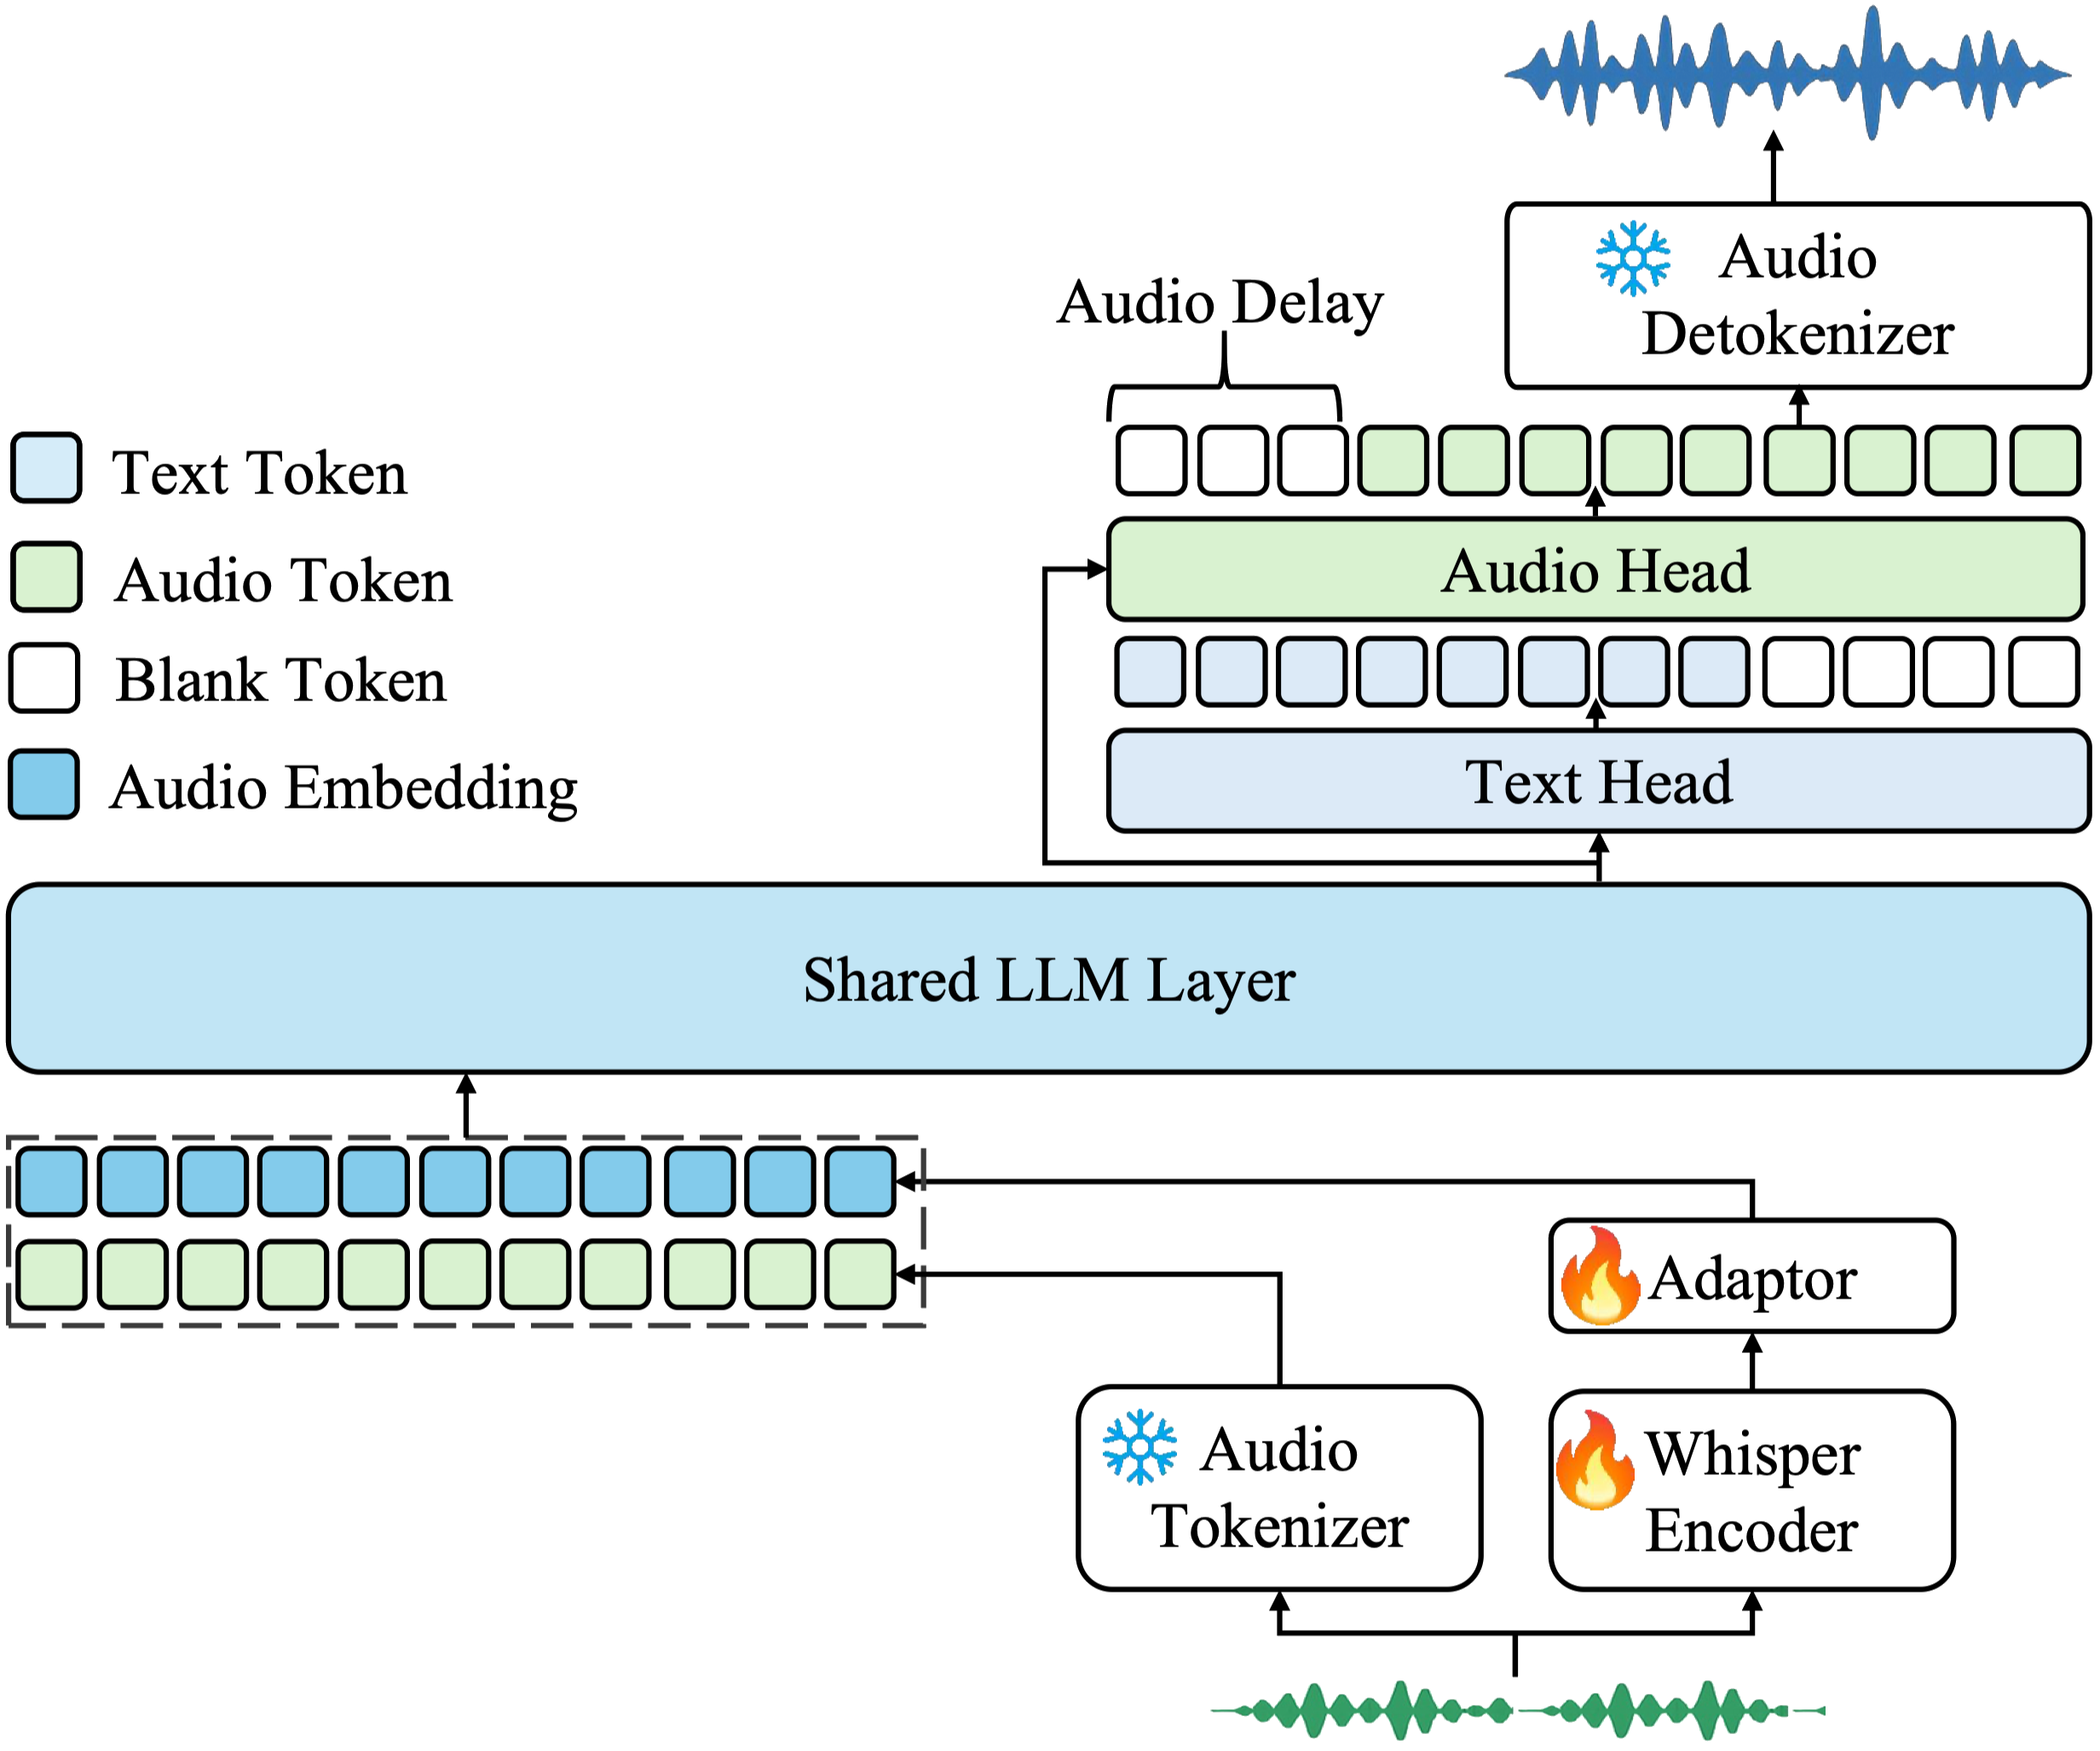

表示层次
波形与频谱
原始波形
在采样率 \(f_s\) 下每秒含 \(f_s\) 个样本。常见前端使用短时傅里叶变换并映射到 log-Mel:
Window、hop、FFT 大小、Mel bins 和归一化都是模型接口。Whisper 是从 log-Mel 输入进行大规模弱监督语音识别与翻译的代表。
连续语义特征
音频 encoder 可产生低帧率连续表示:
Projector 或 resampler 再接入 LLM。连续特征适合理解、ASR 和检索,但通常不能直接重建高质量波形。
离散 codec token
Neural codec 把音频压缩为一个或多个码本流。EnCodec 使用 residual vector quantization(RVQ)。
Residual Vector Quantization
令 encoder latent 为 \(z\):
第 \(m\) 个码本选择
并更新残差:
重建 latent 为
更多码本提高码率和细节,也增加生成序列与同步复杂度。报告 codec 时应给出 sample rate、frame rate、codebook 数、codebook size、bitrate 与重建指标。
最小语义实现
residual_vector_quantize 接收 latent [...,D] 与码本 [M,K,D],逐层寻找当前残差的最近向量,并返回重建、每层索引和最终残差。恒等式 reconstruction + residual == latent 是比只检查 shape 更强的基本不变量。
import torch

def residual_vector_quantize(latent, codebooks):
    residual = latent.float()
    reconstruction = torch.zeros_like(residual)
    indices = []
    for codebook in codebooks.float():
        flat = residual.reshape(-1, residual.size(-1))
        distance = (flat.square().sum(1, keepdim=True)
                    + codebook.square().sum(1) - 2 * flat @ codebook.T)
        index = distance.argmin(-1)
        quantized = codebook[index].view_as(residual)
        reconstruction = reconstruction + quantized
        residual = residual - quantized
        indices.append(index.view(latent.shape[:-1]))
    return (reconstruction.to(latent.dtype), torch.stack(indices, -1),
            residual.to(latent.dtype))

latent = torch.tensor([[1.2, .1], [.1, .8]])
codebooks = torch.tensor([
    [[0., 0.], [1., 0.], [0., 1.]],
    [[0., 0.], [.2, 0.], [0., -.2]],
])
reconstruction, indices, residual = residual_vector_quantize(latent, codebooks)
torch.testing.assert_close(reconstruction + residual, latent)
assert indices.shape == (2, 2) and residual.norm() < latent.norm()
残差范数下降并非任意学习码本的自动保证,示例中的零向量只为建立可检查基线;训练还需定义 codebook/commitment 更新、dead-code 处理和 straight-through 梯度。完整实验见多模态原语:Residual Vector Quantization。
语义与声学 token
AudioLM 把长程语义 token 与细粒度声学 token 分层建模。语义流控制内容和长期结构,声学流恢复音色与局部细节。
分层表示有利于降低高层序列长度,但会引入条件误差传播:
其中 \(s\) 是 semantic token,\(a\) 是 acoustic token。若语义 token 已丢失韵律或非语音事件,声学 decoder 无法凭空恢复正确内容。
多码本延迟模式
若每个时间步有 \(M\) 个 codebook token,直接展平成
会使时间步内部也完全串行。Delay pattern 把第 \(m\) 个 codebook 延迟 \(m-1\) 步,使模型每个 decode step 并行产生多个时间层级。
实现必须定义:
- BOS/padding 填充位置;
- 延迟后有效 token mask;
- pack 与 unpack 的互逆;
- 最后几步如何 flush;
- codebook 顺序和时间戳。
一个 off-by-one 会让所有声学层错帧,却可能仍生成“像语音”的输出。
音频语言建模
MusicGen 展示了基于压缩离散表示的条件音乐生成。更一般地,音频 token 自回归目标为
若使用多 codebook,需说明是 flatten、delay、分层模型还是独立 head。Token-level perplexity 只有在 codec 和展开方式相同的情况下才可比较。
语音到语音
级联系统:
其优点是每层可独立验证;缺点是 ASR 丢失韵律和非语言信息,串联延迟也较高。SeamlessM4T 研究了多语言、多任务语音与文本翻译。
端到端 speech-to-speech 可以在共享表示中保留声学条件,但内容正确性、说话人保持、延迟与安全更难分层诊断。
流式与全双工
流式 encoder 只能看到有限未来。设 chunk 时长为 \(c\)、lookahead 为 \(a\),算法延迟下界包含
系统总延迟还包括:
Moshi 及其官方实现公开了全双工 spoken dialogue 的多流建模路线。全双工系统必须分别维护用户和系统音频流,并处理:
- voice activity detection;
- turn-taking 与重叠说话;
- 用户打断后的生成取消;
- 尚未播放 token 与已播放音频的边界;
- echo、packet loss 与采样时钟漂移。
Shape 与实现契约
波形常见 shape:
Codec token:
实现应固定:
- sample rate、声道与波形范围;
- resample 方法;
- codec frame rate 与 hop;
- codebook 轴、时间轴和 flatten/delay 顺序;
- streaming cache 与 chunk 边界;
- padding 是否更新状态或参与 loss;
- 说话人、语言和模态控制 token;
- 打断时 cache、队列和 decoder 的清理。
失效模式
- 语义—声学错配:内容正确但音色/韵律错误,或反之。
- Codec 上限:生成模型无误,但 decoder 重建已失真。
- Codebook collapse:少数离散码占比异常。
- 错帧:delay pattern pack/unpack 不互逆。
- 流式漂移:chunk 拼接出现重复、缺口或时间偏移。
- 说话人泄漏:输出保留不应复现的身份特征。
- 打断失败:用户插话后旧输出仍继续播放。
- 指标错位:只报告 WER 或 token/s,忽略端到端交互。
验证矩阵
| 层级 | 测试 |
|---|---|
| 前端 | 重采样、STFT/log-Mel 与官方实现对齐 |
| Codec | 原音—重建、bitrate、code usage、不同音频类型 |
| RVQ | residual 逐层下降、encode/decode 互逆 |
| Delay | 随机 token pack/unpack 与边界 flush |
| 内容 | ASR、翻译、非语音事件、音乐结构 |
| 生成 | 可懂度、自然度、说话人、韵律与多样性 |
| 流式 | 首包、实时系数、chunk、lookahead、packet loss |
| 对话 | 抢话、打断、静音、重叠和长时间会话 |
音频 token 的紧凑 RVQ、delay stream 与 streaming state 练习见多模态手撕实现,共享融合接口见多模态融合、位置与训练。
继续深入
感知、ASR、声源、音画对齐与证据定位见音频表示、Codec 与理解;TTS、音乐、通用声音、diffusion/flow 和全双工 runtime 见音频生成、语音交互与流式。本页继续维护 codec token、RVQ 与语音到语音的共同机制。