GLM Agentic Engineering:从一次生成到可验证的长程工作
“模型会写代码”和“Agent 能完成软件工程任务”之间隔着一套完整闭环。前者可以由单轮 prompt 触发;后者必须读取一个真实仓库,理解问题,修改多个文件,运行工具,从失败中恢复,并让独立测试验证最终状态。GLM-5 技术报告把这种转变概括为从 vibe coding 到 agentic engineering。
这个说法最有价值的地方不在命名,而在它暴露了能力的最小乘积:
其中任一项接近零,端到端成功率都会坍塌。模型知道补丁不代表环境能安装依赖;工具执行成功不代表测试覆盖了需求;上下文够长不代表旧观察仍值得保留;reward 上升也可能只是学会钻 renderer 或测试脚本的空子。
本页沿一条真实任务的生命周期展开:任务从哪里来,怎样变成可执行环境,轨迹怎样训练,运行时怎样管理上下文,最后怎样评测。异步优化细节见 slime 与异步 Agentic RL,报告逐表逐图审计见 GLM-5。
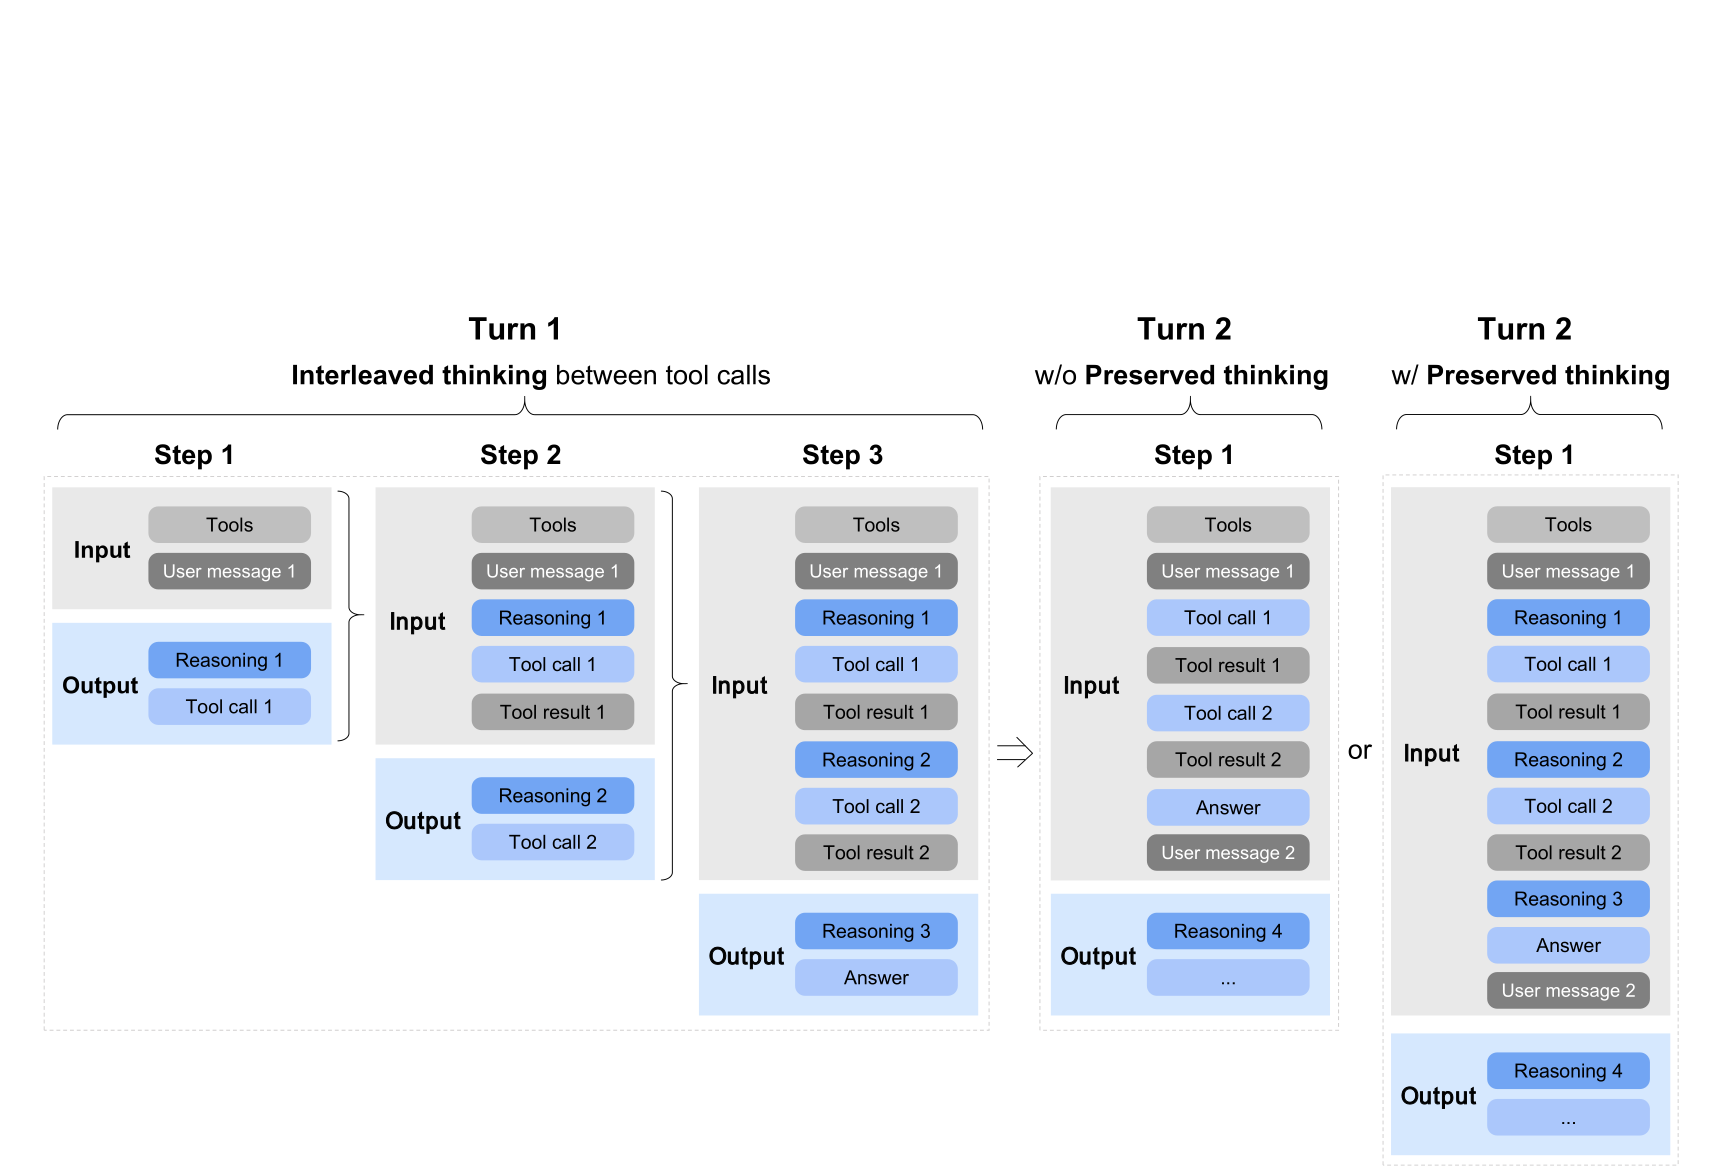
从问题文本到可验证环境
一个软件任务不能只保存 issue 描述。可训练的环境至少包含
其中 \(R\) 是仓库与依赖,\(c_0\) 是初始 commit,\(I\) 是任务说明,\(S\) 是允许的工具与状态转移,\(V\) 是 verifier,\(B\) 是步骤、token、时间和提交预算。
GLM-5 的软件工程环境管线以真实 issue–pull request 对为起点,先用规则和模型过滤,再借助 RepoLaunch 分析安装流程、构建可执行镜像、生成测试命令,并从日志中提取:
- Fail-to-Pass(F2P):修复前失败、正确修复后应通过;
- Pass-to-Pass(P2P):修改前后都应继续通过,防止回归。
报告称由此得到超过 \(10\,000\) 个环境,来自数千仓库、覆盖 Python、Java、Go、C、C++、JavaScript、TypeScript、PHP 与 Ruby 九种语言。这个数字说明管线规模,不等于每个环境都经过人工审计,也不能直接换算成互相独立的任务数。
为什么只测 F2P 不够
若只要求新测试通过,Agent 可以大范围删改旧逻辑;若只跑旧测试,又无法判断 issue 是否解决。一个最小 verifier 可写为
最后一项用于保护测试、依赖来源、路径和网络权限。隐藏测试必须位于 Agent 无法修改的信任域;否则“全绿”可能只是 reward hacking。
环境构建失败不等于模型失败
安装脚本失效、镜像拉取失败、测试随机挂掉与模型写错补丁是不同事件。GLM-5 的异步训练会记录 failure reason,并排除 environment collapse。更完整的状态应至少区分:
PASS
MODEL_FAILURE
BUDGET_EXHAUSTED
INVALID_ACTION
ENV_BUILD_FAILURE
ENV_RUNTIME_FAILURE
VERIFIER_FAILURE
把后三类都压成 reward \(0\) 会让策略学到“回避容易坏的环境”,而非解决任务。
Terminal 任务:从种子、网页到可执行规格
真实 issue 能提供自然分布,却受许可证、依赖腐烂和测试质量限制。GLM-5 还构建了两条 terminal synthesis 管线。
从种子任务扩展
第一条管线分三步:
- 根据真实软件工程和 computer-use 种子生成任务草案;
- construction agent 按 Harbor 格式生成任务描述、Docker 环境与测试;
- refine agent 按人工 rubric 反复检查构建、题意—测试一致性和捷径。
报告称生成数千个环境,Docker 构建准确率超过 \(90\%\)。这仍留下一个重要尾部:即使 \(90\%\) 可构建,剩余失败若与任务主题或依赖复杂度相关,就会产生 selection bias。
从网页生成
第二条管线先从代码相关网页中筛选高质量、适合终端化的内容,再按主题与难度分层采样。construction agent 同时拿到网页和 Harbor 规范,生成任务后执行验证脚本,失败则诊断并重写。
“自验证”只保证样本通过当前自动检查,不保证任务正确、唯一或无漏洞。可靠生产线还需要:
- 独立于生成模型的 verifier 或人工抽样;
- 对 Dockerfile、测试与说明分别做去重;
- 隐藏输入和对抗 shortcut;
- 按来源、许可证与时间冻结 provenance;
- 用多个基线 Agent 测难度,而非让构造者自报难度。
通用数据契约见 Agentic RL 数据与环境。
搜索任务:先建关系,再生成问题
直接让模型“出一道难题”经常得到事实拼接或含糊题意。GLM-5 先从早期搜索 Agent 的轨迹收集并去重 URL,保留超过两百万个高信息网页,再做实体识别、属性归一化、关系合并与语义一致性修正,形成 Web Knowledge Graph(WKG)。
任务生成沿图结构展开:
low/mid-frequency seed entity
  -> expand multi-hop neighborhood
  -> control subgraph overlap
  -> encode relational chain as question
  -> run search agents
  -> verify answer and evidence bidirectionally
难度过滤有三层:
- 无工具 reasoning model 独立尝试八次,只要一次答对就删除;
- 早期搜索 Agent 用少量浏览/计算步骤能解决则删除;
- verification agent 同时检查候选答案与标注答案,排除不唯一、证据矛盾或标签错误。
这条流程比“按罕见关键词出题”更容易产生多跳依赖,但知识图本身仍由模型抽取与修正,不能成为最终事实源。最终 verifier 必须回到可定位的网页证据,还要冻结网页版本;否则链接更新会让同一道题的真值漂移。
上下文管理:窗口不是记忆
搜索 Agent 的历史可以写成
其中 observation \(o_i\) 往往比 action 长得多。把所有 observation 永久保留会让早期页面吞噬窗口,也会使模型在噪声中重新寻找关键事实。
GLM-5 的 keep-recent-k 保留最近 \(k\) 轮,把更早 observation 替换为固定占位:
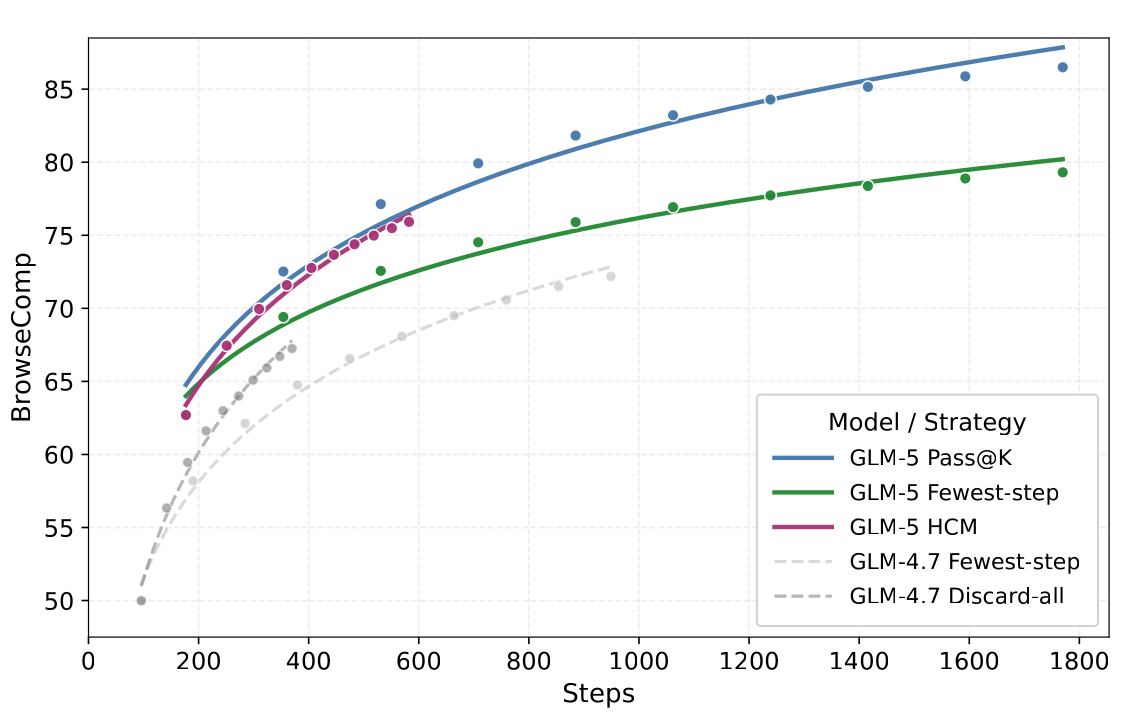
报告使用 \(k=5\),在其 BrowseComp 设置下从 \(55.3\) 提升到 \(62.0\)。进一步的层级策略在总长度超过 \(T=32\text{K}\) 时执行 discard-all,然后继续 keep-recent,最终报告 \(75.9\)。这些分数绑定报告指定的 OpenAI 官方 judge prompt 与 o3-mini judge,不能脱离评测设置比较。
下面的手写实现保留 reasoning/action,只折叠旧 observation:
def keep_recent(turns, k=5, token_count=None, reset_at=32768):
    if token_count is not None and token_count > reset_at:
        return []
    cut = max(0, len(turns) - k)
    out = []
    for i, turn in enumerate(turns):
        x = dict(turn)
        if i < cut:
            x["observation"] = "Tool result is omitted to save tokens."
        out.append(x)
    return out
turns = [{"reasoning": "r", "action": "search", "observation": str(i)} for i in range(8)]
folded = keep_recent(turns)
assert folded[2]["observation"].startswith("Tool result") and folded[3]["observation"] == "3"
代码表达的是报告策略,不代表它是通用最优。它有四个明显损失:
- 占位符没有保留旧 observation 的关键事实;
- discard-all 会同时丢掉未外化的中间结论;
- 固定 \(k\) 不区分一行结果与万 token 页面;
- token threshold 只看长度,不看未来价值。
更一般的 context manager 应把内容分成 immutable task state、recent interaction、verified facts、ephemeral observations,并用 provenance pointer 让被折叠内容可重新读取。相关设计见记忆、规划与上下文和长程 Agent。
Slide 生成:reward 如何反过来塑造环境
GLM-5 的 slide Agent 输出结构化 HTML,因此可以同时观察源码、浏览器布局和最终像素。报告将奖励分成三层:
| 层 | 观察对象 | 例子 | 主要漏洞 |
|---|---|---|---|
| L1 | 静态 markup | 字体、颜色、间距、语法、图片重复 | 写出表面合规属性 |
| L2 | runtime DOM | bounding box、宽高、overflow | 截断内容、操纵 spacing |
| L3 | rendered pixels | 异常留白、构图平衡 | 视觉模型偏好与域偏差 |
训练中出现了 hard truncation 和过度调 spacing 等 reward hacking,团队随后修正 renderer 和规则。这展示了一个普遍循环:
reward 不是静态标签,而是与策略共同演化的程序。每次改 verifier 后都应记录 revision,并回放旧轨迹;否则 reward 曲线跨版本不可比。
报告还把 RL 奖励用于 Best-of-\(N\) rejection sampling,按页面 mask 少量缺陷而保留同一轨迹中的好页面,再做 fine-tuning。这个组合把在线探索转成离线数据,但也可能把 verifier 偏差固化到语料中。应保留未参与训练的人工或独立模型评测。
团队报告 16:9 严格合规率从 \(40\%\) 到 \(92\%\),相对 GLM-4.5 的人工评测在内容、布局、美学和总体上分别得到 \(60\%\)、\(57.5\%\)、\(65\%\)、\(67.5\%\) win rate。这些都是内部协议下的结果;没有样本数、置信区间和完整 rubric 时,不应解释为通用设计能力。
训练轨迹:只优化模型动作
Agent 轨迹交错出现 prompt、model reasoning、tool call 与 environment observation。报告明确只用模型生成 token 优化,环境反馈不进入 loss。令 \(m_t=1\) 表示 action token,则
如果 observation 误进 loss,模型会被训练成复述 shell 输出或网页,而不是选择动作。工具调用的结构 token 是否属于 action、assistant reasoning 是否保存、失败恢复段是否 mask,都必须在 trajectory schema 中固定。
GLM-5 的 SFT 还有一个相关选择:保留轨迹中出现错误但后来成功恢复的段落,只 mask 错误 token 的监督损失,使后续恢复行为仍可学习。这和“删除所有失败轨迹”不同——能恢复的错误是决策过程的一部分,基础设施崩溃才是无关噪声。
Agent-as-a-Judge:评测运行中的系统
GLM-5 的内部 CC-Bench-V2 覆盖 frontend、backend 与 long-horizon chained coding。传统静态 judge 只看最终文本;Agent-as-a-Judge 会操作并检查生成产物:
- frontend 用浏览器检查 220 个任务、949 个 check-items;其中 130 个 check-items 用于 judge–human point-wise consistency 校准;
- backend 执行跨六种语言、每题约 5–10 个测试的任务;
- chained tasks 要求连续完成 3–15 个 commit,并在累积状态上运行测试。
报告称 frontend judge 在 130 个校准 check-items 上的 point-wise 一致率为 \(94\%\)、模型排序 Spearman 相关为 \(85.7\%\)。但它是内部 benchmark 与内部校准结果;任务、judge、完整 rubric 和运行环境没有充分公开,因此可支持“该团队构建了运行式评测”,不能支持独立复现排行榜。
一个 Agent judge 的证据层级应分开:
- 确定性检查:编译、测试、DOM 约束、文件状态;
- 语义检查:需求是否满足、改动是否合理;
- 偏好判断:视觉、美学、交互质量;
- 人工仲裁:处理 judge disagreement 与边界样本。
能写成程序的条件不应交给生成式 judge;必须用模型判断的部分要报告 judge 版本、prompt、重复采样、一致率和人类校准。通用方法见生成式 Judge 与 Agent 工具评测。
部署不是训练的附注
Agentic engineering 依赖长上下文、MoE、稀疏注意力和多轮 KV 复用,训练完成并不意味着任何硬件都能经济运行。GLM-5 报告以 Ascend Atlas 为例,给出三层适配:
量化
- 常规 attention/MLP 使用 W8A8;
- MoE experts 使用 W4A8;
- 用 QuaRot 旋转抑制 outlier,并用
Flex_AWQ_SSZ校准 scale。
这里必须保留参数计数口径:架构表的 744B 包含 MTP,却排除 embedding 与 output layer;芯片章节把部署对象写成约 750B,公开权重索引求和则约为 753.864B。它们不是三种模型尺寸,而是架构统计、工程近似与完整权重统计的差别;每 token 激活参数约为 40B。逐项账本见 GLM-5 模型账本。报告没有公开完整量化校准集、逐任务回归和低层配置,不能据文字复现同等精度。
Kernel
- Lightning Indexer 融合 score、ReLU 与 TopK;
- Sparse Flash Attention 并行选择 KV 与稀疏注意力;
- MLAPO 把 13 个 MLA preprocessing operator 融成一个 super-operator。
Runtime
- D2H sampling copy 与下一 decode step 重叠;
- RadixCache / Prefix Cache 复用长前缀;
- attention DP + expert parallel;
- FlashComm 隐藏 AllReduce;
- MTP 提高每轮产生的 token 数。
报告声称单节点性能可比双 GPU 国际集群、长序列部署成本下降 \(50\%\),但没有给出设备型号对齐、服务等级目标、并发、输入输出长度、功耗、软件版本与完整成本模型。因此这是作者报告的系统结果,不是可移植的性价比定律。通用拆解见量化、注意力 Kernel 与 GPU 执行。
一条任务应怎样被审计
对任意软件、终端、搜索或内容生成任务,可以沿下面七步检查:
- 来源:任务、仓库、网页和许可证能否定位;
- 环境:依赖、初态、工具权限与外部服务是否冻结;
- 动作:实际 token、tool schema 与模型版本是否完整;
- 反馈:策略失败、预算终止和环境故障是否分开;
- 验证:hidden verifier 是否隔离,是否存在 shortcut;
- 上下文:删除、折叠、检索和重启是否可追溯;
- 评测:harness、judge、预算、日期与不确定性是否可比。
Agentic engineering 的核心不是让模型输出更长,而是把一段不可控的交互变成有版本、可验证、可归因、可恢复的状态演化。只有这条闭环成立,训练增益才有机会从 benchmark 迁移到真实工作。
Reference
- GLM-5: from Vibe Coding to Agentic Engineering
- GLM-5 官方仓库
- RepoLaunch: Automating Repository Environment Construction
- Harbor:Agent Environment Evaluation Framework
- SWE-bench: Can Language Models Resolve Real-World GitHub Issues?
- SWE-bench Multilingual
- BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents
- QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs
- slime:LLM Post-Training Framework for RL Scaling
- AgentBench: Evaluating LLMs as Agents