合成数据
合成数据用模型、规则、模拟器或 verifier 生成新的训练对象。它可以扩大任务覆盖、构造稀有边界、蒸馏教师能力,也会复制生成器的盲点并让数据分布逐步收缩。关键不是“是否合成”,而是生成链、验证强度、真实数据锚点和训练权重。
问题分类
| 类型 | 生成什么 | 主要价值 | 主要风险 |
|---|---|---|---|
| Instruction synthesis | prompt、任务与示范 | 扩大接口和任务覆盖 | 模板同质化、错误示范 |
| Distillation | teacher logits 或回答 | 压缩能力与行为 | teacher 错误和偏差复制 |
| Verifier-guided generation | 可执行答案、代码、证明 | 自动筛选正确结果 | verifier 漏洞与分布过窄 |
| Simulation | 环境状态与轨迹 | 稀有或昂贵交互 | simulator 与真实环境偏差 |
| Self-training | 当前模型的高分样本 | 利用未标注输入 | 自我确认与多样性坍缩 |
同一批数据可能同时属于多类。例如由 teacher 生成、再由单元测试筛选的代码既是蒸馏,也是 verifier-guided synthesis。
数据契约
每条合成样本除普通来源字段外,还需保存:
generator family, exact version and decoding configuration
generation specification and input source
random seed or sample identifier
critic / verifier / judge version and raw outcome
selection, repair and dedup decisions
human review status
parent examples and derived variants
只保存最终文本会把生成器、筛选器和人工修正混成一个不可解释来源。teacher 或 verifier 更新后,旧样本不能继续使用同一个无版本标签。
数学与分布
将真实分布和合成分布按有效 token 混合:
\(\lambda\) 应按进入 loss 的 token 计算,而不是按文件数或样本数。筛选会进一步形成条件分布:
即使 verifier 完全判断“答案是否通过”,接受机制仍会偏向它容易验证的题型和格式。
若下一代模型只训练在前一代生成的数据上,误差与低概率模式会被不断重采样。关于 model collapse,研究需要区分两种设置:
- The Curse of Recursion 分析用生成数据替代真实数据时的退化;
- Is Model Collapse Inevitable? 表明在其研究条件下持续累积真实数据与合成数据可避免某些坍缩。
两者并不矛盾:是否保留真实锚点、生成误差、模型族和采样过程决定结论,不能把“合成数据必然失败”或“无限合成即可扩展”写成普遍规律。
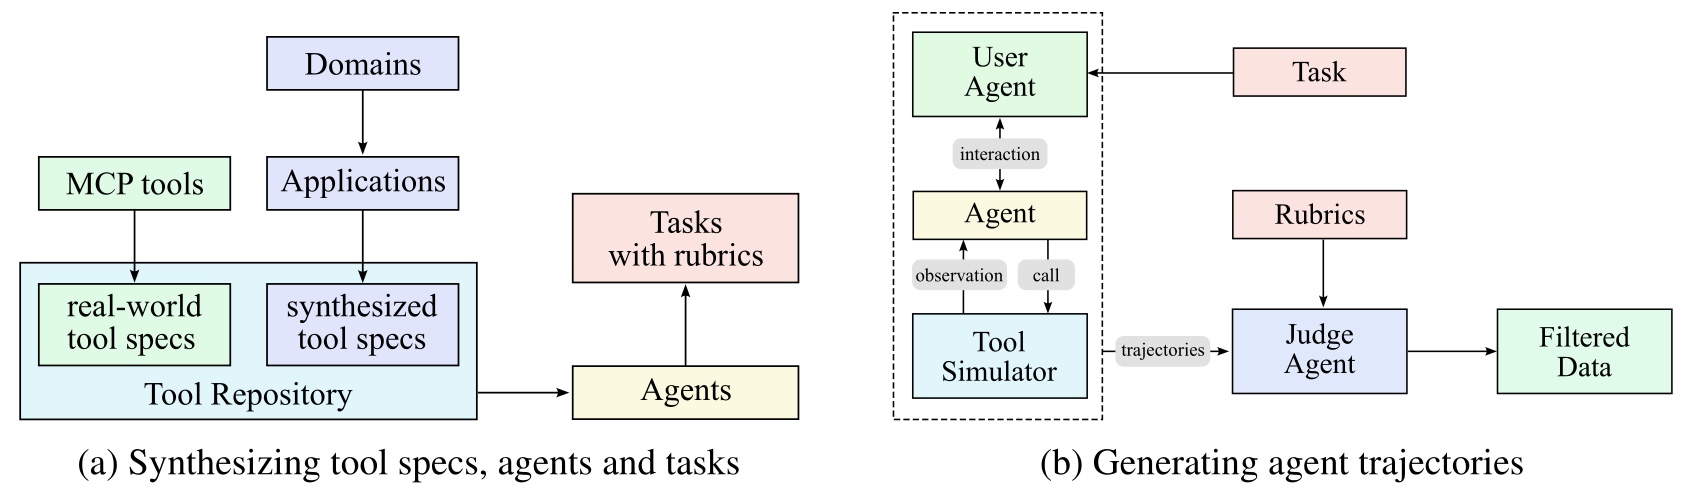
生成与筛选机制
从覆盖缺口出发
先定义真实数据缺少的轴:语言、领域、难度、工具失败、反例、长上下文或边界条件。若只让生成器自由扩写已有样本,通常增加的是表面变体而非新能力。
多通道验证
优先级通常是:
- 形式验证器、编译器、单元测试或精确环境终态;
- 独立规则和结构检查;
- 与生成器不同的 critic 或 judge;
- 分层人工抽检。
自动 judge 不是事实真值;它可能偏好自身风格、长度和固定措辞。可执行 verifier 也只验证其覆盖的性质,测试通过不证明规格完整。
保留失败样本
失败生成不应全部丢弃。若能确认失败类型,它们可用于:
- 构造 chosen/rejected pair;
- 训练错误检测与恢复;
- 扩展 verifier 测试;
- 分析生成器在何种 slice 上失效。
但未经确认的失败不能简单标成负例,infra error、超时和答案错误必须分开。
去重与切分
合成样本要与真实语料、teacher 输出、开发 prompt 和 benchmark 一起做 cluster-level 去重。先从测试题生成变体再切分,会把同一题族泄漏到训练与评测;应先冻结题族和时间边界,再在训练侧生成。
Generalized Knowledge Distillation 讨论了在 student 生成分布上进行蒸馏,以缩小 teacher-forcing 与部署分布的差距;具体目标见知识蒸馏。
正确性与失效
- 生成量替代覆盖:百万条同模板数据仍可能只覆盖极窄行为。
- teacher 与 judge 同源:共同偏差让错误高置信通过。
- 只保留成功:模型从未见过工具超时、格式错误和恢复路径。
- 修正后丢失原始版本:无法判断收益来自生成还是人工重写。
- 合成比例按样本报告:长推理轨迹可能占据绝大多数 token。
- 递归替代真实数据:罕见模式与尾部分布逐代消失。
- benchmark 派生污染:改写题目仍可能泄漏解法和答案。
- verifier 投机:模型优化测试漏洞、格式或超时策略而非任务本身。
何时不应生成
当高质量真实数据可低成本获得、任务需要真实世界时效或社会分布、verifier 无法判断核心正确性,或错误样本代价很高时,应优先收集和审查真实数据。合成数据也不适合替代独立测试集;评测必须保留生成器和 teacher 未接触的来源、时间与题族。
验证
- 报告真实/合成的文档、token、loss-token 和重复暴露比例。
- 按 generator、verifier、任务族、难度和语言做人工精度抽检。
- 比较真实基线、真实加合成、仅合成和不同 \(\lambda\) 的受控训练。
- 用新来源和新时间窗口评测,排除 teacher/benchmark 记忆。
- 测量多样性、答案正确、校准、长度和拒答,而非只看通过率。
- 对 verifier 做反例、对抗格式、超时和部分成功测试。
- 保存失败生成和拒绝原因,检查筛选是否系统性清空某些 slice。
推理轨迹从搜索进入训练的闭环见推理后训练,统计与污染检查见评测工具。