slime 与异步 Agentic RL:把长轨迹变成可训练的数据流
语言模型的在线强化学习最初容易被画成一个整齐的循环:采样一批回答,计算奖励,更新一次策略,再用新策略采下一批。这个图在短答案上尚可工作;一旦模型需要编译代码、操作终端、搜索网页,轨迹长度便会呈现长尾,环境还会发生超时、崩溃与网络抖动。此时最昂贵的不是某一次前向或反向,而是全局 barrier:最快的 GPU 必须等待最慢的环境。
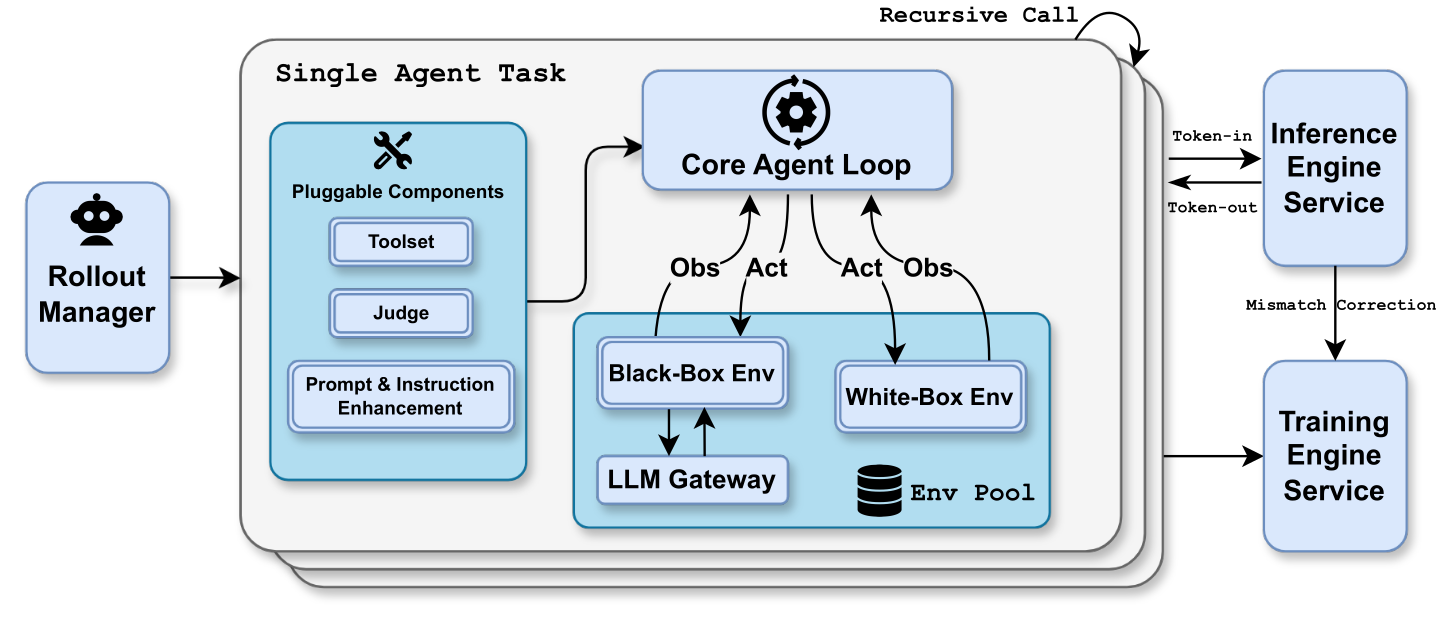
slime 把问题重新表述为一个持续运行的数据系统:
task service ──> rollout engine ──> trajectory gateway ──> learner
     ^                  |                    |                 |
     |                  v                    v                 v
environment <──── tool call/reward      version/filter    weight sync
GLM-5 技术报告披露了这套系统在长程 Agent 训练中的一次大规模落地:训练与推理解耦、中央多任务编排器管理超过千条并发 rollout、精确 token 轨迹避免二次分词、直接用 rollout 概率做重要性比率,并用版本与故障原因过滤不可靠样本。真正值得学习的不是“异步”这个标签,而是它如何同时守住三个契约:
- 动作契约:learner 优化的 token 必须就是 actor 当时采出的 token;
- 策略契约:每个 token 必须知道由哪个 policy revision、以什么概率产生;
- 环境契约:策略失败、预算终止与基础设施失败必须可区分。
整份 GLM-5 报告的逐项入口见 GLM-5,通用训练系统见 Agentic RL 训练系统,策略错位的数学背景见训练—推理分布错位。
为什么同步循环会形成气泡
设第 \(i\) 条轨迹的完成时间为 \(T_i\)。同步组采样必须等待
而这批 rollout 真正消耗的平均工作量接近 \(\frac1K\sum_iT_i\)。等待损失可写为
当 \(T_i\) 近似集中时,\(\Delta T\) 很小;工具型任务的时长通常重尾,少量超长 episode 会放大最大值,空闲 GPU 随组大小增长。异步流水线取消的是这道全局 barrier:推理端持续生成,攒到阈值就把可用轨迹送给训练端,二者运行在不同设备上。
这并不让慢轨迹消失,只是把“全员等待最慢者”改成“完成者先进入队列”。代价也随之转移:
- learner 训练时,rollout policy 可能已经落后;
- 同一条长轨迹甚至可能跨越多次推理权重更新;
- 快任务更早、更频繁进入训练,可能改变任务混合;
- 队列、权重同步和过滤规则共同定义了实际数据分布。
因此端到端目标不是单纯的 tokens/s,而是
被版本过滤、环境故障过滤或 mask 掉的 token 都不应计入分子。
解耦之后,系统里有四个时钟
异步训练至少同时推进四种“时间”:
| 时钟 | 典型标识 | 它回答什么 |
|---|---|---|
| 环境时钟 | step / tool-call index | Agent 在任务中走到了哪里 |
| rollout 时钟 | behavior revision | 这个 token 由哪版策略产生 |
| learner 时钟 | optimizer step | 当前策略已经更新了多少次 |
| 同步时钟 | inference refresh | 推理集群何时接收一版新权重 |
只保存一个“global step”无法重建它们的关系。GLM-5 的做法是训练端每 \(K\) 个梯度更新向推理端推送权重;轨迹记录生成过程中经历的版本序列 \((w_0,\ldots,w_k)\);若当前训练版本 \(w'\) 满足
就丢弃整条轨迹。用最旧版本而非末版本判断,是因为开头 token 已经改变了后续所有状态。
报告还称每次推理端刷新权重后重置 optimizer。这个选择可以避免同一 optimizer state 跨越不断变化的采样问题,但也会丢失动量和二阶矩积累;报告没有给出“重置 vs 保留”的消融。它应被理解为该系统的稳定性选择,而不是异步 RL 的普遍定理。
TITO:文本相同不等于动作相同
Text-in-Text-out 流水线只把最终字符串交给 learner,再用训练 tokenizer 重新编码。看似相同的文本,经过规范化、特殊 token 插入、工具模板拼接、截断或 tokenizer 版本变化后,可能得到不同动作序列。重要性比率却要求比较同一个动作:
若 learner 重编码后的 \(a_t\) 已不再是 behavior policy 实际采出的动作,这个比率没有正确语义。
Token-in-Token-out(TITO)直接传递 actor 产生的 token IDs、逐 token log-probability、边界与版本元数据。GLM-5 在任务服务与推理引擎之间放置 TITO Gateway,使下游环境仍可处理文本,同时由网关记录优化所需的精确动作流。
一个最小轨迹契约可以写成:
from dataclasses import dataclass
@dataclass
class Fragment:
    token_ids: list[int]
    behavior_logp: list[float]
    loss_mask: list[bool]
    weight_versions: list[int]
    terminal_reason: str
def validate(x: Fragment):
    n = len(x.token_ids)
    assert n == len(x.behavior_logp) == len(x.loss_mask)
    assert x.weight_versions == sorted(x.weight_versions)
    assert x.terminal_reason in {"success", "failure", "budget", "environment"}
真实系统还需要 prompt/template、tokenizer、tool schema、environment 与 verifier revision。这里刻意只保留最关键的对齐约束;更完整的字段见轨迹与策略契约。
Direct Double-Sided IS:校正、裁剪与丢弃的边界
从三策略接口到两策略接口
同步 PPO 常同时区分:
- 当前 learner \(\pi_\theta\);
- 目标函数中的 frozen old policy \(\pi_{\mathrm{old}}\);
- 真正执行采样的 rollout policy \(\mu\)。
在长异步轨迹中,完整保存所有历史 old checkpoints 很昂贵。GLM-5 直接复用采样时记录的 log-probability:
这省去单独的 old-policy forward,但并不会消除 off-policy bias:状态 \(s_t\) 本身仍由旧行为策略诱导,单步 action ratio 只校正已访问状态上的动作分布。
不是 PPO 的截断,而是 hard gate
报告给出的校准函数为
并写出
这和 PPO 的 min(clipped, unclipped) 不同:区间外 token 的梯度被完全删除,不是把 ratio 截到边界继续训练。它更接近 IcePop 一类 mismatch gating,但又移除了中间 old policy。
下面的核心实现同时返回 loss 与审计指标;区间判断采用报告中的开区间:
import torch
def direct_double_sided_loss(logp, behavior_logp, advantage, action_mask, eps_l=.2, eps_h=.28):
    ratio = (logp - behavior_logp).exp()
    accepted = (ratio > 1 - eps_l) & (ratio < 1 + eps_h) & action_mask.bool()
    weight = torch.where(accepted, ratio, torch.zeros_like(ratio))
    denom = action_mask.sum().clamp_min(1)
    loss = -(weight.detach() * advantage.detach() * logp).sum() / denom
    stats = {"accept_rate": accepted.sum() / denom, "ratio_mean": ratio[action_mask.bool()].mean()}
    return loss, stats
logp = torch.log(torch.tensor([.3, .2, .1], requires_grad=True))
old = torch.log(torch.tensor([.3, .1, .4]))
loss, stats = direct_double_sided_loss(logp, old, torch.ones(3), torch.ones(3, dtype=torch.bool))
assert 0 < stats["accept_rate"] < 1 and torch.isfinite(loss)
这里把 ratio 当作不反传的采样权重,与报告中“ratio 乘 advantage 再乘 log-prob”的写法相符;若让 ratio 和 log-prob 同时反传,会额外引入 \(\nabla\rho_t\) 项。论文没有把 stop-gradient 细节写清,因此复现时必须显式声明,而不能把两种实现混成同一目标。
三种不同的删除
GLM-5 的系统同时存在三层筛选:
- token gate:ratio 超出区间,只 mask 该 token;
- 版本 gate:轨迹最旧版本超过阈值,删除整条样本;
- 环境 gate:sandbox collapse 等基础设施故障,不作为策略失败训练。
组采样在环境过滤后还会出现残缺组。报告采用:有效样本超过组大小一半时,用有效样本重复补齐;否则丢弃整组。重复不会恢复被删轨迹提供的独立信息,还会改变有效样本权重。审计时至少应分别记录:
只看最终 reward 会把“策略变好”和“过滤器更激进”混在一起。
报告开头的组目标为何不能直接使用
GLM-5 在 Agentic Engineering 章节先写了
括号内对每一组恒等于零,而且公式里没有 \(\log\pi_\theta\)、policy ratio 或其他对 \(\theta\) 的依赖:
因此它不能作为可优化的 policy objective。结合后续 Direct Double-Sided IS 公式,最合理的解释是这里漏写了策略权重。一个具有梯度语义的基本形式应为
异步校正时再令
这里不是替作者猜一个唯一实现,而是把“恒为零的描述式”与“可产生梯度的训练式”分开。报告公式审计的其余问题见 GLM-5 的证据与勘误。
多任务编排器:任务比例也是优化器的一部分
不同任务拥有不同工具、环境、奖励和耗时。GLM-5 让每类任务以独立服务实现 rollout/reward 逻辑,再由中央 Multi-Task Rollout Orchestrator 统一注册、调度和标准化为 message list。报告给出的规模是超过 \(10^3\) 条并发 rollout。
中央编排不只是工程 glue。若任务 \(j\) 的外部到达率为 \(\lambda_j\)、并发槽位数为 \(c_j\)、平均完成时间为 \(T_j\)、验收率为 \(q_j\),稳定状态下进入 learner 的有效流率近似受
共同影响:到达不足时由 \(\lambda_j\) 限制,服务饱和时由 \(c_j/T_j\) 限制。即使入口按 \(1:1\) 发任务,短任务、并发预算更大或验收率更高的任务也可能支配训练。编排器至少应同时控制:
- 入队目标比例与完成后实际比例;
- 每类任务的并发、超时和重试预算;
- reward/length/token 的归一化;
- stale、故障与 ratio gate 后的有效 token 份额;
- 某个服务退化时是降权、暂停还是阻塞全局。
统一 message representation 解决了存储接口,却不能抹平 reward semantics。数学、代码、终端与搜索任务的“1 分”不天然可比。
DP-aware 路由:把 rollout ID 变成 cache key
多轮 Agent 每次请求都复用长前缀。若同一 episode 的相邻请求随机落到不同 data-parallel rank,KV cache locality 会消失,系统反复 prefill 旧历史。GLM-5 使用 consistent hashing,把 rollout ID 固定映射到一个 DP rank,并在 hash space 上做轻量再平衡。令 \(h(\cdot)\in[0,1)\),\(u_r\) 是 rank \(r\) 在环上的位置,一个概念化的 clockwise lookup 是:
它不同于简单的 \(h(\mathrm{id})\bmod N_{\mathrm{DP}}\):后者只在 \(N_{\mathrm{DP}}\) 固定时适合作为均匀映射示意,扩缩容会重映射大量 episode。环式或 rendezvous lookup 才能把成员变化的迁移范围控制在局部。于是每一轮只需处理新增 token,且无需跨 rank 同步整份 KV。这个设计成立需要三个条件:
- episode 生命周期内 affinity 稳定;
- worker 故障或扩缩容时有明确的 cache miss / remap 语义;
- 负载均衡不能频繁迁移热点 rollout,否则局部性收益被抵消。
它与 vLLM 的 PagedAttention、prefix/cache reuse 解决的是相邻层次的问题:前者决定请求去哪台副本,后者决定副本内 KV 如何组织与复用。
从 GLM-5 到 GLM-5.2:系统仍在演进
GLM-5.2 没有另发一份同等完整度的总技术报告;官方模型卡仍把 GLM-5 报告列为技术报告入口。GLM-5.2 发布说明进一步披露:
- 使用 slime 的并行 on-policy distillation,把十余个教师接入统一学生;
- 十余个 expert model 的并行服务把完整 OPD 流程压缩到约两天;发布说明没有给出“单次迭代”耗时或 \(2\times\) 吞吐数字;
- 上下文扩至 1M,并通过 IndexShare 降低 DSA indexer 成本;
- MTP 从 3 个扩到 7 个预测步,加入 IndexShare、KVShare 与端到端 total-variation loss。
这些属于后续谱系增量,不能反写成 GLM-5 报告已经包含的内容。IndexShare 的架构线见 IndexCache 与 IndexShare,蒸馏线见 On-Policy Distillation,模型版本边界见 GLM 演化时间线。
怎样复现才算回答了系统问题
一个小规模复现实验不必拥有千张 GPU,但应保留同样的因果变量:
- 用短任务与重尾长任务构造可控 mixture;
- 对比同步 barrier、异步队列和不同 refresh interval;
- 记录每 token 的 behavior log-prob、revision 与 loss mask;
- 扫描 \(\tau,\epsilon_\ell,\epsilon_h\),同时报告 reward 与数据接受率;
- 注入 environment crash,确认它不会被编码成策略负奖励;
- 对比 TITO 与一次刻意造成 tokenizer drift 的 text round-trip;
- 报告 effective tokens/s,而非只报 rollout tokens/s;
- 分任务报告实际 learner mixture,识别 completion-time bias。
最重要的对照不是“异步比同步快多少”,而是“在相同有效样本预算与可比 policy lag 下,吞吐和策略质量怎样变化”。如果异步系统靠丢掉大部分困难长轨迹获得速度,它优化的是数据分布,不只是调度。
Reference
- GLM-5: from Vibe Coding to Agentic Engineering
- GLM-5 官方仓库
- slime:LLM Post-Training Framework for RL Scaling
- GLM-5.2 官方模型卡
- GLM-5.2 发布说明
- Every Step Evolves: Scaling Reinforcement Learning for Trillion-Scale Thinking Models
- DAPO: An Open-Source LLM Reinforcement Learning System at Scale
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models
- Asynchronous Methods for Deep Reinforcement Learning