视频生成:在时间中维持一个可相信的世界
单张图像只需让一个瞬间自洽,视频却要让同一个世界持续存在。人物转身后仍应是同一个人,杯子被拿走后不能凭空回到桌上,镜头运动要和透视变化一致,声音还要在正确时刻发生。于是视频生成的核心不是“多生成几张图”,而是同时解决四种尺度:
- 帧内的纹理、文字与几何;
- 相邻帧的运动和遮挡;
- 跨镜头的身份、场景与事件状态;
- 条件、动作和声音在真实时间轴上的同步。
理解这四层,可以避免把一次漂亮的短片当成可持续模拟,也可以解释为何视频模型不断在自回归、扩散、分块因果和世界模型之间重新组合。
本页关注“怎样合成时间”。采样、事件定位和长视频证据检索的另一面见视频理解;timestamp、二维/三维位置与 mask 的统一约定见时间、位置与可见性。
早期分解:外观负责“是什么”,运动负责“怎样变”
最早的神经视频生成沿用 GAN 的隐式分布学习,但很快发现单个 latent 难以同时控制身份与运动。Video GAN 把前景运动和静态背景分开,MoCoGAN 则把内容 latent 与随时间演化的 motion latent 分开:
这种分解很有启发性:不随时间改变的因素应共享状态,变化因素才逐帧更新。但 GAN 训练既要骗过逐帧判别器,又要骗过视频判别器;模式坍缩、长程漂移和有限分辨率很难同时解决。更根本地说,连续 latent 没有显式回答“一段已生成历史之后,下一个事件是什么”。
离散 token 给出了另一种写法。VideoGPT 先用 VQ-VAE 压缩视频,再自回归生成时空 token。设原视频为
时空 tokenizer 的压缩率为 \((s_t,s_h,s_w)\),latent 网格为
若展平生成,序列长度 \(N=T'H'W'\)。自回归分解
提供清晰的因果续写,却把空间和时间都变成串行步;tokenizer 的重建误差也会成为生成质量的上限。
扩散为何改变了视频生成
Video Diffusion Models 把图像扩散扩展到时空数据,并探索同时训练图像与视频。前向噪声仍可写成
训练目标为
区别不在公式,而在 \(\epsilon_\theta\) 必须识别哪些变化是物体运动、镜头运动、遮挡,哪些只是逐帧噪声。扩散的全局迭代允许后续步骤同时修正许多帧,比严格逐 token 生成更容易维护短片的一致性。
直接在像素视频上去噪代价极高,因此 latent diffusion 成为主线。Latent Video Diffusion Models 在压缩时空表示上生成;Stable Video Diffusion 系统讨论了数据筛选、图像预训练和高质量视频微调。这里形成了一个重要工程规律:
它利用了图像数据的规模,却也埋下“会画但不会动”的失败:如果视频训练只占很小部分,模型容易把相邻帧变成轻微形变的静态图。
空间与时间怎样进入 Transformer
视频 latent patch 化后可以写成
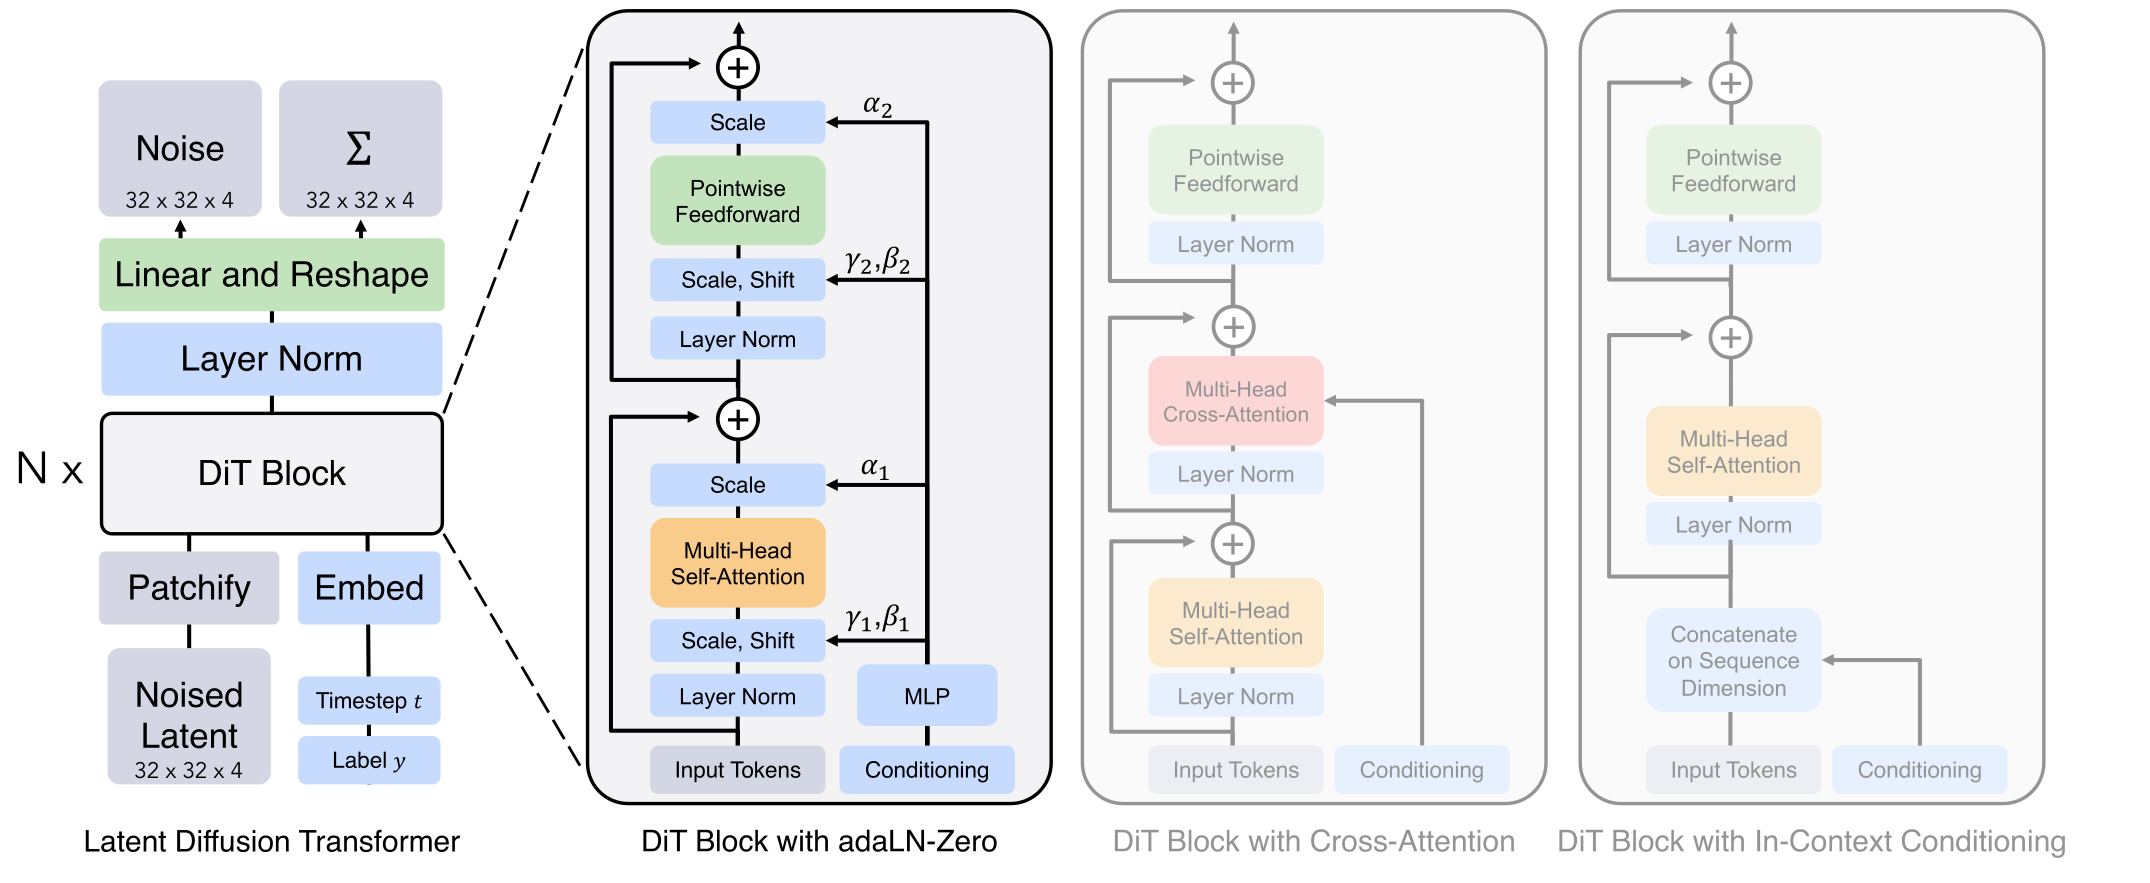
全时空 attention 的代价近似 \(O(N^2)\),分辨率或时长翻倍都会迅速扩大成本。Latte 系统研究了空间与时间 Transformer 的分解设计;常见实现包括:
- 先对每帧做空间 attention,再沿同一空间位置做时间 attention;
- 局部窗口处理细节,稀疏全局 token 传递长程状态;
- 3D patch 或因果 3D 卷积先压缩,再交给 Transformer;
- 图像与视频混训时,对单帧样本退化为合法的 \(T_p=1\) 情形。
位置契约同样重要。时间位置应来自 timestamp,而不只是 frame id:
不同 fps 的视频若只按帧号编码,同一个位置差可能分别代表 \(1/24\) 秒和 \(1/60\) 秒。可变帧率素材还必须读取容器 timestamp;简单假定恒定 fps 会让音画同步和速度控制在训练前就出错。
三种时间可见性:整段、逐帧与分块因果
视频模型真正的行为由 mask 决定,而不只由网络名决定。
整段双向生成
全部帧互相可见,模型能在去噪时联合修正片头和片尾,适合固定长度 clip。代价是必须预先知道总时长,无法自然地边生成边播放;把短窗口滑动到更长视频还会产生接缝。
严格自回归
第 \(t\) 帧只能看过去:
它适合续写和在线交互,却会累积误差,并且同一帧内部若也逐 token 因果生成,串行成本过高。
分块因果
把相邻 \(m\) 帧组成一个 chunk。chunk 内双向,chunk 间只看过去:
它在局部一致性和长视频续写之间折中。下面代码构造这种 attention 可见性。输入 token 顺序约定为 chunk → frame → spatial token;返回 True 表示可见,不是需要填 -inf 的 blocked mask。
import torch
def block_causal_visibility(chunks, frames_per_chunk, spatial_tokens):
    if min(chunks, frames_per_chunk, spatial_tokens) <= 0:
        raise ValueError("all dimensions must be positive")
    per_chunk = frames_per_chunk * spatial_tokens
    chunk_id = torch.arange(chunks * per_chunk) // per_chunk
    return chunk_id[None, :] <= chunk_id[:, None]
visible = block_causal_visibility(3, 2, 4)
assert visible.shape == (24, 24)
assert visible[:8, :8].all()
assert not visible[:8, 8:].any()
assert visible[16:, :16].all()
接入 PyTorch attention 前必须确认 API 的布尔语义:有的实现以 True 表示允许,有的以 True 表示屏蔽。若语义取反,训练不会立即报错,却会让模型偷看未来或完全看不到历史。还要区分:
padding mask:batch 中不存在的帧/token;causal mask:真实存在但尚未到达的未来;conditioning mask:首帧、参考图或已知区域;loss mask:哪些位置参与监督。
四者合成时应保留单元测试,而不是依赖广播“碰巧正确”。
文本、图像、轨迹和动作如何控制同一时间轴
文本到视频只提供高层语义,通常不能精确说明对象在何时出现、向哪里移动。更强的控制包括:
- 首帧/末帧或关键帧,约束外观与状态端点;
- camera path、depth、pose、flow 或 bounding box,约束几何运动;
- 局部 mask 与参考角色,约束身份和编辑区域;
- 时间 span 文本或 storyboard,约束事件顺序;
- 动作 \(a_t\),约束交互式环境的状态转移。
条件可以通过 cross-attention、额外 control encoder 或 residual branch 注入。无论形式如何,都应把时间坐标对齐到相同单位。若轨迹是 30 fps、latent 是 8 fps,不能靠截断到相同长度;应先按 timestamp 重采样并说明插值规则。
图像到视频尤其容易出现一种误解:首帧像素一致不等于身份在后续保持。模型还要区分“应保持不变的外观”和“必须变化的可见面”。把首帧特征无限强地复制到后续,会冻结运动或造成物体转身时纹理贴纸般滑动。
从短片到长视频:记忆不是把窗口加长
长视频至少有两种一致性:
- 感知一致性:人物、服装、场景和光照相对稳定;
- 状态一致性:对象位置、数量、因果结果与叙事目标正确延续。
更大的 context window 只能提高保存历史的机会,不能保证模型学会选择哪些历史是状态。实用系统往往采用层级结构:
每生成一个 chunk,系统可以把关键实体、相机、动作结果和剩余目标压缩为显式 memory,再与局部视觉 cache 一同传给下一段。纯文本摘要省 token,却可能丢失外观;只保留视觉 KV cache 又难以纠正错误状态。两者组合时要记录 provenance,避免一个早期幻觉被后续当成硬条件。
Phenaki 以时序 token 和随时间变化的 prompt 研究长视频生成;VideoPoet 把多种视频生成与编辑任务统一成 token 序列。近期的 MAGI-1 与 Self Forcing 分别探索自回归分块扩散和训练—推理暴露差异。它们给出的长时结果均属于作者报告;判断真正的长程能力仍需看连续生成协议、是否重采样最佳片段,以及状态错误随时长的增长曲线。
视频、声音与世界状态
音画联合生成不是最后再配一条音乐。画面事件有 onset、持续时间和因果延迟;音频采样时钟远密于视频帧。设视频帧 timestamp 为 \(\tau^v_i\),音频 frame timestamp 为 \(\tau^a_j\),同步条件应基于真实时间:
撞击声可以略晚于接触画面,背景音乐则只需场景级语义一致。评测若把所有音画关系都压成 clip-level 相似度,会错过口型漂移和事件提前。MMAudio 研究了视频条件音频生成中的语义与同步对齐;它代表的是“由视频生成声音”,不等价于一个同时联合采样所有模态的世界模型。
视频预测也不自动等于世界模型。若系统只学
它可以生成 plausible future,但不知道智能体执行了什么。决策所需模型至少要显式接收动作:
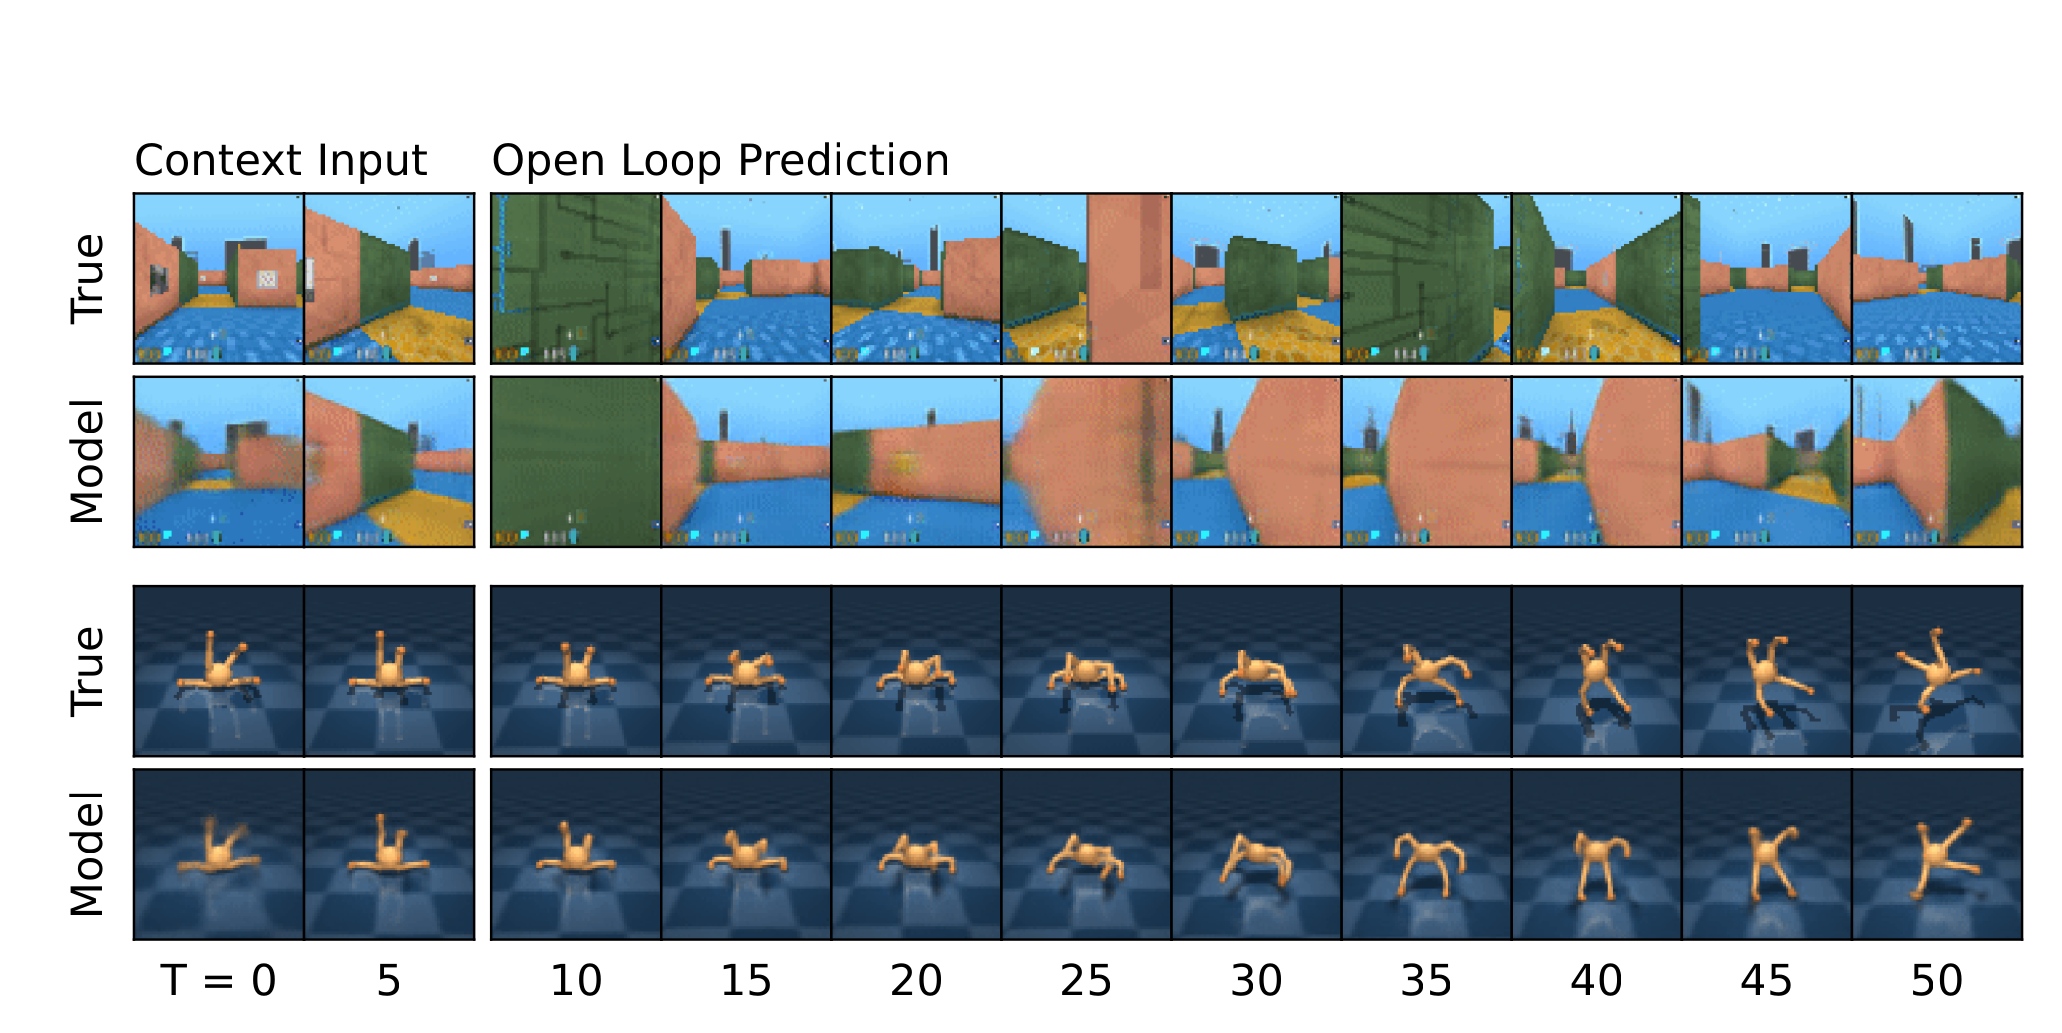
并在规划与真实反馈中检验。GameNGen 和 Cosmos 将生成视频与可交互/物理世界建模联系起来;论文结果是作者报告,不能仅凭视觉逼真度推断可控性、因果性或长期规划价值。关于闭环状态、动作与规划的严格边界见世界模型总览。
实现契约:一个视频不是一个四维数组就够了
| 项 | 契约 |
|---|---|
| 原始媒体 | uint8/float [B,T,H,W,C] 或 [B,C,T,H,W] 必须明确;颜色空间、range 和 gamma 固定 |
| 时间 | 使用 container timestamp;声明 fps 是否恒定、clip 起点和时长 |
| latent | [B,C_z,T_z,H_z,W_z];明确时空压缩率、padding 和 causal/non-causal encoder |
| patch token | 展平顺序固定;位置编码可还原到 (time,row,col) |
| condition | 文本、参考帧、轨迹、动作都带 span/timestamp;缺失条件有独立 mask |
| attention | 明确 full、frame-causal 或 block-causal;padding 与 future 分开 |
| cache | KV/卷积 state 的有效时间范围、淘汰策略和 chunk reset 条件固定 |
| decode | latent overlap、像素 overlap、色彩转换和帧率转换不能重复执行 |
| 音频 | 起始 offset、采样率、音频 codec frame rate 与视频共同使用秒级时钟 |
3D VAE 若使用非因果时间卷积,编码当前 chunk 时可能读取未来帧。离线训练正常,在线生成却无法复现同一 latent。声称“流式”时必须把 tokenizer、denoiser 和 decoder 三层的未来可见性分别列出。
失效模式:看起来会动,不等于事件成立
身份与对象漂移
角色面部、服装纹理和物体数量随时间变化。应做 track-level 身份与属性评测,而非只挑几帧算图文相似。
运动合理但因果错误
每一帧都自然,事件顺序却相反,接触前已经出现声响,物体穿过障碍。需要事件状态、contact 和反事实动作测试。
镜头运动掩盖物体运动
大幅 pan/zoom 能制造“动态感”,却可能没有对象层运动。评测应分离 optical flow 的全局相机分量与局部对象分量。
重复、冻结与时间伸缩
模型可能循环几帧、在难处冻结,或用慢动作填满目标时长。报告“生成 16 秒”时还应测有效新事件、重复率和真实速度遵循。
条件在后半段衰减
文本中的次要对象或后续动作随着生成推进消失。应按时间位置计算条件遵循,而不是只在整段上取平均。
tokenizer 与 chunk 接缝
时空压缩会抹去快速运动;独立解码各 chunk 会产生颜色、相位或运动跳变。必须分别检查 latent 边界和最终像素边界。
评测:把画质、运动、条件和系统成本拆开
FVD 等分布指标提供整体距离,但强依赖特征网络、clip 长度、分辨率和样本数;不能说明是哪种能力改善。一个可诊断矩阵至少包括:
| 维度 | 检查 | 必须控制 |
|---|---|---|
| 单帧质量 | 人工偏好、图像分布/感知指标 | 抽帧位置、分辨率、压缩 |
| 运动 | flow、动作与相机轨迹、动态程度 | fps、速度、全局/局部运动 |
| 时间一致 | 身份 track、对象 permanence、闪烁 | 时长、遮挡、镜头切换 |
| 文本遵循 | 对象、属性、关系、事件顺序 | prompt rewrite、seed、best-of-\(N\) |
| 控制 | 首末帧、pose、depth、trajectory error | control strength、条件覆盖率 |
| 长程 | 重复率、状态错误、叙事完成 | 连续生成还是分段剪辑 |
| 音画 | onset error、口型与事件同步 | 音频 offset、采样率、静音对照 |
| 系统 | latency、吞吐、峰值显存、成本 | 硬件、步数、精度、并发 |
| 安全 | 训练近邻、身份滥用、水印 | 参考来源、攻击 prompt、转码 |
人工评测应随机顺序、隐藏系统名,并把画质、运动真实性、条件遵循、故事一致性分开提问。若系统使用 prompt expansion、多次采样、外部增强或人工剪辑,必须计入协议;只展示最佳样例无法估计一次生成的成功概率。
变化中的前沿边界
以下内容核验至 2026-07-28。论文中的架构、规模和实验结论均作为作者报告;官方演示或服务页面只作为产品披露。对于未公开训练数据、模型结构、推理链路和上线版本差异,不从演示效果反向推断。
- Sora 官方研究页面披露了以时空 patch 表示视频、生成不同时长和分辨率的思路;这是产品/研究披露,不足以重建未公开训练配方。
- Wan 2.1、HunyuanVideo 与 CogVideoX 公开了各自的视频生成系统与实验。跨报告比较时必须对齐分辨率、时长、prompt、采样步数和人工协议。
- Diffusion Forcing 尝试让序列各 token 处在不同噪声水平,以连接生成、预测与规划;它提供了统一视角,但具体任务收益仍是相应实验设定下的作者报告。
- MOVA 研究可扩展、同步的视频—音频联合生成;其同步与质量结论是作者报告,不代表未披露版本的在线产品能力。minWM 则公开了实时交互视频世界模型的全栈框架;应以论文中的动作接口和闭环实验为边界,不把“world model”名称直接等同于已验证的通用物理因果或规划能力。
- TempCache 探索视频扩散推理中的时间缓存复用。加速结果必须连同模型、分辨率、视频长度、采样器、误差容忍和硬件阅读,不能只比较单个倍速数字。
前沿系统越来越像联合工程:数据去重与字幕、时空 tokenizer、图像先验、条件编码、生成目标、并行/缓存、后处理和安全协议共同决定结果。新的模型名不会取消这些接口,反而更要求把每一层公开到足以复现的程度。
时空 patch、block-causal mask 与 rollout 边界测试见多模态手撕实现。
Reference
- Vondrick et al., Generating Videos with Scene Dynamics
- Tulyakov et al., MoCoGAN: Decomposing Motion and Content for Video Generation
- Yan et al., VideoGPT: Video Generation using VQ-VAE and Transformers
- Ho et al., Video Diffusion Models
- Singer et al., Make-A-Video: Text-to-Video Generation without Text-Video Data
- Villegas et al., Phenaki: Variable Length Video Generation From Open Domain Textual Descriptions
- Ho et al., Imagen Video: High Definition Video Generation with Diffusion Models
- Blattmann et al., Align your Latents: High-Resolution Video Synthesis with Latent Diffusion Models
- Blattmann et al., Stable Video Diffusion: Scaling Latent Video Diffusion Models to Large Datasets
- Kondratyuk et al., VideoPoet: A Large Language Model for Zero-Shot Video Generation
- Ma et al., Latte: Latent Diffusion Transformer for Video Generation
- Bar-Tal et al., Lumiere: A Space-Time Diffusion Model for Video Generation
- OpenAI, Video generation models as world simulators
- Chen et al., Diffusion Forcing: Next-token Prediction Meets Full-Sequence Diffusion
- Yang et al., CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer
- Valevski et al., Diffusion Models Are Real-Time Game Engines
- Polyak et al., Movie Gen: A Cast of Media Foundation Models
- Kong et al., HunyuanVideo: A Systematic Framework For Large Video Generative Models
- Cheng et al., MMAudio: Taming Multimodal Joint Training for High-Quality Video-to-Audio Synthesis
- Agarwal et al., Cosmos World Foundation Model Platform for Physical AI
- Wan Team, Wan: Open and Advanced Large-Scale Video Generative Models
- Teng et al., MAGI-1: Autoregressive Video Generation at Scale
- Huang et al., Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion
- MOVA Team, MOVA: Towards Scalable and Synchronized Video-Audio Generation
- TempCache Team, Fast Autoregressive Video Diffusion and World Models with Temporal Cache Compression and Sparse Attention
- minWM Team, minWM: A Full-Stack Open-Source Framework for Real-Time Interactive Video World Models