Agent 与工具评测
Agent 评测的对象不是最终一段文本,而是模型在有状态环境中选择动作、调用工具、遵守规则并达到目标的完整 episode。成功必须由真实环境终态验证,未授权副作用必须独立于主任务成功记录。
环境协议
一个任务实例至少冻结:
task intent and user-visible constraints
initial environment/database/filesystem state
tool names, schemas, implementations and permissions
policy/rule set and untrusted content
target state and accepted equivalence
forbidden states and side effects
turn/token/tool/time/cost budgets
environment, user-simulator and harness revisions
文字声称“已完成”不是终态证据;API 返回 200 也不保证业务状态正确。应在 episode 结束后从权威状态重新读取。
统计单位与状态
以 task instance 为 cluster、trial 为嵌套重复。逐 trial 至少标记:
success
task failure
policy violation
invalid action / arguments
tool or environment timeout
infrastructure error
user simulator failure
partial state change
unauthorized side effect
unknown final state
主任务成功与安全结果是两个轴:
| 主任务 | 未授权副作用 | 解释 |
|---|---|---|
| 成功 | 无 | 完整成功 |
| 成功 | 有 | 能力成功、安全失败 |
| 失败 | 无 | 普通任务失败 |
| 失败 | 有 | 任务与安全双重失败 |
把“成功但越权”的 episode 只记 success 会掩盖最重要风险。
pass@\(k\) 与 pass\(^k\)
至少一次成功
每题生成或运行 \(n\) 次,其中 \(c\) 次成功,pass@\(k\) 的常用无偏估计为
它回答“给 \(k\) 次机会,至少一次成功”的能力/搜索问题。
连续可靠成功
pass\(^k\) 回答“同一任务独立运行 \(k\) 次,是否每次都成功”。若单次成功概率固定为 \(p\) 且 trial 独立,理想值为
实测可对每个 task 的 \(k\) 个预注册 trial 取成功乘积,再跨 task 平均。\(\tau\)-bench 提出 pass\(^k\) 衡量工具 Agent 多次交互的一致性。
pass@\(k\) 随机会增加,pass\(^k\) 随 \(k\) 增大更严格;二者不能混写。实现还必须冻结随机种子、用户模拟器和“独立 trial”的定义。
组合式实现可以避免先计算巨大二项式。输入 n 是实际完成的预注册 trial 数,correct 只统计满足终态与权限谓词的成功;timeout、invalid 和 infra failure 是否进入 \(n\) 必须由评测协议先决定。
def pass_at_k(n, correct, k):
    if not 0 <= correct <= n or not 1 <= k <= n:
        raise ValueError("invalid trial counts")
    if n - correct < k:
        return 1.
    miss = 1.
    for i in range(k):
        miss *= (n - correct - i) / (n - i)
    return 1 - miss
assert pass_at_k(10, 0, 3) == 0
assert pass_at_k(10, 2, 9) == 1
assert abs(pass_at_k(10, 2, 1) - .2) < 1e-12
pass\(^k\) 则要求每个 task 的全部预注册运行都成功,再跨 task 平均。输入保留 task 边界,不能把所有 trial 展平后计算总体成功率的 \(k\) 次方。
def pass_power_k(outcomes):
    if not outcomes or any(not trials for trials in outcomes):
        raise ValueError("every task needs repeated trials")
    widths = {len(trials) for trials in outcomes}
    if len(widths) != 1:
        raise ValueError("all tasks must use the same pre-registered k")
    if any(type(result) is not bool for trials in outcomes for result in trials):
        raise ValueError("trial outcomes must be explicit booleans")
    per_task = [all(trials) for trials in outcomes]
    return sum(per_task) / len(per_task), per_task
rate, per_task = pass_power_k([
    [True, True], [True, False], [False, False],
])
assert rate == 1 / 3
assert per_task == [True, False, False]
assert pass_power_k([[True, True], [True, True]])[0] == 1
pass@\(k\) 回答多次候选中“至少一次成功”的覆盖能力,pass\(^k\) 回答同一系统能否连续可靠成功,随 \(k\) 的方向相反。两者的组合实验见评测工具。生产报告要按 task 先计算并再聚合,保留随机种子、环境版本、trial 相关性和权限违规;“主任务完成但越权”不能计为成功。
指标分解
任务与过程
- final-state task success;
- 必要子目标完成率;
- invalid tool/action rate;
- recovery after tool error;
- redundant/repeated actions;
- policy/rule compliance;
- user clarification quality。
过程分数不能替代终态。更短轨迹也不必然更好:需要澄清或验证的动作可能提高可靠性。
权限与副作用
还应按严重度和对象分层:
- 读到无权数据;
- 将数据发送到错误对象;
- 写入、删除或购买超出授权;
- 跨租户访问;
- 重试产生重复副作用;
- 注入导致攻击者目标完成。
分母不能只用主任务成功 episode。
成本与时延
逐 episode 记录:
model tokens and generations
tool calls and retries
retrieval/network bytes
queue/model/tool/user-simulator latency
wall-clock to terminal state
external/API/compute cost
时延至少拆成 model thinking/generation、tool execution、environment transition 和 judge/verifier。只报总时延无法定位瓶颈。
Harness 与状态可重放
可靠 harness 需要:
- 任务间环境隔离与 deterministic reset;
- 每个动作前后 state digest;
- tool request/response 与错误状态;
- 幂等键、重试和取消语义;
- 环境时钟、网络和外部依赖冻结;
- judge 与终态 verifier 分离;
- 失败后保留完整轨迹而不污染下一任务。
WebArena 以网站环境评估 Agent,OSWorld 使用真实计算机环境,SWE-bench 以仓库 issue 和测试评估代码修复。它们的 container、网站、VM、tests 和工具版本都是测量对象的一部分。
GAIA 与 AgentBench 覆盖更广的工具与环境任务;BFCL 聚焦函数调用格式与语义。不同 benchmark 的 success verifier 和外部访问不同,分数不能直接合成通用 Agent 能力。
注入与攻击
Agent 会读取网页、邮件、文档、代码注释、图像文字和工具结果。攻击测试应包含:
- direct/indirect prompt injection;
- 伪造 tool result 或高优先级指令;
- 跨轮延迟触发;
- 编码、隐藏文本和多模态载荷;
- 合法任务与攻击任务同时存在;
- adaptive attacker 根据 Agent 行为修改内容。
AgentDojo 提供了工具 Agent 间接注入的动态环境。评测要同时测 benign task success、attack success 和防御引入的 utility loss。
DeepSeek-V4 的协议拆解
DeepSeek-V4 报告把 reasoning、长上下文、tool agent、内部工作任务和员工问卷放在一起展示;比较时必须保留各自 harness:
- Codeforces 使用 2025-05 至 11 月的 14 场 Div.1、114 题;每题先生成 32 个候选,再随机无放回取 10 个并排序,以人类同失败数的 median penalty 计算 contest rank,最终对随机序列求期望 rating;
- reasoning 三档 context budget 为 Non-think 8K、High 128K、Max 384K,不能把 effort 增益解释成纯 checkpoint 差异;
- code / search agent 最多 500 step、512K context;BrowseComp 采用 discard-all context policy;
- Terminal-Bench 表格给的是原始 2.0 分数,正文另提 Verified subset 约 72,两者不是同一分母;
- K2.6 / GLM 的空值包含 API busy,GPT-5.4 的部分长上下文空值来自 API failure,不能记作 0 分;
- 内部 30 个 white-collar task、约 200→30 个工程任务和 85 人员工问卷适合做组织内产品信号,不具备公开 benchmark 的独立复现性。
长上下文同样有两种口径:表格中的 MRCR 1M 聚合分数与 Figure 9 的 8-needle 1M 单点曲线不同。完整图表、分母和证据边界见 V4 总深读,103 项 benchmark / method 来源见 V4 引用图谱。
正确性与失效
- 最终文本代替环境状态:虚假完成。
- HTTP 成功码代替业务终态:部分失败被漏掉。
- infra error 记模型失败:能力与系统可靠性混淆。
- infra error 从分母全删:端到端可用性被高估。
- 只看平均成功:同一任务多次不稳定被掩盖。
- pass@\(k\) 与 pass\(^k\) 混用:搜索与可靠性方向相反。
- 主任务成功掩盖越权:安全失败未计。
- 重试不计成本/副作用:最终成功被过度美化。
- 环境未 reset:前一任务状态泄漏。
- judge 读到攻击文本:评分器也被注入。
何时不用完整 Agent benchmark
若模型只需输出一个无状态、可程序验证的函数参数,函数调用 benchmark 足够;没有工具和外部状态的文本任务不需要模拟复杂环境。完整 Agent harness 的成本应由真实状态、权限和长程交互需求驱动。
报告卡
task family and target population
environment/tool/policy/harness revisions
initial/target/forbidden state definitions
model/template/sampling and budgets
task/trial/cluster counts
success/failure/infra/unknown denominators
pass@k and pass^k definitions
unauthorized side effects and severity
tokens/tool calls/latency/cost
injection threat model and adaptive budget
effect/cluster CI and known environment limits
安全攻击矩阵见安全评测,统计重采样见统计推断,最小状态与 pass 指标实现见评测工具。
GLM-5 的运行式 coding 评测
GLM-5 报告的内部 CC-Bench-V2 不只读最终文本,而是让 Agent-as-a-Judge 操作产物:frontend 有 220 个任务、949 个 check-items,backend 有 85 个跨六语言任务、每题 5–10 个测试,long-horizon 任务串联 3–15 个 commit 并运行累积测试。报告另从 frontend 抽取 130 个 check-items 做 judge–human point-wise consistency 校准,不能把这个子样本误当成完整评测规模。
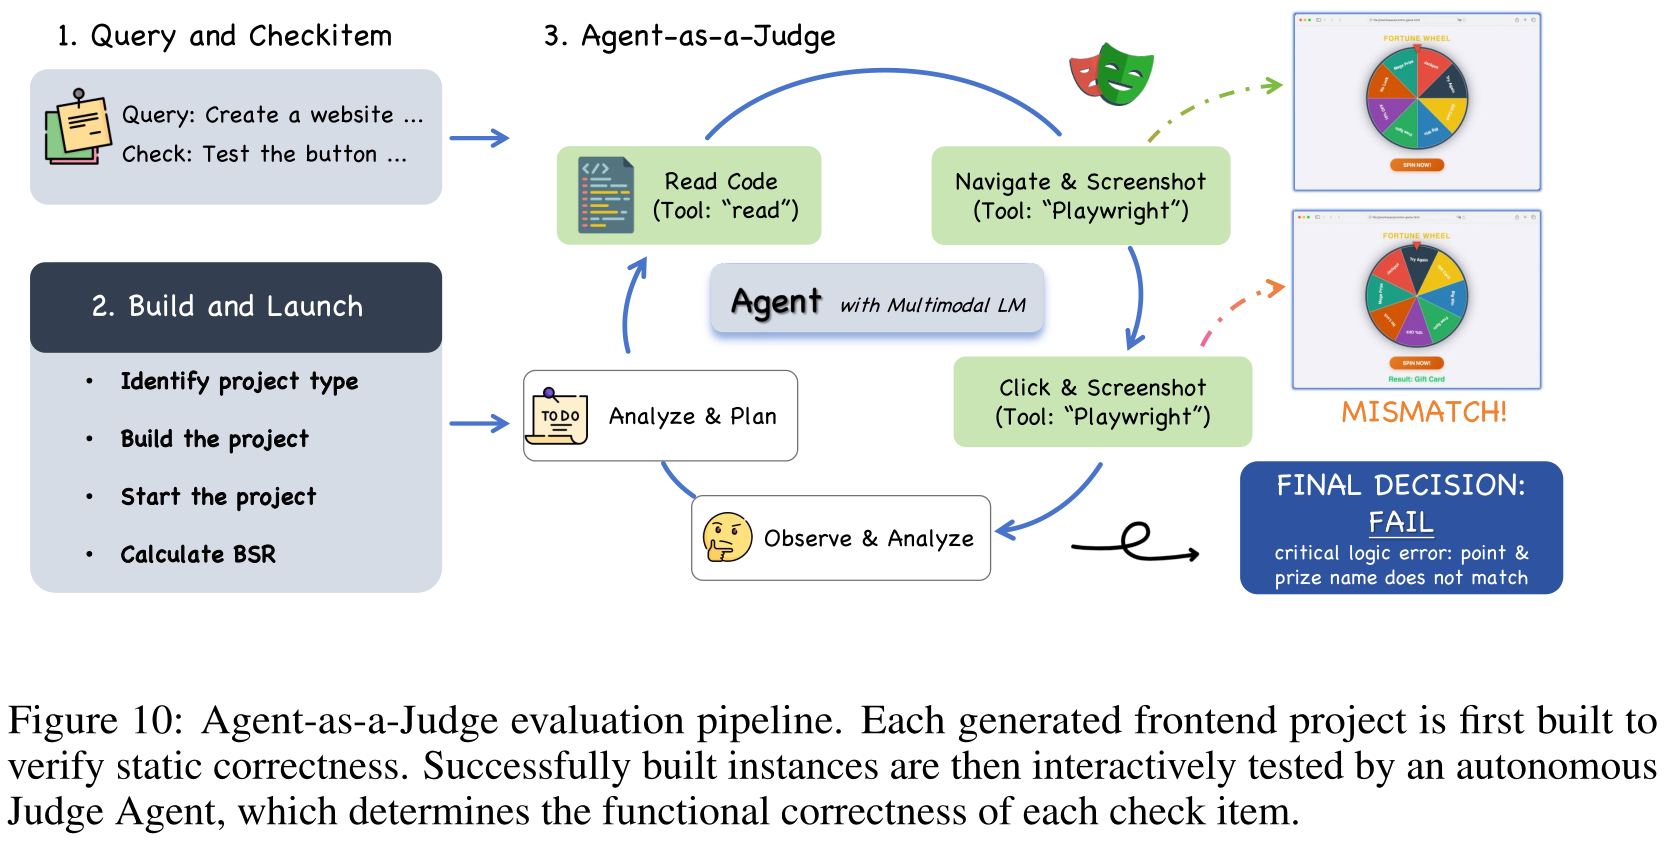
报告给出 frontend 检查点一致率 \(94\%\)、模型排序 Spearman \(85.7\%\)。这些数字说明团队做过 judge–human 校准,却不足以独立复现:任务、完整 rubric、judge prompt、运行环境和样本级 verdict 未充分公开。此类结果应登记为 [I] internal,并把确定性测试、模型语义判断和人工偏好三种证据分开。逐项边界见 GLM Agentic Engineering 与 GLM-5。