DeepSeek 演化案例
DeepSeek 家族适合用来练习谱系分析:语言、代码、数学、MoE、推理与多模态分支彼此交叉,论文、权重和产品事件又不总在同一天发生。家族总览负责公开分支与产物账本,本页沿时间解释关键继承关系,不把家族名当作线性版本号。
主干与专门分支
| 时间 | 分支 | 公开对象 | 关键观察 |
|---|---|---|---|
| 2024-01 | LLM | 论文 | 以公开训练口径建立语言主干基线 |
| 2024-01 | Coder | 论文 | 代码数据、填空目标与长上下文形成专门分支 |
| 2024-02 | Math | 论文 | 数学数据与 GRPO 连接推理后训练 |
| 2024-03 | VL | 论文 | 视觉编码器、适配器与语言主干组合 |
| 2024-05 | V2 | 论文 | MLA 与 MoE 同时改变训练和推理成本结构 |
| 2024-12 | V3 | 论文 | 更大规模 MoE、负载均衡与低精度训练协同设计 |
| 2025-01 | R1 | 论文 | 可验证任务上的 RL 与蒸馏成为推理能力主线 |
| 2025-08 | V3.1 | 发布记录 | 同一模型统一 Think / Non-Think,128K 与工具使用进入主接口 |
| 2025-09 | V3.2-Exp | 报告与代码 | DSA / Lightning Indexer 把长上下文稀疏选择接入 MLA |
| 2025-12 | V3.2 | 技术报告 | DSA、thinking tool-use 与 agent 数据合成合流 |
| 2026-04 | V4 Preview | 报告 | CSA/HCA、mHC、Muon 与百万 token 的训练—服务—Agent 闭环 |
| 2024-10—2025 | Janus / VL2 | Janus、VL2 | 理解、生成与动态视觉 token 形成多模态分支 |
日期对应论文首次公开时间,不等同于 API 或产品上线日。后续修订、模型权重和服务端 checkpoint 还应分别记录。
V2:结构与服务成本一起看
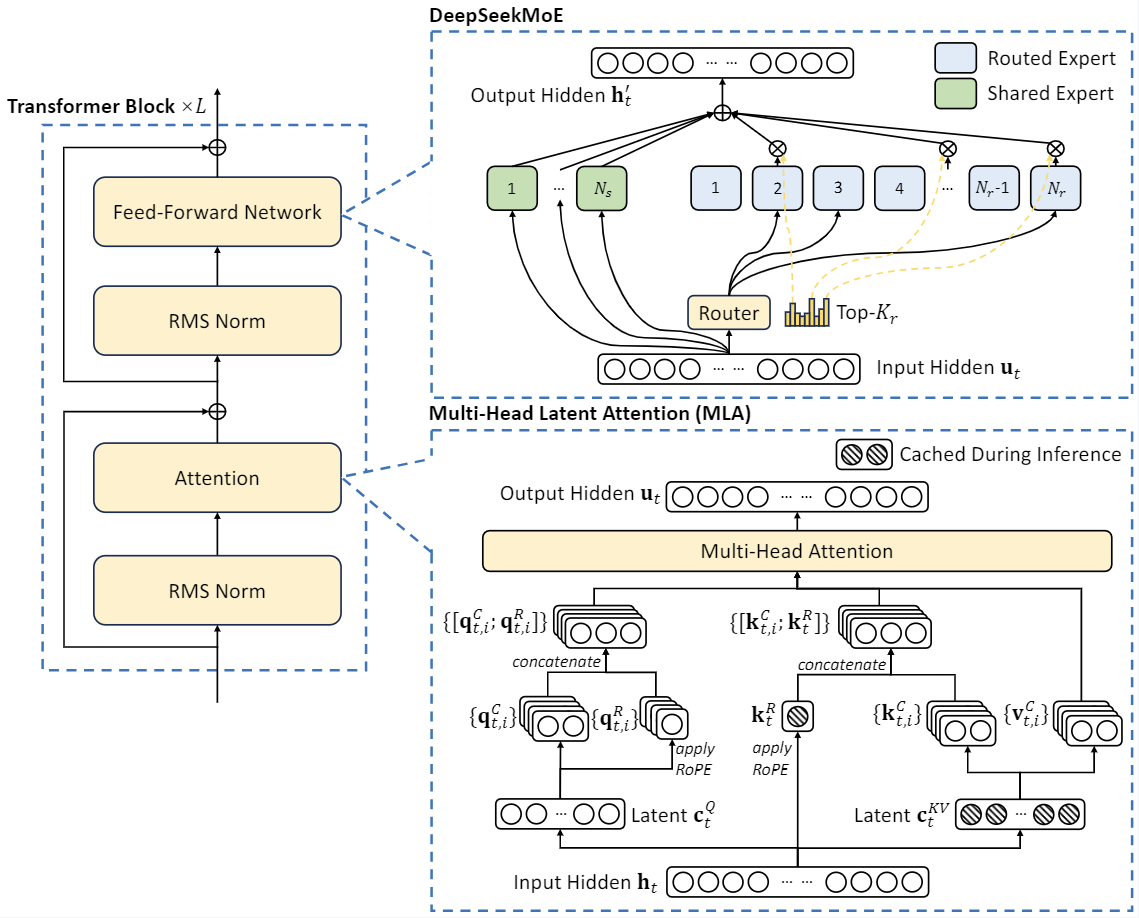
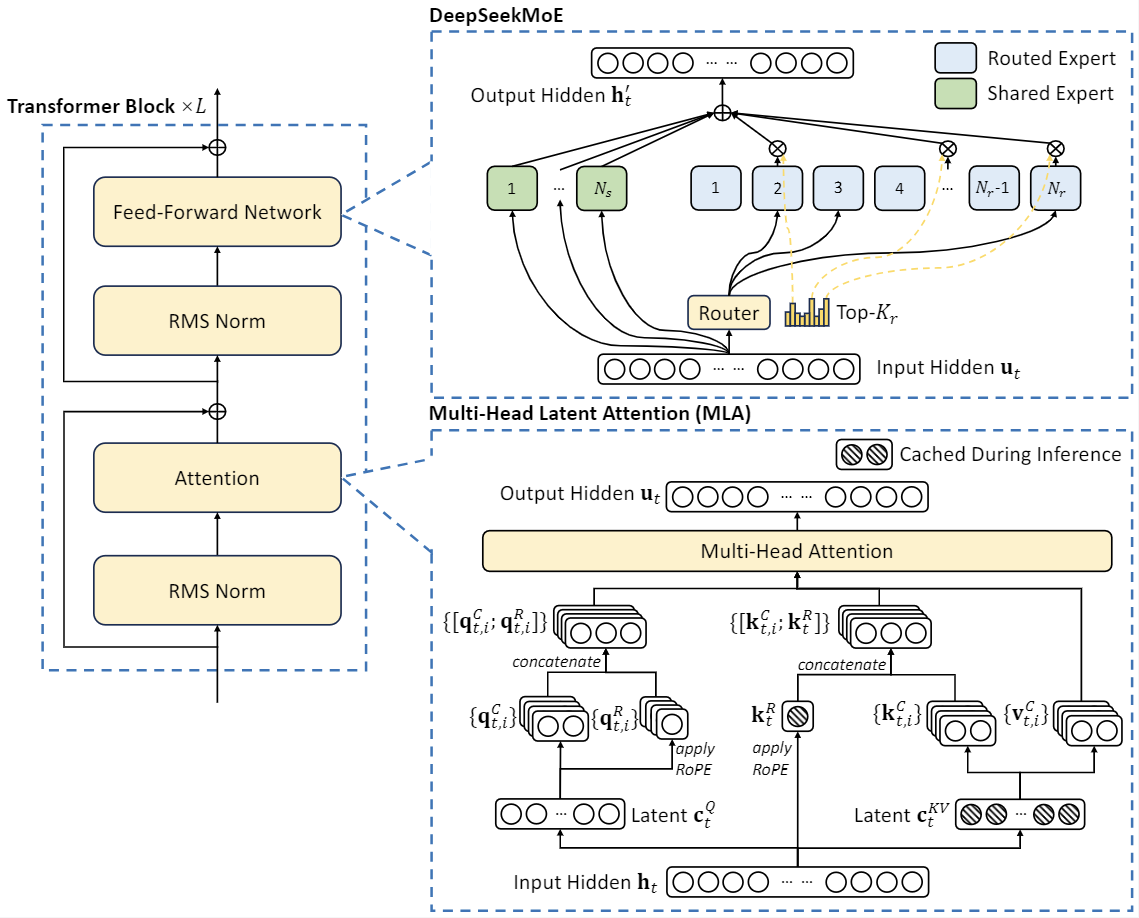
Multi-head Latent Attention 将 K/V 压缩到潜变量表示,目标之一是降低 KV cache:
它不能只被理解为“另一种注意力”。权重吸收、RoPE 分支、训练实现与推理 kernel 决定理论压缩能否转化为真实吞吐。V2 同时采用 MoE,因此模型容量、激活计算、expert parallel 通信和 KV cache 需要联合评估。
V3:训练系统成为模型设计的一部分
V3 的公开材料把架构与系统放在同一配方中:专家路由、负载均衡、共享专家、FP8 训练和多 token prediction 共同决定训练稳定性与效率。阅读这类报告时,应为每项创新建立三栏:
| 机制 | 预期收益 | 新增风险 |
|---|---|---|
| 稀疏专家 | 扩容量而控制激活 FLOPs | 路由偏斜与跨机通信 |
| 辅助损失自由的均衡 | 减少均衡目标对主任务的干扰 | bias 更新速度与稳定性 |
| FP8 训练 | 降低带宽与算力成本 | scaling、累加精度与异常值 |
| 多 token prediction | 增加每个位置的训练信号 | 训练头、权重与推理整合复杂度 |
R1:区分 base、RL checkpoint 与蒸馏模型
R1 相关结论经常混淆三个对象:
- 从 base model 直接进行可验证奖励强化学习的 checkpoint;
- 加入冷启动数据、多阶段训练与拒绝采样的完整模型;
- 由大模型生成轨迹、再训练较小 dense 模型的 distill 版本。
它们共享方法谱系,却不共享参数规模、训练成本和行为边界。GRPO 的组相对优势可简写为
但实际效果还取决于采样多样性、奖励可验证性、KL 约束和训练系统。详见 Agentic RL 数学与算法。
V3.1 到 V3.2:能力接口与注意力路径同时变化
V3.1 首先把 Think / Non-Think 合并进同一 checkpoint,并以 840B token continued pretraining 把 context 扩到 128K;这是一项模型、tokenizer、chat template 与 API 同时变化的事件,不能只记成产品按钮。
V3.2-Exp 随后在 V3.1-Terminus 上引入 DeepSeek Sparse Attention(DSA)。Lightning Indexer 先以低成本分数从历史 KV 中选出 top-\(k\),core attention 再只访问选中项。正式 V3.2 保留这条结构线,又把 thinking 直接接入 tool-use,并披露覆盖 1,800 余环境、85K 复杂指令的 agent 数据合成。
这一阶段建立了 V4 的两个前提:
- 架构上,learned sparse selection 已经可以训练并进入推理 kernel;
- 后训练上,reasoning 不再只面向封闭数学题,而要穿过工具结果和长轨迹。
V4 没有简单把 DSA 的 context 上限改成 1M,而是在选择之前先压缩历史。
V4:压缩、选择与局部精度分工
DeepSeek-V4 发布 Flash 与 Pro 两个 MoE 规模:284B / 13B activated 和 1.6T / 49B activated,均给出 1M context。主线可以分成四层:
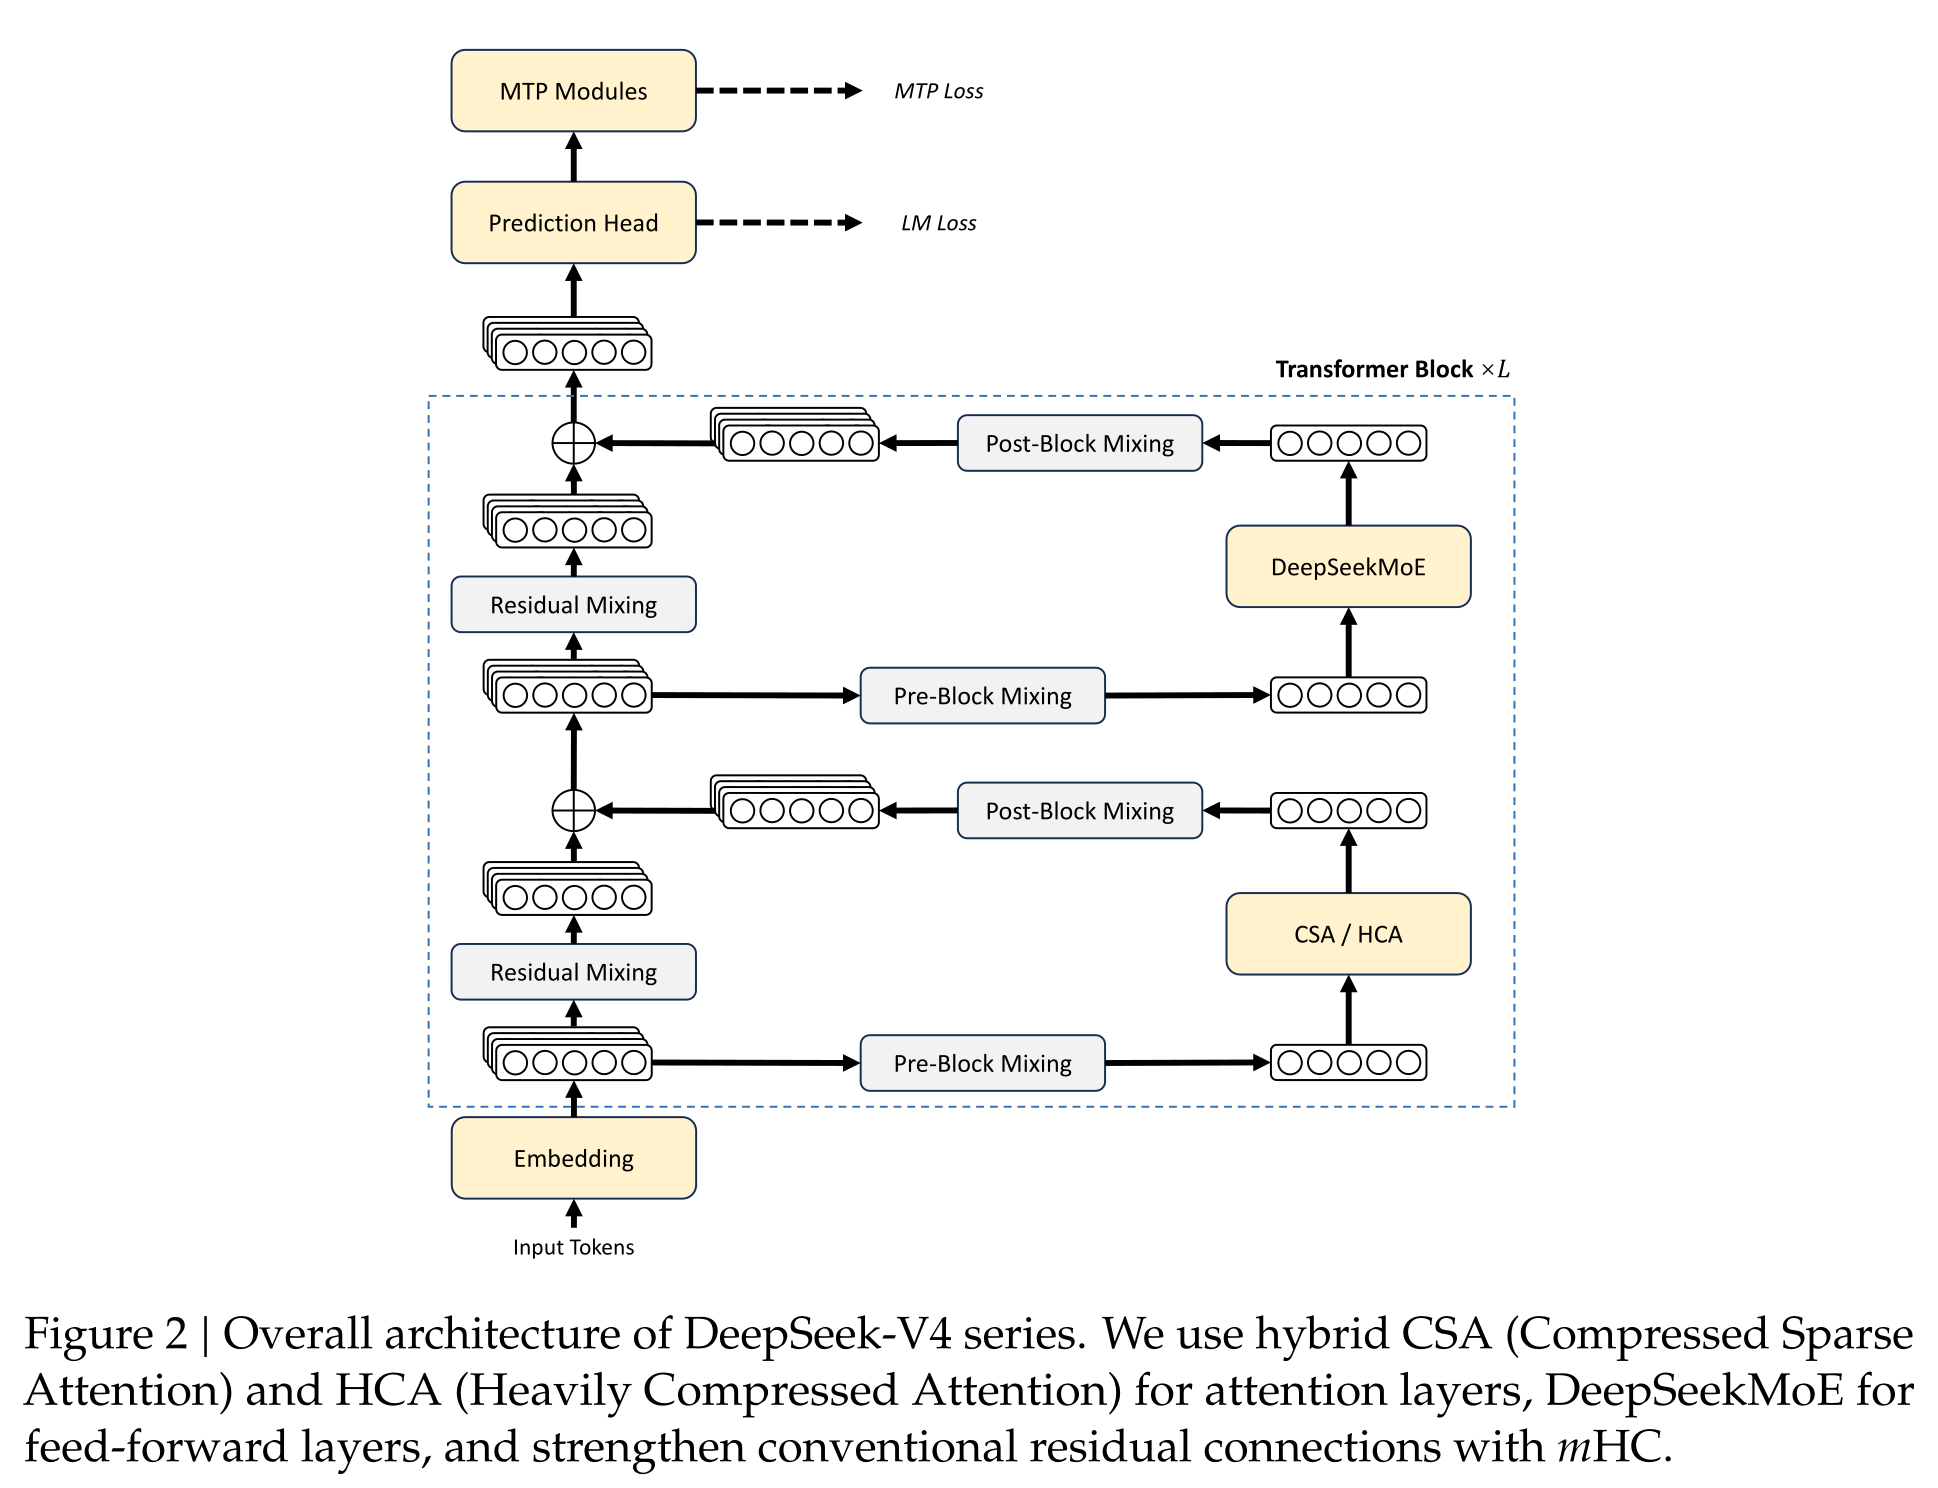
- CSA 每 \(m=4\) 个 token 产生一个重叠压缩项,再由 Lightning Indexer 做 top-\(k\) 选择;
- HCA 每 \(m'=128\) 个 token 产生一个非重叠压缩项,在较短的压缩序列上做 dense MQA;
- SWA 保留最近 128 token 的未压缩局部细节,并承接当前尚未闭合的压缩块;
- mHC 扩展 layer 之间的 residual width,Muon 则改变大多数二维权重的优化几何。
因此 V2 的 MLA、V3.2 的 DSA 和 V4 的 CSA/HCA 不是三次同义命名:
| 阶段 | 首要压缩对象 | 长历史怎样访问 | 主要系统状态 |
|---|---|---|---|
| MLA | 每 token 的 K/V channel | 仍是 dense token positions | latent KV |
| DSA | 访问集合 | learned top-\(k\) token KV | latent KV + indexer |
| CSA | token positions + 访问集合 | 先 \(4\times\) compression,再 top-\(k\) | compressed KV + indexer + SWA |
| HCA | token positions | \(128\times\) compression 后 dense | heavily compressed KV + SWA |
V4 的 系统闭环同样属于模型定义的一部分:compressed block 改变 Context Parallel 边界和 KV cache;MegaMoE 用 wave 隐藏 expert communication;token WAL 与 DSec 让百万 token Agent rollout 可以被抢占和恢复;全词表 OPD 把十余个 specialist 的行为合回一个学生。
DSpark 则是 V4 发布后的推理解码节点,而不是 V4 base checkpoint 内部新增能力。它以深并行骨干加低秩 Markov 头提高长草稿的 prefix survival,再以 经过校准的 confidence 和硬件 SPS 曲线按负载选择每请求 verify length。论文报告 DSpark 在 V4-preview 发布约两周后替代生产 MTP-1;公开 DeepSpec 覆盖 Qwen3 / Gemma 4 的训练和 离线评测,但不等于内部 V4 scheduler、HAI-LLM 与 ragged kernel 的完整源码。
官方把当前版本称为 Preview。报告没有给出训练集配比、总训练 FLOPs、硬件规模、完整 RL 配方或核心组件的充分规模消融,并明确把架构简化、多模态和新的稀疏方向列为后续工作。对应的 103 项正文引用、方法前身与 benchmark 入口见 V4 引用图谱。
多模态不是旁支标签
VL、VL2、Janus 与 OCR 系列处理不同问题:
- VL 路线强调视觉编码、分辨率与语言对齐;
- VL2 使用动态切片与稀疏语言主干,提高多图和高分辨率处理能力;
- Janus 将视觉理解与图像生成的表示路径解耦,再交给统一 Transformer;
- OCR 路线把视觉压缩、文档结构和文字识别作为独立系统问题。
因此“支持图像”不足以说明模型处于同一谱系。详见 DeepSeek 多模态案例。
怎样维护时间线
- 事件粒度固定为 paper、weights、code、API、product、license;
- 每条事件保留精确版本、来源与日期;
- 主干升级与专门分支分别排列,再用结构变化建立交叉链接;
- 未公开训练数字保持未知,不从相邻版本补齐;
- 产品模型名复用时,建立新的 checkpoint 记录而非覆盖旧条目。
训练数字口径见训练 token 口径,通用谱系模板见模型谱系。
Reference
- DeepSeek LLM
- DeepSeek-Coder: When the Large Language Model Meets Programming
- DeepSeekMath
- DeepSeek-VL: Towards Real-World Vision-Language Understanding
- DeepSeek-V2
- DeepSeek-V3
- DeepSeek-R1
- DeepSeek-V3.1 官方发布记录
- DeepSeek-V3.2-Exp 官方发布记录与 DSA 入口
- DeepSeek-V3.2 官方发布记录
- DeepSeek-V3.2 技术报告
- DeepSeek-V4 技术报告
- DSpark 论文
- DeepSeek-V4 官方发布记录
- DeepSeek-V4 官方模型集合
- Janus