从 MegaMoE 到 DSec:DeepSeek-V4 的系统闭环
DeepSeek-V4 的系统章节不是一份“用了哪些库”的清单。它围绕同一个约束展开:模型把每 token 的有效计算压低以后,通信、kernel 启动、归约顺序、KV 生命周期和 Agent 环境都会从次要开销变成主瓶颈。
这条链可以沿一次请求的生命周期阅读:
- MoE token 跨 rank 路由,MegaMoE 把通信和两次矩阵乘切成可重叠的 wave;
- 大量异形算子由 TileLang 表达,host codegen、静态分析与显式数值语义压低 launch 前的 CPU 开销;
- 训练要求 batch-invariant、可确定的 kernel,Muon、mHC、压缩注意力再分别改变参数分片、流水线和 Context Parallel;
- 推理端必须同时管理 SWA state、未完成压缩块、CSA/HCA 压缩项和 indexer key state;
- 长程 Agent rollout 会被抢占、跨越数十万环境,因而还需要 token WAL、外部 KV 与 DSec 沙箱。
本页还原这些接口怎样咬合。DeepSeek-V4 总深读给出报告全貌;通用机制分别进入 TileLang、GPU 执行模型、MoE 系统、Attention Kernel、KV Cache 和 Agentic RL 训练系统。
为什么低激活 MoE 仍可能被通信拖住
一个 routed token 要经历
只看总字节数会错过关键:all-to-all 的长尾、expert 负载差异和小 batch 会让通信与计算按阶段串行暴露。已有 Comet 把 dispatch 与 Linear-1、Linear-2 与 combine 分别重叠;FlashMoE 展示了更细粒度的 fused distributed MoE 路径。V4 的 MegaMoE 再把 expert 切成 wave:
wave j-1:                  combine ───────▶
wave j:             Linear-1 → act → Linear-2
wave j+1: dispatch ───────▶
time ─────────────────────────────────────▶
一个 wave 的远端 token 到齐便开始计算,不必等待整层所有 expert。稳态下,上一 wave 回传、 当前 wave GEMM、下一 wave 拉取并行推进。报告在 NVIDIA GPU 与昇腾 NPU 上相对其强非融合 基线给出 \(1.50\text{–}1.73\times\) 的一般推理加速,延迟敏感场景最高 \(1.96\times\);这些 是作者测量,不应扩写成对任意拓扑、batch 或硬件都成立。
带宽阈值不是“越大越好”
若峰值计算吞吐为 \(C\),互联带宽为 \(B\),理想重叠下完全隐藏通信所需的 balance condition 为
在报告这段局部记号中,\(h\) 是模型侧 activation width,\(d\) 是单个 expert 的 intermediate width。V4-Pro 对每个 token–expert pair 估计 \(6hd\) FLOPs:SwiGLU 的 gate、up、down 三条 矩阵路径;dispatch 用 FP8、combine 用 BF16,共 \(3h\) bytes,于是
这里代入的是 V4-Pro 的 expert intermediate width \(d=3072\),不是模型 hidden size 7168。 6144 也不是硬件常数:它依赖通信 dtype、算子流量与 expert shape,而且上述不等式只给出理想 balance point。kernel 的额外读写、wave 气泡、expert skew、Tensor Core 利用率和网络持续 带宽仍可能让通信无法完全隐藏。
def overlap_budget(expert_width, dispatch_bytes=1, combine_bytes=2):
    flops = 6 * expert_width
    traffic = dispatch_bytes + combine_bytes
    return flops / traffic
assert overlap_budget(3072) == 6144
assert overlap_budget(2048) == 4096
assert overlap_budget(3072, dispatch_bytes=2) == 4608
这段算术还揭示一个硬件协同结论:越低精度的通信会提高可隐藏的 compute/bandwidth 比,但极端 fusion 会让计算、显存和网络同时满载,功耗墙可能先于理论 roofline 到来。
Pull-based activation 与 wave 的所有权
报告建议远端消费者主动读取 activation,而不是让生产者逐个 push。pull 的价值不只在 API:
- 消费者知道自己的 wave 何时具备计算条件;
- producer 不必维护跨节点目的地队列;
- 数据到达与 expert scheduling 可以共用状态机;
- backpressure 落在真正拥有计算资源的一侧。
代价是远端内存可见性、失败重试、buffer 生命周期和拓扑路由必须成为 kernel 契约。公开实现位于 DeepGEMM MegaMoE PR;论文速度数字和某个开源 backend 能否在特定 GPU 上运行是两类证据,不能互相替代。
TileLang:DSL 只是入口
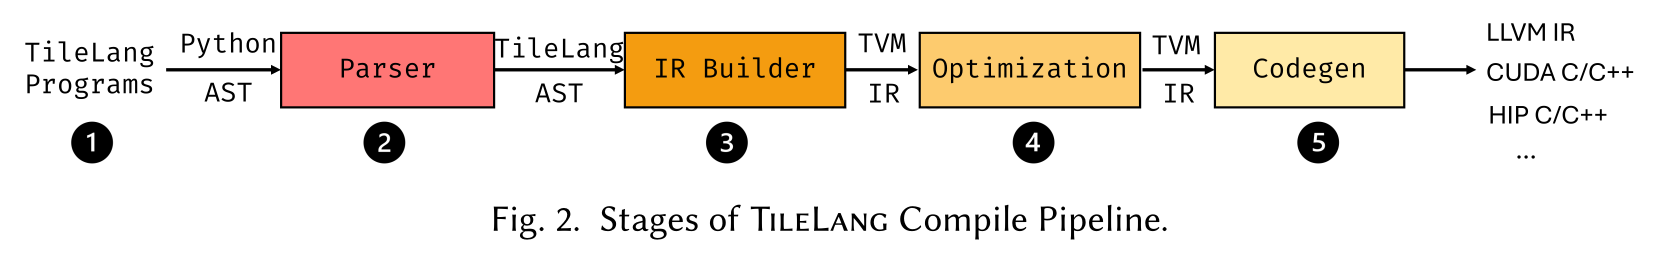
TileLang 通用专题解释语言、layout、pipeline、编译 pass、JIT 与后端;本节只讨论 V4 披露的增量。TileLang 把 kernel 写成 tile 级数据流,让编译器负责 layout、pipeline 和底层代码生成。V4 报告强调了三项容易被“Python 写 kernel”口号遮住的工程:
Host code generation
GPU kernel 启动前常有 shape、stride、dtype 与 layout 检查。动态语言逐项验证可能耗费几十到 数百微秒;对 decode 小 batch,这与 kernel 本身同量级。V4 通过 IR 共同生成 device kernel 与轻量 host launcher,并借助 TVM-FFI 连接 runtime;报告中降到 \(1\,\mu s\) 以下的是 CPU-side validation overhead,不是整个 kernel launch 或端到端调用延迟。优化对象不是 GPU FLOPs,而是每次调用的固定 CPU 税。
SMT 静态分析
layout 合法性、共享内存冲突和边界条件被转成 Z3 的 QF_NIA 问题。QF_NIA 是无量词非线性整数算术,表达力足以覆盖许多整除、tile 索引与范围约束,但最坏求解复杂度高;报告接受数秒级编译,换取运行前排除一类 layout/hazard 错误。SMT 证明的是编码进去的性质,不是 kernel 的全部语义正确性。
显式浮点语义
默认 fast math、近似指数和隐含融合会改变舍入路径。V4 的接口让 fast math 显式 opt-in,并为 IEEE 风格 intrinsic、rounding 与 layout 提供注解。这一层是后面 batch invariance 的前提:如果编译器可以任意重写归约,运行时无法承诺逐 bit 一致。
Batch invariance 与 determinism 是两个问题
令同一条请求 \(x\) 单独执行与放进不同 batch 执行。batch invariance 要求
determinism 则要求固定执行配置重复运行得到同一结果。一个 kernel 可以在固定 batch 下 deterministic,却因 batch shape 改变 split-K 或归约树而不 batch-invariant。
V4 对不同算子分别固定运算顺序:
- attention:主体的完整 waves 让一条 sequence 在单个 SM 内完成;最后一个未填满的 wave 才用多个 SM 加速单条 sequence,并借助 distributed shared memory 协作;两条 kernel 路径刻意保持同一累加顺序;
- GEMM:以 DeepGEMM 替代会随 batch/shape 选算法的 cuBLAS,尽量避免改变归约次序的 split-K;
- sparse-attention backward:每个 SM 写独立 buffer,再按固定次序归约;
- MoE:预处理 token order,不同 rank 使用隔离 buffer,避免 arrival order 进入浮点求和;
- mHC:\(n_{\mathrm{hc}}=4\) 时,动态参数 projection 的输出宽度只有 \(n_{\mathrm{hc}}^2+2n_{\mathrm{hc}}=24\);极小 batch 仍需 split-\(k\) 时,先分开写出各 partial output,再由后续 kernel 按固定次序归约。
代价也要明说:禁止某些 split-K 会损失极端 shape 下的吞吐,独立 buffer 增加显存,固定顺序限制 autotuning 空间。这里追求的是训练、rollout、故障恢复共享可比的 token 概率,而不是抽象意义上的“所有 GPU 计算绝对可复现”。
Muon 怎样进入 ZeRO
AdamW 的一阶、二阶状态天然按参数元素切分;Muon 的正交化把一个二维矩阵视为完整对象,随意切开矩阵会改变更新。V4 的折中是:
- 用 knapsack 把完整矩阵分配给 rank,报告 padding 低于 10%,每 rank 不超过 5 个矩阵;
- 额外建立重复 data-parallel group,增加可调度的 owner;
- MoE 矩阵按 projection type flatten,使各 expert 的同类权重形成一致 shape,但不在正交化语义内截断单个矩阵;
- 梯度以 stochastic BF16 通信降低带宽;
- 先 all-to-all 把矩阵梯度送给 owner,再在本地 FP32 累加,避免低精度 tree/ring reduction 改变数值路径。
它说明 optimizer state sharding 不只是内存布局:优化器把什么视为一个数学对象,决定了合法的分片边界。通用背景见集合通信与状态分片和优化器家族。
mHC、Pipeline Parallel 与重算
mHC 把 residual stream 扩成 \(n_{\mathrm{hc}}\) 条,并动态生成 \(A/B/C\)。V4 用 fused kernel、选择性重算和修改后的 DualPipe 1F1B 接住额外状态;报告测得 mHC 占 overlapped 1F1B pipeline stage wall time 的额外开销为 6.7%。这不是完整训练作业的 统一“端到端增量”,也不能由 mHC 的小矩阵 FLOPs 单独推导。
V4 还在 TorchFX 图上做 tensor-level activation checkpointing:
- 不是把整个 layer 一刀切成“保存或重算”;
- 从目标张量反向寻找最小重计算子图;
- 识别 pointer reuse 与 storage alias,避免同一底层存储重复保存;
- 让不同形状、生命周期的 mHC/attention 中间量获得不同策略。
这里的 checkpoint 是训练期 activation rematerialization,不是持久化 optimizer checkpoint。后者的故障语义见检查点与容错。
压缩注意力怎样做 Context Parallel
CSA/HCA 的压缩块跨越 rank 边界时,不能让每个 rank 独立 padding,否则全局块划分会改变。V4 的两阶段协议是:
- 对压缩率 \(r\in\{m,m'\}\) 的分支,每个 CP rank 把末尾 \(r\) 个未压缩 KV entries 作为 halo 发送给下一 rank;
- 每个持有 \(s\) 个本地 token 的 rank 生成固定 \(s/r+1\) 个、其中可能带 padding 的 compressed entries;
- 对压缩结果 all-gather;
- fused select-and-pad 将结果整理成总长 \(\texttt{cp\_size}\cdot s/r\) 的压缩序列,把 padding 统一放到尾部,再送入 sparse/dense core attention。
对 HCA 和 CSA indexer,可见范围可由位置规则预先算出;CSA core attention 则由 top-\(k\) selector 显式给出可见索引。核心不变量仍是任意 query 只能选择已经完整闭合的因果块。通信量、 padding 位置和 top-\(k\) 可见集合因此一起定义正确性。
一份请求为什么需要四类 cache
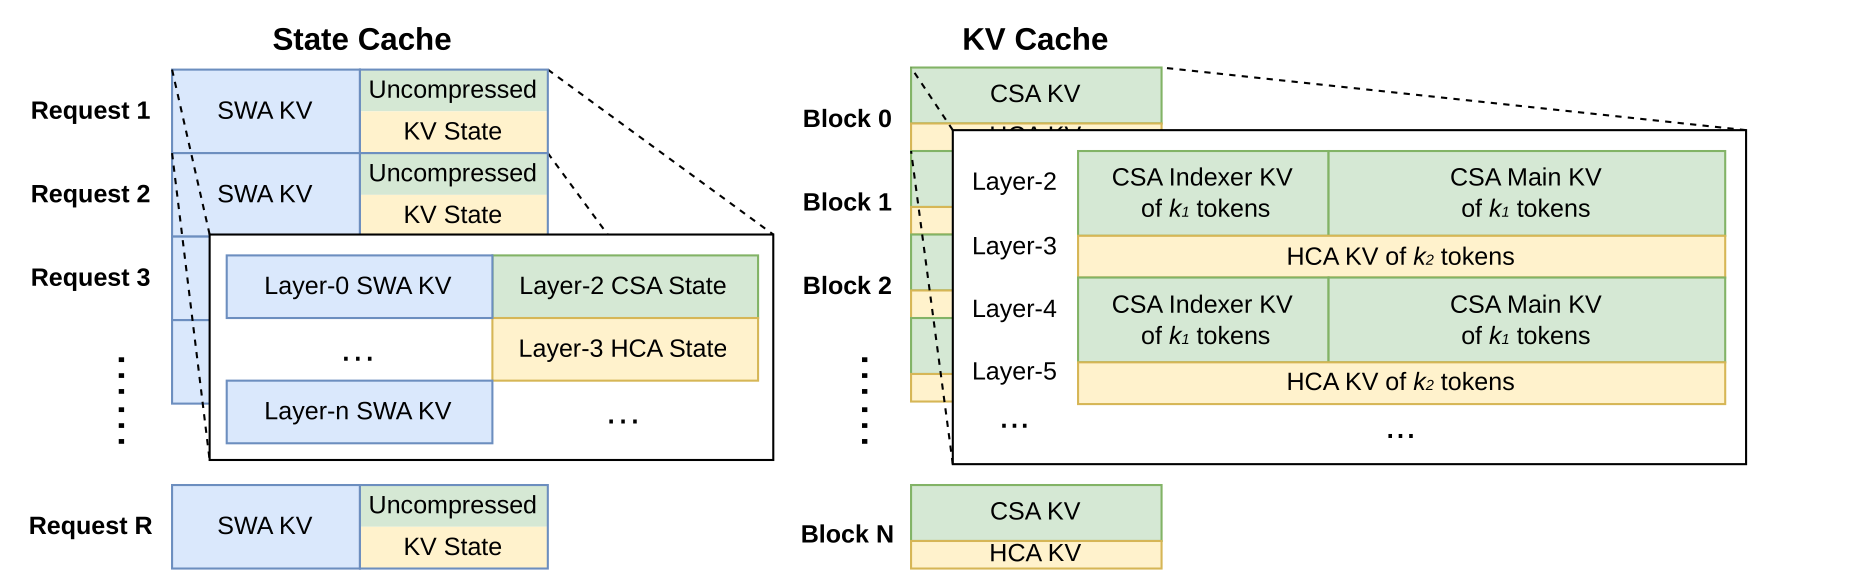
普通 PagedAttention 假设各层 KV 形状和 block 语义近似一致。V4 的 hybrid attention 至少同时存在:
| 状态 | 生命周期 | 访问方式 |
|---|---|---|
| SWA KV | 最近 128 token 滑动 | 连续局部窗口 |
| 未完成压缩 tail | 直到 \(m\) 或 \(m'\) block 闭合 | 增量写、闭合后转换 |
| CSA/HCA compressed KV | 完整历史块 | CSA top-\(k\) / HCA dense |
| Lightning Indexer key | 与 CSA 压缩块对齐 | 先评分再间接寻址 |
V4 将 SWA 和 tail 放进 state cache,把已闭合 compressed entries 放进 classical block cache, 并以 \(\operatorname{lcm}(m,m')\) 对齐 block。页分配仍然有用,但页的完成条件、跨层布局和稀疏 索引不再是传统同构 KV cache;kernel 与 cache manager 必须共同定义 block metadata。
On-disk prefix:压缩块能存,局部状态怎样恢复
完整 CSA/HCA 压缩块可以直接持久化;不完整 tail 依赖后续 token,恢复时需要重算。SWA 有三种策略:
- 全量保存:恢复最快,磁盘量最大;
- 每 \(p\) 个 token 周期 checkpoint:每隔 \(p\) 个 token 保存当时最后 \(n_{\mathrm{win}}\) 个 token 的 SWA state,在空间和恢复计算间插值;
- 完全不保存:从 prefix 尾部重算;对 \(L\) 层模型,报告给出的充分恢复范围是最后 \(n_{\mathrm{win}}L\) 个 token,而不是“每层各自独立重放 \(n_{\mathrm{win}}\) 个 token”。
报告估计全量 SWA KV 约为 compressed cache 的 8 倍,因此第三种策略并非荒谬;但真实选择还取决于磁盘带宽、prefix 命中率、prefill 富余算力和恢复尾延迟。详见 Cache 复用。
Rollout 的 token WAL:为什么不能“失败就重采”
长程 RL trajectory 若在第 \(t\) 个 token 被抢占,简单从头重新采样会带来两类问题:
- 长轨迹更容易遭遇抢占,也更容易被丢弃,数据分布向短样本偏移;
- 即使保存随机种子,只要 batch 形状或 kernel 归约改变,后续 token 也未必逐 bit 重现。
V4 使用 token-granular write-ahead log(WAL)记录已生成 token,并在抢占时保存未完成请求的 KV cache;恢复时联合使用持久 WAL 与已保存 KV 继续 decode。致命故障若丢失 KV,则从 WAL 中的 持久 token 重新 prefill,而不是重新采样已经发生的前缀。
一个正确的提交顺序是:
generate token
→ append token/WAL metadata
→ durably mark committed
→ expose token to environment/client
若先执行外部工具再写 WAL,非幂等副作用就无法安全重放。轨迹与策略契约进一步讨论 observation、policy version 与 environment state 的共同边界。
百万 token RL 的数据路径
把完整 token tensor 交给全局 shuffle 会让 control plane 搬运巨型对象。V4 把 trajectory 分成:
- 轻 metadata:长度、来源、policy version、reward、存储位置;
- 重字段:tokens、masks、log-probs、KV references。
全局排序、packing 和动态 minibatch 只操作 metadata;worker 到执行时才从 shared memory 取重字段,并在 minibatch 完成后释放。这与数据库“先排索引、后取大字段”相似,目标是让调度复杂度随 trajectory 数增长,而不是随总 token 数增长。
DSec:环境是 RL 状态的一部分
长程 Agent 训练不只保存模型侧 token,还要保存可执行世界。DSec 由 Rust 实现的 Apiserver、Edge 与 Watcher 协调,并用 3FS 承载大规模镜像与状态。它按隔离成本提供四种 substrate:
| substrate | 适合 | 隔离与启动权衡 |
|---|---|---|
| Function Call / 预热容器 | 受控轻任务 | 启动最快,环境自由度最低 |
| Docker + EROFS | 常规 Linux 工具链 | 容器隔离,镜像只读层按需加载 |
| Firecracker microVM | 更强租户边界 | VM 级隔离,仍追求快速启动 |
| QEMU full VM | 完整 OS / 特殊内核 | 支持任意 guest OS,启动与资源成本最高 |
EROFS 的 metadata 可本地驻留,数据块按需从 3FS 获取;microVM 基础镜像经 OverlayBD 远端分层,本地只保存 copy-on-write 增量。chainable snapshot 支持 millisecond-scale resumption;报告同时称其生产环境中的单个 DSec cluster 管理数十万并发 sandbox instances。 前者是恢复尺度描述,后者是作者生产部署声明,均不等价于公开可复现的容量基准。
高密度环境还会把 page cache 变成共享资源:相同只读页需要去重,冷页要可回收,内存可适度 overcommit;全局锁在几十万 sandbox 下会成为热点。DSec 为每个 sandbox 维护全序 trajectory log,持久记录 command invocation 及其结果;它与模型侧 token WAL 是相邻但不同的日志。前者 用于:
- client fast-forward 到已知状态;
- 追踪每次变更的 provenance;
- 在不重复非幂等动作的前提下重放与诊断。
“确定性重放”因此不是假设外部世界永远确定,而是重用已记录结果,不让重执行重新定义历史。
该怎样验证整条系统链
- MegaMoE 同时报 steady-state throughput、p50/p99 latency、网络利用率、功耗与 expert skew;
- TileLang 比较 compile time、host launch tax、kernel time 和数值误差,不能只报 kernel 峰值;
- batch invariance 用同一请求在不同 batch size、排序与并发下逐 token 比较 logits;
- fault recovery 注入 worker kill、KV 丢失、WAL 截断和非幂等工具调用;
- cache 测试 prefix 不完整块、\(\operatorname{lcm}(m,m')\) 边界、SWA 恢复与跨层索引;
- sandbox 同时审计逃逸边界、镜像冷启动、page-cache 干扰和状态 provenance。
V4 报告公开了接口与若干速度数字,却没有给出完整集群拓扑、功耗、绝对吞吐、所有 kernel shape、DSec 故障注入结果或端到端服务尾延迟。这些空白不削弱设计本身,但决定了哪些结论目前只能算作者系统上的实证。
Reference
- DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
- DeepSeek-V4 官方推理实现
- DeepGEMM:包含 MegaMoE 与 V4 Kernel
- DeepGEMM MegaMoE 公开 PR
- TileLang:面向高性能算子的 tile-level DSL
- TileLang: Bridge Programmability and Performance in Modern Neural Kernels
- Comet: Fine-grained Computation-communication Overlapping for Mixture-of-Experts
- FlashMoE: Fast Distributed MoE in a Single Kernel
- Z3: An Efficient SMT Solver
- 3FS:面向 AI 工作负载的分布式文件系统
- Firecracker: Lightweight Virtualization for Serverless Applications
- EROFS: A Compression-friendly Readonly File System
- DADI / OverlayBD: Block-level Image Service for Agile and Elastic Application Deployment
- PagedAttention / vLLM