长时任务
长时 agent 的核心挑战不是把 context window 拉长,而是在数小时、数百步甚至多个 episode 中维持目标、状态和可恢复性。
能力为何随时长下降
假设每个关键步骤独立正确的概率为 \(p\),需要 \(n\) 个步骤全部正确,则粗略成功率为
实际错误并不独立:早期错误会改变后续状态,使失败传播更强。即使 \(p=0.99\),经过 200 个关键步骤也只有约 \(0.99^{200}\approx0.134\)。
因此长时能力必须依赖检测、回滚、重新规划和冗余验证,而不能只提升单步准确率。
三层状态
| 状态 | 内容 | 维护方式 |
|---|---|---|
| 工作记忆 | 当前观察、最近工具输出 | 上下文窗口 |
| 任务状态 | 目标、计划、已验证事实、阻塞 | 结构化 ledger |
| 环境状态 | 文件、进程、服务、资源 | 外部检查点与重新读取 |
自然语言摘要适合压缩背景,不应成为环境事实的唯一来源。恢复任务时要重新读取关键文件、git 状态、进程或远端对象。
环境 checkpoint 与语义记忆承担不同职责:checkpoint 恢复“机器当时是什么状态”,ledger/摘要恢复“任务为何走到这里”。长时 agent 应把两者用不可变 ID 绑定,但不能用摘要替代进程、文件或应用数据库。AgentENV 提供了 microVM pause/resume/fork 的公开实现入口;K3 报告则展示了把这种可恢复环境用于跨模拟天、数千工具调用的训练实例。
层级规划
把长任务分成里程碑 \(z_1,\ldots,z_K\),每个里程碑有:
- 输入状态与前置条件;
- 明确产物;
- 验收测试;
- 可逆边界;
- 失败恢复策略。
高层策略选择里程碑,低层策略执行动作。完成条件必须来自验证器,而非模型自我判断。
上下文压缩
一份可靠压缩应保留:
objective
scope and constraints
verified facts
current artifacts and immutable identifiers
changes made
checks passed / failed
open risks
next action
应删除重复工具输出、已否定假设和无关探索,但保留否定结论本身,防止再次走回同一路径。
如果摘要由 policy 自己生成、后续执行以摘要重建状态,并让摘要 token 也接受任务终态奖励,压缩就从运行时整理进入了训练目标。CompactionRL 展示了这种接口,同时用全局 token mean 和跨 segment 的 GAE 折扣近似修复可变分段造成的优化偏差。
失败恢复
长时系统需要把失败分类:
| 类型 | 示例 | 恢复 |
|---|---|---|
| 可重试瞬态 | 网络抖动、限流 | 有界退避、幂等重试 |
| 状态漂移 | 远端分支更新、页面变化 | 重新发现并重规划 |
| 局部实现错误 | 测试失败、编译错误 | 最小诊断、修复、回归 |
| 目标冲突 | 需求与仓库规则矛盾 | 请求决策 |
| 权限边界 | 缺少凭据或高风险确认 | 停止并保留可验证状态 |
“继续尝试”不是恢复策略。每类失败都应有重试预算和升级条件。
跨 episode 学习
单次 episode 结束后,可将经验整理为:
- 可验证的成功轨迹;
- 失败模式与触发条件;
- 环境/工具使用技巧;
- 更好的任务分解模板;
- 不应泛化的项目特例。
直接把完整历史塞入下一次上下文会造成隐私、噪声和错误固化。更稳妥的是抽取经过验证、去情境化的规则,并保留来源与适用边界。
评测时间范围
固定 benchmark 通常测短任务。长时评测应同时改变:
- 预计人类完成时间;
- 工具调用和环境步骤;
- 依赖深度与并行度;
- 恢复点数量;
- 外部状态变化。
METR time horizon 用固定成功率下可完成任务时长描述能力变化。这个指标仍依赖任务分布、人类基线和 agent scaffold,不能解释为模型拥有等长的自主工作能力。
工程 harness
Anthropic 的长时 agent harness 文章强调初始化、进度文件、增量提交和重新进入任务。通用原则是:每个新工作周期都能从外部状态重建事实,并留下下一周期可验证的入口。
Harness 也是实验变量
system prompt、工具命名、context compactor、skills、memory 与 subagent policy 会共同改变长时成功率。white-box harness 应把这些组件拆成带 revision 的可组合模块,并设置三类实验:
- 固定模型,替换单个 harness 组件;
- 固定 harness,比较 checkpoint;
- 在训练未见的组件组合上测 scaffold robustness。
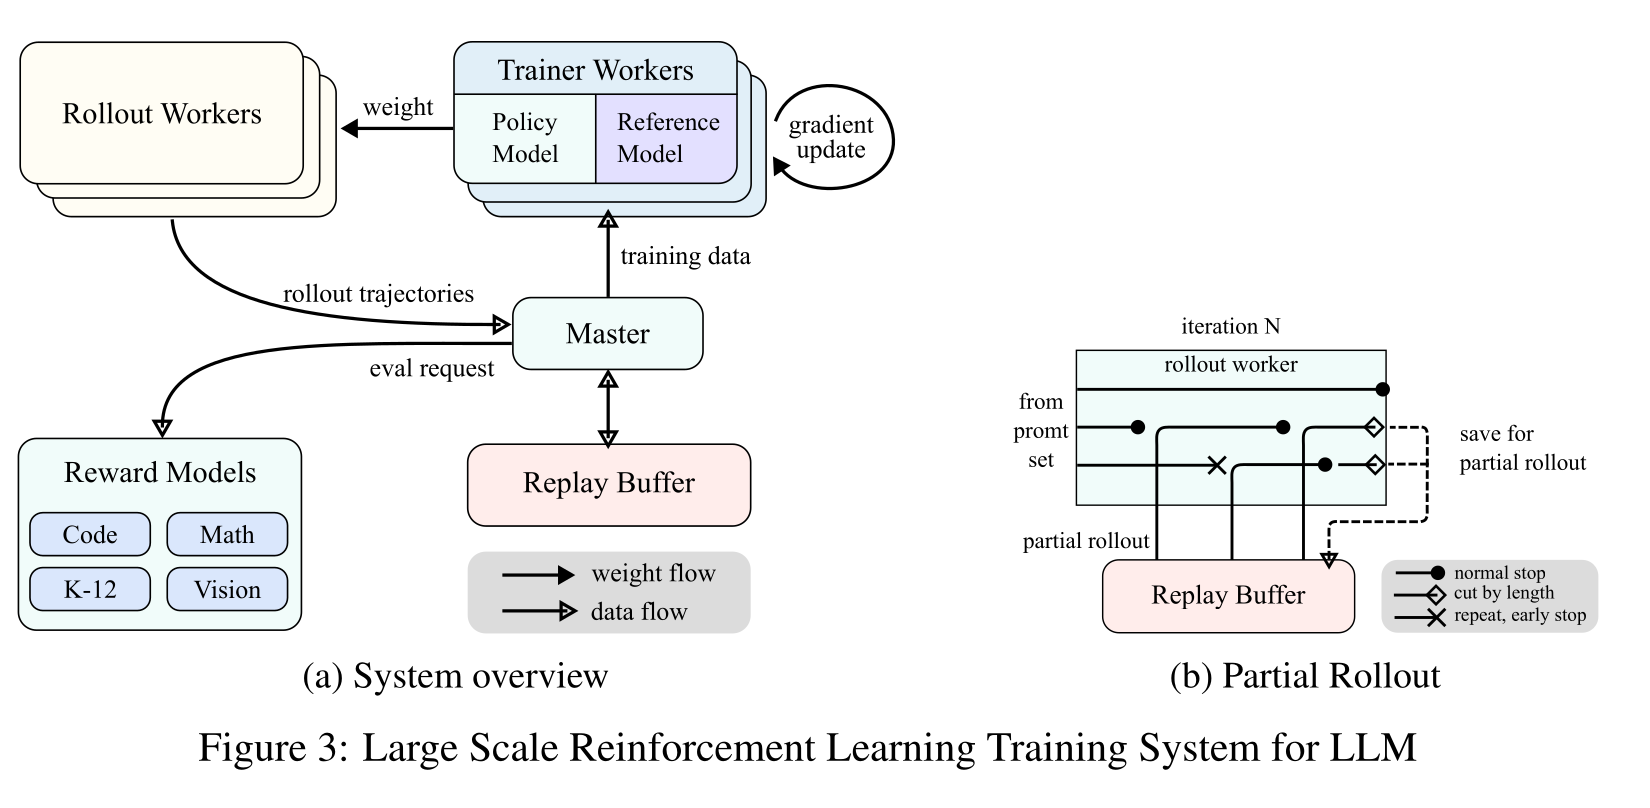
Kimi K3 技术报告描述了一套可实例化多种 coding/agent scaffold 的训练 harness。它提示我们不要把某个终端界面的得分直接归因于模型;具体组件和内部实现并未完整公开。长上下文、partial rollout、persistent environment 如何接成一个系统,见 Kimi K3。
Coding 场景见 Coding Agent,训练侧状态见训练系统。
Keep-recent 与层级重启
GLM-5 的搜索 Agent 没有把最大窗口等同于有效记忆。它保留最近 \(k=5\) 轮,较早 observation 用占位符折叠;总上下文超过 \(T=32\text{K}\) 时再丢弃完整工具历史并重新开始。报告在其 BrowseComp harness 下给出从 55.3 到 62.0,再到 75.9 的阶段性结果。
该设计降低 observation 噪声,却没有保留早期事实摘要或 provenance pointer。长程系统更稳妥的扩展是把 task state、已验证事实、近期交互和可重取 observation 分层:折叠只改变活动上下文,不删除外部可恢复状态。报告策略的代码与评测口径见 GLM Agentic Engineering。