从“看懂”到“生成”:多模态模型的四股汇流
今天把图片、语音或视频送进一个语言模型,看起来像是在输入端多接了几种数据。真正困难的地方却不在接口:不同模态原本拥有不同的采样频率、空间结构和训练传统,模型既要找到可以互相比较的表示,又要保留各自不可压平的细节。多模态的发展因此不是一条直线,而是四股长期分开的水流逐渐汇合:可学习感知、语言对齐、可逆媒体生成,以及动作条件下的环境预测。更完整的时代背景见多模态的四条汇流,本页聚焦真正改变接口的工作转折。
第一股水流:语言成为视觉的开放词表
早期视觉模型通常在固定类别上接受监督。类别表一旦写死,模型知道的是一组封闭标签,而不是可以自由组合的语言概念。CLIP 深读所代表的转折,是把自然语言从结果描述变成训练监督:图像与文本分别编码,只要求同一配对在 batch 内比其他配对更相似。这样得到的不是一个固定分类头,而是可以用文本临时构造的开放词表分类器。
这条路线改变了后来的接口设计。视觉 encoder 不必从零与语言模型共同训练;它可以先学到广泛语义,再通过轻量桥接层接入已经成熟的语言模型。不过,对比学习擅长判断“是否匹配”,并不天然回答“图片里有什么、为什么、下一步该做什么”。从相似度空间走向生成式交互,还需要另一次转弯。
复用预训练组件的桥
Flamingo 用 Perceiver Resampler 把可变数量的视觉特征压成固定数量 latent,并把 gated cross-attention 插入冻结语言模型;BLIP-2 让 Q-Former 先从冻结视觉 encoder 中提取与语言有关的信息,再对接冻结 LLM;LLaVA 则展示了另一种重要经验:当视觉 encoder 与语言模型已经足够强时,简单 projector 加高质量视觉指令数据也能成为有竞争力的起点。
这三项工作并不是“桥越复杂越好”的排序。它们回答的是不同资源约束:
- Flamingo 关心交错图文与少样本上下文,桥接层承担持续注入视觉条件的责任;
- BLIP-2 关心冻结两端时怎样缩小模态鸿沟,Q-Former 本身需要分阶段预训练;
- LLaVA 关心如何低成本获得可对话的视觉指令跟随,数据构造与响应格式占据更重要的位置。
这段演化的细节、张量路径和最小 cross-attention bridge 见复用预训练组件怎样架桥。它也解释了为什么“projector 很小”不等于系统简单:视觉分辨率、token 数量、数据混合、冻结策略和语言模型能力都会改变结论。
第二股水流:从离散表示到连续生成
理解模型把世界压进表示;生成模型必须从表示返回世界。早期自回归图像模型直接预测像素,概率定义清楚但序列极长。VQ-VAE 把图像压成离散 code,使自回归 prior 可以在更短的 latent grid 上建模;原作使用 PixelCNN,后续路线才进一步采用 Transformer。DDPM 则换了问题:不再一次预测复杂分布,而是学习把逐渐加噪的样本一步步去噪。
Latent Diffusion 把这两类思想接了起来:先用 autoencoder 压缩,再在连续 latent 中扩散。随后 DiT 表明去噪 backbone 也可以换成 Transformer;Flow Matching 进一步把训练表述为沿选定概率路径回归向量场。它们共享的深层问题不是“U-Net 还是 Transformer”,而是表示空间、概率路径、训练目标和数值求解器怎样共同决定误差。
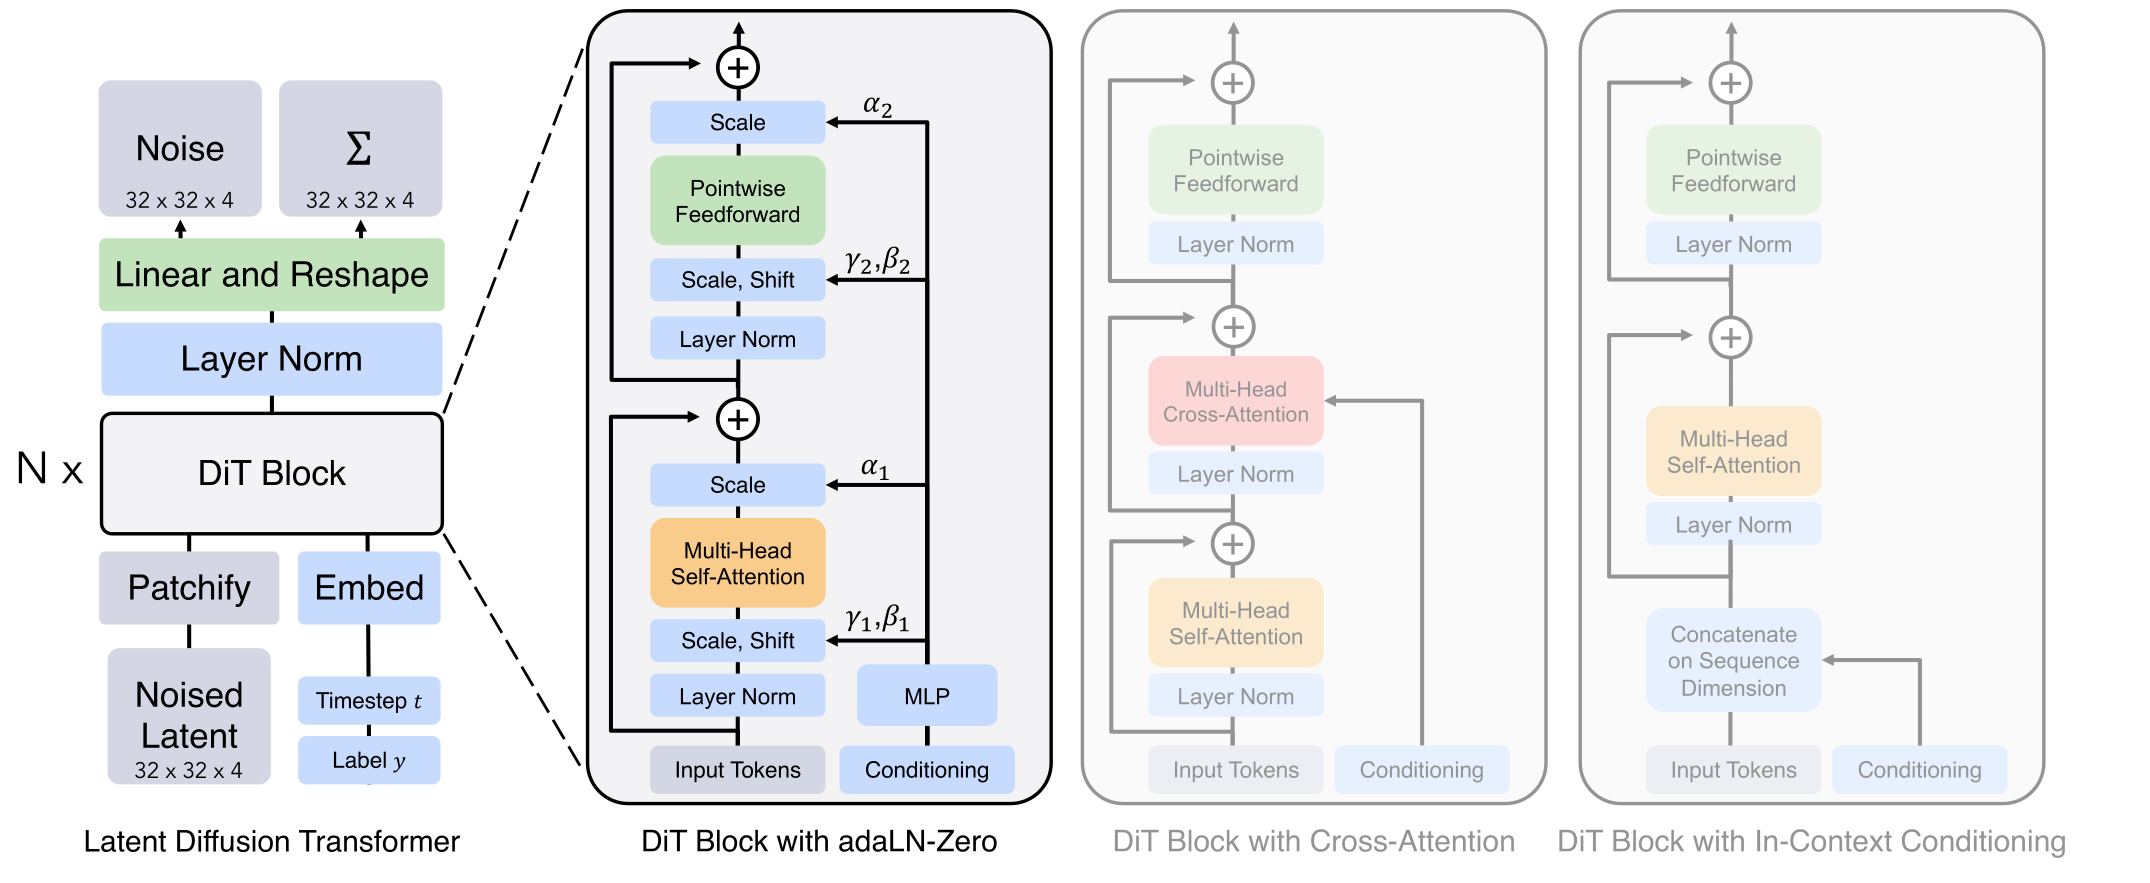
完整推导和一段可执行的噪声预测 reference 见从 DDPM 到 DiT 与 Flow,机制地图见多模态生成模型。
第三股水流:声音与视频带来真实时间
图像模型可以把一个样本当作静态 token 集,音频与视频却必须面对采样率、同步、流式状态和中断。wav2vec 2.0 与 HuBERT 从无标注语音学习上下文表示;SoundStream 和 EnCodec 把波形压成多码本 codec token;AudioLM 再把语义与声学 token 分层生成。声音由此同时接入理解与生成,但 speech content、speaker identity、韵律和高保真声学仍属于不同信息层。
视频侧从 3D CNN、分解时空 attention 与 masked video modeling,逐步走到时空 latent 生成。理解任务要求事件顺序和时间证据,生成任务还要求身份、运动、镜头与长 rollout 一致。两者共享视频 tokenizer 并不意味着目标相同:理解表示可以忽略难以预测的纹理,生成表示则要把它恢复。
更重要的变化发生在 runtime。实时语音和视频不是离线 batch;采集时间、到达时间、模型状态和播放时间必须共同存在。音频路线见音频表示与理解和音频生成与流式,视频路线见视频理解与视频生成。
第四股水流:预测开始服务行动
World Models、PlaNet 与 Dreamer 把观察压入 latent dynamics,并在想象中规划或训练策略;MuZero 进一步说明,决策模型可以只学习 reward、value 与 policy 所需状态,而不重建全部像素。
视频预测与这条路线后来重新相遇。JEPA 在表示空间预测未来或被遮区域,Genie 类工作从视频学习潜在动作和交互环境,VLA 则把视觉、语言、机器人状态与动作块接入共同模型。真正的汇流标准不是画面“像一个世界”,而是动作能否改变预测、预测能否改善规划、真实反馈能否纠正模型。
这条路线的 canonical 边界见世界模型、潜在动力学与规划和具身智能。
四股水流怎样汇合
理解与生成开始共享 tokenizer、backbone 或序列接口后,“图像输入”和“图像输出”可以出现在同一上下文里。但统一 token 并不会自动统一语义:
- 文本 token 的局部错误常可继续解码,视觉 code 的局部错误可能变成明显纹理;
- 理解追求语义不变性,重建要求保留位置、颜色与细节,二者的表示偏好并不相同;
- 自回归、diffusion 与 flow 的时间轴含义不同,不能只因为都使用 Transformer 就共享同一 loss mask;
- 端到端训练会让梯度跨模态流动,也可能破坏原来稳定的单模态能力。
因此,“原生多模态”只有落到计算图和训练目标才有意义。统一理解与生成的具体接口见统一理解与生成,多输入、多输出和实时状态见 Any-to-Any 系统。
留给后来工作的三个问题
这条谱系至今仍围绕三个没有被单一架构解决的问题展开:
- 表示瓶颈:压缩多少才不会丢掉 OCR、空间关系、音色或动作细节;
- 时间与空间预算:高分辨率和长视频怎样进入有限上下文,哪些 token 可以合并或递推;
- 可验证性:开放式描述容易显得流畅,grounding、计数、时序因果、生成一致性和闭环收益却需要可定位的证据。
读新工作时,先问它改变了哪一个瓶颈,再看它是否只是增加数据、模型和推理预算。这样,模型名称会不断更换,技术位置仍然清楚。
Reference
- Flamingo
- BLIP-2
- Visual Instruction Tuning / LLaVA
- VQ-VAE
- Denoising Diffusion Probabilistic Models
- High-Resolution Image Synthesis with Latent Diffusion Models
- Scalable Diffusion Models with Transformers
- Flow Matching for Generative Modeling
- SoundStream: An End-to-End Neural Audio Codec
- AudioLM: a Language Modeling Approach to Audio Generation
- World Models
- Mastering Atari, Go, Chess and Shogi by Planning with a Learned Model