Kimi K3 引用图谱:150 项证据如何组成一条论证链
Kimi K3 技术报告列出 150 项参考文献。它们并不都在证明 K3 的方法:有些是直接技术前身,有些是并行系统,有些只定义 benchmark 或比较模型,还有一项是独立安全评估。若把它们平铺成书目,模型机制、实验协议与外部评价就会混在一起。
本页把 150 项做一次不重不漏的主分类,并说明每项在报告论证链中的作用。编号保持与官方报告一致;同一工作虽然可能跨越多个主题,但这里只放进一个主组,方便检查覆盖:
| 分组 | 编号数 | 在报告中的主要角色 |
|---|---|---|
| K3 与 Kimi 第一方谱系 | 12 | 直接前身、家族演化或第一方组件 |
| 注意力、状态、深度、归一化与激活 | 20 | 模型结构的理论与工程背景 |
| MoE、路由与均衡 | 10 | Stable LatentMoE 与 Quantile Balancing 的谱系 |
| scaling law 与优化器 | 4 | 规模实验和 Per-Head Muon 的背景 |
| 长上下文与序列并行 | 8 | 1M context 训练和 KDA CP 的前身 |
| reasoning、RL 与蒸馏 | 11 | test-time scaling、partial rollout 与 MOPD 的上下文 |
| 量化与 speculative decoding | 5 | deployment-aware post-training |
| Agent scaffold、环境与任务 benchmark | 25 | harness、sandbox、任务合成、工作流与测量协议 |
| 训练、通信、编译器与 kernel | 17 | 3T 训练和高性能执行依赖 |
| 基线、排行榜与评测 | 37 | 测量协议或比较对象,不是方法来源 |
| 安全 | 1 | 独立能力与风险评估 |
| 合计 | 150 | 每个官方编号恰出现一次 |
K3 家族的发布日期、权重、代码、API 与许可证差别见 Kimi 技术谱系;模型本身的公式、系统和评测见 K3 工作深读;Kimi-VL、K2.5、MoonViT-V2 与 Kimi-Audio 的边界则见 Kimi 多模态分支。
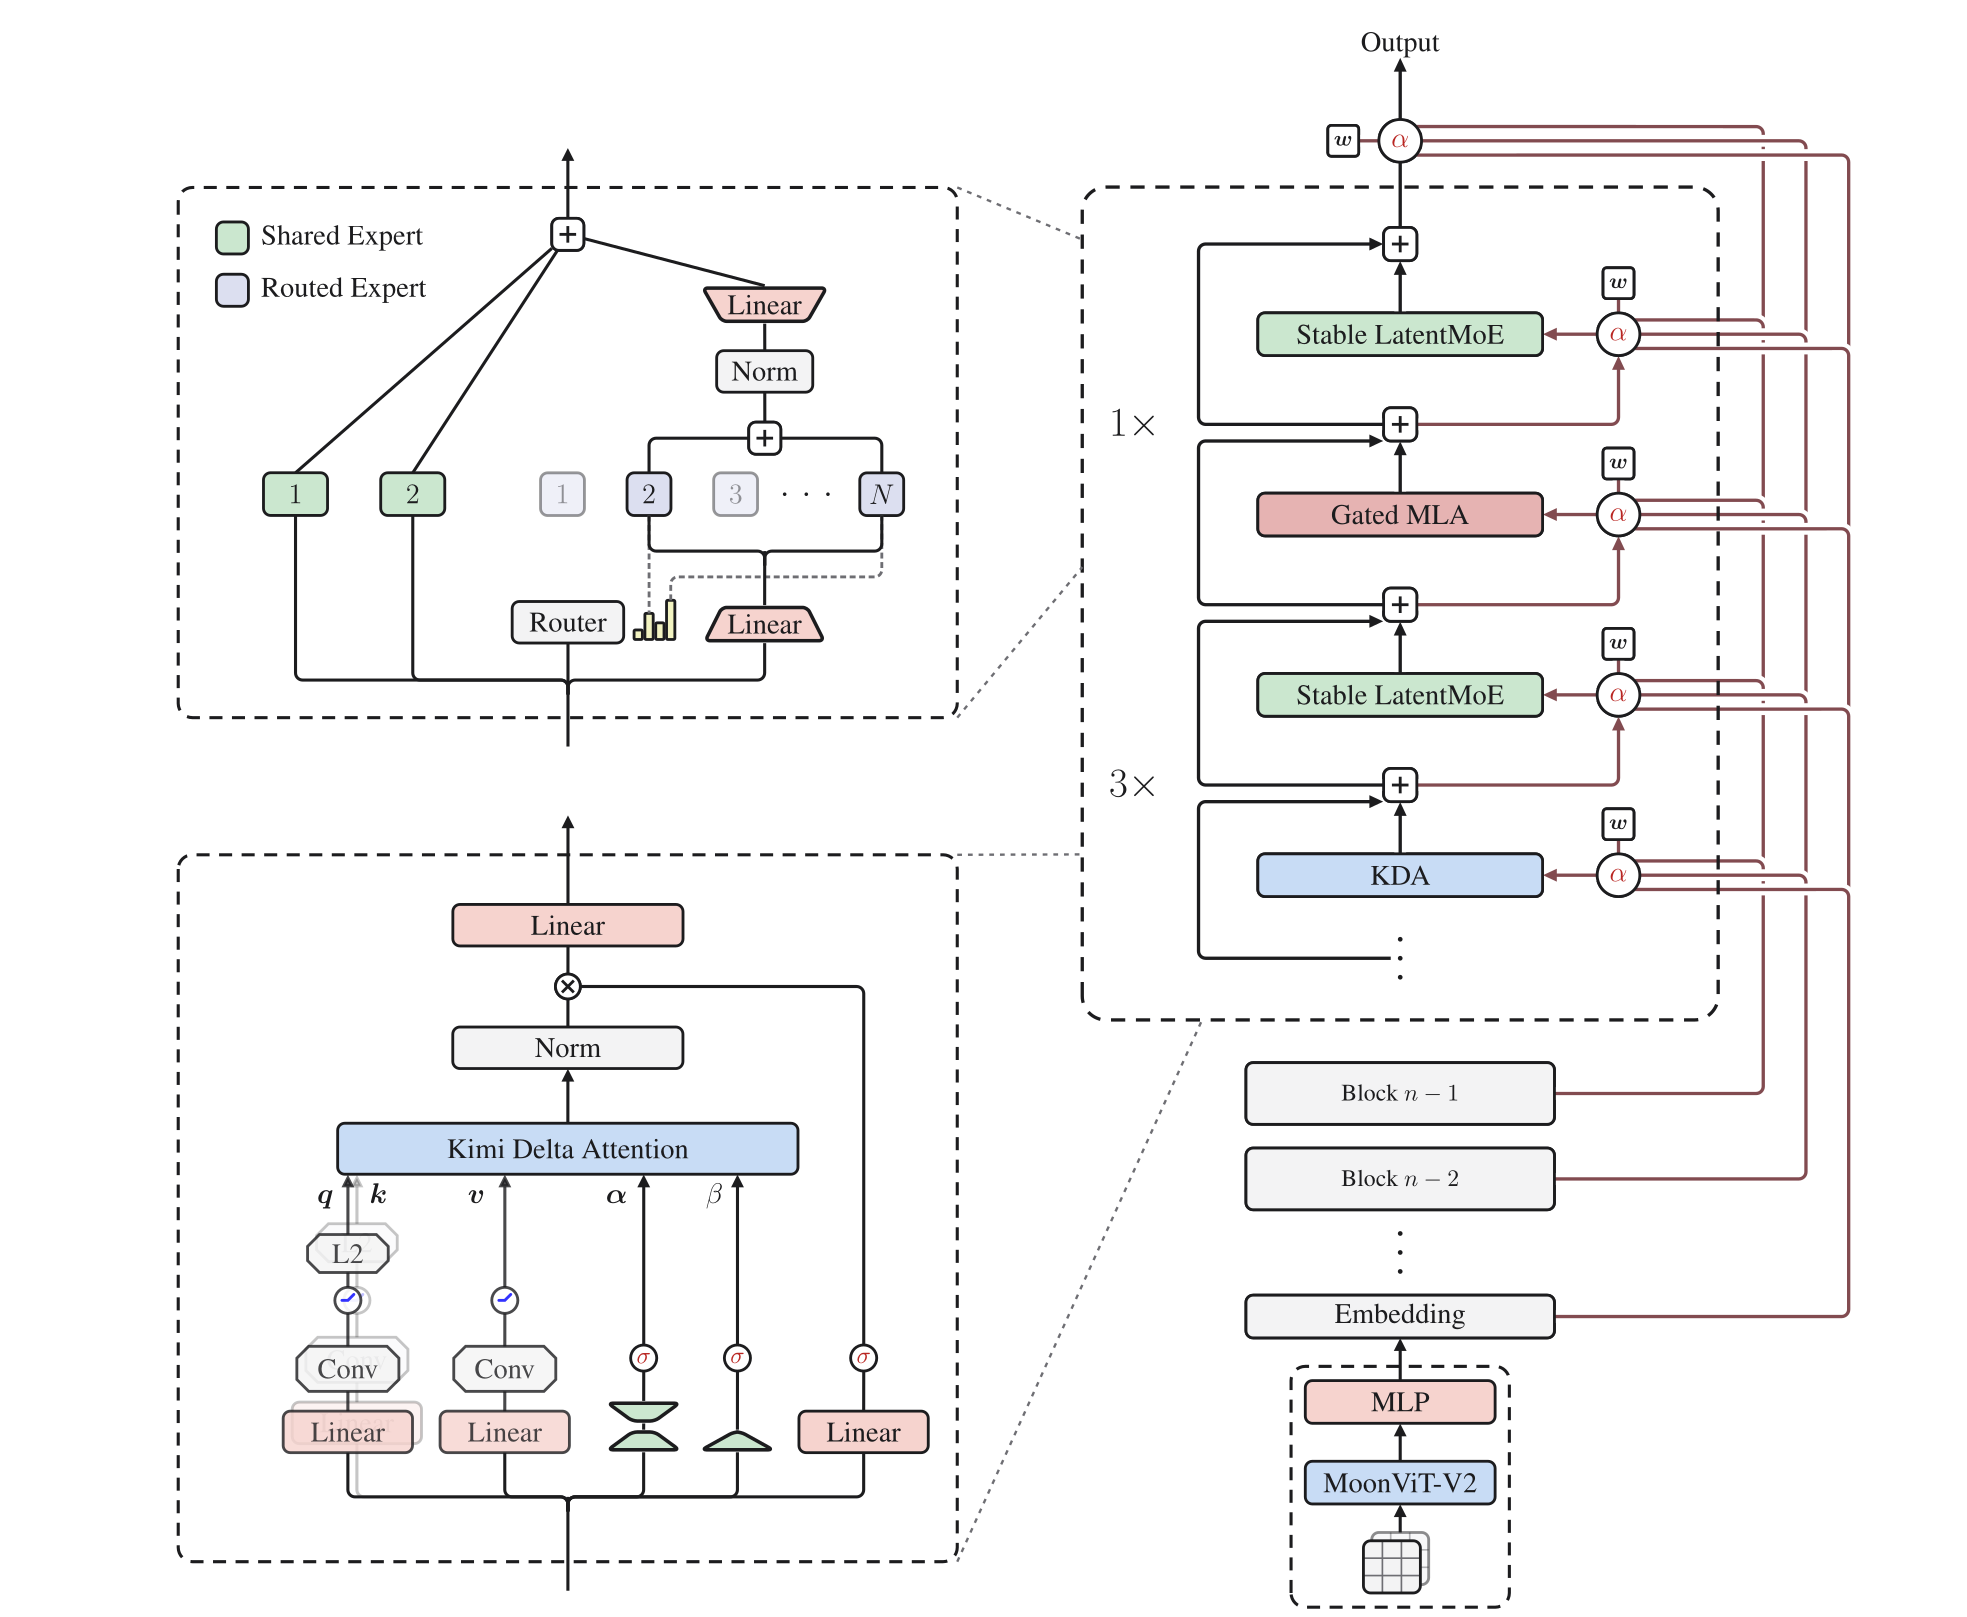
K3 与 Kimi 第一方谱系:12 项
- [14] FlashKDA:为 KDA 提供 CUTLASS kernel,是报告中 algorithm–system co-design 的直接实现证据。
- [56] Kimi CLI:定义 K3 编码评测与真实使用中的主要 agent harness,不能与裸 checkpoint 能力混为一谈。
- [57] Attention Residuals:给出沿 depth 做选择性聚合的机制,K3 采用其 Block AttnRes 版本。
- [58] Kimi K2:是 K3 scaling curve、MuonClip、MoE 训练和 agentic post-training 的直接家族基线。
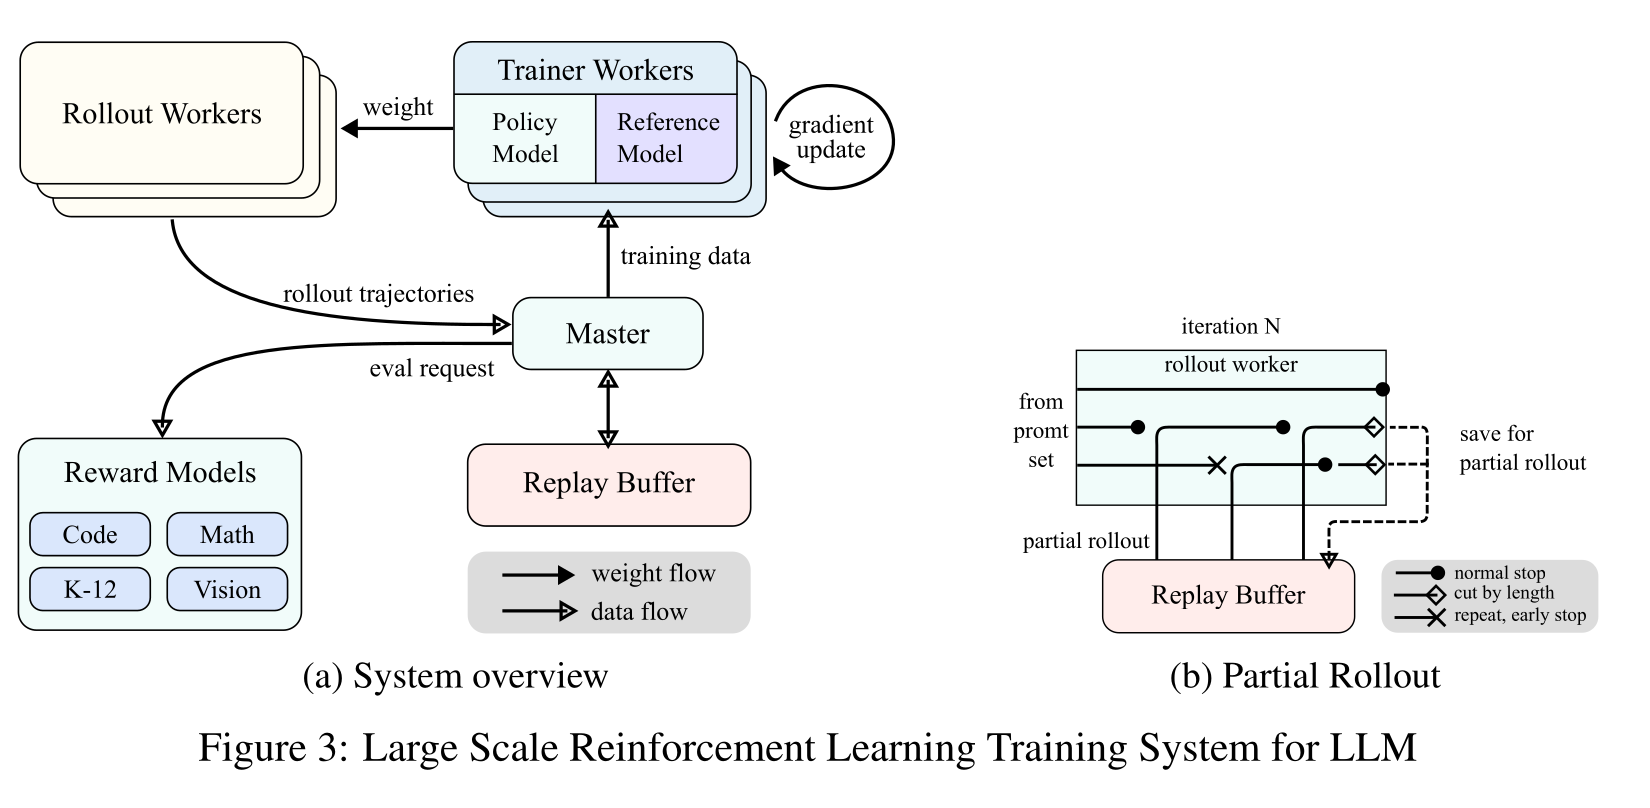
- [59] Kimi K2.5:提供原生多模态、reasoning effort、partial rollout 与 K3 policy optimization 的直接前身。
- [60] Kimi K3 发布文章:记录产品发布、能力叙事和已知限制,是报告之外的第一方发布证据。
- [61] Kimi-VL:建立 Kimi 家族的视觉语言路线,是 MoonViT-V2 与联合多模态训练的家族背景。
- [62] PerceptionBench:提供第一方原子视觉感知测量,支撑报告对 perception 与高阶 reasoning 分开评估。
- [63] Kimi Linear:正式提出 KDA 与 3:1 KDA / global-attention hybrid,是 K3 sequence mixing 的直接结构来源。
- [73] Muon is Scalable:说明 Muon 在语言模型训练中的可扩展配方,是 K2 MuonClip 和 K3 Per-Head Muon 的优化器前身。
- [96] Mooncake:K3 在训练内存管理中直接使用其 Transfer Engine,把 activation 临时 remote-offload 到其他 pipeline rank;报告没有把它列为 hybrid prefix cache 的来源。
- [118] Kimi k1.5:把长 CoT、长上下文 RL 与 partial rollout 接到一起,是 K3 百万 token agentic RL 的早期家族节点。
这组里只有 [14]、[57]、[60]直接属于 K3 发布附近的独立材料;[63]、[58]、[59]等是前身。正文提出但 bibliography 没有单列的 MoonEP、Stable LatentMoE、SiTU-GLU、Quantile Balancing、Per-Head Muon、MoonViT-V2、KDA Context Parallelism 与 XTML,应直接引用 K3 报告,不能把邻近工作误当成原始出处。
注意力、状态、深度、归一化与激活:20 项
- [10] Neural Machine Translation by Jointly Learning to Align and Translate:提供可学习内容寻址的历史起点,AttnRes 借用同一思想在 depth 轴选择历史表示。
- [24] Transformers are SSMs:用 structured state-space duality 连接 recurrence 与并行计算,是理解 KDA 状态形式的理论背景。
- [26] Language Modeling with Gated Convolutional Networks:建立 GLU 的乘法门控形式,K3 的 SiTU-GLU 在这条激活谱系上加入平滑 softcap。
- [27] Griffin:展示 gated linear recurrence 与局部 attention 的混合路线,为 KDA / MLA hybrid 提供并行架构对照。
- [28] DeepSeek-V2:提出 Multi-head Latent Attention,并提供压缩 KV 与大规模 MoE 的直接背景。
- [43] Deep Residual Learning:定义标准 residual identity path,是 AttnRes 要推广的固定深度累积机制。
- [51] PowLU:提供稳定预训练激活函数的并行方案,用于比较 SiTU-GLU 的饱和与梯度性质。
- [55] Transformers are RNNs:建立 kernelized linear attention 的 recurrent / parallel dual form,是 delta-rule 路线的基础。
- [79] Online Normalizer Calculation for Softmax:给出增量维护 softmax normalizer 的算法,支撑 Block AttnRes 与高性能 softmax kernel。
- [91] RWKV-7:代表动态状态演化的并行 linear-recurrent 路线,用于放置 KDA 的模型家族位置。
- [97] HGRN2:以 state expansion 增强 gated linear RNN,是 KDA 有限状态容量的直接比较对象。
- [98] Why Low-Precision Transformer Training Fails:分析 flash attention 的低精度误差,解释 K3 MLA 输出保留更高精度的动机。
- [99] Gated Attention for Large Language Models:说明 attention 输出门控对 sparsity 与 attention sink 的影响,是 Gated MLA 的背景。
- [105] Linear Transformers Are Secretly Fast Weight Programmers:把 delta update 解释为 fast-weight memory,是 KDA 写入残差的概念前身。
- [107] GLU Variants Improve Transformer:系统化 SwiGLU 等 GLU 变体,给 SiTU-GLU 提供直接 baseline。
- [125] Attention Is All You Need:定义 Transformer token mixing 与 residual block 的共同起点。
- [138] Gated Delta Networks:把 gated decay 与 delta rule 结合,是 KDA 最直接的算法前身。
- [140] Gated Linear Attention Transformers:展示硬件友好的 gated linear attention 训练,为 KDA chunkwise kernel 提供前置路线。
- [141] Parallelizing Linear Transformers with the Delta Rule:给出 DeltaNet 沿序列并行的算法,是 KDA chunkwise formulation 的直接技术基础。
- [146] Root Mean Square Layer Normalization:提供 K3 backbone、KDA output 与 AttnRes key normalization 使用的归一化原语。
一层前溯后,KDA 的主链是 Linear Transformer → fast weights / DeltaNet → GLA / Gated DeltaNet → Kimi Linear → K3;AttnRes 的并行背景还包括 DenseFormer、DeepNet、Hyper-Connections、MUDDFormer 与 mHC。这些工作都处理跨层信息流,但不等同于 K3 的 Block AttnRes。
MoE、路由与负载均衡:10 项
- [23] DeepSeekMoE:以细粒度专家和 shared experts 推动专家专门化,是 K3 shared / routed path 的重要前身。
- [30] DeepSeek-V3:提供 auxiliary-loss-free expert bias 与大规模 MoE 训练对照,QB 附录将其 sign update 放回同一对偶目标。
- [32] LatentMoE:在较窄 latent space 中执行大专家池,为 K3 Stable LatentMoE 的 latent projection 提供直接背景。
- [33] Switch Transformers:以 top-1 routing 扩展稀疏容量,是现代 trillion-parameter sparse model 的基线。
- [47] Step 3.5 Flash:K3 用它支持“路由失衡可能让部分 expert 训练不足”这一判断;它也是同期低激活参数 MoE 的背景,而非 Stable LatentMoE 的结构来源。
- [66] GShard:连接 conditional computation、自动 sharding 与大规模 all-to-all,是 expert parallel 的早期系统基础。
- [67] BASE Layers:用 balanced assignment 取代常规局部路由,直接连接 QB 的全局指派视角。
- [111] 最优指派视角下的 MoE 负载均衡:从 assignment dual 解释 expert bias,是 QB 推导的直接思想背景。
- [112] Expert Threshold Routing:用每 expert 阈值允许动态激活数量,是 K3 固定 top-16 + bias 路由的对照。
- [116] BIP Expert Load Balancing:用整数规划处理容量约束,QB 附录据此比较不等式约束导致的 clipping 与收敛差别。
这里还必须补上 Auxiliary-Loss-Free Load Balancing:它明确提出依据近期负载做 expert-wise bias update,是 QB 的 sign-based 前身。K3 的 QB 则在 balanced-assignment dual 上交替取精确 quantile coordinate minimizer;两者有关联但不相同。
Scaling law 与优化器:4 项
- [45] Training Compute-Optimal Large Language Models:提供 compute-optimal 参数 / token 配比背景,提醒规模比较必须固定总预算。
- [46] MiniCPM:是报告讨论 Warmup Stable Decay(WSD)时引用的 schedule 来源;K3 独立搜索后选择 cosine。
- [53] Muon:提出对隐藏层矩阵梯度做正交化更新,是 Per-Head Muon 的原始优化器起点。
- [54] Scaling Laws for Neural Language Models:建立 loss 对参数、数据与 compute 的经验幂律,是 K3“整体 scaling efficiency”叙述的基础。
K3 的约 \(2.5\times\) 是多种结构和配方共同形成的 family curve 位移,不能归因于单一组件。Per-Head Muon 还要沿 Muon → Muon is Scalable → K2 MuonClip → K3 head-wise grouping 阅读。
长上下文与序列并行:8 项
- [25] ReplaySSM:提出缓存 SSM input 而非直接缓存 state 的 serving 设计,是 K3 KDA prefix replay 的并行背景。
- [50] DeepSpeed Ulysses:沿 sequence dimension 做 all-to-all,是百万 token Transformer 训练的经典并行基线。
- [72] Ring Attention:以 blockwise ring communication 扩展近无限上下文,为 K3 hybrid layer 的 sequence partition 提供对照。
- [77] Parallelizing Linear Recurrent Neural Nets:建立线性 recurrence 可借 associative scan 并行的基础。
- [92] YaRN:提供 RoPE context extension 路线,用来对照 K3 Gated MLA 的 NoPE 选择。
- [113] LASP-2:研究 linear attention 与 hybrid architecture 的 sequence parallelism,是 KDA CP 的直接系统背景。
- [114] LASP:首次系统化 linear attention sequence parallel,为 KDA 跨设备状态传播提供前身。
- [142] Context Parallelism for DeltaNet:直接处理 DeltaNet context parallel,是 K3 KDA CP 最接近的工程先例。
K3 自身使用 8K → 64K → 256K → 1M 的 progressive curriculum,并把昂贵长序列集中在训练后段。它没有因此证明任意百万 token 位置都能均匀 recall;长度、状态容量、训练分布和任务协议需要分别测量。
Reasoning、RL 与蒸馏:11 项
- [6] Claude Extended Thinking:代表自适应 thinking budget 与可见 reasoning 的闭源 test-time scaling 路线。
- [7] Claude 4:提供 interleaved reasoning / tool use 的 frontier baseline。
- [29] DeepSeek-V4:提供 million-token intelligence 与 multi-teacher on-policy distillation 的并行模型路线。
- [40] DeepSeek-R1:证明大规模规则奖励 RL 能诱导 reasoning,是 K3 reasoning RL 的开放基线。
- [75] On-policy Distillation:解释学生在自身 rollout 上接受 teacher token feedback 的基本机制,是 K3 MOPD 的直接背景。
- [83] OpenAI o3 / o4-mini:提供 reasoning 与 tool-use test-time scaling 的闭源比较点。
- [84] Learning to Reason with LLMs:把强化学习与 test-time reasoning 作为第二条 scaling 轴,是 K3 引言的重要历史背景。
- [120] Inkling:提供 2026 年 open-weight reasoning model 的并行基线。
- [134] MiMo-V2-Flash:提供 multi-teacher / on-policy consolidation 的并行实现线索。
- [135] MiMo-V2.5-Pro:作为同时代开放模型基线,支撑“1T-class 附近趋同”的背景判断。
- [145] GLM-5:提供 agentic engineering 与大规模开放模型的同期比较。
MOPD 的更早一层是 Generalized Knowledge Distillation:学生从自己生成的分布接受 teacher feedback。与 K3 同期还应对照 DAPO、VAPO、SAO 和 CompactionRL,但报告没有声称采用这些算法。K3 是同步 partial rollout 跨 iteration 续跑;SAO 是异步 single-rollout critic 路线;CompactionRL 则显式联合学习 context compaction。
量化与 speculative decoding:5 项
- [12] Warp Decode:提供 MoE decode kernel 的同期工程优化背景。
- [49] Quantization and Training of Neural Networks:建立 fake quantization 与 quantization-aware training 的经典方法。
- [71] EAGLE-3:以多层 feature fusion 训练单层 draft,是 K3 把 MTP 层改造成 speculative draft 的直接方法来源。
- [103] Microscaling Data Formats:定义共享 scale 的 MX 数据格式背景,支撑 K3 MXFP4 weight / MXFP8 activation。
- [104] LK Losses:直接优化 speculative acceptance rate,而不是只最小化 KL,是 K3 draft fine-tuning 的目标来源。
还应连接 OCP MX Formats Specification、Speculative Decoding 与 Speculative Sampling。K3 从 SFT 起对 expert weights 做 MXFP4 QAT,并在 RL rollout / training 中维持同一量化路径;这比离线 PTQ 更深地改变训练分布。
Agent scaffold、环境与任务 benchmark:25 项
- [3] Firecracker:提供轻量 microVM 隔离和快速恢复基础,支撑长程 RL sandbox。
- [15] Claude Code:是 K3 white-box harness distribution 与编码评测的一个可配置外部 scaffold。
- [20] Codex:提供另一种 coding-agent harness 与 benchmark 对照。
- [44] Hermes Agent:代表开放 agent scaffold,说明 K3 训练不绑定一种 tool schema。
- [52] JobBench 官网:提供现实职业任务入口,也对应 K3 professional-workflow 环境。
- [68] DADI:提供按块镜像分发与快速容器部署背景,支撑大规模 sandbox image 管理。
- [70] JobBench 论文:定义 agent 是否符合人类意图的工作任务测量,用于评估长程执行。
- [78] Terminal-Bench:测量真实 CLI 环境中的长程 agent 能力,是 K3 coding-agent 主要评测之一。
- [85] Harmony Response Format:提供 think / response / tool channel 的协议背景,K3 XTML 在此基础上设计自己的 typed structure。
- [86] OpenClaw:作为可组合 agent harness 的一个实例进入 K3 white-box environment。
- [87] OfficeQA Pro:要求 agent 在企业 PDF corpus 上端到端 grounded reasoning,验证长文档工作流。
- [90] GDPval:把经济价值较高的真实工作任务纳入 agent 评估。
- [106] ResearchRubrics:用细粒度 rubric 评价 deep-research agent;它在报告中是评测项,与 K3 的 rubric-first judging 概念相邻,但不是 Agentic GRM 的方法来源。
- [108] AutomationBench:测量端到端自动化任务,覆盖 K3 autonomous execution 的能力边界。
- [109] SaaS-Bench:在真实 SaaS workflow 上评估 computer-use agent;它在报告中只作为评测项出现,不能据此视为 K3 mock-app personal-assistant 环境的来源。
- [115] Agents’ Last Exam:强调复杂、跨工具、长程任务,是 K3 general-agent 的高难度外部测量。
- [119] Tool Decathlon 官网:定义跨多种工具与长 horizon 的执行任务,也记录 K3 评测所用具体版本。
- [121] SciCode:由科学家设计研究编码任务,检验 agent 是否能完成真实数值与科学实现。
- [126] DeepSearchQA:测量 deep-research answer 的覆盖与证据整合。
- [127] APEX-Agents:提供专业 agent 能力与外部 leaderboard 对照。
- [131] BrowseComp:要求浏览代理完成难检索问题,K3 还用它分析 1M context 与 300K compaction 的差别。
- [133] MCPMark:压力测试真实 MCP 使用,测量 tool protocol 而非静态知识。
- [136] OSWorld-Verified:改进 computer-use task 的验证可靠性,是视觉 agent 评测入口。
- [143] OSWorld 2.0:扩展到长 horizon 真实操作系统任务。
- [150] SpreadsheetBench 2:测量端到端业务表格工作流,连接 professional deliverable 与可验证终态。
这一组的历史前溯还应包括 ReAct、Toolformer、SWE-agent、OpenHands 和 OSWorld。它们分别建立 reasoning–acting loop、训练期工具调用、软件工程 agent、开放 agent platform 与 computer-use environment;K3 的新意在统一 white-box harness、知识图谱任务生成、persistent living environment 和 verifier-in-the-loop AET,而不是首次提出工具型 agent。
训练、通信、编译器与 kernel:17 项
- [5] PyTorch 2:提供 dynamo / graph compilation 基础,也是 K3 case study 与 kernel workflow 的执行环境。
- [22] cuBLAS:作为厂商高性能矩阵库,给 K3 kernel case study 提供硬件效率参照。
- [41] SonicMoE:直接启发 K3 重写 permuted-probability gradient,从而移除 backward 对 forward output 的依赖并允许 activation 释放或重算。
- [48] GPipe:建立 microbatch pipeline parallelism,K3 的细粒度 recomputation 与 AttnRes cross-stage cache 在其系统背景上展开。
- [64] MLIR:提供多层 compiler IR 基础,直接支撑 MiniTriton case study 的编译管线。
- [80] Nangate 45nm Open Cell Library:为 nano-kpu 的综合与面积 / 时序报告提供公开标准单元库。
- [81] Megatron-LM:定义 tensor、pipeline 与 data parallel 组合,是 3T 训练并行的基础。
- [82] NCCL:提供 GPU collective communication 原语,进入 expert、tensor 与 pipeline parallel。
- [89] PyTorch:是报告代码、训练框架和 reference kernel 的基础软件。
- [100] ZeRO:通过分片 optimizer、gradient 与 parameter state 降低显存,是 K3 memory-efficient training 的历史基础。
- [110] ThunderKittens:提供 tile-level GPU kernel 抽象,也进入 K3 kernel-optimization RL task distribution。
- [122] Triton:定义 tiled GPU programming language,是 kernel RL 与 MiniTriton 的直接语言背景。
- [129] TileLang:提供 composable tiled programming model,是 K3 kernel 任务覆盖的编程路线之一。
- [132] UltraEP:以 rack-scale expert parallel 和负载均衡优化 MoE,是 MoonEP 的同期系统对照。
- [137] Scalable MoE Training with Megatron Core:给出 Megatron Core / Echo expert parallel 设计,是 MoonEP 的直接比较对象。
- [139] Flash Linear Attention:提供 linear-attention Triton kernel 与 KDA reference backend。
- [147] DeepEP:提供高性能 expert-parallel dispatch / combine,MoonEP 以不同的动态冗余设计与之比较。
K3 的系统主链不是“用了更多并行缩写”,而是让结构约束变成系统原语:bounded KDA decay 进入 tile kernel,AttnRes block 进入 pipeline cache,QB quantile 进入整数 histogram all-reduce,MoonEP 把动态路由变成固定 rank load。完整系统连接见分布式训练与推理运行时。
基线、排行榜与评测:37 项
- [1] τ³-Banking:测量知识密集银行 agent,而不是提供 K3 训练方法。
- [2] AA-Briefcase:用 Elo 比较 agentic knowledge work,属于第三方动态快照。
- [4] Agents’ Last Exam Leaderboard:提供特定 harness 下的官方榜单结果,分数必须绑定日期。
- [8] Artificial Analysis:提供能力、价格与效率第三方指数,不能替代同协议独立复现。
- [9] AA-LCR:测量长上下文 reasoning,结果同时受长度和推理预算影响。
- [11] MCP-Atlas:在真实 MCP server 上评估 tool-use competency。
- [13] BabyVision:刻意弱化语言捷径,测量视觉 reasoning。
- [16] Claude Fable 5:是报告所列强闭源基线之一,部分任务存在 fallback。
- [17] Claude Opus 4.8:提供 coding、agentic 与 cost 的闭源比较点。
- [18] Claude Sonnet 5 System Card:报告在 BrowseComp 的 cost-efficiency 比较中引用其公开成本图,不把它当作 K3 方法来源。
- [19] Claude Sonnet 5:作为 cost-efficiency 图中的服务基线。
- [21] CorpFin v2:测量公司金融工作流,属于专业 agent 外部评测。
- [31] DeepSWE:测量软件工程 agent;报告同时披露 Kimi Code 与 mini-SWE-agent harness 差异。
- [34] Finance Agent v2:测量金融 agent,分数来自第三方平台。
- [35] FrontierSWE:测量 frontier software engineering,结果依赖 harness 与 dominance 计算版本。
- [36] Video-MME:测量视频理解,是 K3 原生视觉能力的一项外部证据。
- [37] GLM-5.2:作为同期开放 / API 模型基线,部分分数由其发布文章提供。
- [38] GPT-5.5:是 reasoning、coding、agent 与成本的闭源比较对象。
- [39] GPT-5.6 Sol:是报告最强基线之一,结果需要保留 xhigh / cyberguard 等配置。
- [42] Harvey LAB:测量法律 agent 的 criterion pass rate。
- [65] Legal Research Bench:测量法律研究工作流,属于第三方专业任务评测。
- [69] Tool Decathlon:评估多工具、现实、长 horizon 执行,报告采用其 verified 版本。
- [74] LMArena:提供 Text / WebDev / Agent Arena 动态 Elo,必须保留查询日期。
- [76] MLS-Bench:评估构建 AI 系统的 coding agent,而不只是生成单函数。
- [88] OmniDocBench:测量复杂 PDF document parsing,是 K3 文档视觉的外部指标。
- [93] Humanity’s Last Exam:提供高难度知识与 reasoning 测量,并区分有无工具。
- [94] PostTrainBench:评估模型执行 post-training 工程任务的能力,硬件与 harness 版本会影响结果。
- [95] ProgramBench:提供程序任务的第三方可比结果。
- [101] GPQA:测量 graduate-level science reasoning,是 K3 单步知识 / reasoning 基线。
- [102] ZeroBench:以当时模型近乎无法完成的视觉问题测量上限,报告同时给出 Python tool augmentation。
- [117] SWE Marathon:测量长程软件与 GPU 工程;K3 报告使用 H20 校准的 pre-v1.1 分支。
- [124] Vals AI:提供 ProgramBench 与专业 agent 分数,也是随时间更新的第三方聚合平台。
- [128] MATH-Vision:测量多模态数学推理,报告区分无工具与 Python tool 分数。
- [130] CharXiv:测量真实图表理解,RQ 与 Python 增强结果需分开。
- [144] MMMU-Pro:提高多学科多模态题的鲁棒性,报告同时记录 tool augmentation。
- [148] MMVU:测量专家级多领域视频理解。
- [149] WorldVQA:测量多模态模型的原子世界知识。
这 37 项共同支持“覆盖面广”,却不能自动支持公平的 checkpoint 排名。K3 表格混合了官方 leaderboard、作者重跑、不同 harness、tool augmentation、reasoning effort、fallback、context compaction 与 H20 calibration;每个数字都应保留协议脚注,详见评测对象如何扩张。
安全:1 项
- [123] UK AISI / US CAISI 对 Kimi K3 网络安全能力的初步评估:提供独立 cyber capability 证据,同时显示 exploit 能力增长与完整 arbitrary-code-execution 链仍有限。
它只支持特定任务集上的初步能力判断,不能推广成整体安全认证。公开权重、长 autonomy、终端工具和 preserved thinking 会共同扩大部署风险面;权限、隔离、日志、可中断性和 abuse monitoring 应作为独立系统设计。
从引用图谱回到 K3 的十条主链
| 主链 | 历史节点 | K3 落点 |
|---|---|---|
| sequence state | Linear Transformer → DeltaNet → Gated DeltaNet → Kimi Linear | lower-bounded KDA、FlashKDA、KDA CP、state cache |
| global retrieval | Transformer → MLA → gated attention | 每 3 层 KDA 插入 1 层 Gated MLA,末层保持全局 attention |
| depth retrieval | residual / PreNorm → DenseFormer / Hyper-Connections → AttnRes | 8-block Block AttnRes 与 pipeline cache |
| sparse width | GShard / Switch → DeepSeekMoE → LatentMoE | Normalized LatentMoE、16/896 与 2 shared experts |
| router balance | auxiliary loss → loss-free bias → assignment / BIP | Quantile Balancing 与 histogram all-reduce |
| optimization | Muon → Scalable Muon → MuonClip | Per-Head Muon |
| long context | YaRN / Ring / Ulysses → LASP / DeltaNet CP | progressive 1M curriculum 与 KDA context parallelism |
| post-training | K1.5 → K2 → K2.5 | 九个 domain × effort experts、partial rollout、MOPD |
| deployment | MX QAT、EAGLE-3、LK loss | native MXFP4 / MXFP8、MTP draft、hybrid prefix cache |
| agent system | ReAct / tool learning → coding and computer-use environments | white-box harness、KG task synthesis、persistent sandbox、AET verifier |
“相关”不等于“采用”。例如 SAO 与 CompactionRL 能帮助比较 K3 长程 RL,却不是报告声明的训练算法;DenseFormer 与 mHC 能解释 depth mixing 的问题,却不是 Block AttnRes 的实现;OCP MX 规范定义格式,也不能证明 K3 的特定 QAT recipe。保持这条归因边界,引用图谱才会帮助理解,而不是把所有相邻工作揉成一个未经证实的系统。
Reference
- Kimi K3 official technical report
- MoonshotAI/Kimi-K3 official repository
- Kimi K3 model card and weights
- Kimi Linear: An Expressive, Efficient Attention Architecture
- Attention Residuals
- MoonshotAI/FlashKDA
- MoonshotAI/MoonEP
- Kimi K2: Open Agentic Intelligence
- Kimi K2.5: Visual Agentic Intelligence
- Kimi-VL Technical Report