图像生成:离散 Token、Diffusion 与 Flow
图像生成模型需要把简单先验分布或离散序列变成高维像素。主要路线分别建模:
- 离散视觉 token 的条件概率;
- 加噪过程的反向去噪;
- 噪声到数据之间的连续向量场。
三者的训练目标、采样路径和失败模式不同,不能只按最终样例比较。
DDPM、DiT 与 Flow Matching 把去噪目标、Transformer backbone 和连续向量场放在同一组符号下比较;它们与视觉语言理解路线的汇合位置见多模态理解与生成。
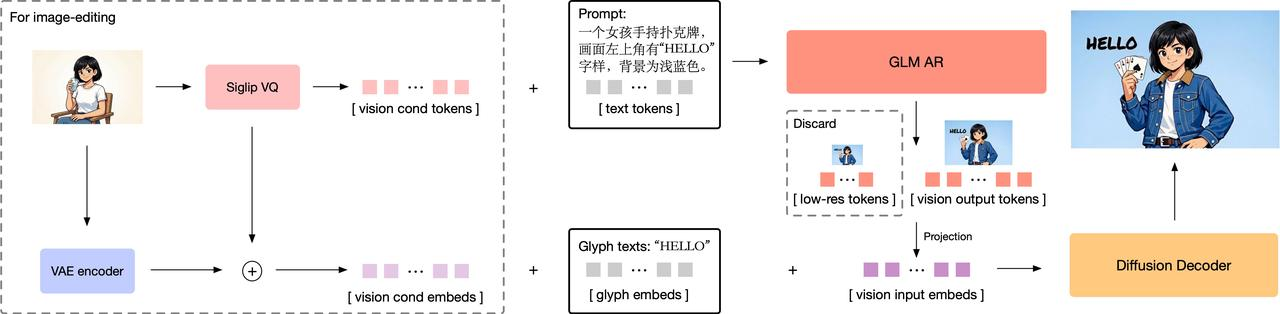

VQ 表示
Encoder 产生连续 latent:
对每个位置选择最近码本向量:
VQ-VAE 的典型目标包含重建、码本和 commitment:
Straight-through 路径可写为
前向使用 \(z_q\),反向把 decoder 梯度传给 encoder。
VQ 的语义核是“最近邻用于前向,straight-through 用于 encoder 梯度”。下面把 flattened latent 写为 [position, dim];空间 layout 应在外围显式展平并原样恢复。
import torch
def vector_quantize(z_e, codebook, beta=.25):
    if z_e.ndim != 2 or codebook.ndim != 2 or z_e.size(1) != codebook.size(1):
        raise ValueError("expected [position, dim] and [code, dim]")
    distance = (z_e.square().sum(1, keepdim=True)
                + codebook.square().sum(1) - 2 * z_e @ codebook.T)
    index = distance.argmin(1)
    z_q = codebook[index]
    z_st = z_e + (z_q - z_e).detach()
    codebook_loss = (z_q - z_e.detach()).square().mean()
    commitment = beta * (z_e - z_q.detach()).square().mean()
    return z_st, index, codebook_loss + commitment
z = torch.tensor([[.9, .1], [.1, .8]], requires_grad=True)
codebook = torch.tensor([[1., 0.], [0., 1.]], requires_grad=True)
z_st, index, vq_loss = vector_quantize(z, codebook)
torch.testing.assert_close(z_st, codebook[index])
assert index.tolist() == [0, 1]
(z_st.sum() + vq_loss).backward()
assert z.grad is not None and codebook.grad is not None
z_st 的数值等于码本向量,但对 decoder loss 的局部导数按恒等映射流向 z_e;codebook 与 commitment 两项各自 detach,避免错误地互相追逐。生产 tokenizer 还要监控 code usage、dead code、EMA 更新约定和 padding/特殊 code。
VQGAN 加入感知与对抗目标,提高重建的感知质量。重建更锐利不一定意味着码本更适合语义建模;tokenizer 需同时评估 reconstruction、code usage 与下游生成。
离散自回归与 masked generation
量化后可建模
优点是与语言模型、交错图文和受约束解码统一;缺点是生成步数随视觉 token 数增长,且 raster 顺序对二维局部性不友好。
MaskGIT 并行预测被 mask 的图像 token,并迭代保留高置信位置。迭代 masked generation 需要明确每步 remask schedule、置信度和最终未填位置处理。
Diffusion 前向过程
DDPM 定义逐步加噪。记
则可以直接采样任意时刻:
噪声预测目标:
模型也可预测 \(x_0\)、score 或 velocity。Prediction type、noise schedule 与 sampler 必须成套匹配。
DDIM 与采样
DDIM 构造与 DDPM 共享训练边缘分布的非马尔可夫采样路径,可减少采样步数并控制随机性。少步不自动保持质量;时间步子集、参数化和 discretization 都会改变误差。
Latent diffusion
Latent Diffusion 先用 autoencoder 压缩图像:
再在 latent \(z\) 上扩散。空间压缩降低计算,但 decoder 重建误差构成上限。实现必须固定 autoencoder 版本、latent scale、通道布局和像素归一化。
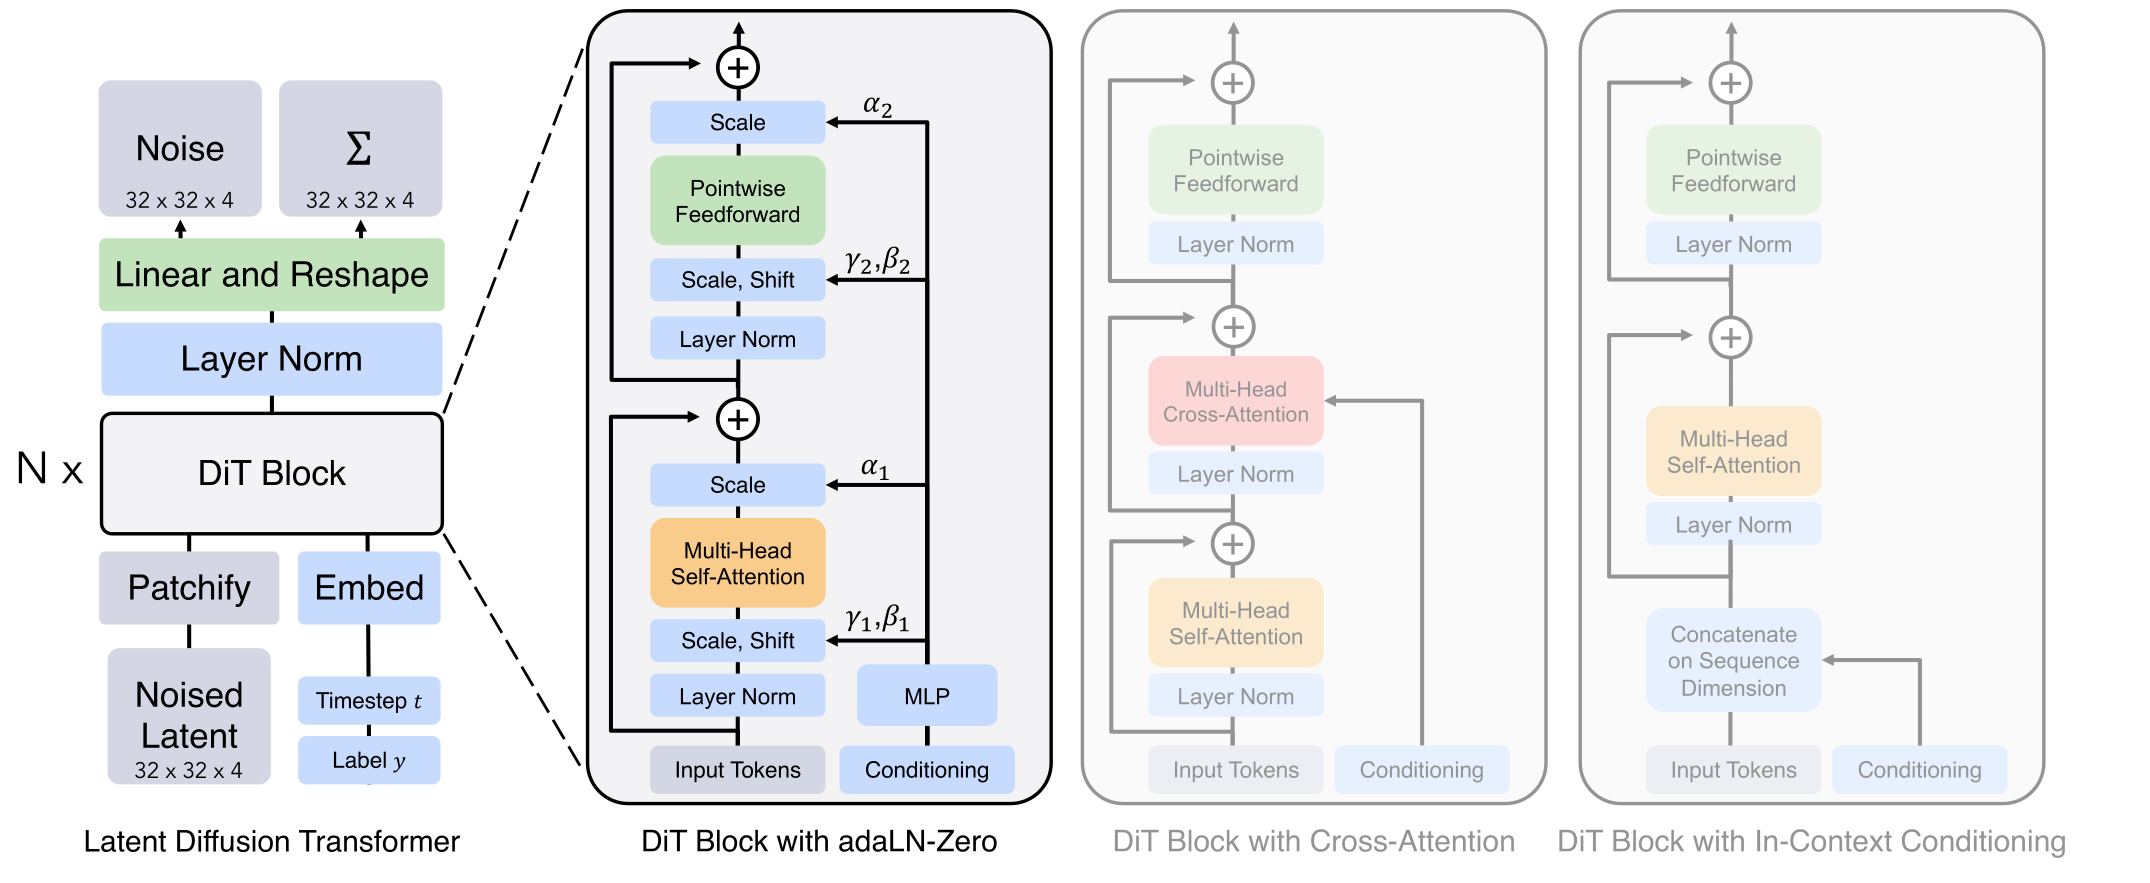
DiT 使用 Transformer 处理 latent patches,并通过时间和条件调制 block。其“Transformer”是去噪 backbone,不等于自回归语言模型。
Conditioning
常见条件接口包括:
- cross-attention;
- AdaLN/FiLM 尺度与偏置;
- 条件 token 拼接;
- control encoder;
- classifier-free guidance。
Classifier-free guidance:
\(w\) 提高通常增强条件遵循,但可能降低多样性、产生过饱和和伪影。训练时条件 dropout、无条件分支定义与 batch 拼接顺序必须和推理一致。
Flow matching
连续流满足
Flow Matching 直接回归选定概率路径的条件向量场。对简单线性插值:
目标:
Rectified Flow 研究把耦合路径变直以减少积分误差。训练不需要完整解 ODE,推理仍需 solver:
是最简单 Euler 步。时间方向、边界分布和步长写反会生成完全错误的过程。
加噪、CFG 和 flow 积分很短,却最容易因 broadcast、条件对齐或时间方向产生静默错误。下面约定 alpha_bar 已按 batch 选好并可广播,flow 从 \(t=0\) 的 noise 积分到 \(t=1\) 的 data;模型函数只接收当前状态与标量时间。
Diffusion 加噪、CFG 与 Euler flow
import torch
def q_sample(x0, noise, alpha_bar):
    while alpha_bar.ndim < x0.ndim:
        alpha_bar = alpha_bar.unsqueeze(-1)
    return alpha_bar.sqrt() * x0 + (1 - alpha_bar).sqrt() * noise
def classifier_free_guidance(unconditional, conditional, scale):
    if unconditional.shape != conditional.shape:
        raise ValueError("conditional branches must align")
    return unconditional + scale * (conditional - unconditional)
@torch.no_grad()
def euler_flow(x, velocity, steps):
    if steps <= 0:
        raise ValueError("steps must be positive")
    dt = 1 / steps
    for step in range(steps):
        t = x.new_tensor(step * dt)
        x = x + dt * velocity(x, t)
    return x
x0 = torch.tensor([[1., -1.]])
noise = torch.tensor([[3., 5.]])
torch.testing.assert_close(q_sample(x0, noise, torch.tensor([1.])), x0)
torch.testing.assert_close(q_sample(x0, noise, torch.tensor([0.])), noise)
u, c = torch.zeros(2), torch.tensor([1., 2.])
torch.testing.assert_close(classifier_free_guidance(u, c, 0), u)
torch.testing.assert_close(classifier_free_guidance(u, c, 1), c)
start = torch.zeros(2)
end = euler_flow(start, lambda x, t: torch.ones_like(x), 4)
torch.testing.assert_close(end, torch.ones(2))
assert not end.requires_grad
这不是 DDPM/DDIM sampler:q_sample 只实现训练侧闭式前向边缘,Euler 只实现给定向量场的 ODE 积分。真实 sampler 必须把 prediction type、schedule、solver 与时间网格作为同一版本化契约;CFG 两个分支还需共享 latent、时间与 batch 顺序。
少步与一致性
Consistency Models 学习同一概率流轨迹上不同点映射到一致输出,可支持一步或少步生成。应分别报告:
- 是否从预训练 diffusion 蒸馏;
- 一步、少步和多步质量;
- 采样成本与训练额外成本;
- 新分布和强 guidance 下的稳定性。
Shape 与实现契约
图像 latent 常写为
DiT patchify 后:
实现应固定:
- 像素范围与 channel order;
- autoencoder latent scale;
- \(\beta_t,\alpha_t,\bar\alpha_t\) 的索引约定;
- prediction type;
- 时间 \(t\) 的方向和离散网格;
- conditional/unconditional batch 对齐;
- solver、步数和随机性;
- VQ codebook、特殊 token 与扫描顺序。
失效模式
- Codebook collapse:少数 code 占据大部分位置。
- Dead codes:部分 embedding 永远不被选择。
- 重建上限:生成错误来自 tokenizer/autoencoder 而非 prior。
- 参数化错配:模型预测 \(v\),sampler 按 \(\epsilon\) 解释。
- Schedule 错位:训练与推理时间索引不一致。
- CFG 过强:条件遵循提高但多样性和自然度下降。
- Flow 方向错误:从数据积分到噪声而非反向。
- Solver 截断:少步误差集中在细节或构图。
- 评测混淆:只看感知质量,不测文字、计数和属性绑定。
验证矩阵
| 层级 | 测试 |
|---|---|
| VQ | 最近邻、STE 梯度、code usage、原图重建 |
| Forward noise | \(t=0\)、末端分布、经验均值与方差 |
| Prediction | \(\epsilon/x_0/v\) 相互转换 |
| CFG | \(w=0,1\) 与 batch 对齐 |
| Flow | 边界、方向、Euler 步与解析向量场 |
| Sampling | seed、步数、solver、guidance 网格 |
| 语义 | 文字、数量、空间、属性绑定与身份 |
| 系统 | 采样步数、延迟、峰值显存与吞吐 |
理解与生成怎样共享主干见理解与生成统一,音视频的离散表示见音频与语音和视频与世界模型,最小 VQ、加噪、CFG 与 flow sampler 见多模态手撕实现。
继续深入
本页保留三条生成路线的共同符号与稳定入口:
- 从像素概率到 GAN 补齐 likelihood、adversarial game 与离散 AR 的历史;
- Autoencoder 与视觉 Tokenizer 讨论压缩、码本和 decoder 上限;
- Diffusion 与 Score 统一离散加噪、score、SDE 与 prediction type;
- Latent Diffusion、DiT 与 Flow 连接生成空间、backbone、概率路径和少步采样;
- 条件控制、编辑与评测分开条件遵循、局部编辑、身份保持、质量与系统成本。