推测解码:接受规则、状态与收益边界
标准自回归生成每次 target forward 只确认一个 token,串行深度等于输出长度。推测解码先便宜地产生多个候选,再让 target 一次并行验证;它减少的是 target 的串行调用次数,而不是 target 必须表达的条件分布。
“一次接受多个 token”不自动保证结果正确。需要区分保持 target 分布的精确算法、只保持 greedy 结果的算法,以及改变分布的近似算法。
两模型精确采样
设 draft policy 为 \(q\),target policy 为 \(p\)。draft 依次提出
target 对候选前缀一次计算各位置分布。对候选 \(x_i\),精确接受概率为
若拒绝,不能简单改从 \(p_i\) 重采样,而要从正残差分布采样:
若全部 \(\gamma\) 个候选均接受,再从 target 的下一个位置采样一个额外 token。Leviathan 等人的 speculative decoding 与并行 speculative sampling 给出了这类保持 target 分布的方法。
关键不是概率公式孤立成立,而是 \(p_i\) 和 \(q_i\) 必须已经应用同一套当前状态下的 temperature、penalty、grammar、禁用 token 与其他 logit processors。
单位置接受 reference
target 是普通目标解码在该历史上实际使用的离散分布,draft 是同一验收位置上
候选的实际提议分布;两者不必使用相同的采样 processor,但必须映射到同一验收词表。
token 是 draft 已采样的候选,uniform 是本次接受检验的均匀随机数。接受时返回
(True, None);拒绝时返回归一化后的正残差分布,供调用者采样替代 token。
import torch

def verify_candidate(target, draft, token, uniform):
    if target.ndim != 1 or target.shape != draft.shape or target.numel() == 0:
        raise ValueError("target and draft must be aligned one-dimensional distributions")
    if not isinstance(token, int) or not 0 <= token < target.numel():
        raise ValueError("token must index the shared vocabulary")
    if not torch.all(torch.isfinite(target) & (target >= 0)) or not torch.all(
            torch.isfinite(draft) & (draft >= 0)):
        raise ValueError("probabilities must be finite and non-negative")
    torch.testing.assert_close(torch.stack((target.sum(), draft.sum())), target.new_ones(2))
    if not 0 <= float(uniform) < 1:
        raise ValueError("uniform must lie in [0, 1)")
    if draft[token] <= 0:
        raise ValueError("draft could not have sampled this token")
    accept_probability = torch.minimum(
        target.new_ones(()), target[token] / draft[token]
    )
    if uniform < accept_probability:
        return True, None
    residual = (target - draft).clamp_min(0)
    if residual.sum() <= 0:
        raise ValueError("rejection has no residual mass")
    return False, residual / residual.sum()

p, q = torch.tensor([0.8, 0.2]), torch.tensor([0.2, 0.8])
accepted, residual = verify_candidate(p, q, token=1, uniform=0.9)
torch.testing.assert_close(residual, torch.tensor([1., 0.]))
assert verify_candidate(p, p, token=0, uniform=0.999)[0]
impossible = verify_candidate(torch.tensor([0., 1.]), torch.tensor([1., 0.]), 0, 0.)
assert not impossible[0] and impossible[1].tolist() == [0., 1.]
for bad in [(p, q, -1, .5), (p, p[:, None], 0, .5)]:
    try:
        verify_candidate(*bad)
    except ValueError:
        continue
    raise AssertionError("invalid distributions and token indices must be rejected")
正残差非负且和为 \(1\),\(p=q\) 时所有合法 draft token 都被接受。该函数只定义一个 位置的分布语义;完整运行时还要负责候选链的条件历史、拒绝后逻辑状态不再引用 suffix,以及“全接受后额外 target token”。若另求同 seed 逐字重放,才还需额外 对齐 RNG 消耗;分布精确性本身不要求复制普通 AR 的随机数轨迹。
接受长度与速度模型
为形成直觉,假设各位置条件接受率恒为 \(a\),一次最多验证 \(\gamma\) 个 draft token。每轮期望产出 token 数近似为
当 \(a\to1\) 时,期望接近 \(\gamma+1\);接受率下降时,继续增大 \(\gamma\) 很快失去价值。
粗略速度上界为
\(T_{\mathrm{state}}\) 包含候选组织、采样、KV 提交 / 回滚、grammar 状态和跨设备同步。target verify 处理更多 query token,可能从 bandwidth-bound 变得更 compute-efficient,但高并发下也会改变 batch shape 和 KV 水位。
接受率不是充分指标。应同时报告:
- accepted tokens / target invocation;
- draft、verify、sample 与 state 时间;
- target invocations / output token;
- TTFT、TPOT、goodput;
- 额外权重与 KV 显存;
- 不同温度、任务、长度和 batch 的分布。
Draft 的来源
独立小模型
独立 draft 易于理解,也增加第二套权重、KV 和调度。tokenizer / vocab 必须兼容,跨设备部署还可能引入通信。小得过头会降低接受率,太大又失去成本优势。
多头候选
Medusa 在模型上增加多个 decoding heads,预测多个未来位置并构造候选树。它避免独立 draft 模型,却需要额外训练、tree attention 和候选选择;不同模式对精确性与质量的保证不能混用。
特征级 Draft
EAGLE 在特征空间进行自回归草拟;EAGLE-2 引入动态 draft tree;EAGLE-3(2025)继续调整训练和特征使用。官方实现适合核对训练产物与支持范围。
这些 2024–2025 路线说明候选不必来自完整独立语言模型,但会新增 draft head、训练数据、版本和运行时 tree verification。论文速度不能直接外推到不同 target、batch、temperature 或服务引擎。
Kimi K3 技术报告披露了一项 EAGLE-3 训练实例:以预训练的 multi-token-prediction 模块初始化 draft,冻结 target,做七步 unroll,并取第一、第四和最后一个 Attention Residual block 的特征。其 draft 只用 temperature \(1\) 的 LK loss,不再混合交叉熵:
对归一化分布,\(\sum_v\min(p_v,q_v)=1-\operatorname{TV}(p,q)\),因此目标直接提高两分布的重叠质量,而不是只惩罚 target token 的负对数概率。LK Losses 给出这一目标的一手论述。上述层位、unroll 深度和 loss 组合属于 K3 具体 recipe;迁移到另一架构时要重新搜索并测 accepted tokens、draft cost 与最终分布。整体证据见 Kimi K3。
半自回归 Block Draft
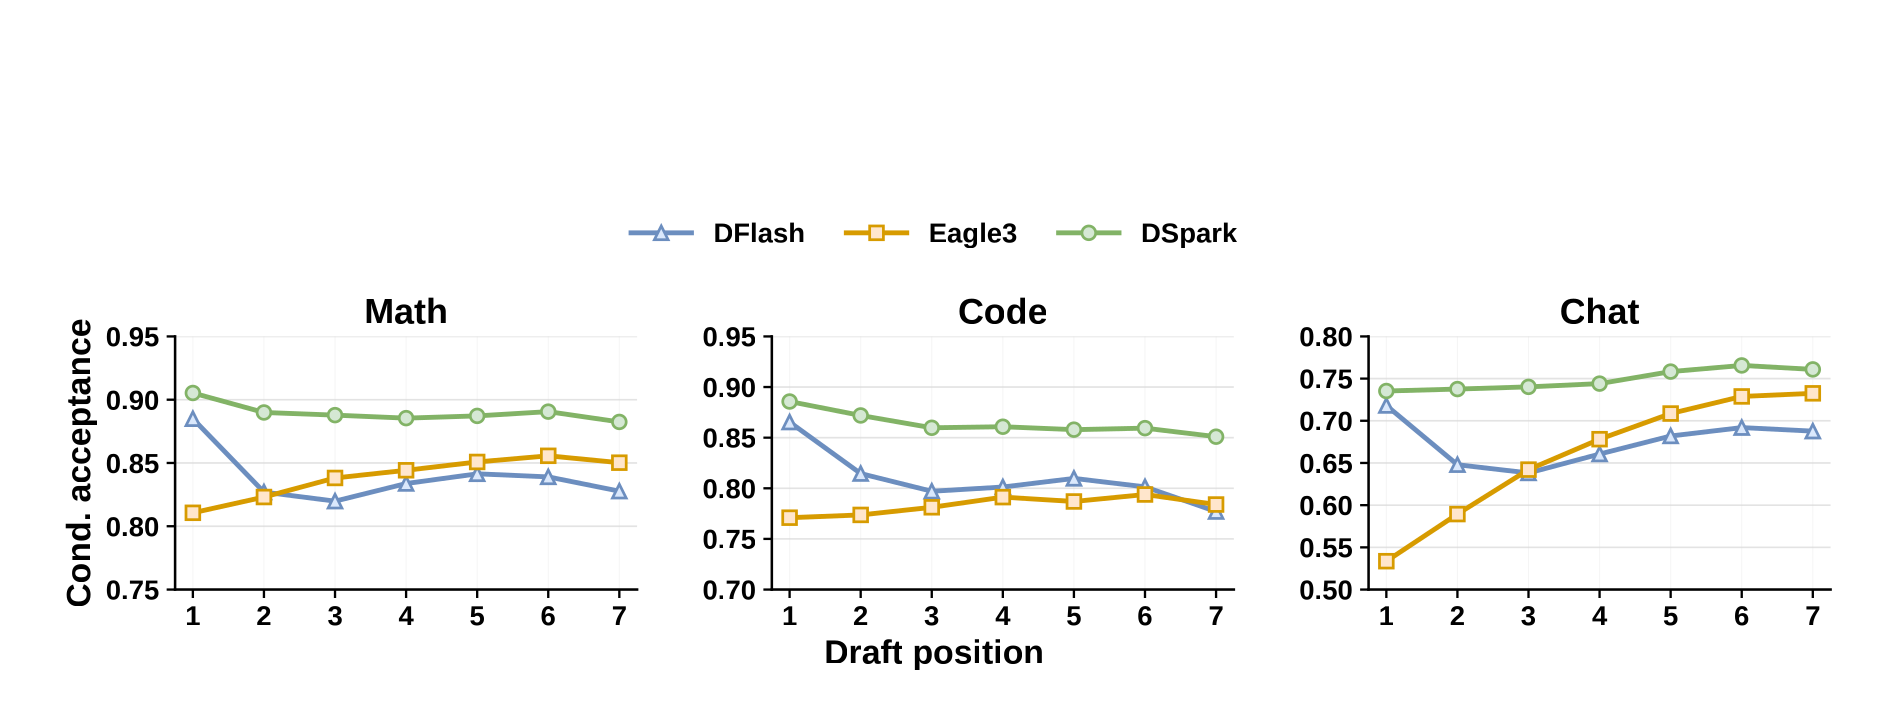
DSpark 把并行与自回归 drafter 组合在同一个 block: 较深的 DFlash 式骨干一次产生 \(\gamma\) 组 base logits,低秩 Markov head 再以刚刚 采样的前一个 token 修正下一位置:
并行骨干保留强首位置和近似固定的 draft 串行深度,顺序头则减少独立预测把多条 语义路径拼错的 suffix decay。RNN 头可以保留更长块内历史,但需要额外 recurrent state;DSpark 默认使用更简单的 Markov 版本。
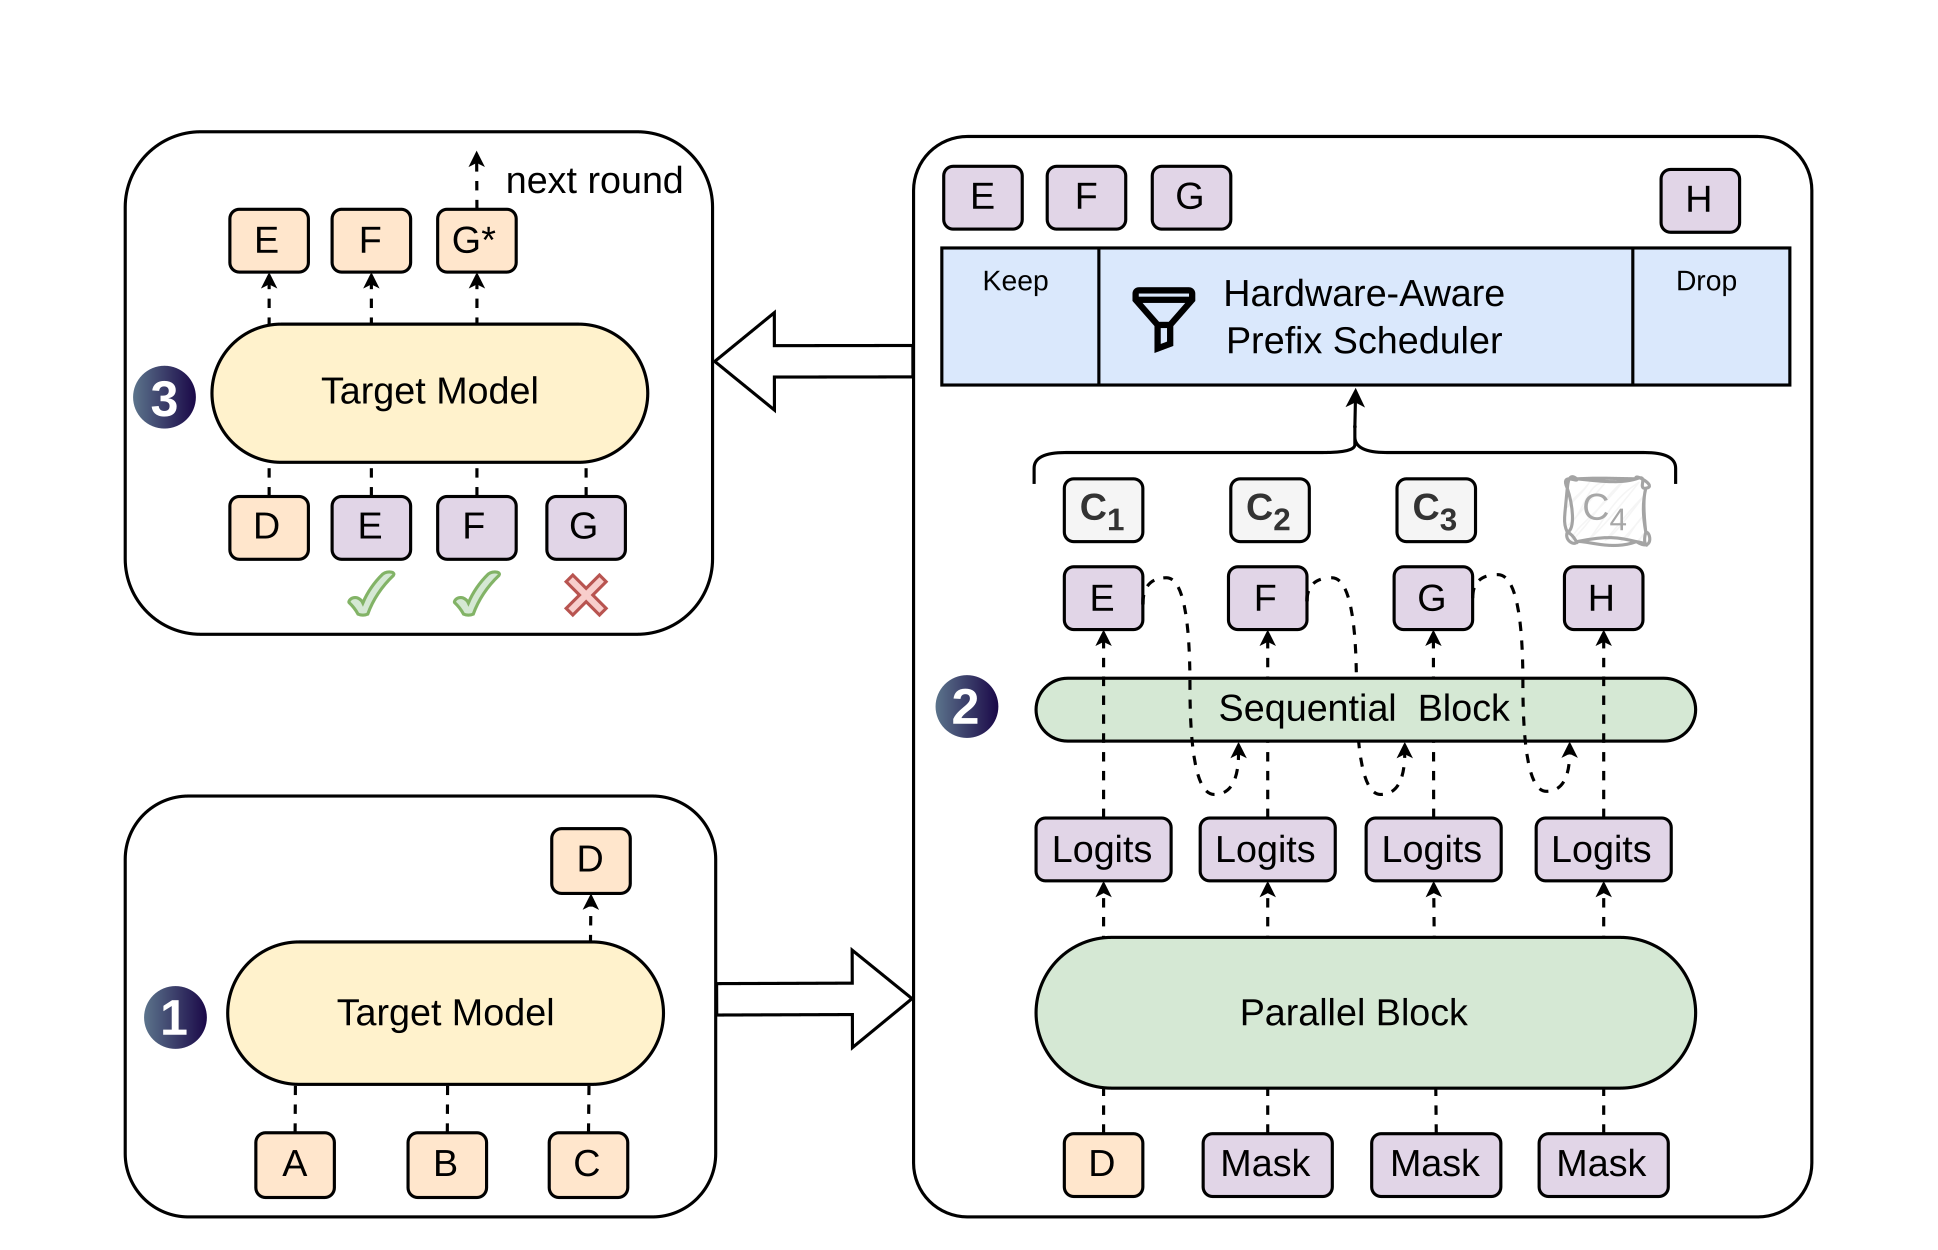
它还把 draft / target 的分布重叠
作为 confidence 软标签。请求 \(r\) 的第 \(j\) 个 prefix 存活概率为 \(a_{r,j}=\prod_{i\le j}c_{r,i}\);经过校准后,serving scheduler 可以把这些概率与 实测 step-rate 曲线结合,为不同请求分配不同 verify length。
这里要保留实现边界:官方 DeepSpec 公开训练、标准 rejection sampling 和静态 confidence-threshold 评测;完整的多请求 硬件感知调度需要支持 ragged verify、SPS cost table 与 non-anticipating admission 的 serving engine。能加载 DSpark checkpoint,不自动表示运行了论文完整 scheduler。
模型原生多 token 预测
若 target 训练时包含 multi-token prediction heads,可以复用模型内部特征产生候选。它减少额外模型驻留,但仍要定义候选分布、验证路径和部署兼容;“模型能预测多个未来 token”不等于服务默认能精确接受它们。
Tree Verification
单链 draft 只验证一个候选序列;tree 方法在一个 forward 中验证多个分支。若树有节点集合 \(\mathcal T\),verify 的成本不是节点数的简单线性函数:
宽树提高覆盖率,也增加 attention mask、候选排序、KV 分支和采样成本。tree node 的 parent、position、token 和 cache slot 必须一一对应;任何重排都要同步更新这些数组。
状态事务
一次 speculative round 应视为小事务:
snapshot committed state
create provisional draft branch
run target verification
commit accepted prefix and one target token
discard every rejected suffix
advance stream and RNG exactly once
需要同步管理:
- target 与 draft KV;
- token IDs 和 position;
- target / draft RNG counter;
- repetition / frequency penalty history;
- grammar automaton state;
- stop-sequence buffer;
- beam / tree parent;
- streaming cursor 与 finish reason。
拒绝后只裁剪 token array、却保留多写入的 KV 或 grammar state,会让后续输出静默偏离。
Recurrent state replay
对 KDA、SSM 或其他 recurrent 层,每个 speculative branch 都复制完整 state 会迅速放大显存与写带宽。另一条路线是在 draft 阶段缓存状态更新所需的 projected inputs,target 接受前缀后,再把被接受 token 的更新在片上顺序 replay,最后一次性提交新 state。这样把“每个候选分支一份 state”改成“候选输入 + 一份 committed state”。
这种 replay 必须保持接受 token 的原顺序、数值格式和 gate 语义;拒绝分支的 projected inputs 不得推进 committed state。ReplaySSM 描述了 recurrent speculative decoding 的相关机制,K3 报告则将 state replay 用于其 KDA 路径。它优化的是状态事务,不改变前文 target acceptance 的分布条件。
与 Logit Processor 的组合
若原始 target logits 为 \(z_i\),实际采样分布是处理器组合
接受比率必须使用处理后的 \(p_i\) 与 \(q_i\)。需要特别处理:
- repetition / frequency / presence penalty;
- min length、EOS 与 bad words;
- temperature、top-\(k\)、top-\(p\) 和 min-\(p\);
- JSON schema 或 grammar mask;
- 跨 token stop string;
- all-masked grammar state。
若 draft 无法表达 target 的 tokenizer 或约束状态,应关闭精确 speculative,而不是用近似映射伪装兼容。
Batch 与服务
不同请求会在不同位置拒绝,造成 verify 后输出数和下一轮 shape 不规则。调度器需要决定:
- speculative 与普通 decode 是否混排;
- 每请求 \(\gamma\) 是否动态;
- draft 和 target 是否共用 GPU;
- provisional KV 是否进入 block budget;
- graph bucket 怎样覆盖不同 tree;
- 高负载时是否降级为普通 decode。
低并发单请求最容易获得串行深度收益;高并发 target 本身已形成大 batch 时,draft 可能抢占同一 GPU 的算力和显存。服务优化应以 goodput 而非单请求 speedup 决策。
正确性契约
- 明确声明保持的是 target 采样分布、greedy 输出还是近似质量;
- \(p\)、\(q\) 使用相同 token space 和处理器顺序;
- 每个候选位置的分布条件于正确的已接受历史;
- 残差分布非负、归一化,并覆盖浮点舍入边界;
- 拒绝 suffix 的 KV、RNG、grammar 和 stop state 全部回滚;
- provisional block 不可被其他请求或 prefix cache 看见;
- accepted token 只流式发送一次;
- 关闭 speculative 后,普通 decode 路径仍是独立 reference。
浮点误差可能让 \(p-q\) 出现微小负值,应先取正部再归一化;若残差和数值退化,需要定义稳定 fallback。
常见失效
- 接受率高却不加速:draft、tree 构造或 state transaction 占主导;
- 温度升高后收益骤降:draft 与 target 分布更难一致;
- grammar 请求出现错误:processor 状态没有随分支复制和回滚;
- p99 变差:少数低接受请求反复支付 draft + verify;
- 高并发吞吐下降:draft 占用 target 的关键资源;
- 显存超预期:两套权重、draft KV 和 provisional tree 未计入;
- 固定 seed 不可重放:不同接受路径消费 RNG 的次数不一致;
- 模型升级后输出异常:draft head 与 target 权重版本不兼容。
何时不用
- target 已被大 continuous batch 充分利用;
- 输出很短,初始化和 draft 固定成本占主导;
- draft 接受率低或任务分布剧烈变化;
- tokenizer、vocab、grammar 或 logit processors 不兼容;
- 显存无法容纳额外 draft 权重和 provisional KV;
- 严格重放要求尚未定义 RNG 与状态事务;
- 近似方法无法通过质量和安全回归。
验证
精确算法先在小词表上枚举完整序列,比较 speculative 与普通 target sampling 的经验分布;再覆盖:
- 第一个 token 拒绝、全部接受和中间拒绝;
- \(q(x)=0\)、\(p(x)=0\) 与极端概率;
- temperature、top-\(k\)、top-\(p\) 和 repetition penalty;
- grammar、EOS、跨 token stop 与最大长度;
- 固定 seed、取消、抢占和 OOM 回滚;
- paged KV 的 block 边界和 tree COW;
- mixed batch、不同 \(\gamma\) 与 graph fallback;
- 模型 / draft 版本切换。
性能矩阵至少包含 task、温度、prompt / output 长度、batch、接受长度分布、draft / verify 时间、TTFT、TPOT、goodput、显存与功耗。TensorRT-LLM 的 speculative decoding 文档可用于核对一种生产实现的模式与约束,但最终结论必须以目标版本和本地工作负载为准。
候选接受、状态回滚与分页 KV 边界的紧凑 reference 见手撕:推理引擎。
Shared MTP 与 GLM-5.2 的共享链
GLM-5 训练一个参数共享的 Multi-Token Prediction module,并把同一模块递归用于三个未来位置;报告在内部 prompt 集、四步 speculative setting 下给出平均接受长度 2.76,对照 DeepSeek-V3.2 的 2.55。这个指标依赖 prompt、采样、验证与实现,不能当成通用加速比。
GLM-5.2 把草稿深度扩到七步,并加入两种跨步共享:
- IndexShare:MTP draft steps 复用主干 DSA index;
- KVShare:后续 draft step 复用前一步 KV;
- 用 rejection sampling 与端到端 total-variation loss 缩小整条 proposal chain 的分布偏差。
官方发布说明报告平均接受长度从 4.56 提升到 5.47。这里的核心演进是:MTP 不再只是多加几个预测头,而是把 proposal 的 attention state、KV state 和序列级分布一起训练。逐步机制见 GLM-5 架构与 IndexCache。
Reference
- Fast Inference from Transformers via Speculative Decoding
- 并行 speculative sampling
- Medusa
- EAGLE
- EAGLE-2
- EAGLE-3(2025)
- SafeAILab/EAGLE
- LK Losses
- DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation
- DeepSpec official training and evaluation repository
- ReplaySSM
- TensorRT-LLM 的 speculative decoding 文档
- Kimi K3 Technical Report
- GLM-5: from Vibe Coding to Agentic Engineering
- GLM-5.2 发布说明