Autoencoder 与视觉 Tokenizer:生成模型的表示地基
生成模型很少真正“从文本直接生成像素”。中间通常隔着一层表示:
Encoder \(E\) 决定保留什么,prior 学习什么,decoder \(D\) 决定哪些错误会被放大。这个分层带来数量级的计算节省,也制造了一条无法被后续模型跨越的 reconstruction ceiling。若 tokenizer 已经抹掉小字、物体数量或人物身份,再大的 Transformer 也只能在丢失后的空间里生成。
因此,autoencoder 不是“训练好后可以忘掉的压缩器”,而是生成系统的概率接口与版本边界。

连续潜变量:VAE 把压缩写成概率模型
VAE 假设
并用 encoder 近似不可解的后验:
重参数化
把随机采样改写为对参数可微的确定函数。训练最大化 evidence lower bound:
第一项要求可重建,第二项要求每个样本的 posterior 不要离共同 prior 太远。二者的冲突形成 rate–distortion 取舍:
Rate 太小,decoder 忽略 \(z\),出现 posterior collapse;rate 太大,latent 容易重建,却形成难以采样的孔洞。对图像使用简单 Gaussian pixel likelihood 又会把多种可能细节平均,产生视觉上的模糊。后续工作由此走向两条分支:改善感知 loss,或把 latent 变成离散 code。
离散化:VQ-VAE 学一个可复用的视觉词表
VQ-VAE 令 encoder 在每个空间位置输出 \(z_e\in\mathbb R^d\),再从码本
中选择最近邻:
离散 argmin 没有普通梯度,因此前向使用 \(z_q\),反向把 decoder 梯度按恒等映射送给 encoder:
典型 loss 为
第二项移动 codebook,第三项要求 encoder 对所选 code 作出 commitment。两个 stop-gradient 方向不能互换:否则 codebook 和 encoder 会通过错误路径互相追逐。
离散 code 让 prior 变成标准分类问题,但“一个 code 是一个视觉词”只是一种方便比喻。码本可能编码纹理、颜色或局部轮廓,也可能把相似语义拆散;其含义由重建目标、感受野和数据共同决定。
层级码本与 residual quantization
VQ-VAE-2 用多尺度 latent:上层描述全局结构,下层补局部细节。另一种做法是 residual vector quantization(RVQ)。第 \(m\) 层量化上一层残差:
最终近似为
若每层有 \(K_m\) 个 code,位置数为 \(N\),离散率约为
这使系统可以通过截断后几层降低 bitrate;SoundStream 与 EnCodec 把这一思想用于音频 codec。图像和音频共享同一个数学骨架,但时间序列的码率单位通常是 bit/s,图像则更常报告 bit/pixel 或 token/image,不能直接比较一个“token 数”。
感知质量为何需要另一种距离
逐像素 \(L_1/L_2\) 把一个像素的平移视为大量独立错误,却未必对应人眼感知。VQGAN 组合:
Perceptual loss 在预训练网络特征中比较结构,patch discriminator 奖励局部真实纹理。结果往往更锐利,也可能“合理地重画”输入中原本的细节。因此要区分:
- fidelity:输出是否忠实于这一张输入;
- perceptual realism:输出是否像自然图像;
- semantic utility:code 是否便于 prior 建模和条件控制。
一个 reconstruction FID 很低的 tokenizer,未必有最低 OCR error;一个视觉上漂亮的重建,也可能改变身份或小物体数量。
Latent diffusion 为什么偏爱连续空间
Latent Diffusion 使用带感知压缩的连续 latent:
再在 \(z\) 上执行 diffusion。空间下采样 \(f\) 倍后,\(H\times W\) 图像变为
U-Net 或 DiT 的 token 数与 attention 成本显著下降。这里的 scale \(s\) 不是装饰:它把 latent 方差调到训练 schedule 预期的范围。若 encoder 输出未乘 scale,而 sampler 假设已缩放,生成会在数值上彻底错位,却不一定触发 shape error。
连续 latent 避免 nearest-neighbor 的量化误差和巨大 softmax,但 prior 不再能用精确 categorical likelihood。离散与连续并没有绝对优劣,核心在于:
- 需要多大压缩;
- 下游 prior 使用怎样的目标;
- 是否需要与文本统一 vocabulary;
- reconstruction ceiling 能否满足任务;
- token/latent 的吞吐与存储协议。
从重建 latent 到语义 latent
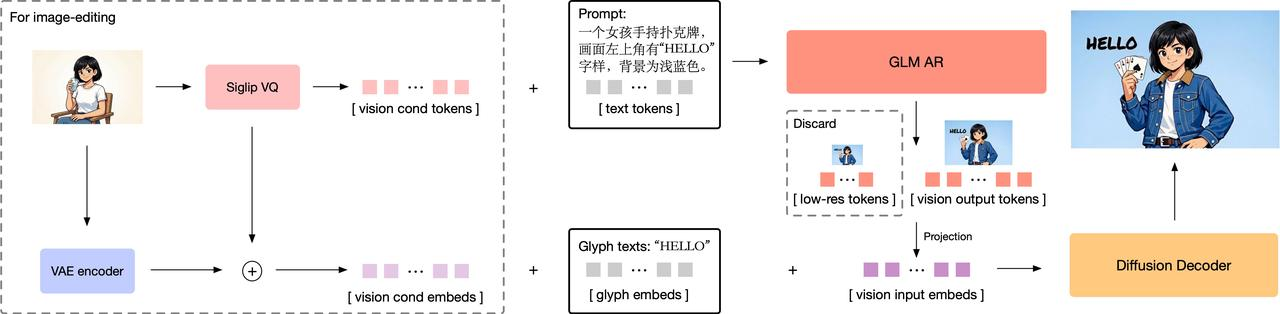
经典 autoencoder 从零学习表示,并以重建为主。Diffusion Transformers with Representation Autoencoders 把预训练视觉 representation encoder 与训练出的 decoder 组合,让 diffusion 在更语义化、通常也更高维的 latent 上工作。这个方向改变了旧假设:
latent 不必尽可能窄;若它已经含有稳定语义,prior 可能更容易学习,只是 backbone 必须能处理更宽的通道和不同统计。
高维 latent 也带来新问题:噪声 schedule 是否仍合适、patch embedding 是否成为瓶颈、decoder 能否恢复纹理、表示模型的数据偏差是否被带入生成。Scaling Diffusion Transformers with Representation Autoencoders 属于快速演进中的后续工作;截至 2026-07-28,涉及其规模与效果的结论应按作者报告理解,并以对应版本、训练配置和公开评测为边界。
离散 tokenizer 同样在尝试更短序列。MAGVIT-v2 研究可服务于视觉生成的 lookup-free quantization,Finite Scalar Quantization 把向量量化改为若干标量级别的笛卡尔积,TiTok 探索把图像压成一维短 token 序列。这些方法减少 prior 的序列长度,但不能只报 token 数:码本容量、decoder 规模与 reconstruction quality 必须一起看。
最小 RVQ:把 shape、梯度与残差写清楚
下面约定输入是 [batch, channel, height, width],码本是 [level, code, channel]。每一级只量化上一层残差;返回值数值上等于码本和,但通过 straight-through 把 decoder 梯度送回 encoder。
import torch
def residual_vector_quantize(z_e, codebooks, beta=.25):
    if z_e.ndim != 4 or codebooks.ndim != 3:
        raise ValueError("expected z_e [B,C,H,W], codebooks [L,K,C]")
    if z_e.size(1) != codebooks.size(2):
        raise ValueError("channel and code dimension must match")
    flat = z_e.permute(0, 2, 3, 1).reshape(-1, z_e.size(1))
    residual, quantized, indices, loss = flat, torch.zeros_like(flat), [], 0.
    for book in codebooks:
        distance = (residual.square().sum(1, keepdim=True)
                    + book.square().sum(1) - 2 * residual @ book.T)
        index = distance.argmin(1)
        q = book[index]
        loss = loss + (q - residual.detach()).square().mean()
        loss = loss + beta * (residual - q.detach()).square().mean()
        quantized = quantized + q
        residual = residual - q.detach()
        indices.append(index)
    z_st = flat + (quantized - flat).detach()
    shape = (z_e.size(0), z_e.size(2), z_e.size(3), z_e.size(1))
    z_st = z_st.reshape(shape).permute(0, 3, 1, 2).contiguous()
    index = torch.stack(indices).reshape(-1, *shape[:-1])
    return z_st, index, loss
z = torch.tensor([[[[.9]], [[.8]]]], requires_grad=True)
books = torch.tensor([[[1., 0.], [0., 1.]],
                      [[0., 0.], [0., 1.]]], requires_grad=True)
z_q, index, loss = residual_vector_quantize(z, books)
assert z_q.shape == z.shape and index.shape == (2, 1, 1, 1)
torch.testing.assert_close(z_q.flatten(), torch.tensor([1., 1.]))
(z_q.sum() + loss).backward()
assert z.grad is not None and books.grad is not None
这段代码故意没有 EMA codebook、distributed usage aggregation、dead-code revival 与 entropy regularization;它给出的是不可再删的语义核心。生产实现若使用 EMA 更新,codebook 通常不再由 optimizer gradient 更新,必须避免同时启用两套更新。
实现契约
| 层 | 必须版本化 |
|---|---|
| 输入 | RGB/BGR、值域、色彩空间、resize/crop、alpha 处理 |
| Encoder | 架构、下采样率、归一化、冻结状态、输出 layout |
| Quantizer | codebook、距离、级数、特殊 code、EMA/gradient 更新 |
| Continuous latent | mean/std 或 scale、channel 顺序、posterior sampling |
| Decoder | 架构、上采样、输出 activation、感知/GAN 训练配置 |
| Prior 接口 | flatten 顺序、patch size、token offset、padding/mask |
还应在 checkpoint 元数据中保存 encoder_id、decoder_id、codebook_hash、latent_scale 与输入预处理。仅保存 prior 权重不足以复现系统。
失效模式与诊断
Posterior collapse
若 decoder 足够强,\(q_\phi(z\mid x)\) 会贴近 prior,latent 不携带信息。检查 per-dimension KL、重建对 latent permutation 的敏感度,而不只看总 ELBO。
Dead code 与 codebook collapse
部分 code 从不被选择,或少数 code 垄断所有位置。应报告:
并按数据域、空间位置与 RVQ level 切片。高 perplexity 也不必然好:均匀使用可能来自无意义噪声。
Train–serve latent mismatch
常见静默错误包括遗漏 latent scale、NHWC/NCHW 互换、posterior mean 与 sample 混用、不同 VAE 的 decoder 被错误配对。必须做固定输入的 byte-level latent 或 tolerance-based golden test。
高压缩下的小目标消失
平均 LPIPS 可能掩盖 OCR、脸部与细线结构。应构建带文字、计数、小物体、重复纹理和高频边缘的专门 slice。
评测应该先拆 tokenizer,再看生成
| 层级 | 指标与检查 |
|---|---|
| Pixel fidelity | PSNR、SSIM、色差、边缘误差 |
| Perceptual fidelity | LPIPS、reconstruction FID、人工 A/B |
| Semantic fidelity | OCR、identity、object count、属性保持 |
| Discrete health | usage、perplexity、dead-code rate、RVQ 各层贡献 |
| Rate | token/image、bit/pixel、latent bytes、压缩率 |
| Prior utility | 固定 prior 预算下的生成质量与条件遵循 |
| System | encode/decode 延迟、峰值显存、吞吐、batch scaling |
比较 tokenizer 时应让 decoder 规模、输入分辨率和训练数据透明。若一个方案用更大的 decoder“补画”细节,另一个追求逐像素保真,单一 reconstruction FID 并不构成公平结论。
离散 prior 的历史与顺序见似然、对抗学习与视觉 Token;连续 latent 上的 diffusion 见 Latent Diffusion、DiT 与 Flow;音频 codec 的时间码率与流式协议见音频生成与流式合成。
VQ、RVQ、重建与码本退化测试见多模态手撕实现。
Reference
- Kingma and Welling, Auto-Encoding Variational Bayes
- van den Oord et al., Neural Discrete Representation Learning
- Razavi et al., Generating Diverse High-Fidelity Images with VQ-VAE-2
- Esser et al., Taming Transformers for High-Resolution Image Synthesis
- Rombach et al., High-Resolution Image Synthesis with Latent Diffusion Models
- Zeghidour et al., SoundStream: An End-to-End Neural Audio Codec
- Défossez et al., High Fidelity Neural Audio Compression
- Mentzer et al., Finite Scalar Quantization: VQ-VAE Made Simple
- Yu et al., Language Model Beats Diffusion — Tokenizer is Key to Visual Generation
- Yu et al., An Image is Worth 32 Tokens for Reconstruction and Generation
- Zheng et al., Diffusion Transformers with Representation Autoencoders
- Zheng et al., Scaling Diffusion Transformers with Representation Autoencoders