具身智能与动作
具身模型把视觉、语言、本体感知和历史状态映射到动作。它与静态 VQA 的根本差异是:输出会改变后续输入,错误通过环境闭环累积。
\(g\) 是语言目标,\(s_t\) 是真实环境状态,\(o_t\) 是不完整观测。
从 VLM 到 VLA
Vision-Language-Action(VLA)模型通常组合:
- 图像/视频 encoder;
- 语言目标与任务历史;
- 共享 Transformer 或融合层;
- 离散或连续动作 head;
- 控制器与安全约束。
PaLM-E 把连续传感器表示注入语言模型,RT-2 把机器人动作表示为可由视觉语言模型预测的 token。它们展示了把互联网语义知识迁移到动作模型的路线,不意味着语言能力会自动转化为精确控制。
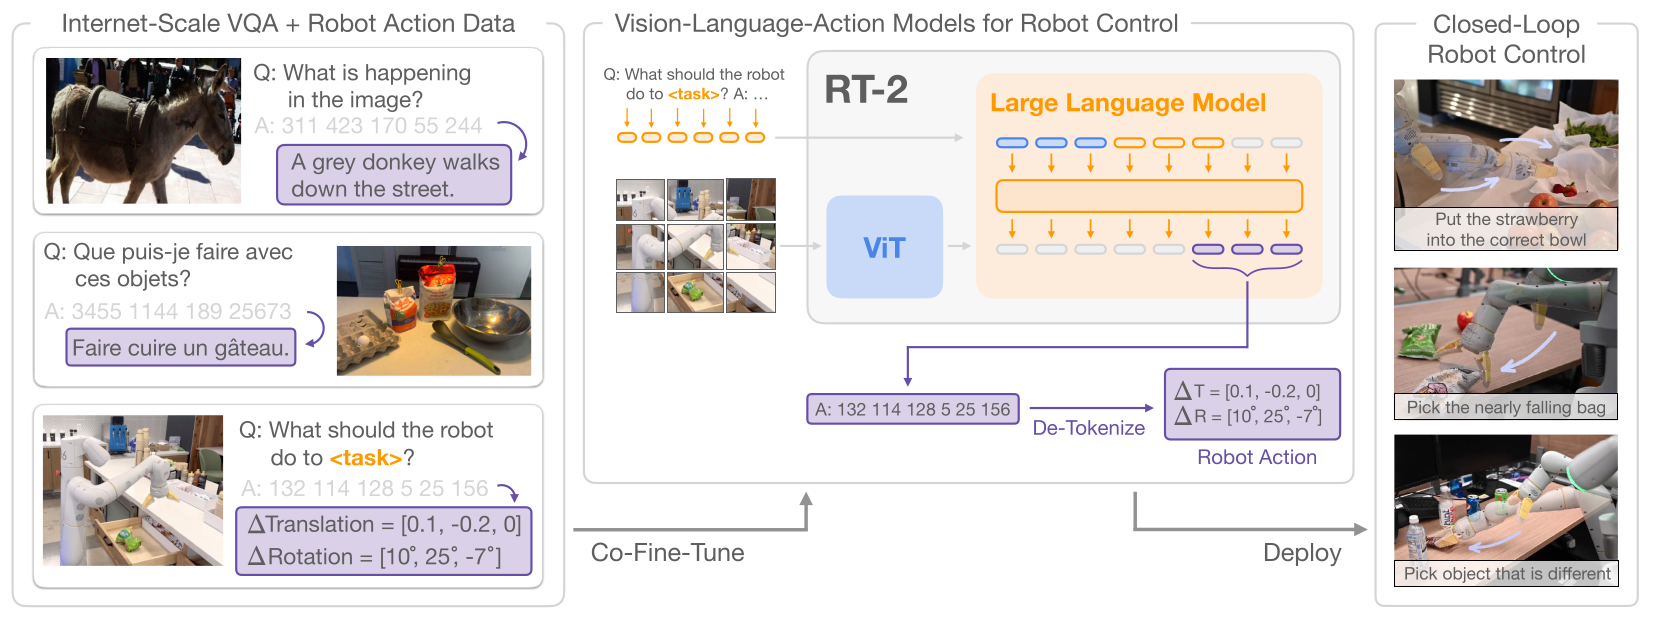
动作表示
离散动作
连续动作 \(a\in\mathbb R^d\) 可按每维量化:
模型预测动作 token:
离散化可复用语言 softmax 和 autoregressive training,但带来量化误差,并可能产生超出动力学约束的组合。
连续动作
模型直接预测高斯、混合分布或 diffusion policy:
连续 head 保留精度,但训练、采样和多峰动作分布更复杂。单点 MSE 容易平均多个可行动作,产生不可执行的中间值。
Action chunking
一次输出未来 \(H\) 步:
Chunking 降低模型调用频率并提高动作平滑度,但环境变化时旧计划会过期。应定义 receding horizon:执行前若干步后重新观察与规划。
状态与时间
单帧无法判断速度、接触和隐藏状态。输入通常需要:
- 多帧视觉或 video token;
- 关节、末端执行器和触觉状态;
- 前序动作;
- 任务进度与对象 memory;
- 相机标定和坐标系。
时间戳和控制周期是模型接口。训练数据 10 Hz、部署 30 Hz 时,若不重采样或显式提供 \(\Delta t\),同一动作 token 会具有不同物理意义。
坐标系
动作可能定义在:
- world frame;
- robot base frame;
- end-effector frame;
- camera frame;
- object-relative frame。
齐次变换:
视觉 bbox、深度点、机器人姿态和动作必须转换到明确坐标系。坐标约定错误常表现为“方向大致正确但总有固定偏移”,不能靠更多语言推理修复。
训练数据
动作数据来源包括 teleoperation、示教轨迹、仿真、自动执行和视频。需要记录:
- 观测与动作时间对齐;
- 控制频率和动作执行语义;
- 成功、失败、中止和恢复;
- 语言目标如何生成;
- 机器人形态、相机和环境;
- 数据是否包含安全干预后的偏差。
只训练成功轨迹会让模型缺少失败识别和恢复行为;但失败数据也必须标注失败原因与可恢复状态。
闭环控制
开放环评测只比较离线动作预测:
该误差不一定与任务成功相关,因为多个动作可能等价,微小误差也可能在接触任务中造成失败。闭环评测应执行:
并测成功率、恢复率、碰撞、干预和完成时间。
安全层
模型输出不应直接绕过控制约束。典型安全层包括:
- workspace、速度、力和关节限制;
- 碰撞检测与紧急停止;
- 高风险动作确认;
- 低层稳定控制器;
- 观测失效和通信超时的 fail-safe;
- 指令权限与环境文本隔离。
视觉中的文字、二维码或屏幕内容属于环境观测,不应自动提升为控制指令。
Shape 与实现契约
动作序列可写为
或离散 token:
实现需要固定:
- 每个动作维的单位、范围和坐标系;
- absolute、delta 还是 velocity control;
- action timestamp 与 observation timestamp;
- chunk 中各步的执行间隔;
- gripper 等离散维怎样编码;
- padding、无操作和终止 token;
- 新观测到达时旧 chunk 如何取消;
- 安全过滤前后动作如何记录和评测。
失效模式
- Covariate shift:小错误把系统带到训练未覆盖状态。
- 动作平均:MSE 在多峰策略间输出不可行动作。
- 时间错位:观测对应的是未来或过去动作。
- 坐标错误:camera/base/world frame 混用。
- 开放环幻觉:离线预测接近,但闭环持续失败。
- 计划过期:action chunk 不随环境变化重算。
- 语义压过几何:识别对象正确,抓取位姿错误。
- 危险泛化:语言指令被执行到未授权对象或区域。
- 仿真迁移:纹理、动力学和传感器噪声差异导致失效。
验证矩阵
| 层级 | 测试 |
|---|---|
| 数据 | 时间同步、坐标、单位、控制频率 |
| 动作 | 量化往返、范围、平滑与多峰覆盖 |
| 几何 | 标定、坐标变换、深度和遮挡 |
| 开放环 | action error、离散准确率、校准 |
| 闭环 | 成功率、恢复、完成时间、重试 |
| 扰动 | 物体移动、遮挡、延迟、相机变化 |
| 安全 | 碰撞、越界、急停、权限和环境注入 |
| 泛化 | 新对象、任务、环境与机器人形态 |
视频状态预测见视频与世界模型,GUI 动作的坐标与状态问题见文档、图表、GUI 与 Grounding,多模态输入接口见融合、位置与训练。
继续深入
本页保留从 VLM 到动作的稳定概览。完整控制栈见具身智能总览,动作 token、chunk、diffusion/flow policy 见状态、动作与策略,数据与 VLA 谱系见 VLA、数据与跨本体学习,真实运行和物理边界见规划、闭环评测与安全。