空间、时间、位置与 Mask
Transformer 最终看到的是一列向量,但图像不是一维句子,音频的 frame index 不是墙钟时间,视频中的下一帧也不等于生成序列中的下一个 token。把媒体 flatten 成序列只解决了存储布局;模型仍需要知道每个 token 在哪里、属于谁、何时发生、允许看见什么。
这四个问题分别对应:
位置表示负责给出结构,attention mask 负责定义信息流,loss mask 负责定义监督。三者混用时,模型可能在训练中读取未来、在 padding 上更新状态,或把两个媒体对象错误地接成一张连续画布。
一维序列只是容器
Transformer 必须显式加入位置,因为 self-attention 本身对 token 排列是置换等变的。文本通常有自然顺序:
媒体则常有多维坐标:
flatten 后,图像一行末尾与下一行开头在序列中相邻,但在二维空间中并非最近邻;两张图若直接拼接,第一张图末尾也不应与第二张图开头共享连续几何。至少要区分:
- 序列位置:token 在打包序列中的 offset;
- 媒体内坐标:patch、frame、频带或区域的位置;
- segment 身份:属于哪张图、哪段音频、哪个 clip 或哪轮交互;
- 真实时间:原始信号中的 timestamp;
- 生成时间:模型按什么顺序预测输出。
这几个计数器可以相关,但不能默认相等。
从绝对位置到旋转位置
绝对位置 embedding 将坐标映射为向量并加到 token 上。固定表简单,却受最大长度和分辨率限制;插值可以适配新网格,但会改变训练时的频率与尺度。
RoFormer 提出 RoPE:将 query、key 的通道成对旋转,使注意力内积包含相对位移。对一维位置 \(p\):
图像可把通道分给 \((r,c)\) 两个轴,视频再加入 \(t\):
实现必须固定每个轴占用的通道、频率、坐标起点和文本 token 的坐标推进方式。名称都叫“2D/3D RoPE”,通道切分和时间缩放不同仍然是不兼容的 checkpoint 接口。
Qwen2-VL 用 M-RoPE 将视觉的时间、高度和宽度位置分解到不同维度;Qwen2.5-Omni 进一步用时间对齐的多模态位置处理交错音视频。它们说明一个共同原则:跨模态同步应映射到共同物理时间,而不是强迫不同采样率共享 token index。
动态分辨率需要坐标契约
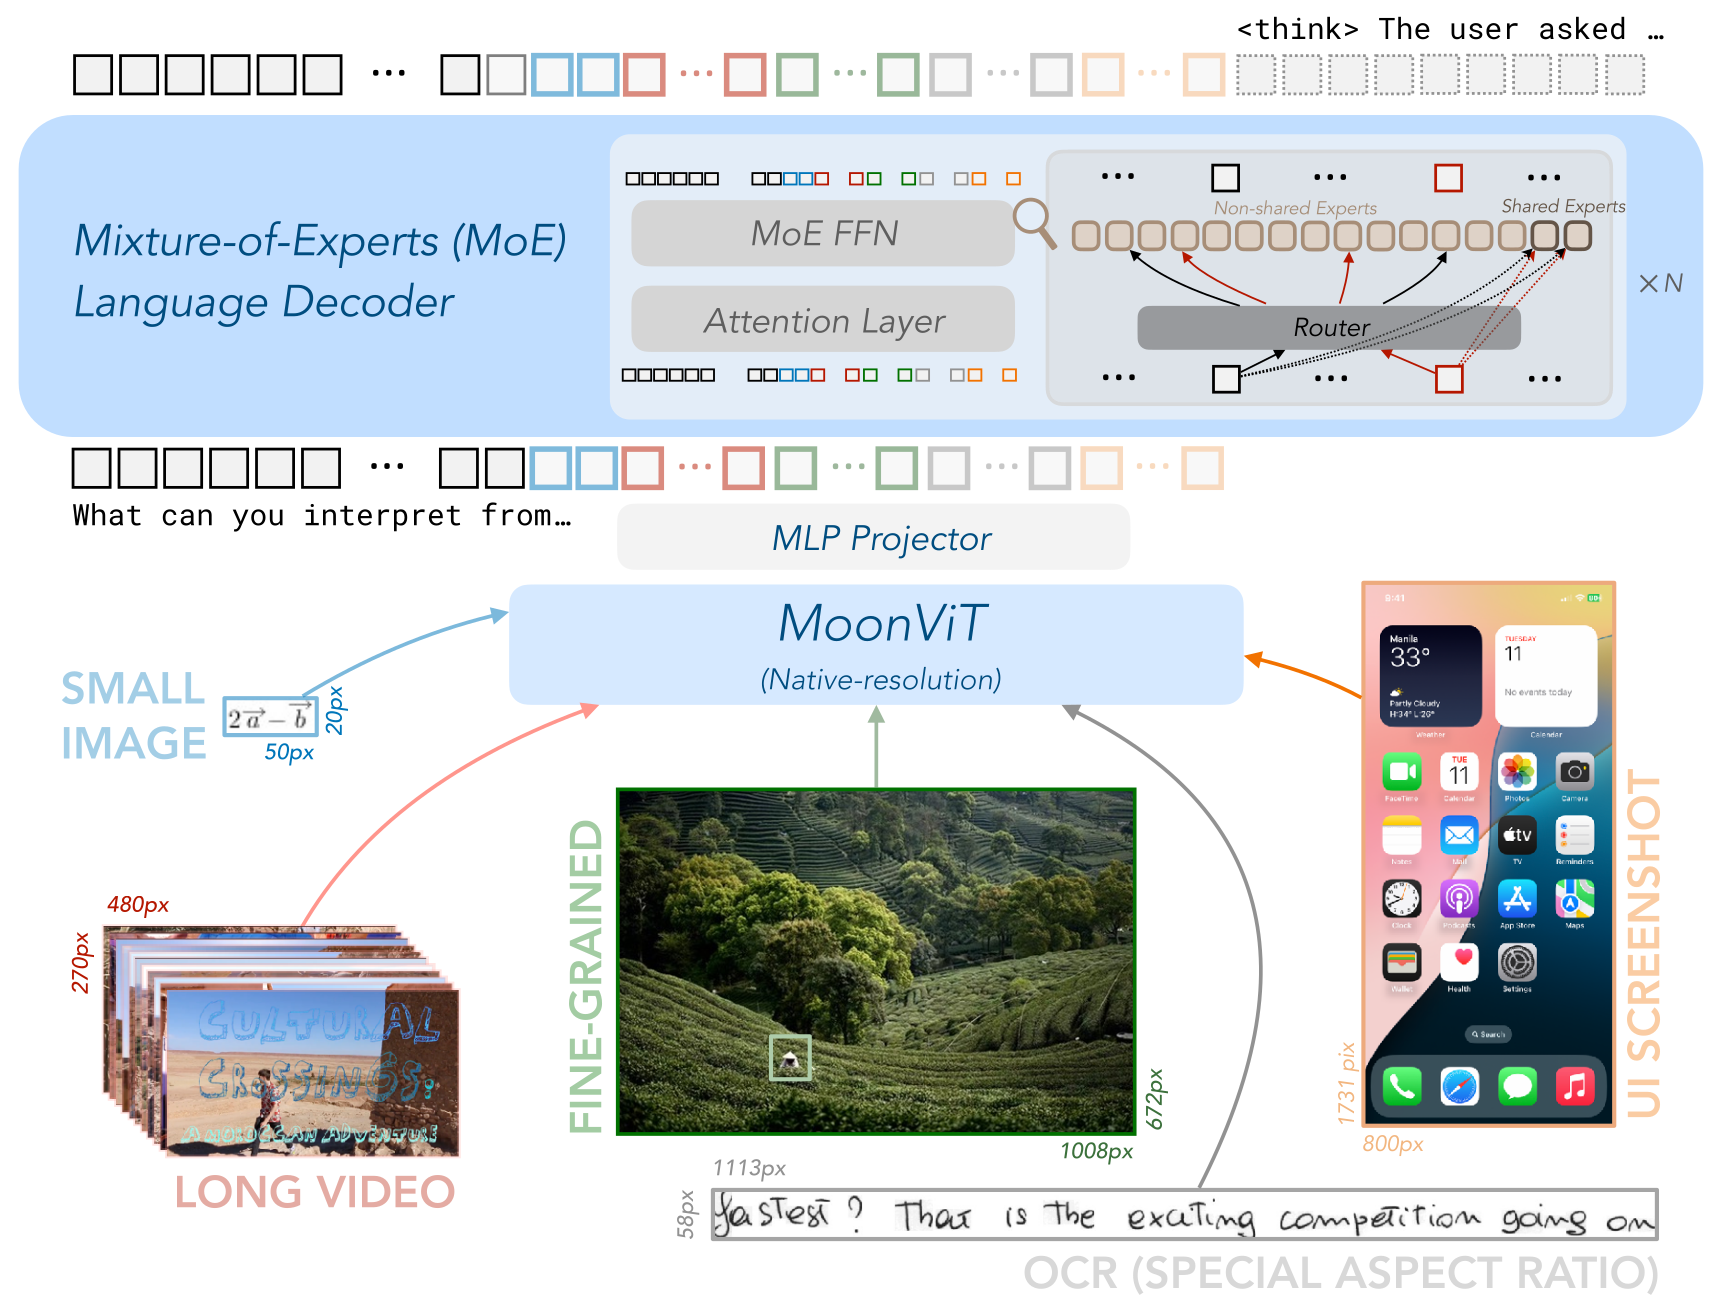
Vision Transformer 在固定 patch 网格上建立了基本视觉序列;NaViT 则展示了可变分辨率图像的 sequence packing。动态输入必须保留:
original width and height
resize scale
padding
crop or tile origin
patch row and column
image or view identity
valid region
若先缩放 \((s_x,s_y)\)、再裁剪 offset \((o_x,o_y)\):
模型输出必须沿逆变换回到原图。位置 embedding 只帮助模型理解 token 关系,不能替代几何变换记录。
多图还应明确坐标是否重置。每张图的局部 \((0,0)\) 可以相同,但 segment ID 必须不同;若任务包含拼图、跨视角或页面顺序,还需要额外的全局关系,而不是把所有坐标简单累加。
时间位置必须回到真实时钟
对固定帧率视频,frame index \(k\) 可近似映射为
但真实媒体可能有可变帧率、剪辑、丢帧或重采样。音频 encoder 也有 window、hop、subsampling 和 lookahead。应把第 \(i\) 个 token 对应的原始区间记录为
而不只记录一个整数位置。字幕、声音事件和视频动作可按区间相交对齐;流式系统还要把算法 lookahead 加入“模型何时有资格输出”的定义。
VideoMAE 使用时空 tube masking 学习视频表示;mask 覆盖哪些 tube、target encoder 能看到什么,本身就是训练任务定义。把这种预训练 mask 与部署时的时间因果 mask 混为一谈,会把“恢复被遮挡内容”和“预测尚未发生的未来”误写成同一个问题。
假设音频每 20 ms 一个 token,视频每 40 ms 一帧。若二者都从 0 开始编号,position=10 分别表示 200 ms 与 400 ms。直接按 index 对齐会产生稳定但错误的音画偏移。
四种 Mask 不能合成一个布尔量
多模态训练至少需要区分:
| Mask | 决定什么 | 错误后果 |
|---|---|---|
| padding mask | token 是否真实存在 | padding 进入 attention、norm 或状态 |
| attention mask | query 能读取哪些 key | 未来泄漏或不必要的信息隔离 |
| loss mask | 哪些位置接受监督 | prompt、padding 或条件被当作 target |
| state/update mask | 递推状态、cache、codebook 是否更新 | 跨样本污染与流式漂移 |
loss mask 为零不代表该 token 不可见;图像 context 通常不承担文本 loss,却必须被答案 token 读取。反过来,target token 即使参与 loss,也不能在预测自己时读取未来真值。
任务决定可见性
理解任务
媒体 encoder 内部可以双向读取整张图或完整离线 clip;答案 target 通常读取完整媒体与已经进入模型的 target 前缀:
这里采用标准 shifted next-token 约定:位置 \(i\) 的输入 token 用来预测位置 \(i+1\),所以 attention 对角线可以可见。若张量在同一位置直接放置待预测真值,条件必须改为严格的 \(<i\)。
自回归统一生成
离散文本和媒体 token 若共同 next-token prediction,通常遵守生成顺序。图像扫描顺序是概率分解的一部分,不应由文件 layout 偶然决定。
Diffusion 或 masked generation
被加噪媒体块常允许块内双向交互,时间 \(t\) 表示 noise level 而不是 token index。Transfusion 在共享序列中分别处理文本 next-token 与连续图像 diffusion;一个 triangular mask 无法同时表达两种目标。
流式音视频
chunk 内可允许有限 lookahead:
其中 \(\ell\) 是显式未来窗口。训练若使用无限未来、部署却设 \(\ell=0\),就是任务协议变化。
世界模型与动作
声称预测未来状态时,任何 encoder、normalization、resampler 或 memory 都不能从 \(t'>t\) 读取信息。动作发生在观测前还是后,也必须进入时间索引约定。
一个可手算的 block mask
下面的 reference 把 batch flatten 后的三个条件分开:只允许同一样本交互;context 之间双向可见;target 可以读取全部 context,以及不晚于自身输入位置加 lookahead 的 target。矩阵按 [query,key] 排列,并采用上面的 shifted next-token 约定。
import torch

def block_visibility(sample, phase, time, valid, lookahead=0):
    sample, phase, time, valid = map(torch.as_tensor, (sample, phase, time, valid))
    if not (sample.ndim == phase.ndim == time.ndim == valid.ndim == 1):
        raise ValueError("metadata must be one-dimensional")
    if not (len(sample) == len(phase) == len(time) == len(valid)):
        raise ValueError("metadata lengths must match")
    if not torch.all((phase == 0) | (phase == 1)):
        raise ValueError("phase must be 0=context or 1=target")
    same_sample = sample[:, None].eq(sample[None, :])
    real = valid[:, None].bool() & valid[None, :].bool()
    query_context = phase[:, None].eq(0)
    query_target = phase[:, None].eq(1)
    key_context = phase[None, :].eq(0)
    key_target = phase[None, :].eq(1)
    target_time_ok = time[None, :] <= time[:, None] + lookahead
    flow = ((query_context & key_context)
            | (query_target & key_context)
            | (query_target & key_target & target_time_ok))
    return same_sample & real & flow

sample = torch.tensor([0, 0, 0, 0, 1, 1])
phase = torch.tensor([0, 0, 1, 1, 0, 1])
time = torch.tensor([0, 1, 0, 1, 0, 0])
valid = torch.tensor([1, 1, 1, 1, 1, 0], dtype=torch.bool)
allowed = block_visibility(sample, phase, time, valid)
assert allowed[0].tolist() == [True, True, False, False, False, False]
assert allowed[2].tolist() == [True, True, True, False, False, False]
assert not allowed[:, 5].any() and not allowed[5].any()
这是小序列真值,不应在长序列上物化 \(N\times N\) 矩阵。生产 kernel 应把 sample、phase、time、block 和 valid metadata 编译成等价的稀疏或分块 mask,并用这个 reference 做逐元素对照。
Segment、边界与打包
把多个样本、图片或 clip 放入同一长序列时,必须明确哪些边界阻断 attention:
batch sample
conversation
document
image / video / audio object
generation target
streaming chunk
episode
这些边界不是同一种 segment。两张图可以属于同一问答样本并允许跨图 attention,却拥有各自局部坐标;两个训练样本即使相邻打包也绝不能互相读取;同一 episode 的两个 chunk 可能共享 cache,但 reset 后必须清空状态。
Flamingo 处理交错图文时需要追踪文字位置可读取哪一组视觉条件;Chameleon 的统一离散序列则把媒体边界写进 token 序列。两种设计都证明 special token 只是边界表示的一部分,仍需实际 attention 规则与 processor 保持一致。
实现契约
- 坐标单位、轴顺序、起点和端点约定固定;
- sequence position 与 media-local coordinate 分开保存;
- image、view、clip、speaker、episode 与 batch sample ID 不混用;
- timestamp 来源、单位、重采样和可变帧率策略明确;
- padding、attention、loss 与 state-update mask 分开构造;
- mask 明确采用
[query,key]还是[key,query]; - bool mask 与 additive mask 的
True/-inf语义明确; - 训练 reference 与 FlashAttention、block-sparse kernel 逐元素等价;
- cache key 包含 processor、位置、segment 与 mask 版本;
- crop、tile、scroll 与坐标返回链可逆;
- 流式 lookahead、chunk overlap、reset 与 flush 行为固定;
- 截断不能留下半个媒体对象或失配的边界 token。
失效模式
- Flatten 邻接幻觉:行尾、跨图或跨 clip token 被当作几何邻居。
- 坐标漂移:resize/crop 后仍输出原尺度或错误 viewport 坐标。
- 时钟漂移:sample、frame、codec 与播放时间被当作同一索引。
- 未来泄漏:双向 encoder、normalization 或 resampler 暗中读取未来。
- Padding 污染:无效 token 更新 attention、递推状态或 quantizer。
- Segment 穿透:packed sample 之间可以互相读取。
- 位置冲突:多图重置坐标却没有对象身份,或全局累加导致外推失稳。
- Mask 转义错误:布尔语义在框架或 kernel 转换时反转。
- 训练—服务错配:训练看完整媒体,服务使用 chunked causal 路径。
- Cache 错位:复用 KV 时忽略媒体变换、segment 或位置 offset。
验证矩阵
| 层级 | 必须通过的检查 |
|---|---|
| 坐标 | resize、padding、crop、tile、scroll 的手算往返 |
| 图片 | 改变宽高比、tile 顺序、多图顺序与局部坐标 |
| 音频 | 不同 sample rate、hop、chunk、lookahead 与时钟漂移 |
| 视频 | 可变帧率、短事件、镜头切换、音画同步 |
| Mask | 小矩阵逐元素真值、未来 token 注入探针、跨样本隔离 |
| Padding | 极端 padding 值不影响可见输出,也不更新状态 |
| Kernel | dense reference 与生产 kernel 随机等价测试 |
| 流式 | 整段离线与 chunked 路径在承诺边界内等价 |
| 外推 | 新分辨率、长时间与多媒体数量下的位置稳定性 |
| 系统 | position/mask metadata 的内存、构造时间和 cache 命中 |
输入怎样形成 token 见表示、采样与 Tokenization,媒体怎样进入共享主干见对齐、桥接与融合,动态打包与训练协议见多模态数据、训练与系统。
位置、segment 与 attention mask 的组合边界测试见多模态手撕实现。
Reference
- Vaswani et al., Attention Is All You Need
- Dosovitskiy et al., An Image is Worth 16x16 Words
- Su et al., RoFormer: Enhanced Transformer with Rotary Position Embedding
- Dehghani et al., Patch n' Pack: NaViT, a Vision Transformer for any Aspect Ratio and Resolution
- Alayrac et al., Flamingo: a Visual Language Model for Few-Shot Learning
- Bai et al., Qwen2-VL: Enhancing Vision-Language Model's Perception of the World at Any Resolution
- Xu et al., Qwen2.5-Omni Technical Report
- Team Chameleon, Chameleon: Mixed-Modal Early-Fusion Foundation Models
- Zhou et al., Transfusion: Predict the Next Token and Diffuse Images with One Multi-Modal Model
- Tong et al., VideoMAE: Masked Autoencoders are Data-Efficient Learners for Self-Supervised Video Pre-Training