多模态融合、位置与训练
多模态架构首先要解决 shape 对齐:感知 encoder 输出的 token 数和维度通常与语言主干不同。设
\(P_m\) 同时决定信息瓶颈、token budget 和 checkpoint 兼容性。
Projector
最简单的接口是线性层:
MLP projector 可以增加非线性:
LLaVA 展示了预训练视觉 encoder、projector 与语言模型对齐的一条简洁路线。Projector 不减少 \(N_m\);高分辨率输入的成本会原样传给 LLM。
Querying 与 resampling
固定 \(N_q\) 个可学习 query:
无论原始 token 数 \(N_m\) 多大,语言主干只接收 \(N_q\) 个结果。BLIP-2 的 Q-Former 和 Perceiver IO 的 latent querying 提供了代表性设计。
固定压缩率有明确风险:全局语义可能保留,小文字、密集目标和稀有区域更容易被丢弃。应测性能随 \(N_q\) 的曲线,而不是只报告一个配置。
Fixed-query resampler
QueryResampler 接收可变长视觉序列 [B,N,D] 与 padding mask,始终返回 [B,N_q,D]。测试把被 mask 的最后一个 token 改成极端值,输出保持不变,从而同时检查固定 query 数与 padding 语义。
import torch
import torch.nn as nn

class QueryResampler(nn.Module):
    def __init__(self, width, query_count, heads):
        super().__init__()
        self.query = nn.Parameter(torch.randn(query_count, width) / width ** .5)
        self.norm_query = nn.LayerNorm(width)
        self.norm_visual = nn.LayerNorm(width)
        self.attention = nn.MultiheadAttention(width, heads, batch_first=True)
    def forward(self, visual, padding_mask=None):
        if padding_mask is not None:
            if padding_mask.shape != visual.shape[:2] or padding_mask.dtype != torch.bool:
                raise ValueError("padding_mask must be bool [batch, visual_tokens]")
            if padding_mask.all(dim=-1).any():
                raise ValueError("every row needs at least one visible visual token")
        query = self.query[None].expand(visual.size(0), -1, -1)
        output, _ = self.attention(
            self.norm_query(query), self.norm_visual(visual), self.norm_visual(visual),
            key_padding_mask=padding_mask, need_weights=False,
        )
        return query + output

torch.manual_seed(0)
resampler = QueryResampler(width=8, query_count=3, heads=2)
visual = torch.randn(2, 5, 8)
padding = torch.tensor([[False] * 4 + [True]] * 2)
output = resampler(visual, padding)
changed = visual.clone()
changed[:, -1] = 1_000
torch.testing.assert_close(resampler(changed, padding), output)
assert output.shape == (2, 3, 8) and torch.isfinite(output).all()
try: resampler(visual, torch.ones(2, 5, dtype=torch.bool))
except ValueError: pass
else: raise AssertionError("fully padded rows must fail before attention")
这是单层 cross-attention bottleneck,不含多层 Q-Former、自注意力、模态位置或图像 tile 元数据;固定 \(N_q\) 也不保证小目标信息仍在。可运行的 query-count 与 padding 实验见多模态原语:Fixed-query resampler。
Cross-attention
在语言层中加入对模态特征的 cross-attention:
Flamingo 使用 gated cross-attention 处理交错图文。Cross-attention 让文本 token 按需读取媒体,但改变主干结构,也增加每层媒体 K/V、checkpoint 转换和服务 runtime 的复杂度。
Projector、Q-Former/Resampler 与深层 cross-attention 的资源约束不能只按参数量排序;Flamingo、BLIP-2 与 LLaVA 深读并排比较了三者的冻结策略、数据目标和注入位置。
Early fusion
另一条路线把媒体 token 投影到共同维度后,与文本一起进入 self-attention:
优点是任意位置可直接交互;代价是所有模态共享序列长度和二次 attention。还必须定义:
- 每种模态的 type embedding;
- causal、bidirectional 或 block mask;
- 多图、多段音频与视频的边界 token;
- position IDs 是否重置;
- 哪些媒体 token 参与语言 loss。
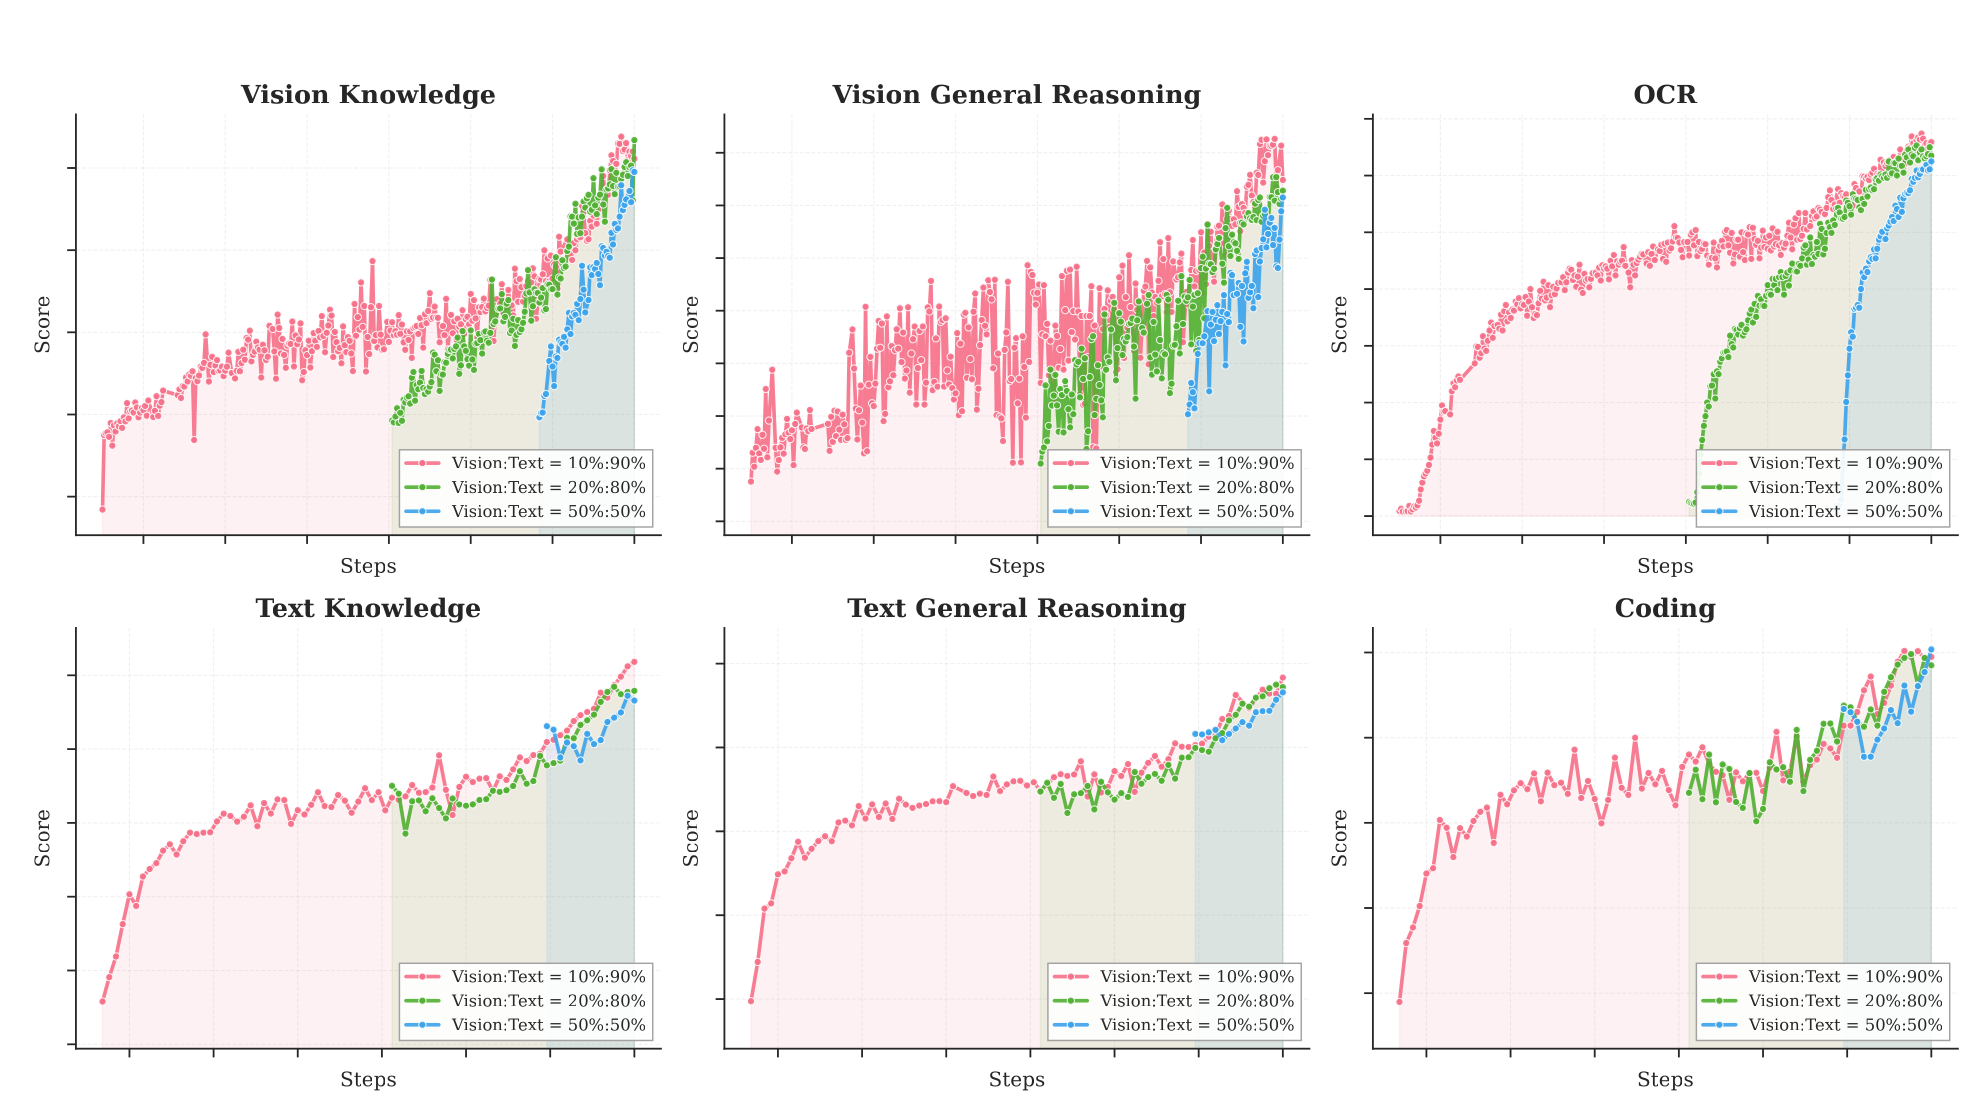
原生联合训练与 MoonViT-V2
“Early fusion”只描述 token 怎样进入主干,不决定视觉塔何时、用什么目标训练。常见 grafting 路线先 得到成熟的语言模型和对比学习视觉 encoder,再训练 projector 或 alignment stage;它启动快、组件 可替换,但 joint training 必须同时协调已经形成的两套表示尺度。
Kimi K3 技术报告公开了另一种 实例:MoonViT-V2 从随机初始化开始,与语言主干从预训练起共同优化,交错图文序列的 next-token loss 直接反传进视觉 encoder,不再增加一次 post-hoc modality alignment。因而“对齐”来自端到端生成目标, 而不是先冻结视觉塔再只训练 projector。
这并不意味着 contrastive pre-training 普遍无用。报告中的受控 ablation 显示,在其联合训练配方下, 从头训练的 MoonViT-V2 相比 SigLIP 初始化的 MoonViT-3D 有更低、更少尖峰的视觉塔 gradient norm, 并在作者给出的视觉评测上达到相近结果;这是一套配方内的经验,迁移到更小数据、冻结主干或纯检索任务 仍需重新比较。Kimi-VL 则提供了早期 MoonViT 路线的公开背景。
MoonViT-V2 的公开结构参数是 27 层、401M 参数、patch size 14、12 个 attention heads,使用 RMSNorm,并移除 linear 与 attention projection 的 bias。图像和视频完全共享 encoder 参数;视频 attention 拆成 frame 内的 spatial pass 与 frame 间的 temporal pass,再以 temporal pooling 压缩 时间轴。这个 factorization 避免直接在 \(T_{\mathrm{frame}}HW\) 个 patch 上做单个三维全注意力,但 空间—时间交互必须经过交替层传播。
视觉 token 经 encoder 后先做 \(2\times2\) pixel grouping,再由轻量 MLP 投影到语言 hidden width:
token 数缩为四分之一,单 token channel 增为四倍;projector 再决定压回 \(d\) 时保留哪些信息。K3 报告的输入上限可到 \(3584\times3584\),但“可输入”不自动等于细字、密集目标和跨 tile 关系都能可靠 利用,仍需按下文分辨率与证据依赖矩阵测量。
2×2 visual token grouping
下面只实现无损的空间重排,不包含后续 MLP。断言同时固定 token 数缩减四倍、channel 扩大四倍且元素 没有被丢弃;生产路径还要携带 padding、tile offset 与原始宽高比。
import torch

def group_visual_tokens_2x2(x):
    assert x.ndim == 4
    batch, height, width, channels = x.shape
    assert height % 2 == 0 and width % 2 == 0
    x = x.reshape(batch, height // 2, 2, width // 2, 2, channels)
    x = x.permute(0, 1, 3, 2, 4, 5)
    return x.reshape(batch, height // 2, width // 2, 4 * channels)

visual = torch.arange(2 * 6 * 8 * 3).reshape(2, 6, 8, 3)
grouped = group_visual_tokens_2x2(visual)
assert grouped.shape == (2, 3, 4, 12)
assert grouped.numel() == visual.numel()
torch.testing.assert_close(grouped.flatten().sort().values, visual.flatten().sort().values)
从头联合训练还要分别记录 vision/LLM learning rate、初始化、loss mask、分辨率分布与 gradient norm; 否则无法判断稳定性来自训练范式、视觉塔结构还是优化器。K3 的 native vision 如何与 NoPE、1M 长度课程和共享主干组合,见 Kimi K3。
对齐目标
CLIP 对归一化图文表示使用批内对比:
对图到文、文到图分别做交叉熵:
CLIP 深读从 batch 内负例、temperature 与 zero-shot classifier 还原这套目标,并区分原论文证据与后续视觉语言生成接口。
SigLIP 改为 pairwise sigmoid loss:
这里按 image batch size \(B\) 归一,因此每个样本引入更多 negatives 时,目标尺度也会改变。全局对比学习建立语义对齐,但不自动提供字符、区域和关系级监督;重复 caption、同类图像和弱文本会形成 false negative 或错误对应。
CLIP 目标的最小实现应先逐样本归一化,再用同一个配对索引计算双向交叉熵。输入是已经全局 gather 的 [batch, dim] 表示;分布式训练若只用本 rank 的 negatives,目标已经发生变化。
import torch
import torch.nn.functional as F
def clip_loss(image_features, text_features, logit_scale):
    if image_features.shape != text_features.shape or image_features.ndim != 2:
        raise ValueError("paired [batch, dim] features required")
    image = F.normalize(image_features, dim=-1)
    text = F.normalize(text_features, dim=-1)
    logits = logit_scale.exp() * image @ text.T
    target = torch.arange(len(logits), device=logits.device)
    loss_i = F.cross_entropy(logits, target)
    loss_t = F.cross_entropy(logits.T, target)
    return (loss_i + loss_t) / 2, logits
image = torch.eye(3, requires_grad=True)
text = torch.eye(3, requires_grad=True)
loss, logits = clip_loss(image, text, torch.tensor(0.))
loss.backward()
assert logits.argmax(-1).tolist() == [0, 1, 2]
torch.testing.assert_close(logits, logits.T)
assert torch.isfinite(image.grad).all() and loss > 0
这段实现不处理重复 caption、多正例或跨设备梯度语义;这些情况需要修改 target,而不能只改 batch loader。logit_scale 在真实模型中常为可学习参数并受范围控制;图文有效样本 mask 也必须在 gather 和 loss 分母中一致。
SigLIP pairwise 目标
siglip_loss 对 batch 内全部图文 pair 独立做二分类:对角 pair 标签为 \(+1\),其余为 \(-1\)。输入是同 shape 的 [B,D] 表示;返回按 image batch size 归一的 loss 与完整 logits。
import torch
import torch.nn.functional as F

def siglip_loss(image_features, text_features, logit_scale, bias=0.):
    assert image_features.shape == text_features.shape and image_features.ndim == 2
    image = F.normalize(image_features.float(), dim=-1)
    text = F.normalize(text_features.float(), dim=-1)
    logits = logit_scale.exp().clamp(max=100) * image @ text.T + bias
    target = torch.eye(logits.size(0), device=logits.device).mul(2).sub(1)
    return F.softplus(-target * logits).sum() / logits.size(0), logits

image = torch.eye(3, requires_grad=True)
text = torch.eye(3)
aligned, logits = siglip_loss(image, text, torch.tensor(2.3))
misaligned, _ = siglip_loss(image, text.roll(1, 0), torch.tensor(2.3))
assert aligned < misaligned and logits.argmax(-1).tolist() == [0, 1, 2]
target = torch.eye(logits.size(0), device=logits.device).mul(2).sub(1)
expected = F.softplus(-target * logits).sum() / logits.size(0)
torch.testing.assert_close(aligned, expected)
aligned.backward()
assert torch.isfinite(image.grad).all()
这仍假设 batch 对角是一一正例;重复 caption、多正例和跨设备 gather 会改变标签矩阵与分母,不能只增大 batch。CLIP/SigLIP 并排实验见多模态原语:CLIP 与 SigLIP。
分辨率与 patch
对图像大小 \(H\times W\)、patch \(P_h\times P_w\):
分辨率翻倍时,patch 数约增长四倍。常见策略包括:
- 固定 resize;
- 保留宽高比并 padding;
- 全局缩略图加局部 tiles;
- 动态分辨率或 dynamic tiling;
- token merge、pooling 或 resampler。
动态切片必须保存 tile 顺序、原图 offset、缩放比例和二维坐标。否则模型虽然获得高清 crop,却无法恢复跨 tile 空间关系。
多维位置
图像 token 使用 \((h,w)\),视频使用 \((t,h,w)\)。若采用多维旋转位置:
Qwen2-VL 提供了 M-RoPE 与动态视觉 token 的公开设计。实现中应固定每个轴的通道切分、文本 token 的坐标推进和多媒体边界。
训练阶段
一种常见但非唯一的顺序是:
- 感知 encoder/tokenizer 单模态预训练;
- 冻结主干,训练 projector/resampler 对齐;
- 解冻部分或全部组件做多模态预训练;
- 指令、grounding、OCR、工具和多轮数据;
- 偏好、安全与生产分布适配。
每阶段需记录:
- 冻结参数与 trainable parameter 数;
- 数据混合、采样权重和分辨率;
- 模态 token、文本 token 与 packing;
- optimizer、学习率和各组件 schedule;
- loss mask 与模态 loss 归一;
- encoder、tokenizer 和 chat template 版本。
Loss 平衡
若文本与媒体 token 数量差异很大,直接按全部 token 平均会让占比高的模态支配梯度。可按模态有效 token 归一:
\(\lambda\) 控制的是容量分配,不只是数值尺度。应监控每个目标的梯度范数、训练曲线和遗忘,而不只监控总 loss。
实现契约
- 每个模态张量的 layout、dtype 和有效长度明确;
- projector 输出与 LLM hidden size、norm 约定一致;
- media placeholder 数量与实际注入 token 完全一致;
- position IDs、attention mask 和 loss mask 独立构造;
- resize、crop、tile 与 grounding 坐标使用同一变换;
- 多图、视频和音频在 batch packing 后仍保持边界;
- frozen module 处于正确的 train/eval 状态;
- checkpoint 保存 encoder、projector、tokenizer 和模板版本。
失效模式
- 模态遗漏:移除媒体后答案几乎不变。
- 语言先验:常见答案模式掩盖感知失败。
- 压缩瓶颈:固定 query 无法保留小目标与文字。
- 占位错位:placeholder 与视觉 token 数不同。
- 坐标漂移:crop 后 bbox 仍使用原图尺度。
- 目标竞争:媒体 loss 增长造成文本能力退化。
- 冻结错误:名义冻结但 BatchNorm/dropout 状态仍变化。
- 模板漂移:训练与服务的媒体边界 token 不一致。
- 权限混淆:图像内文本被当成高权限指令。
验证
| 维度 | 测试 |
|---|---|
| Shape | 多尺寸、多图、空模态、最大 token |
| 对齐 | 正确配对、错配、重复 caption、hard negative |
| 证据依赖 | 遮挡、替换、移除媒体与反事实图像 |
| 空间 | tile 顺序、crop、bbox、二维位置 |
| Loss | 各模态梯度、冻结组件、训练阶段切换 |
| 系统 | token 数、prefill、峰值显存、吞吐 |
| 鲁棒 | 压缩、旋转、噪声、模态缺失、媒体内攻击 |
可执行的 patchify、CLIP/SigLIP loss、resampler、模态 mask 与位置练习见多模态手撕实现。文档和坐标见文档、图表、GUI 与 Grounding,统一生成目标见理解与生成统一。
继续深入
本页保留跨模态架构的稳定总览;更细的 canonical 契约分别位于对齐、桥接与融合、空间、时间、位置与 Mask 和多模态数据、训练与系统。输入压缩与可逆性见信号、表示与 Token 化。