文档、图表、GUI 与 Grounding
文档和界面理解不仅是 OCR。模型必须同时恢复文字、二维布局、对象关系和可操作区域,并把输出可靠地绑定到原始坐标或结构节点。
一条完整路径是:
任何中间层丢失坐标、阅读顺序或页面状态,后续语言推理都无法可靠补回。
三种输入路线
OCR-first
先由 OCR、layout parser 或 DOM 提取
其中 \(t_i\) 是文本,\(b_i\) 是 bbox,\(c_i\) 是置信度,\(\tau_i\) 是元素类型。语言模型读取结构化元素。
优点是可审计、token 成本低、易检索;缺点是上游错误会固化,图形、公式、图标和视觉关系可能丢失。
OCR-free
Donut 直接从文档图像生成结构化序列;Pix2Struct 通过截图解析预训练学习视觉语言结构。这类路线减少外部 OCR 依赖,但仍受视觉分辨率、输出语法和长页面 token 限制。
融合像素与结构
系统同时输入截图与 OCR/DOM,将结构元素作为额外 token 或工具结果。它可以用像素纠正 OCR,也可以用 DOM 提供可点击性;实现必须标记来源和冲突优先级,不能把两种信号无条件拼接。
坐标表示
原图大小为 \(W\times H\),把坐标量化到 \(K\) 个离散值:
反量化:
归一化坐标便于跨分辨率共享词表,但量化误差对小按钮和小字影响更大。Kosmos-2 展示了把文本 span 与位置 token 绑定的 grounded language modeling 路线。
Resize、crop 与坐标链
若原图先按 \((s_x,s_y)\) 缩放,再裁剪 offset \((o_x,o_y)\),原图坐标到模型输入坐标为
模型输出坐标必须沿逆变换映射回原图。动态 tile 还要保存 tile ID、tile 原点、padding 和重叠区域;只记录最终截图尺寸不足以恢复坐标。
最小语义实现
transform_box 实现上式:先把原图 xyxy 坐标按 \(s_x,s_y\) 缩放,再减去 缩放后画布 中的 crop offset;invert_box 执行严格逆变换。输入输出均使用连续像素坐标,量化应放在完整几何链之后。
import torch

def transform_box(box, scale_xy, crop_offset):
    box = torch.as_tensor(box, dtype=torch.float64)
    sx, sy = scale_xy
    ox, oy = crop_offset
    assert sx > 0 and sy > 0
    scale = box.new_tensor([sx, sy, sx, sy])
    offset = box.new_tensor([ox, oy, ox, oy])
    return box * scale - offset

def invert_box(box, scale_xy, crop_offset):
    box = torch.as_tensor(box, dtype=torch.float64)
    sx, sy = scale_xy
    ox, oy = crop_offset
    scale = box.new_tensor([sx, sy, sx, sy])
    offset = box.new_tensor([ox, oy, ox, oy])
    return (box + offset) / scale

original = torch.tensor([10., 20., 30., 50.], dtype=torch.float64)
mapped = transform_box(original, (2., .5), (4., 5.))
torch.testing.assert_close(mapped, torch.tensor([16., 5., 56., 20.]).double())
torch.testing.assert_close(invert_box(mapped, (2., .5), (4., 5.)), original)
真实 preprocessing 还可能加入 letterbox padding、tile 原点、viewport scroll 与坐标裁剪;应把每一步组成可逆变换并保存,而不是只记最终尺寸。离散化误差与 crop-first 变体见多模态原语:坐标离散与几何变换。
Grounding 指标
预测框 \(B_p\) 与真值 \(B_g\) 的 IoU:
对 GUI 点击,点落入 bbox 只是最低要求。还应检查:
- 元素是否可见、启用且未被遮挡;
- 当前 viewport 与滚动位置;
- 多个重叠元素中实际接收事件的节点;
- 点击点是否避开边缘与相邻危险控件;
- 动作后页面状态是否符合预期。
SeeClick 研究了 GUI 视觉 grounding;ScreenAI 及其官方研究页覆盖 UI 与信息图理解。
阅读顺序与结构
二维页面没有唯一线性顺序。简单规则可按栏分组,再按
排序,但多栏、浮动注释、表格、脚注与公式会破坏该假设。更可靠的表示包括:
- block tree 与父子层级;
- 表格 row/column span;
- 标题、段落、图注和脚注类型;
- 元素间“左于、上于、包含、引用”关系图;
- 原始页码与跨页连接。
Nougat 提供了科学文档到标记序列的公开路线,适合讨论公式、表格和阅读顺序,但生成的 markup 仍需语法与内容双重验证。
图表
图表理解至少包含:
- 标题、轴、图例和单位;
- series 与颜色/符号对应;
- 数据点或趋势恢复;
- 比较、插值与异常解释。
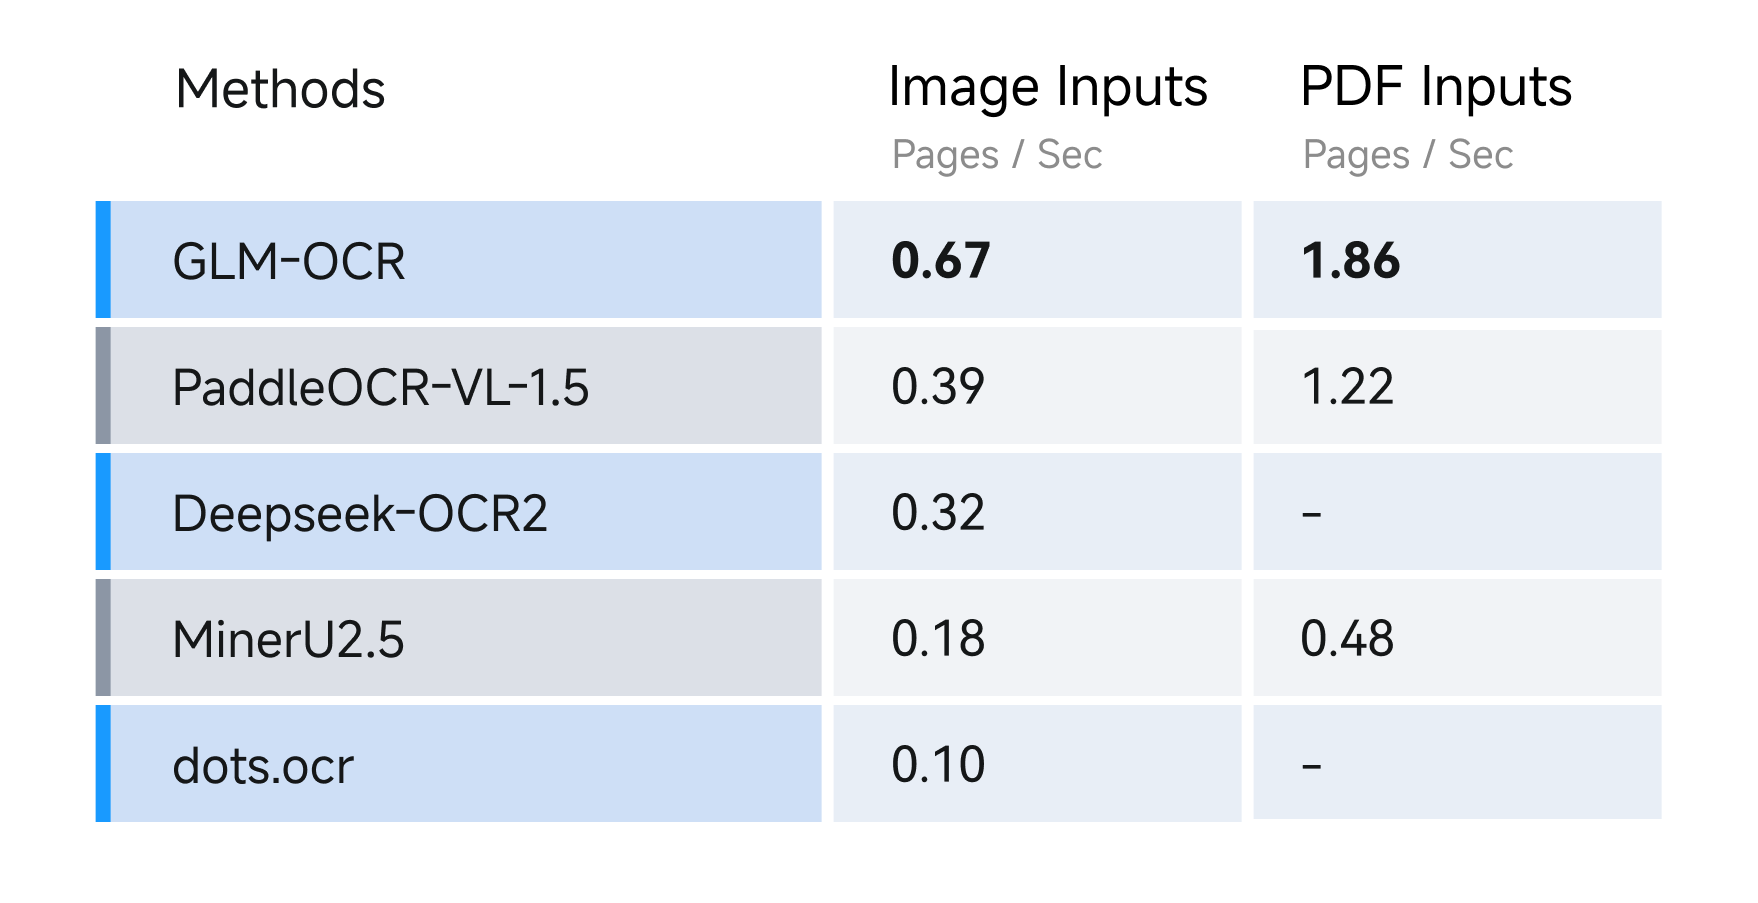
只生成自然语言 caption 会隐藏数值错误。可以要求中间输出结构化表,再用几何或 OCR 规则验证轴范围、单位和数据点。
GUI 状态与动作
截图只描述某一时刻的可见像素。可靠操作还需要:
其中 \(\mathcal E_t\) 是元素/DOM 状态,\(h_t\) 是交互历史。动作后应重新观察,而不是假设点击成功。
高风险操作需要额外确认,且图像、网页和文档内容都应视为不可信输入,不能改变系统权限。
Shape 与实现契约
一个 batch 可包含:
以及变长元素:
实现应固定:
- bbox 是
xyxy、xywh还是多边形; - 坐标属于原图、resize 后图、tile 还是 viewport;
- 端点是否闭区间;
- OCR 文本与 bbox 的一一对应;
- page、frame、window 与 scroll offset;
- padding 元素不参与 attention、loss 和 IoU;
- 输出 schema、非法坐标和越界处理。
失效模式
- 坐标系漂移:crop/resize 后仍用原坐标点击。
- OCR 幻觉:模型补出视觉上不存在的文字。
- 阅读顺序错误:跨栏、图注和脚注被串联。
- 表格结构丢失:合并单元格被展开为错误键值。
- 小目标消失:缩放或 resampler 丢掉图标与小字。
- 视觉可见但不可操作:遮挡、禁用或非交互元素被点击。
- 状态过期:动作前后页面变化,仍使用旧 bbox。
- 内容注入:文档中的文字诱导系统越权。
验证矩阵
| 层级 | 测试 |
|---|---|
| OCR | 字符、词、行、公式和多语言切片 |
| Layout | 多栏、表格、图注、跨页与阅读顺序 |
| 坐标 | resize、crop、tile、scroll 的往返映射 |
| Grounding | IoU、point-in-box、小目标与重叠元素 |
| 图表 | 轴、单位、series、数值恢复与趋势 |
| GUI | 可点击性、动作后观察、取消与回滚 |
| 安全 | 页面内指令、隐藏元素、危险相邻控件 |
| 系统 | 分辨率、视觉 token、延迟与失败重试 |
视觉 token 和动态分辨率见多模态融合、位置与训练,紧凑坐标与 mask 实现见多模态手撕实现。
继续深入
视觉表示、感知与 Grounding 给出从全局语义到区域证据的共同底座;涉及深度、多视角和机器人坐标时继续读空间智能与三维表示。文档、图表和界面执行应保留各自输入协议,不能用同一个 VQA 总分代替。