规模律与实验设计
规模律把模型参数、训练数据和损失之间的经验关系压缩为可外推曲线。它适合规划预算和筛选候选,不是脱离数据、架构与部署负载的自然定律。
问题
给定有限计算,至少有三种不同问题:
- 固定训练计算,参数与 token 怎样分配?
- 固定训练时间或集群,什么配置真正可运行?
- 计入未来查询后,训练更大模型是否仍是最低总成本?
只回答第一问,可能得到训练上近似 compute-optimal、部署上却昂贵的模型。
经验规模律
一种常见拟合形式是
其中 \(N\) 是参数规模,\(D\) 是训练 token,\(L_\infty\)、\(a\)、\(b\)、\(\alpha\)、\(\beta\) 都需要在固定数据分布、tokenizer、架构和训练配方下估计。Scaling Laws for Neural Language Models 建立了早期经验框架,Chinchilla 重新研究固定计算下模型与数据的分配。
两项工作的拟合问题、isoFLOP 证据与后来常见的误读见 Scaling Laws 与 Chinchilla 深读。
若把训练计算近似为
代入 \(D=C/(\kappa N)\) 并对 \(N\) 求极值,可得
这说明最优扩展指数由拟合系数决定,而不是一个永久的 tokens-per-parameter 常数。数据质量、重复度、模型形状或训练目标变化后,需要重新拟合。
\(6ND\) 的边界
对稠密 Transformer,常以
估计参数相关的 forward 与 backward FLOPs。它是数量级工具,隐含:
- 参数在每个 token 上参与稠密计算;
- forward 与 backward 的相对成本近似稳定;
- 不计或粗略吸收 embedding、attention 长度项和输出投影;
- 不计 activation recomputation、padding、稀疏路由和低利用率;
- \(D\) 是真正进入计算的 token,而不是原始语料大小。
以下场景需要单独建模:
- 长上下文中 attention 的 \(S^2\) 项不可忽略;
- MoE 的总参数与每 token 激活参数不同;
- 多模态 encoder、视觉 token 和 cross-attention 改变计算图;
- vocab 很大时输出层占比上升;
- 数据并行 padding、专家不均衡和 pipeline bubble 降低有效利用率;
- 失败重跑、数据处理与 checkpoint 不属于理论 FLOPs。
实际 wall-clock 应写成
并同时报告执行 FLOPs、利用率、重跑和非训练成本。
Inference-aware 总成本
部署查询量为 \(Q\) 时,总预算可写成
其中 \(\mathcal H\) 表示硬件与服务配置。较小但训练更充分的模型,可能以更多训练 token 换取更低的长期推理成本。Beyond Chinchilla-Optimal 研究了把推理需求纳入模型与数据配置的影响。
推理成本不能只按参数量估计:batch、prefill/decode 比例、KV cache、量化、延迟 SLO 和模型并行都会改变每请求成本。若预期查询量未知,应至少画出不同 \(Q\) 下的 break-even 曲线。
实验契约
固定可比变量
代理实验和主实验应显式固定或记录:
data snapshot, mixture and dedup
tokenizer and sequence-length distribution
architecture family and shape ratios
optimizer, parameterization and schedule
effective batch tokens and precision
training token / FLOP / wall-clock budget
evaluation protocol and checkpoint selection
hardware utilization and failed runs
只固定模型参数量,却让数据质量、context length 或调参预算不同,不能归因规模。
代理网格
不要只训练一条随规模增长的曲线。至少在若干 \(N\) 与 \(D\) 组合上形成二维网格,并预留不参与拟合的验证点。每个点检查:
- 是否进入稳定训练区间;
- loss 是否由同一 protocol 计算;
- 是否因数据重复进入饱和;
- 残差是否随规模系统性偏移;
- 多个随机种子的噪声是否小于候选差异。
DeepSeek LLM 给出了公开的 scaling 分析实例;其系数和结论属于对应模型族与数据配方,不应直接替代自己的代理实验。
配方条件化的搜索
规模律只在实验协议稳定时描述同一族曲线。若 optimizer、学习率日程、参数化或架构族改变,应先把最优超参数看成条件函数
而不是沿用旧族的单个学习率和 batch。尤其是 cosine decay 与 warmup–stable–decay(WSD)在同一计算预算下有不同的有效高学习率区间;用为其中一方调好的参数比较两者,会把搜索偏差写成算法差异。
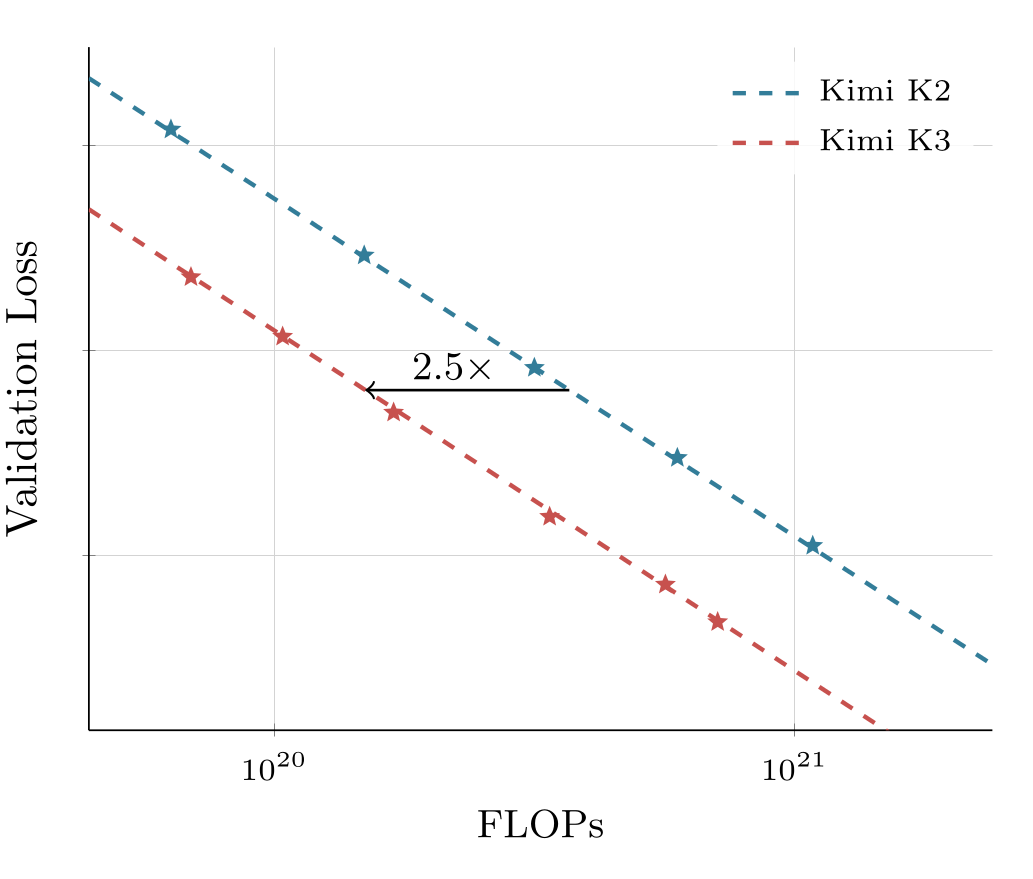
Kimi K3 技术报告把 cosine 与 WSD 的学习率、batch 搜索分开,并将架构、数据和训练方案的合计收益报告为约 \(2.5\times\) 的 scaling efficiency 实例。报告没有公开足够的原始拟合点、逐组件曲线与置信区间,因此这项结果适合支持“配方改变后重做搜索”,不能据此搬用系数或完成独立归因。其整体实验脉络见 Kimi K3。
多目标决策
最低预训练 loss 不一定是最终最优点。候选还需比较:
- 下游能力与数据域覆盖;
- 训练和推理内存;
- 首 token 与逐 token 延迟;
- 量化和并行可部署性;
- 失败恢复与总体成本;
- 记忆化、校准和安全回归。
正确性与失效
- 从少量点高精度外推:拟合误差在训练范围内小,不代表区间外可靠。
- 把参数总量当激活参数:MoE 的训练与推理成本被误算。
- 不同 tokenizer 直接比较 PPL:token 单位变化导致指标不等价。
- 忽略数据重复:继续增加 \(D\) 可能只是重复暴露同一语料。
- 只报成功运行:失败点和重跑成本被系统性排除。
- 代理规模迁移无验证:优化器、数据 mixture 或架构在大规模下改变。
- 只优化训练 FLOPs:未来大量推理时得到错误的总成本选择。
- 在同一 benchmark 反复选配方:测试集被用成开发集。
何时不应使用规模律决策
小规模 SFT、固定 checkpoint 的 PEFT、数据分布剧烈变化、全新架构或受硬延迟/显存约束的项目,往往没有足够同分布点支持可靠拟合。此时先做受控消融、性能模型和瓶颈测量,比强行拟合幂律更可信。
验证
- 公开拟合点、留出点、参数置信区间和残差,而不只给最终曲线。
- 用至少一个超出拟合范围但仍可承受的点验证外推。
- 重新计算实际 token、executed FLOPs、利用率和重跑成本。
- 对长上下文、MoE、多模态和量化候选单独核算非 \(6ND\) 项。
- 绘制不同部署查询量 \(Q\) 下的总成本与 break-even。
- 在同一数据和调参预算下比较简单 baseline 与新配方。
- 将模型选择与最终冻结评测分开,避免选择偏差。