理解与生成统一
多模态理解希望得到对语义变化敏感、对无关像素变化稳定的表示;生成则需要保留颜色、纹理、几何和时序等可重建细节。统一模型的核心不是“使用一个 Transformer”,而是怎样协调两种表示目标。
四条架构路线
| 路线 | 理解表示 | 生成表示 | 共享部分 |
|---|---|---|---|
| 工具组合 | 独立 encoder | 独立生成器 | LLM 调度与文本接口 |
| 共享主干、独立接口 | 语义 encoder | VQ/latent decoder | 高层 Transformer |
| 统一离散 token | 同一码本或 token 空间 | 同一离散 token | embedding、主干、softmax |
| AR + diffusion/flow | 媒体/文本 token | 连续 latent | 条件状态与部分主干 |
不存在对所有任务都占优的固定路线。统一程度越高,接口越简洁,但 token 竞争、表示冲突和训练稳定性也越难处理。
连续理解表示
视觉 encoder 产生
连续表示适合 projector、resampler 与 cross-attention;若要生成像素,还需独立 decoder 或连续生成目标。语义 encoder 的不变性可能已经丢失精确纹理,因此不能假设任何理解特征都可逆。
离散生成表示
媒体 tokenizer 把连续信号映射为有限码本:
文本与媒体 token 可统一做自回归建模:
Chameleon 展示了 early-fusion token 模型;Emu3 以 next-token prediction 统一视觉理解与生成。离散化简化主干目标,但 tokenizer 重建误差成为生成上限,图像 token 也显著增加序列长度。
解耦表示、共享主干
Janus 及其官方实现采用独立理解/生成视觉路径并共享自回归主干。该设计保留任务专用表示,同时让高层语言状态共享。
“共享主干”仍需要说明:
- 两类媒体 token 是否使用同一 embedding;
- 通过不同 special token 还是 router 选择接口;
- 生成 token 是否参与理解任务 attention;
- 各任务对共享层的梯度比例;
- 推理时何时切换 decoder。
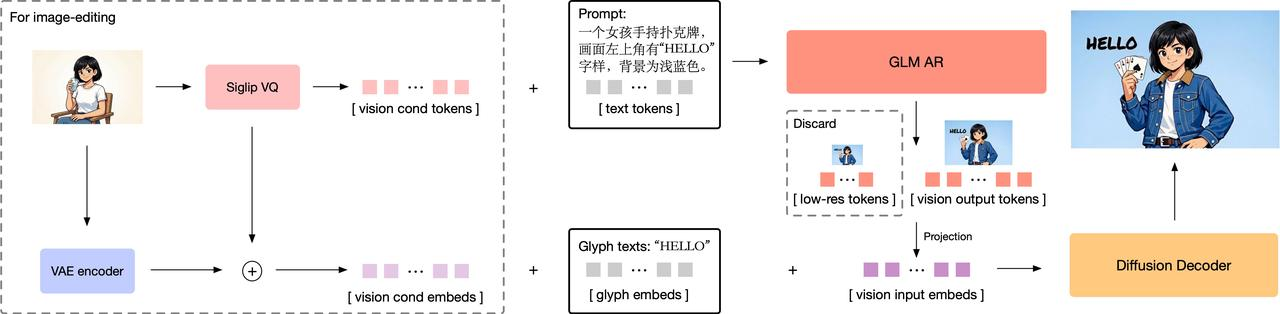
自回归与 diffusion 混合
Transfusion 在同一序列中对离散文本使用 next-token loss,对连续媒体块使用 diffusion loss。Show-o 及其官方实现探索自回归理解与离散 diffusion 生成的统一。
抽象联合目标为
若各模态 token 数不同,应按有效位置归一:

Attention mask 是任务定义
文本生成通常使用 causal mask;图像理解 token 可能需要双向可见;离散 diffusion 的 masked token 也不服从单向顺序。一个 batch 中可构造 block mask:
实现必须逐任务定义:
- 文本是否能看完整图像;
- 图像 token 是否互相双向可见;
- 生成中的未来媒体 token 是 mask、noise 还是不可见;
- 交错媒体之间能否跨段读取;
- loss 位置与可见位置是否一致。
把所有 token 直接套用一个 triangular mask,常会无意中泄漏目标或限制理解。
最小语义实现
下面把统一序列的两个独立契约并列:context_target_mask 允许 context 内双向可见,而 target 只能读取全部 context 与过去 target;modality_loss 先在每个模态的有效 token 内求均值,再按显式权重组合。
import torch

def context_target_mask(role):
    role = torch.as_tensor(role)
    assert torch.all((role == 0) | (role == 1))
    position = torch.arange(role.numel(), device=role.device)
    causal = position[:, None] >= position[None, :]
    query, key = role[:, None], role[None, :]
    context_reads_context = (query == 0) & (key == 0)
    target_reads_prefix = (query == 1) & ((key == 0) | causal)
    return context_reads_context | target_reads_prefix

def modality_loss(token_loss, modality, valid, weights):
    total, present = token_loss.new_zeros(()), 0
    for kind, weight in weights.items():
        selected = valid.bool() & modality.eq(kind)
        if selected.any():
            total = total + weight * token_loss[selected].mean()
            present += 1
    assert present > 0
    return total

role = torch.tensor([0, 0, 1, 1])
allowed = context_target_mask(role)
assert allowed.device == role.device
assert allowed[0].tolist() == [True, True, False, False]
assert allowed[-1].all()
loss = modality_loss(
    torch.tensor([1., 3., 10., 10., 10.]),
    torch.tensor([0, 0, 1, 1, 1]),
    torch.ones(5, dtype=torch.bool), {0: 1., 1: 1.},
)
torch.testing.assert_close(loss, torch.tensor(12.))
这里的布尔矩阵是小序列真值,不应在长序列上直接物化;生产 kernel 要把 task/segment/position metadata 编译成等价 mask。模态权重也不能替代 batch mixture 审计。逐元素实验见多模态原语:Context–target attention mask 与按模态归一的 loss。
模态平衡
设文本和图像 token 数分别为 \(T_t,T_v\)。直接对全部 token 平均时,梯度占比近似受
影响,而不一定符合任务价值。训练需监控:
- 每模态 loss 与 token 数;
- 对共享层的梯度范数和夹角;
- 单模态验证集遗忘;
- 不同 batch mixture 下的更新频率;
- 生成 tokenizer 的重建上限。
动态 loss 权重可以缓解数值失衡,但不能消除表示容量冲突。
序列与位置
统一序列需要显式边界:
应记录:
- media type 与 segment ID;
- 图像二维、视频三维位置;
- 多图是否重置坐标;
- generation order;
- placeholder 与实际 token 数;
- 截断时是否保留完整媒体块。
实现契约
- 每个任务有独立 mask builder 和 loss mask;
- modality/segment/position IDs 与序列同步;
- 媒体 tokenizer、codebook 和 decoder 版本固定;
- loss 先按有效 token 归一,再进行任务加权;
- 训练和采样使用一致的 special token 与 schedule;
- mixed batch 不允许不同任务误共享目标位置;
- 生成路径输出非法媒体 token 时有明确处理;
- text-only、understanding-only、generation-only 均可独立回归。
失效模式
- 表示冲突:理解需要不变性,生成需要可逆细节。
- 模态吞噬:高 token 数媒体主导共享参数。
- 文本退化:联合训练后纯文本能力下降。
- 模态遗忘:阶段切换后旧能力迅速丢失。
- Mask 泄漏:生成位置读取了目标 token 或未来 latent。
- Tokenizer ceiling:主干能力提升但重建质量不再提高。
- 接口错配:理解 encoder 输出被错误送入生成 decoder。
- 序列爆炸:高分辨率离散 token 使训练与采样不可承受。
验证
| 问题 | 对照 |
|---|---|
| 是否真正共享受益 | 独立模型、共享主干、统一 token |
| 是否发生冲突 | 单任务与联合训练曲线、梯度夹角 |
| Mask 是否正确 | 小型人工序列逐元素检查 |
| Tokenizer 是否限质 | 原图—重建与最终生成分别评测 |
| 文本是否退化 | 固定纯文本留出集 |
| 模态是否被使用 | 替换、遮挡、移除与反事实输入 |
| 成本是否可控 | 每模态 token、prefill、decode/采样步数 |
离散与连续生成目标见图像生成,融合接口见多模态融合、位置与训练,最小 modality mask 与 loss 见多模态手撕实现。
继续深入
token、位置和可见性契约见空间、时间、位置与 Mask;系统如何把文本、图像、音频、视频与流式输出调度在一起,见 Any-to-Any 系统;生成目标的独立推导见图像生成总览。