从静态批处理到状态化推理集群
自回归模型把一次请求拆成长度不确定的多轮执行:prefill 并行处理 prompt,decode 随后一次生成少量 token。服务系统的历史因而不是 kernel 越来越快,而是调度粒度、KV 所有权和阶段边界不断重写。每次提高吞吐,都会产生新的显存、尾延迟或分布式状态问题。
两种阶段,两组约束
对典型 decoder-only Transformer:
- prefill 同时处理多个 query token,矩阵较大,通常更容易利用计算吞吐;
- decode 每轮只追加少量 query token,却反复读取权重与历史 KV,通常更受显存带宽和 batch 并发影响。
这不是硬件无关的定律。短 prompt、大 decode batch、量化 kernel 或不同并行度都可能改变边界。判断阶段行为应使用算术强度与真实 trace,而不是只给它贴上 compute-bound 或 memory-bound 标签。
服务指标也必须拆开:
只报告总 tokens/s 会掩盖交互请求是否按时得到首 token,以及流式输出是否发生长暂停。完整指标口径见推理与服务。
静态 batching:最长请求锁住整个 batch
传统 request-level batching 把一组请求固定到同一 batch,直到全部结束。生成长度未知时,短请求必须等待最长请求,新请求也不能利用已经空出的 slot。batch 增大虽然提高 GEMM 利用率,却同时增加 head-of-line blocking。
Orca 把调度粒度从整条请求降到模型 iteration:每轮结束后移除完成请求、加入新请求,并通过 selective batching 处理并非所有算子都能按相同方式动态合批的问题。对一轮调度,可写成
其中 \(K\) 是 token budget,普通 decode 请求常有 \(q_i=1\),prefill 或 verify 请求可以贡献多个 token。
Iteration-level scheduling 消除了固定 batch 的空槽,却让 batch shape、请求集合与显存需求每轮变化。调度器由此变成模型执行语义的一部分,而不是外部队列。
KV Cache:动态批处理把显存变成主资源
对 \(L\) 层、每元素 \(b\) 字节、KV head 数 \(H_{\text{kv}}\)、head dimension \(d_h\),一组长度为 \(T_i\) 的请求占用
因子 2 来自 K 和 V。若系统为每条请求预留最大长度,未使用空间巨大;若使用不同大小连续区间,请求增长、结束和取消又会制造外部碎片。Continuous batching 提高活跃请求数以后,KV 容量而非计算往往首先限制 batch。
PagedAttention:把逻辑连续与物理连续分开
PagedAttention/vLLM 借鉴虚拟内存,把逻辑 token block 映射到固定大小的物理 KV block:
block size 为 \(P_b\) 时,一条序列最后一块的内部浪费小于 \(P_b\) 个 token slot。分页避免为完整最大长度连续预留,也允许共享只读 block;代价是 page table、refcount、分配器与 attention kernel 的间接寻址。
PagedAttention 不是单独的 attention 公式创新。它成立的系统条件包括:
- scheduler 以逻辑位置维护请求进度;
- allocator 原子分配和回收 block;
- kernel 按 block table 读取 K/V;
- cancel、preemption、beam 和 speculative 分支都更新所有权;
- 内存不足在 admission 阶段处理,而不是写 KV 时才崩溃。
机制与紧凑 reference 见 vLLM 与 PagedAttention、KV Cache 和推理引擎。
Prefix reuse:分页让细粒度共享更便宜
重复 system prompt、few-shot 示例或多轮对话可以共享已经计算的前缀 KV。安全 cache identity 至少绑定
exact token IDs
model and weight version
tokenizer and template version
adapter
position / RoPE / mask configuration
KV dtype and layout
tenant and permission boundary
字符串相同不保证 token 或模型状态相同。共享的非满尾块在任一分支续写前必须 copy-on-write,否则会修改其他请求的历史。
SGLang 中的 RadixAttention 用 radix tree 组织最长共享前缀。命中是否有价值取决于
因此 cache-aware routing 同时面对复用收益和队列倾斜:总把热前缀路由到同一 worker,可能让高命中率反而提高 TTFT。更完整的身份与生命周期见缓存复用。
Chunked prefill:在共置引擎里治理阶段干扰
长 prefill 可以占据一次很长的 GPU iteration,使已在流式输出的 decode 请求出现 TPOT 尖峰。Sarathi-Serve 把 prefill 切成较均匀的 chunk,与 decode token 放进同一轮预算:
chunk 大,prefill GEMM 更高效但 decode stall 更长;chunk 小,调度与 kernel launch 增多,prefill 效率下降。Chunked prefill 保留同一 worker pool,适合网络不足以搬运 KV 或负载尚不能支撑独立资源池的场景。
Speculative decoding:串行瓶颈转成并行验证
标准 decode 要为每个新 token 串行执行 target model。Speculative decoding 让较快 draft 一次提出 \(\gamma\) 个 token,再由 target 并行验证。精确 speculative decoding 对 proposal \(q\) 和 target \(p\) 使用
作为接受概率;拒绝时从归一化的 \([p-q]_+\) residual 采样,从而保持 target 分布。
它把“小 batch、单 token 的内存读取”转成更大的 verify 工作,却新增 draft 成本、接受率波动和事务状态。一次 round 的 provisional KV、RNG、grammar 与 stop state 必须整体 commit 或 rollback。Continuous batching 下,verify shape 还会和普通 decode 竞争 token budget;高接受率不自动等于高 goodput。推导与验证见推测解码。
Prefill–Decode 分离:让两阶段独立扩缩
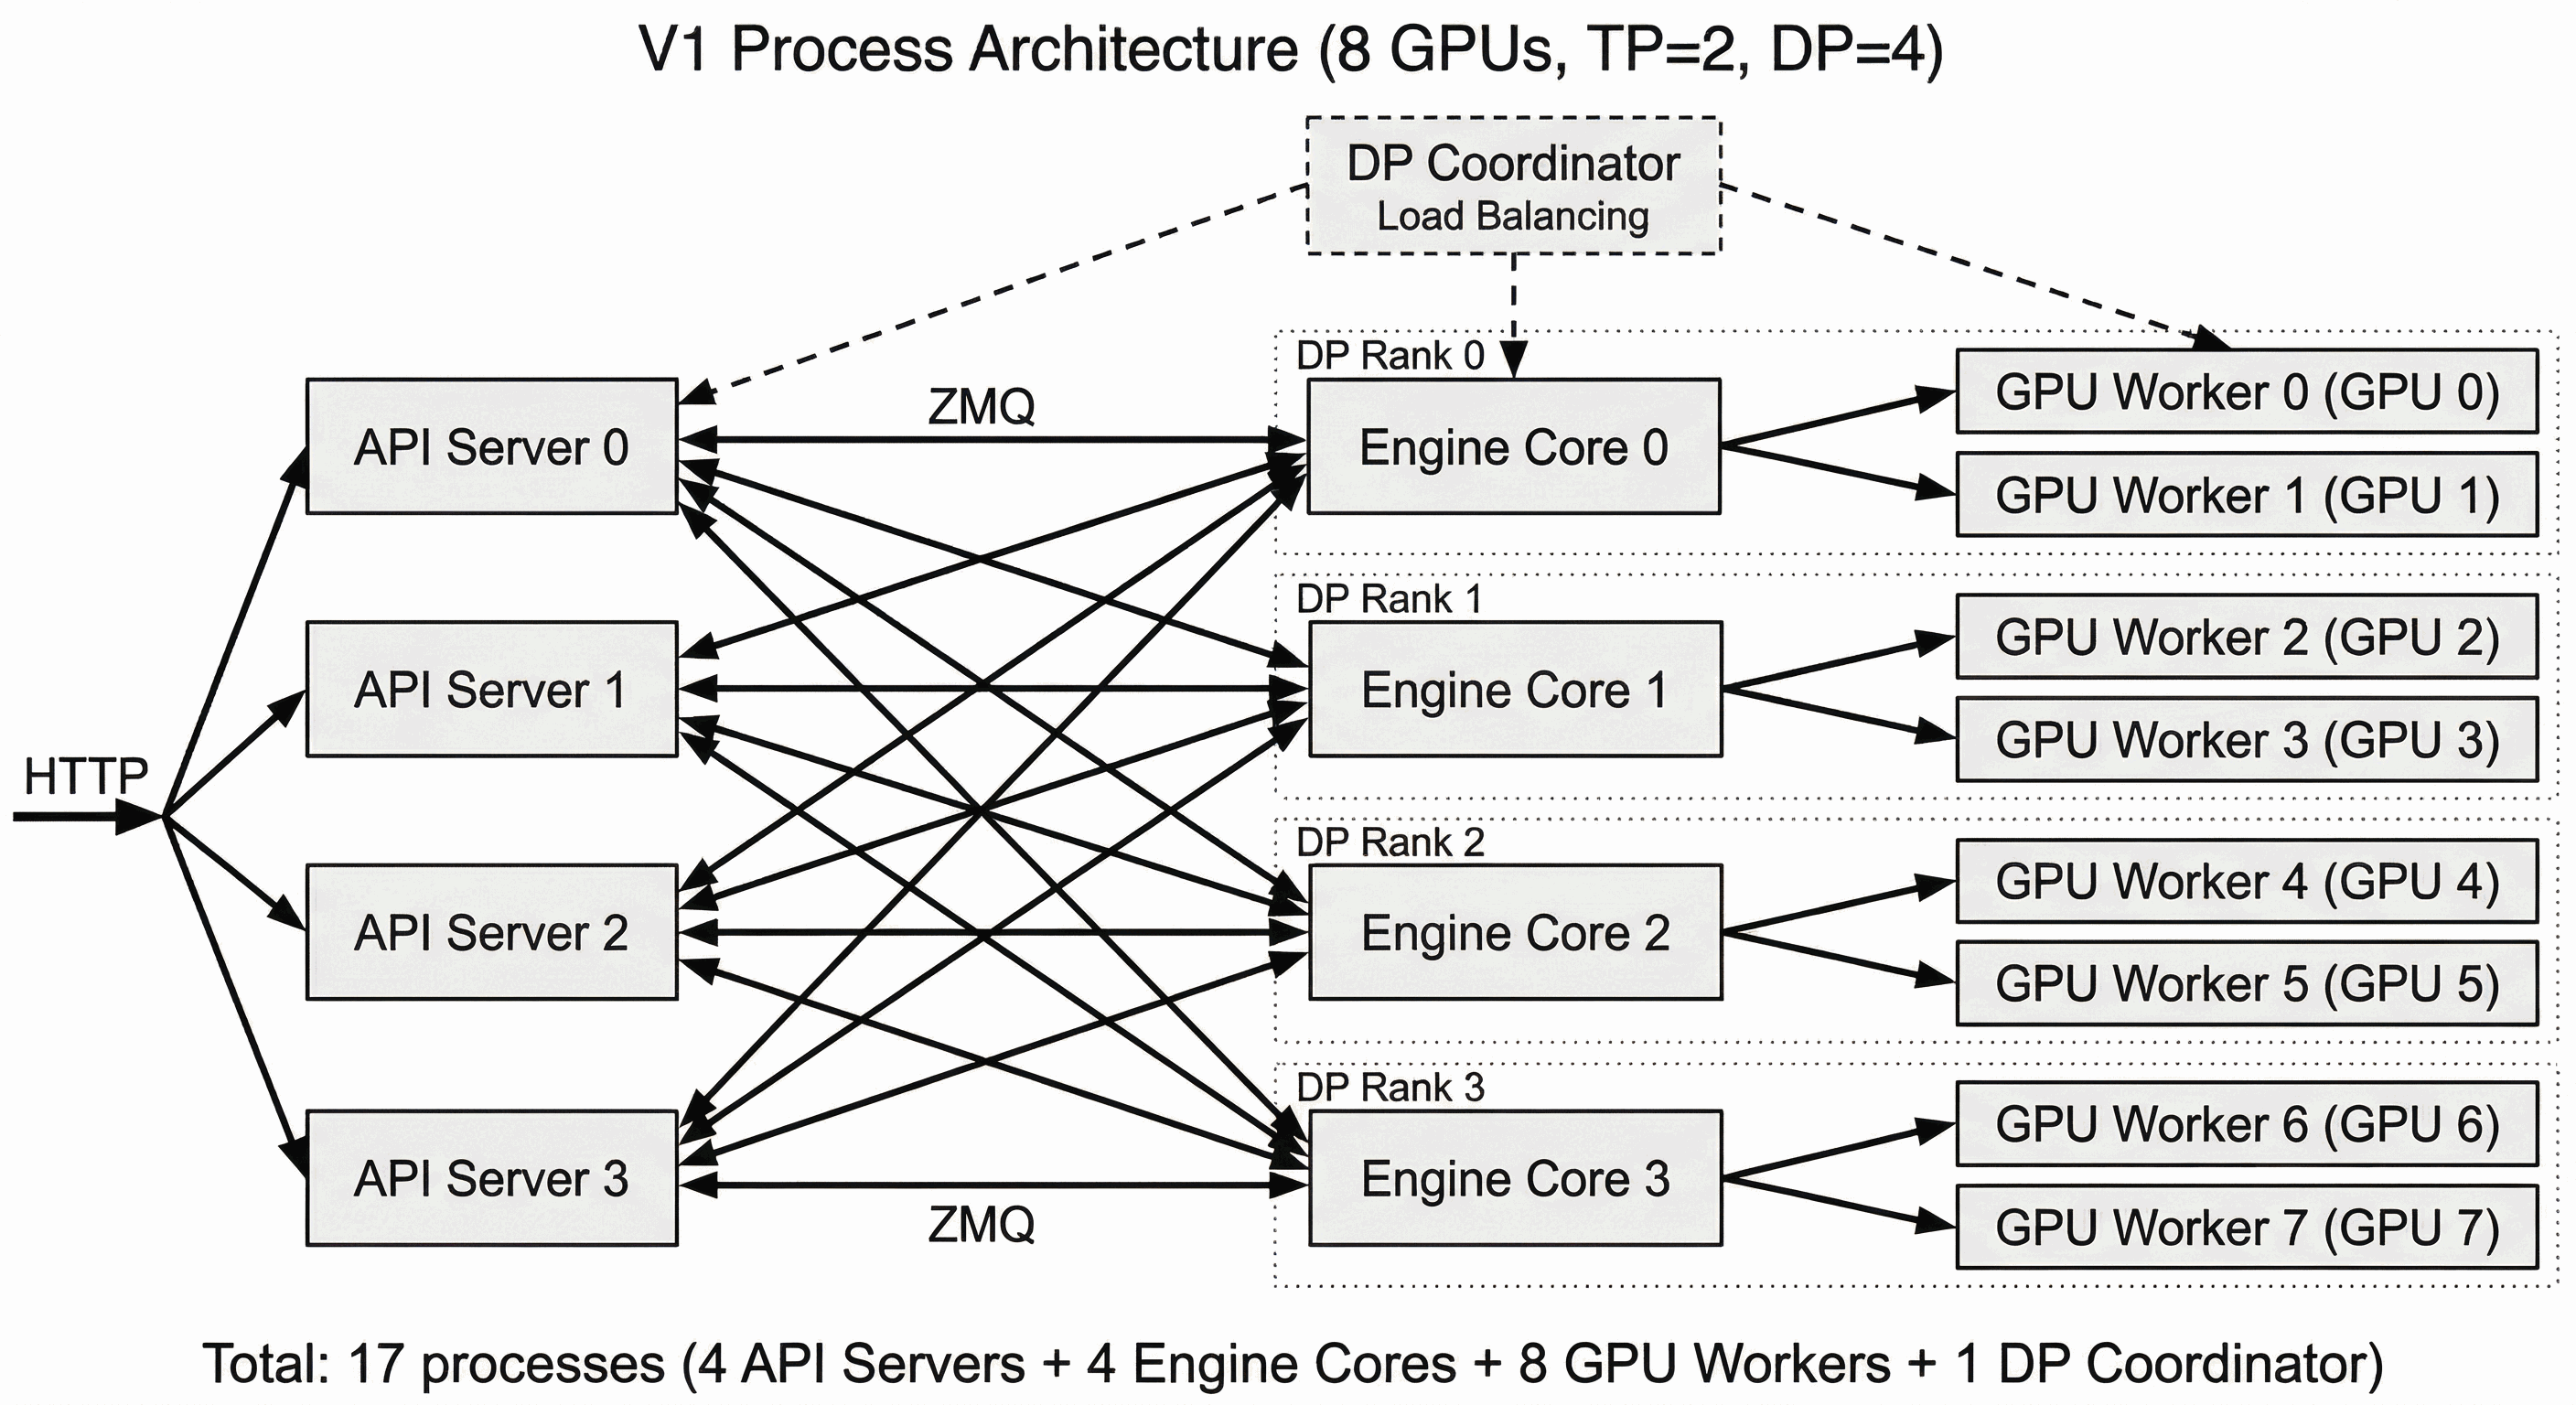
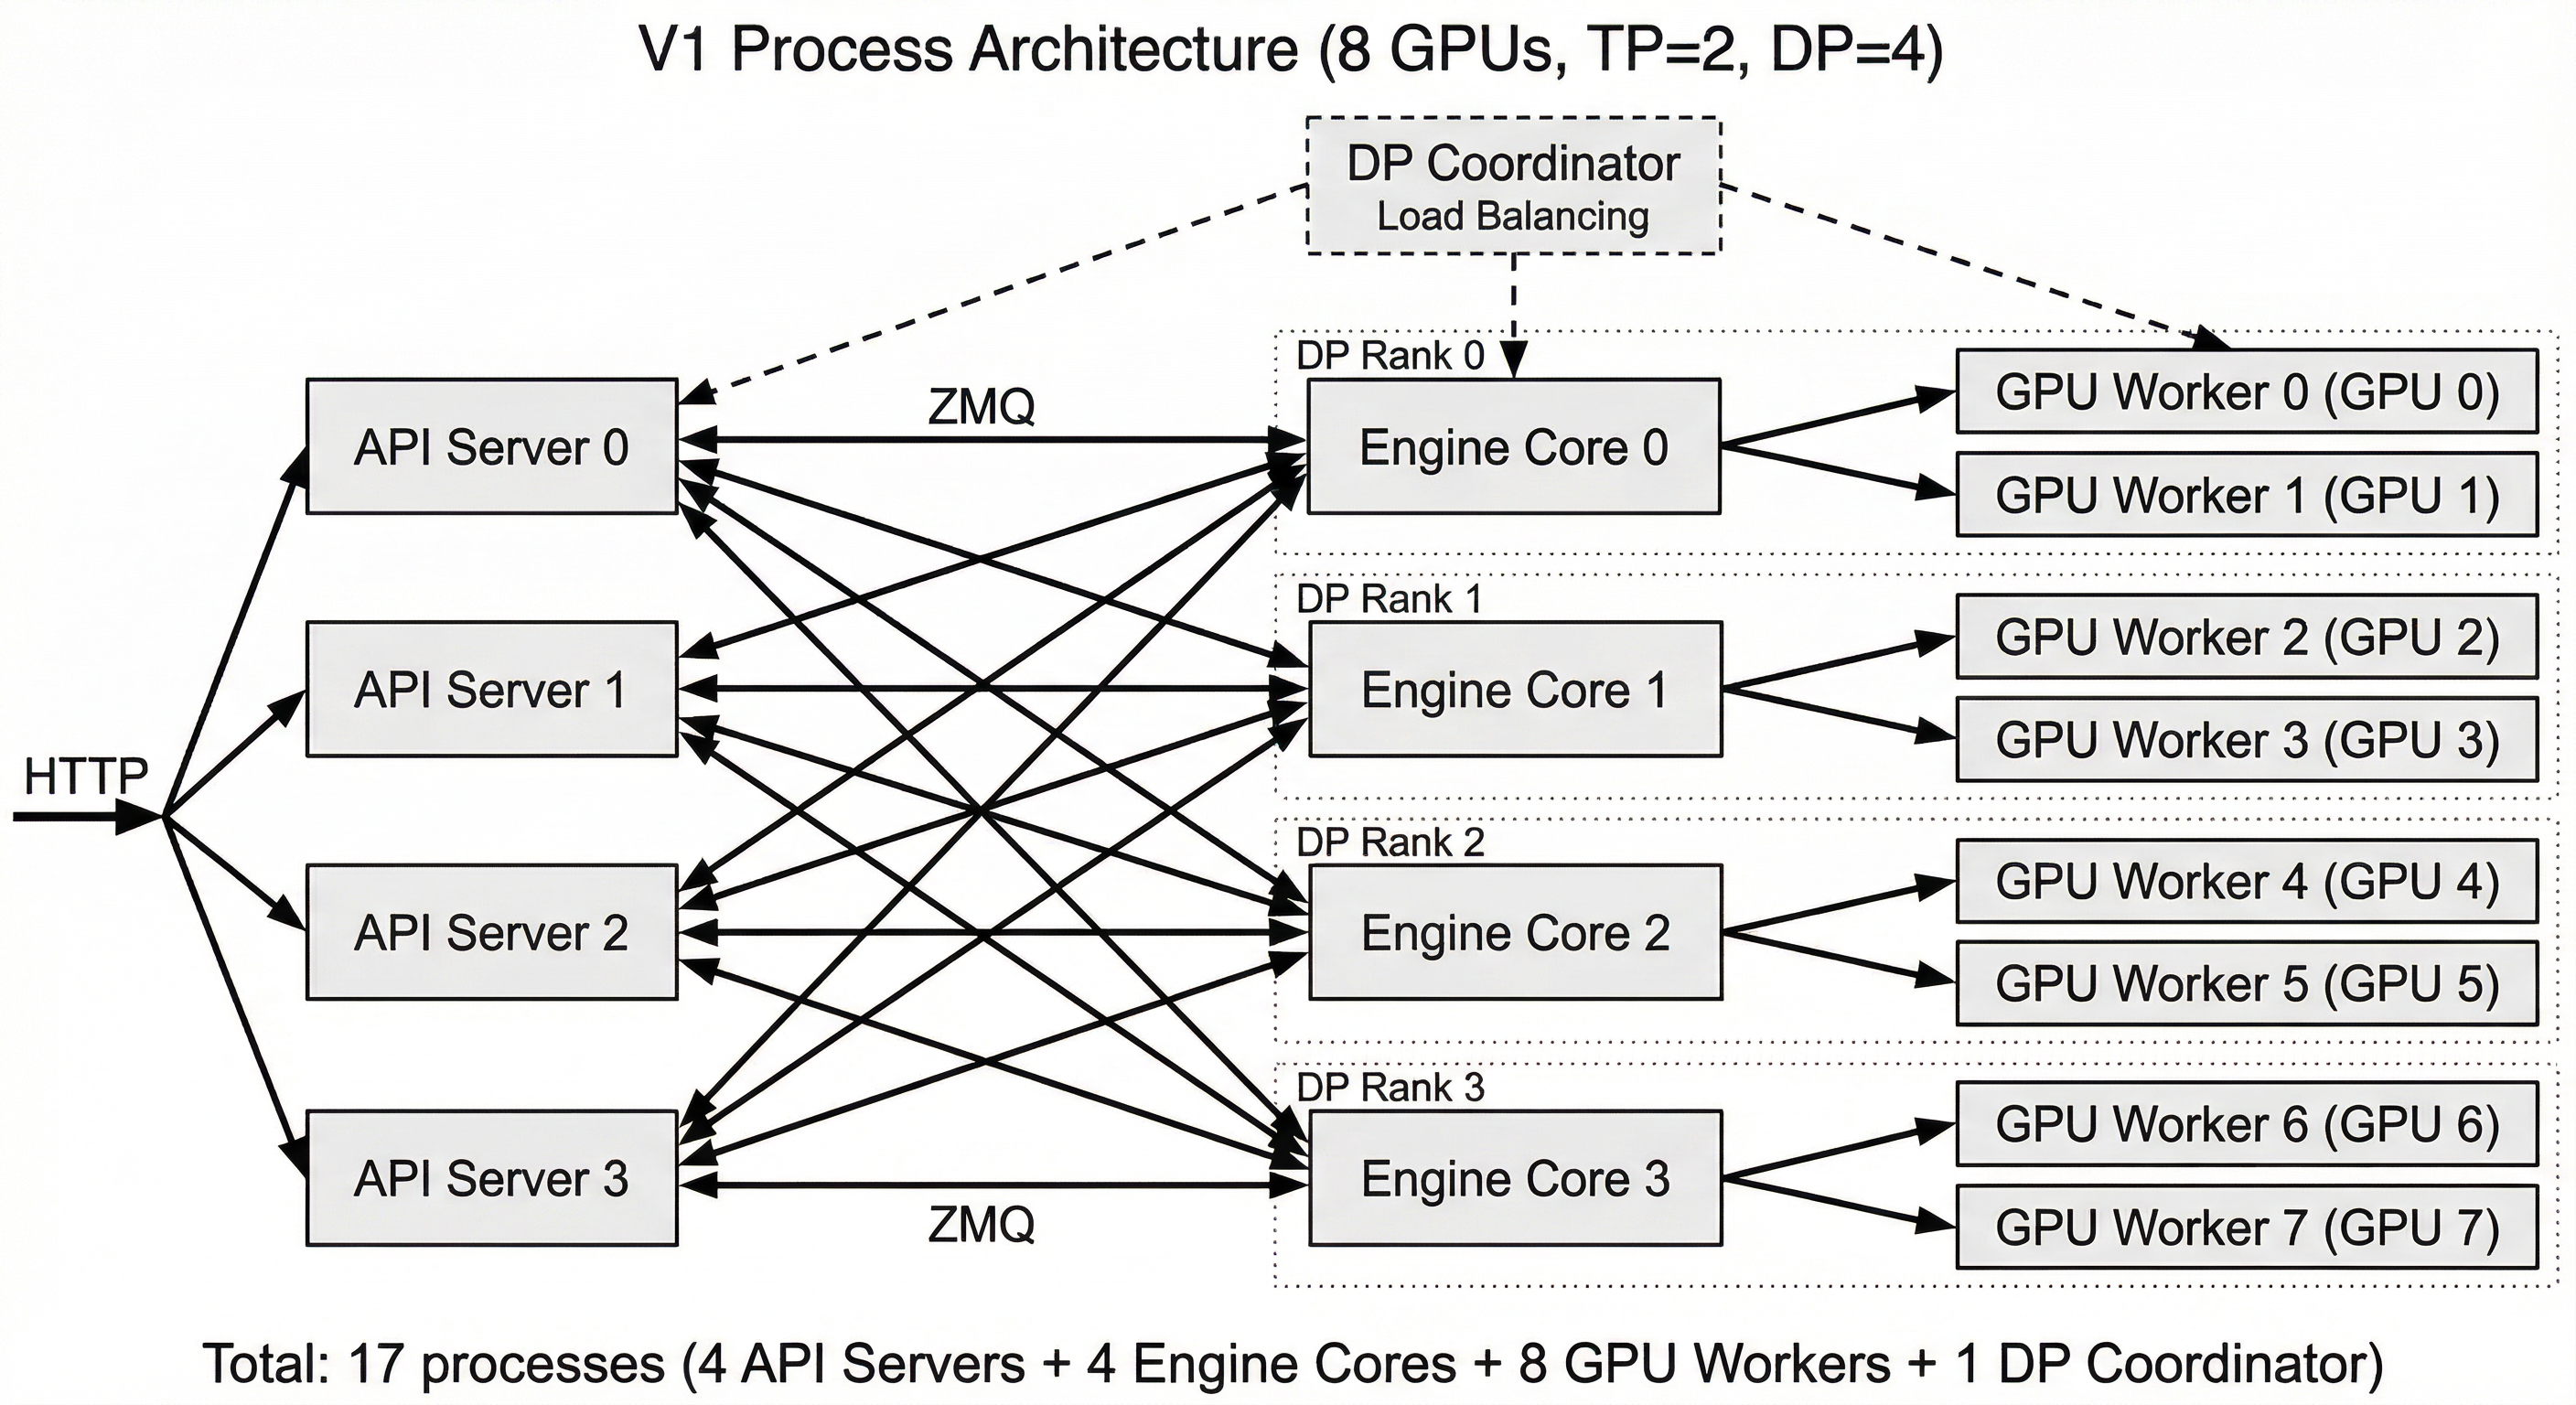
Chunked prefill 缓解共置干扰,但 prefill 和 decode 仍共享同一 GPU、并行度和容量计划。Splitwise 与 DistServe 把两阶段放到不同 worker pool,使 TTFT 与 TPOT 可以分别规划。
分离不是免费调度。prefill 完成后必须传输每层 prompt KV:
若两池采用不同 TP/PP 或 KV block layout,还要执行 head、layer 或 block reshard。decode 容量必须在 prefill 开始前预留,否则 prefill 生产速度超过 decode 消费速度时,KV 会堆积在发送端、网络或接收端。
令请求到达率为 \(\lambda\),平均 prompt/output token 数为 \(\mathbb E[P]\)、\(\mathbb E[O]\),稳定运行至少要求
Prefix hit 会减少实际 prefill token 流量,speculative decoding 会改变每轮 target 工作量,所以最优 P:D 比例不是固定配置。数据路径、版本和失败恢复见 Prefill–Decode 分离。
分布式 KV:状态跨出单机以后
P/D 分离、跨副本迁移和长前缀复用都会让 KV 成为网络对象。Mooncake 研究 KV-centric 的分离式服务架构,并利用 GPU 之外的 DRAM 与 SSD 扩展缓存层级。更大容量可以减少重复 prefill,却增加目录一致性、远端带宽、安装延迟、版本失效与权限隔离。
目录命中不等于 KV 可用。只有目标 worker 完成 schema 校验、传输、checksum 和 block 安装后,请求才能进入 decode。远端副本还能改善故障恢复,但常态复制成本可能超过偶发重算,因此要与 workload 的复用率和故障率共同评估。
Goodput:吞吐最终回到 SLO
在线系统真正关心的是同时满足首 token 和流式延迟约束的请求率:
Admission 需要同时估计未来 KV 增长、prompt 工作量、输出长度、prefix hit、adapter 驻留与当前队列。只检查瞬时 free memory 会把未来增长承诺给多个请求;只优化平均延迟又会掩盖长 prefill、cache miss 和迁移造成的尾部。
评价至少固定:
- prompt/output 长度与到达过程;
- prefix 冷启动、热度和 worker 倾斜;
- prefill、decode、verify 的 token budget;
- TTFT、TPOT、E2E 的 p50/p95/p99;
- KV 水位、block waste、eviction 与 transfer;
- 取消、OOM、worker failure 和模型升级。
具体协议见调度与 Goodput 和基准与可靠性。
机制怎样互相改写
| 机制 | 直接缓解 | 随后出现的约束 |
|---|---|---|
| Orca 式 iteration scheduling | 静态 batch 空槽与等待 | 动态 shape、每轮 admission |
| PagedAttention | 连续预留与碎片 | 间接寻址、block ownership |
| Prefix reuse | 重复 prefill | cache identity、COW、路由倾斜 |
| Chunked prefill | 共置阶段干扰 | chunk 效率与调度开销 |
| Speculative decoding | token 串行与权重读取 | draft/verify 成本、事务回滚 |
| P/D 分离 | 干扰与资源耦合 | KV 传输、双池背压和失败 |
| 分布式 KV | 单机容量与冷前缀 | 网络、目录、版本和隔离 |
最好的方案不是把所有机制同时打开,而是先定位当前 SLO 下的首个瓶颈,再验证新增状态和通信是否仍落在收益预算内。
Reference
- Orca: A Distributed Serving System for Transformer-Based Generative Models
- Efficient Memory Management for Large Language Model Serving with PagedAttention
- SGLang: Efficient Execution of Structured Language Model Programs
- Sarathi-Serve
- Fast Inference from Transformers via Speculative Decoding
- Splitwise
- DistServe
- Mooncake