工具与智能体
智能体不是“带长 prompt 的聊天模型”,而是一个在外部环境中反复观察、选择动作、接收结果并判断终止的系统。模型负责提出候选决策,运行时负责状态、权限、预算和可恢复执行。
最小抽象
在部分可观测环境中,时刻 \(t\) 的策略可写成:
其中 \(o_t\) 是观察,\(a_t\) 是动作,\(h_t\) 是可见历史。真实系统不会把全部历史原样塞回上下文,而是构造受预算限制的状态:
\(m_t\) 是记忆,\(p_t\) 是当前计划,\(b_t\) 是预算与权限。模型只看到 \(x_t\),因此 context builder 本身就是策略的一部分。
四层结构
| 层 | 负责什么 | 不应交给模型自由决定的部分 |
|---|---|---|
| 推理模型 | 理解观察、提出下一步 | 权限授予、真实终态 |
| 工具契约 | 动作 schema 与结果语义 | 未校验参数、隐式副作用 |
| 运行时 | 状态机、调度、重试、恢复 | 无限循环、盲目重放 |
| 安全边界 | 身份、隔离、审批、审计 | 由不可信内容提升权限 |
记忆与规划横跨四层:它决定保留什么状态、如何修订计划以及何时把信息写入长期存储。
推理与行动
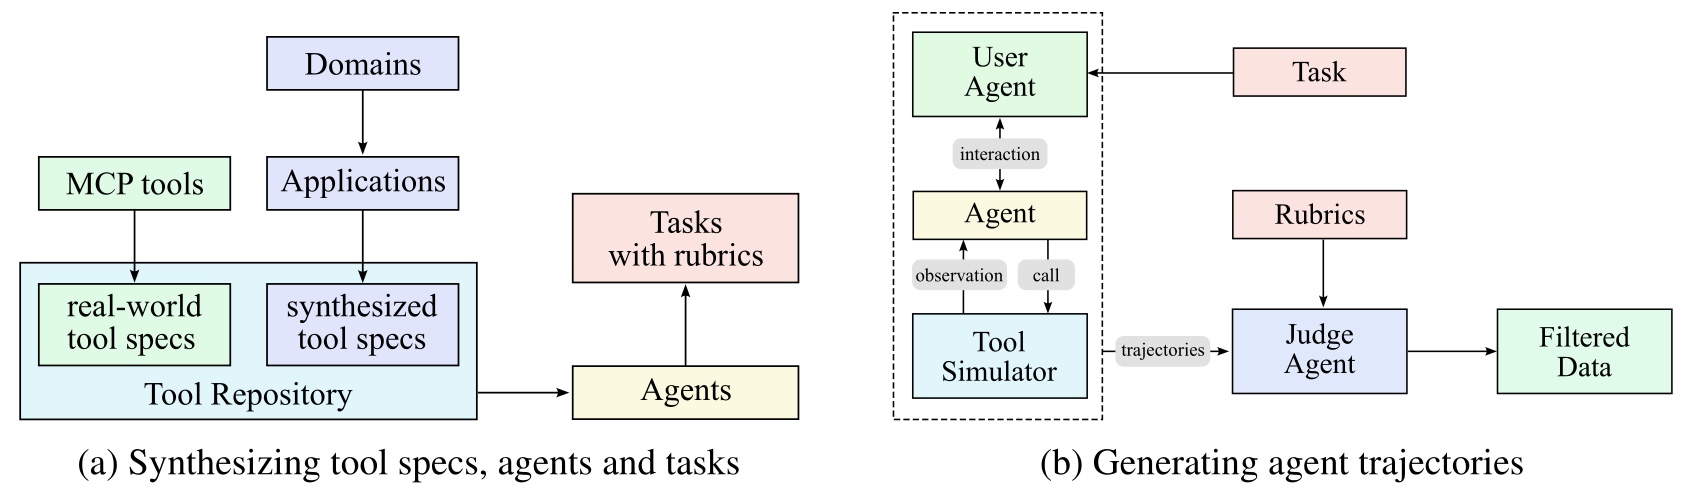
ReAct 把推理与行动交错,用环境观察修正后续步骤;Toolformer 研究模型自监督学习何时调用 API。两项工作深读区分推理时 trajectory 与训练数据筛选。工程系统不需要公开或保存自由形式的内部推理文本。可持久化的是任务状态、工具参数、结果、证据、决策标签与错误,而不是不可审计的长篇“思维”。
动作空间常分为:
- 回答:不改变外部状态;
- 读取:搜索、数据库查询、文件读取;
- 计算:代码、解释器、模型或求解器;
- 写入:修改文件、数据库或配置;
- 通信:发送消息、创建工单、发布内容;
- 破坏性动作:删除、覆盖、支付、撤销或权限变化。
后几类需要更强的身份、确认、幂等与验收。
自主程度
“可以多步执行”不等于“可以自动执行任何动作”。自主程度至少由四个轴决定:
- 动作是否可逆;
- 错误的影响范围;
- 终态是否能被机器验证;
- 用户是否已明确授权该范围。
低风险只读任务可以自动循环;高风险外部写入即使模型置信度很高,也可能需要预览、审批或双人控制。
终止
智能体必须区分:
- success:环境证据满足成功谓词;
- partial:部分子目标完成,剩余项明确;
- blocked:缺少权限、输入或外部状态;
- failed:已知错误且不可在当前预算内恢复;
- unknown:动作可能执行,但结果无法确认;
- cancelled:收到取消并完成清理。
“模型说完成了”不是 success。成功谓词应由测试、API 返回、文件状态、页面可见性或其他外部观察判定。
何时需要 agent
适合 agent 的任务通常同时具有:
- 不能提前写死完整步骤;
- 中间观察会改变下一步;
- 工具结果可验证;
- 失败可以局部恢复;
- 动作边界与成本可控。
单次检索、固定 DAG 或确定性 ETL 往往用普通工作流更可靠。不要为了“自治”把可静态编排的步骤改成自由循环。
评测
至少分三层:
动作级
工具选择、参数正确率、schema 合法率、权限违规、无效调用与错误恢复。
轨迹级
步骤数、重复率、计划修订、观察利用率、token/时间/费用和中间副作用。
任务级
环境判定的成功率、部分完成率、恢复率、尾延迟与安全事件。
多次运行的成功概率也要报告。若单次成功率为 \(p\),在独立假设下 \(n\) 次至少成功一次为 \(1-(1-p)^n\);实际运行常共享同一环境缺陷,不能把这个公式当作真实独立性保证。
阅读路径
- 从工具调用固定动作与结果;
- 用运行时实现有界循环和恢复;
- 再加入记忆与规划;
- 用智能体安全检查信任与权限;
- 仓库级实例见 Coding Agent;
- 需要从轨迹学习时进入 Agentic RL。
最小 schema 校验与工具调度代码见手撕:检索与智能体。