策略身份、训推分布与策略滞后
“模型权重相同”不等于“采样分布相同”。语言模型 RL 往往用推理引擎生成 token,再用另一套训练栈重算 log-probability;同时,learner 可能已在 rollout 排队期间更新多次。于是一个看似简单的 importance ratio,实际混合了 policy update、engine mismatch 与异步 staleness 三件事。
先给结论:任何 PPO、GRPO 或异步算法都应先写清四个 policy 身份,再讨论 clipping。
| 记号 | 含义 | 回答的问题 |
|---|---|---|
| \(\pi_\theta^{\mathrm{train}}\) | 当前训练引擎上的 learner policy | 现在要更新谁 |
| \(\pi_{\mathrm{old}}^{\mathrm{train}}\) | rollout 版本在训练引擎上的重算分布 | 相对哪个冻结版本做局部更新 |
| \(\mu_{\mathrm{old}}^{\mathrm{rollout}}\) | 实际生成 token 的 behavior distribution | 数据到底由谁采出 |
| \(\pi_{\mathrm{ref}}\) | KL 或行为先验的 reference policy | 不希望偏离哪个锚点 |
同步、同精度、无采样变换时,\(\mu_{\mathrm{old}}^{\mathrm{rollout}}\) 可以近似 \(\pi_{\mathrm{old}}^{\mathrm{train}}\)。这只是一个需要验证的特殊情形,不是由 checkpoint ID 自动保证的事实。
三种 ratio 不应混写
policy update ratio 为
它描述 learner 相对冻结 old policy 的变化,是 PPO 和许多 GRPO 变体中的局部更新坐标。
同一参数版本的 train–rollout discrepancy ratio 为
它描述训练引擎与真实生成引擎之间的差异。若 rollout 还经历 temperature、top-\(p\)、top-\(k\)、grammar、repetition penalty 或 MoE router 变化,分母必须对应变换后的真实采样分布,而不是未经处理的 raw logits。
当前 learner 相对真实 behavior 的直接 ratio 则是
这条分解把两个误差源隔开:
old rollout engine --engine mismatch--> old training policy
       --policy updates / queue lag--> current training policy
reference ratio \(\pi_\theta/\pi_{\mathrm{ref}}\) 只用于 KL、reward shaping 或行为约束,不是 behavior correction。即使 old、behavior 和 reference 在初始化时来自同一份权重,三种语义也不能合并。
一个数值例子足以看出差别。若某 token 上
则
把任意两个量互换,都会改变 estimator。
三种 ratio 最适合在 log-space 中分别构造,再检查乘法分解。这里的输入都是同一批 action token 的 post-processor log-probability;若 prefix、tokenizer 或 grammar support 不同,函数应在更上游拒绝比较,而不是靠数值裁剪掩盖。
import torch
def policy_ratios(current_logp, old_train_logp, behavior_logp, action_mask):
    if not (current_logp.shape == old_train_logp.shape == behavior_logp.shape == action_mask.shape):
        raise ValueError("all token tensors must align")
    mask = action_mask.bool()
    update = torch.ones_like(current_logp)
    engine = torch.ones_like(current_logp)
    direct = torch.ones_like(current_logp)
    update[mask] = (current_logp[mask] - old_train_logp[mask]).exp()
    engine[mask] = (old_train_logp[mask] - behavior_logp[mask]).exp()
    direct[mask] = (current_logp[mask] - behavior_logp[mask]).exp()
    return update, engine, direct
cur = torch.tensor([[99., .6, .3]]).log()
old = torch.tensor([[88., .5, .2]]).log()
beh = torch.tensor([[77., .25, .4]]).log()
mask = torch.tensor([[False, True, True]])
update, engine, direct = policy_ratios(cur, old, beh, mask)
torch.testing.assert_close(direct[mask], (update * engine)[mask])
assert update[0, 0] == engine[0, 0] == direct[0, 0] == 1
assert direct[0, 1] == 2.4
mask 外返回乘法单位元,便于后续乘 loss,但这些位置仍不得进入统计分母。生产轨迹还需绑定 checkpoint、训练/推理引擎、sampling processor 与 action span;ratio 应在构造 gate 前先按长度、任务和版本分层观察。
为什么同权重也会有分布差
train 与 rollout policy 的差别可来自多个层级:
- 数值精度:训练使用 BF16/FP32 混合,rollout 使用 FP8、INT8 或量化 KV;
- kernel 与归约顺序:attention、normalization、vocabulary projection 的浮点归约不同;
- MoE routing:router logits 的微小误差会跨过 top-\(k\) 边界,选择不同 expert;
- 模型变换:tensor parallel、weight packing、fused op 和量化 scale 改变前向数值;
- 解码变换:temperature、top-\(p\)、grammar 和重复惩罚直接重定义 behavior distribution;
- 版本滞后:权重同步、队列和长 rollout 使 behavior checkpoint 落后于 learner;
- 上下文重建:chat template、tokenizer、position ID、padding 或 compaction 不一致,使条件历史 \(h_t\) 已经不同。
前五项即使 checkpoint 完全相同也会发生;第六项是异步系统固有的 policy lag;第七项甚至不是同一条件分布上的概率差。
因此诊断顺序应从“是否在同一个 token、同一个 prefix 上比较”开始,再看 log-prob gap。若 tokenization 或历史不同,计算 ratio 没有可比语义。
从 sequence 目标到 token 近似
语言模型 reward 常在整条 response 结束后给出。真实 sequence objective 写成
对 behavior \(\mu\) 采出的 response,完整 trajectory importance ratio 是
长序列上的乘积方差会迅速恶化。现代 LLM trainer 因而常用 token-level surrogate、clipping、gate 或归一化 sequence ratio。它们是有条件的低方差近似,不应在没有 mismatch/staleness 诊断时被称为“等价的 on-policy objective”。
Stabilizing Reinforcement Learning with LLMs 把 token-level formulation 与两种偏移明确连接:engine discrepancy 决定同版本分布是否一致,policy staleness 决定 rollout 相对 current learner 有多旧。二者都小,才更接近局部一阶近似成立的区域。
TIS:校正 engine mismatch
Truncated Importance Sampling(TIS)针对同版本训练分布与 rollout 分布的差异,构造
它再乘到由训练 policy 定义的 policy-gradient 项上。关键是:TIS ratio 与 PPO ratio 不是一个量。
上截断降低极端 importance weight 的方差,却引入偏差。若 rollout distribution 对某些 token 赋零概率,普通 importance sampling 也无法恢复缺失 support;top-\(p\) 等处理器必须进入行为契约。
TIS 的直接优点是保留所有已采 token 的有限权重;缺点是被严重错配的 token 仍可贡献饱和权重。C 因而应与 discrepancy 分位数、有效样本量和训练稳定性一起报告。
IcePop:校正后再双侧拒绝
IcePop 使用同一 engine ratio
但采用双侧 acceptance band:
区间内做 importance correction,区间外直接丢弃 token 的 policy-gradient 信号。与 TIS 相比,它更积极地隔离 mismatch tail,也更明显地改变有效训练分布。若异常 ratio 与长度、任务难度、语言或 reward 相关,mask 会产生结构化选择偏差。
IcePop 是 Ring-1T 整体训练系统的一项组件;论文中的结果还同时依赖其他算法、数据和基础设施改动,不能把完整模型收益单独归给这个 gate。
R3:让 MoE 重放 rollout route
MoE 的特殊问题是:很小的 router 数值差异可能选择完全不同的 expert。此时仅校正最终 token probability,未必能修复训练前向经过了另一条计算路径。
Rollout Routing Replay(R3)记录 inference 侧的 routing distribution 或选择,并在训练侧重放,使同一 token 尽量经过 rollout 时的 expert 路径。它处理的是 计算图身份,而不仅是输出概率的重加权。
这带来新的审计问题:
- 记录的是 router logits、top-\(k\) index 还是 dispatch weight;
- 重放后梯度对 router 的定义是什么;
- routing metadata 怎样与 token、microbatch 和 checkpoint 对齐;
- 强制重放是否改变了希望优化的 current-policy computation。
R3 与 ratio correction 可以互补:前者缩小 MoE 路由差,后者处理剩余概率差和 policy update。不能因为使用 R3 就省略 behavior log-prob。
DIS:直接跨过 old policy
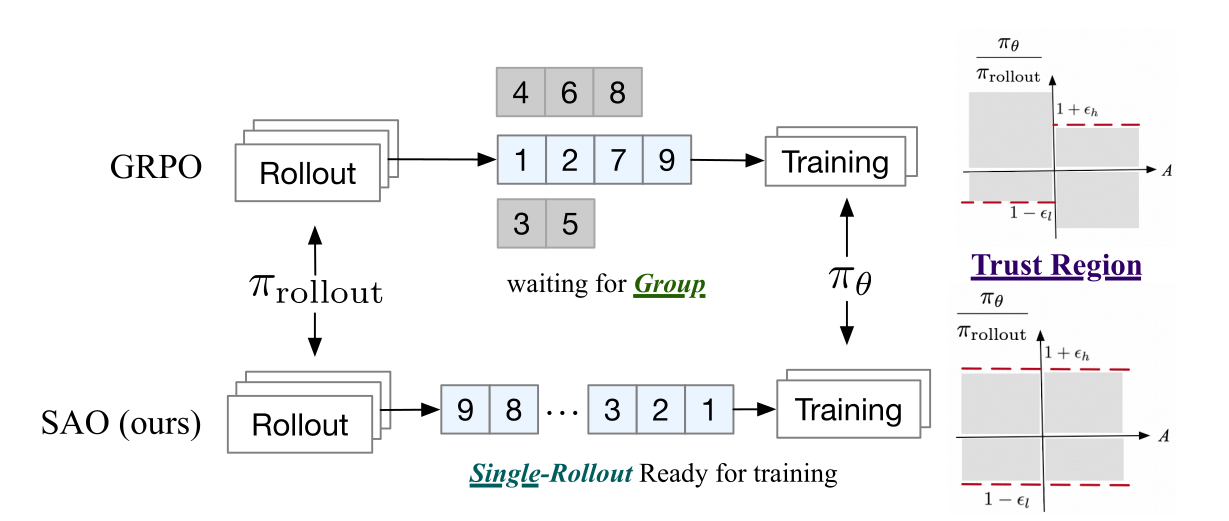
异步 single-rollout 系统可能不愿在训练侧重算每个 behavior checkpoint。SAO 的 Direct Double-Sided Importance Sampling(DIS)直接使用
并只保留双侧区间内的直接 ratio。它把 engine mismatch 与 policy lag 合并到一个可观测量里,省去 \(\pi_{\mathrm{old}}^{\mathrm{train}}\) 这层重算;交换来的代价是硬拒绝造成的偏差,以及 accepted token 可能随 staleness、长度和任务结构变化。
DIS 的目标几何与 PPO clipping、TIS、IcePop 的精确差异见 ratio、clipping 与 gate。SAO 还包含 critic、单轨迹调度和特殊 GAE 等组件,不能把整套方法缩写为 DIS。
Policy lag 不只看版本号
“落后 3 个 checkpoint”不是完整 staleness。一次更新的实际偏移还取决于:
- 每个 checkpoint 之间做了多少 optimizer step;
- batch 的任务和 reward 分布;
- learning rate、gradient norm 与 clipping;
- response 长度和经过的 action 数;
- rollout 生成期间 learner 是否继续更新;
- engine mismatch 是否与 policy update 同向叠加。
更可操作的量包括 sampled log-ratio 分布、per-token KL proxy、sequence ratio、accepted fraction 与 effective sample size:
ESS 必须说明 \(j\) 是 token、response 还是 trajectory;跨相关 token 计算出来的值不能直接解释成独立样本数。
最小轨迹契约
每条 rollout 至少保存:
model/checkpoint revision
rollout engine and numerical mode
sampling processors and their parameters
exact token ids, action mask and prefix boundary
behavior log-prob after the actual sampling transform
tokenizer, chat template and position convention
generation start/end time and learner revision on arrival
MoE route metadata when replay is required
terminal, truncation and infrastructure-failure status
进入 learner 后再记录:
current/old/reference revision
recomputed train-side old and current log-prob convention
update, engine and direct ratio quantiles
TIS cap or acceptance interval
kept-token fraction by length/reward/task slice
number of reuse epochs and optimizer steps
这份契约与语言模型作为策略、轨迹与策略契约及异步训练系统共同构成可复现边界。
一条排查顺序
- 固定同一 token ID 与 prefix,核对 tokenizer、template、position 与 action mask;
- 在同一精度和同一 kernel 下比较 rollout/train logits,建立理想基线;
- 逐项启用量化、并行、fused kernel、采样 processor 与 MoE routing;
- 分开画 \(c^{\mathrm{engine}}\)、\(r^{\mathrm{update}}\) 与 \(r^{\mathrm{direct}}\);
- 按长度、reward、任务、语言、route 和 checkpoint age 切片;
- 比较无校正、TIS、masked correction、route replay 与同步 rollout;
- 同时报告吞吐、拒绝率、ESS、训练 reward 和 held-out 能力。
若只有“加 correction 后不崩了”,尚不能判断修复的是 engine mismatch、policy lag,还是恰好丢掉了一批困难样本。
TIS、IcePop 与 DIS 的 detached coefficient 和退化断言见手撕 LLM 策略优化;实践页用于横向实验,本页的 policy 身份、ratio 分解与轨迹字段仍是实现入口。
GLM-5 的直接两策略校正
GLM-5 的异步 Agentic RL 省去单独的 \(\pi_{\mathrm{old}}\),直接保存 rollout engine 当时产生每个 token 的 log-prob,并计算
只在
时保留该 token 的梯度,区间外设为零。它是 hard masking,不是把 ratio 截到 PPO 边界。系统同时用最旧 rollout revision 与当前 revision 的距离删除过期轨迹,因此 token mismatch 和 trajectory staleness 是两层不同过滤。
这套方法接受一个明确近似:action ratio 修正已经访问的 \(s_t\),却无法恢复当前策略本会访问而旧策略没有访问的状态。报告还在推理权重刷新后重置 optimizer,但没有给出该选择的单独消融。公式、stop-gradient 歧义与数据接受率审计见 slime 与异步 Agentic RL。
Reference
- Schulman et al., Proximal Policy Optimization Algorithms
- Yao et al., On the Rollout-Training Mismatch in Modern RL Systems
- Qwen Team, Stabilizing Reinforcement Learning with LLMs: Formulation and Practices
- Ling Team, Every Step Evolves: Scaling Reinforcement Learning for Trillion-Scale Thinking Model
- Ma et al., Stabilizing MoE Reinforcement Learning by Aligning Training and Inference Routers
- Hou et al., Single-Rollout Asynchronous Optimization for Agentic Reinforcement Learning
- GLM-5: from Vibe Coding to Agentic Engineering