Kimi-VL:原生分辨率、稀疏语言主干与长视觉上下文
2025 年春,Kimi-VL 把当时常被分开处理的四件事放进同一个公开模型: native-resolution image、16B total / 2.8B activated 的 MoE language decoder、128K text-video context, 以及经 long-CoT SFT 与 RL 激活的视觉推理。它既是一个独立的高效 VLM,也是 Kimi K2.5 与 Kimi K3 之前,Kimi 家族视觉路线最清楚的一次公开展开。
这页关注的不是“能不能看图”,而是视觉信息怎样经过四个接口:
variable-resolution pixels
  -> MoonViT patch packing
  -> 2x2 spatial merge + MLP projector
  -> MoE language token space
  -> joint pretraining / long context / reasoning RL
任何一个接口都可能成为瓶颈:resize 会损失小字,视觉 token 太多会挤占 context,projector 可能形成 模态鸿沟,语言主干又可能在 joint training 中遗忘文本能力。
公开对象与规模口径
官方技术报告 描述 Base、Instruct 与 Thinking 路线;官方仓库发布 A3B Instruct / Thinking 权重和 inference code, 代码仓库使用 MIT License。 模型主体为:
| component | 公开规格 |
|---|---|
| vision encoder | MoonViT,约 400M |
| bridge | 2×2 pixel shuffle + two-layer MLP |
| language decoder | Moonlight MoE,16B total / 2.8B activated |
| loaded LM state | 已见 5.2T pure-text token,8K context |
| multimodal training after load | 4.4T token,含 2.1T vision-tower stage 与 2.3T joint stages |
| final context | 128K |
| inputs | single / multi-image、video、long document、text |
| post-training | joint SFT;Thinking 另有 long-CoT SFT + online RL |
这里最容易误读的是 4.4T:其中 2.0T + 0.1T 用于 ViT training / alignment,不都更新 16B language model;真正 joint update 的 pretraining、cooldown 与 long-context 三阶段合计 \(1.4+0.6+0.3=2.3\)T。语言主干在接入视觉前又已经见过 5.2T pure-text token。三种分母必须分列。
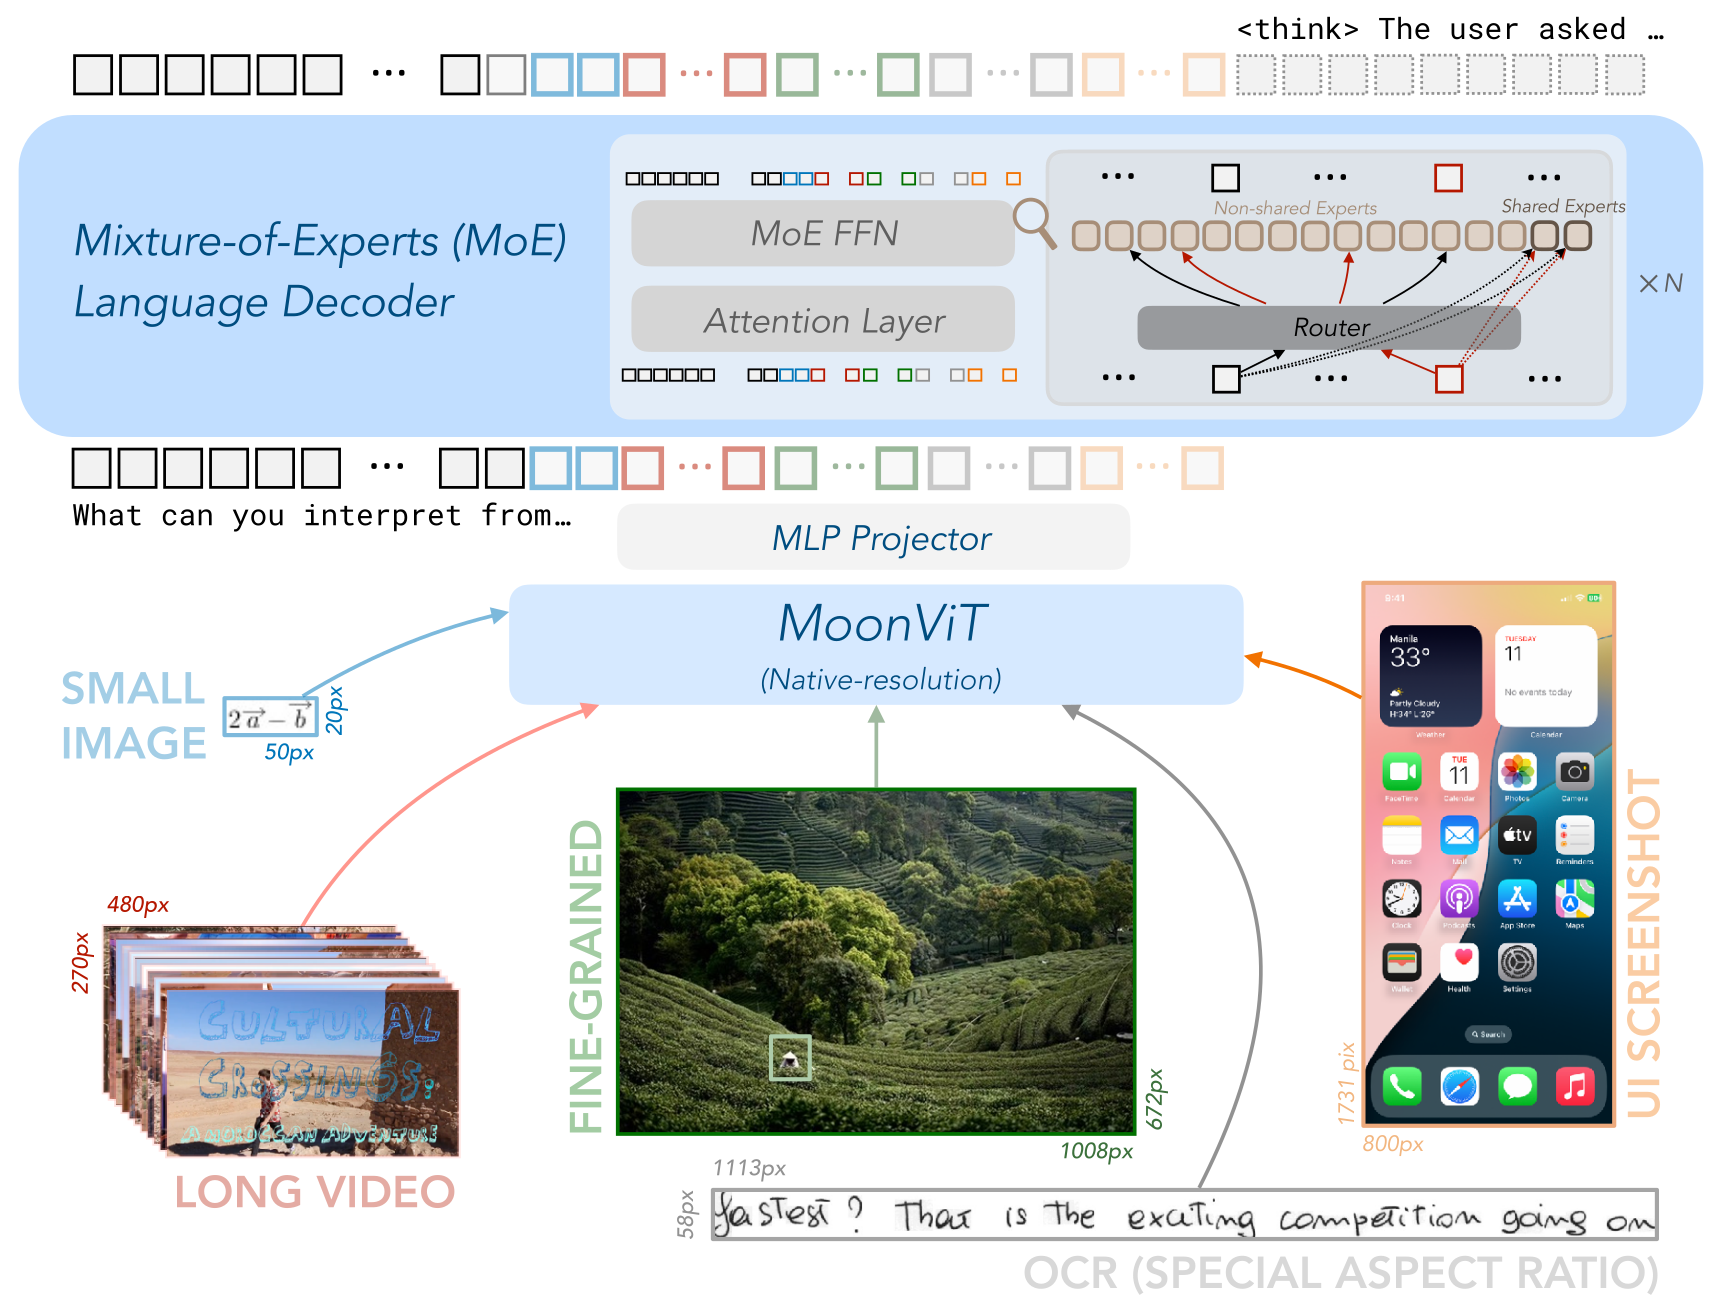
MoonViT:先保留几何,再把图片排成序列
固定分辨率 ViT 往往把所有图片 resize 到同一正方形。对自然图像尚可接受,对细长网页、密集表格和 高分辨率文档却会造成形变或小字消失。另一条路线是把大图切成多个 crop,再额外维护 crop order 与 全局缩略图。
MoonViT 选择 NaViT-style packing:
- 每张图按自身 \(H\times W\) 划分 \(P\times P\) patch;
- patch 按二维顺序 flatten 成变长序列;
- 多张图的序列在 batch 内 concatenate;
- 用 cumulative sequence lengths 隔开样本,让 variable-length FlashAttention 不跨图 attention。
对第 \(n\) 张图,若输入在进入 encoder 前补齐到 patch multiple,视觉 token 数为
这保留 aspect ratio,却没有让计算免费:attention 仍随同图 patch 数近似二次增长,超高分辨率图片 必须受 total patch budget 约束。
下面的 PyTorch reference 只演示 packing contract:输出连续 patch tensor、每张图的二维坐标与
cu_seqlens。真实 MoonViT 还要做 normalization、position interpolation、2D RoPE、padding 与
FlashAttention kernel 调用。
import torch

def patchify(image, patch):
    channels, height, width = image.shape
    assert height % patch == 0 and width % patch == 0
    grid_h, grid_w = height // patch, width // patch
    patches = image.unfold(1, patch, patch).unfold(2, patch, patch)
    patches = patches.permute(1, 2, 0, 3, 4).reshape(grid_h * grid_w, -1)
    y, x = torch.meshgrid(torch.arange(grid_h), torch.arange(grid_w), indexing="ij")
    coordinates = torch.stack((y.flatten(), x.flatten()), dim=-1)
    return patches, coordinates

def pack_images(images, patch):
    sequences, coordinates, cu_seqlens = [], [], [0]
    for image in images:
        tokens, coords = patchify(image, patch)
        sequences.append(tokens)
        coordinates.append(coords)
        cu_seqlens.append(cu_seqlens[-1] + len(tokens))
    return torch.cat(sequences), torch.cat(coordinates), torch.tensor(cu_seqlens)

images = [torch.arange(3 * 4 * 6).reshape(3, 4, 6), torch.zeros(3, 2, 4)]
tokens, coords, cu = pack_images(images, patch=2)
assert tokens.shape == (8, 12) and coords.shape == (8, 2)
assert cu.tolist() == [0, 6, 8]
assert coords[5].tolist() == [1, 2] and coords[6].tolist() == [0, 0]
两套 position signal 为什么并存
MoonViT 从 SigLIP-SO-400M 初始化。原 checkpoint 已学到 fixed absolute positional embedding;直接 丢弃会浪费已有视觉表征,但只做 interpolation 又难以稳定外推到未见过的分辨率。因此报告保留并插值 absolute embedding,同时在 height / width 两个轴加入 2D RoPE。
若一个 patch 坐标为 \((u,v)\),可把通道拆成两组:
absolute embedding 提供继承自 SigLIP 的全局位置先验,2D RoPE 提供相对几何与分辨率外推。二者并存 不是重复装饰,而是“保留初始化能力”和“适应动态网格”的折中。
Projector:先压缩空间,再对齐语言维度
MoonViT 输出 shape 可写成
projector 先把相邻 \(2\times2\) patch 沿 channel 合并:
视觉 sequence length 因而降为原来的四分之一;随后 two-layer MLP 投影到 language embedding dimension \(d_{\mathrm{lm}}\)。报告把这一操作称为 pixel shuffle,语义上更接近 space-to-depth: 没有丢掉四个 patch 的 feature,只是把空间位置换到 channel 后再压缩。
这一步的优势是显著减少进入 128K context 的视觉 token;代价是后续语言模型看到的是局部合并后的 表示,极细粒度定位需要 projector 保留足够空间结构。对 OCR、GUI grounding 与小目标,评测必须记录 原始分辨率、patch budget 和合并后的 token 数,不能只写“native resolution”。
MoE decoder:视觉效率不只由 vision tower 决定
Kimi-VL 的语言侧来自 Moonlight:16B total、每 token 激活约 2.8B 的 MoE,结构与 DeepSeek-V3 系 稀疏模型相近。视觉 token 进入 shared embedding space 后,与文本 token 一起经过 causal decoder。
这带来两类效率:
- conditional FFN 让总容量大于每 token 的 activated compute;
- 2×2 merge 先减少视觉 sequence length,再降低 attention 与 MoE token traffic。
但“A3B”不是整模型显存只等于 3B dense:部署仍需持有或分片 16B language weights、400M vision tower、router 与 KV cache;专家通信和长 context attention 也不会按 activated parameter 比例消失。
四阶段预训练:先建视觉词典,再共同写长上下文
Kimi-VL 在已见 5.2T text token 的 Moonlight intermediate checkpoint 上继续四个阶段;第一阶段包含两个 记账子步骤,因此下表列出五行:
| stage / accounting row | tokens | context | data / trainable components |
|---|---|---|---|
| ViT CoCa-like training | 2.0T | 8K | image-text;训练 vision encoders / tiny decoder |
| ViT-to-LLM alignment | 0.1T | 8K | 只更新 MoonViT 与 projector |
| joint pretraining | 1.4T | 8K | text + 最多 40% multimodal;ViT + LLM |
| joint cooldown | 0.6T | 8K | 高质量 text / multimodal;ViT + LLM |
| joint long-context | 0.3T | 32K→128K | long text / video / document;ViT + LLM |
ViT stage:contrastive 与 captioning 互补
vision tower 的目标为
SigLIP loss 让 paired image / text embedding 对齐;caption cross-entropy 迫使视觉表示保留能支持 token prediction 的细节。报告先用 SigLIP-SO-400M 初始化 image/text encoder,并以小型 decoder 训练 2.0T token,再用 0.1T token 只调 MoonViT + projector,让其输出在冻结 MoE LLM 下具有较低 初始 perplexity。
这 2.1T 是 vision-stage token accounting,不应与“LLM 又预训练了 2.1T”画等号。
Joint pretraining:逐步提高 multimodal ratio
1.4T joint stage 先从 pure text 开始,再逐步把 multimodal ratio 提到最多 40%。text 数据从原 language distribution replay,视觉数据覆盖 caption、interleaving、OCR、knowledge、video 与 agent。 渐进 mixture 同时降低 projector cold start 和 catastrophic forgetting 风险。
multimodal ratio 只有连同 reduction 才有意义。若视觉样本平均 sequence 更长,40% sample ratio、 40% token ratio 与 40% loss weight 会产生完全不同的梯度。报告给出 token / data 级总体口径,没有 公开逐源 sequence-length distribution。
Cooldown:高质量 QA 只占低比例
0.6T cooldown 同时回放高保真文本与多模态数据。数学、知识、代码和视觉学术材料会被筛选、重写为 QA,并经 rejection sampling 验证;报告刻意把 QA pattern 保持在较低比例,避免模型只适应问答格式。
这与 pretraining rephrasing 的原则一致:synthetic data 用来提高已有知识的可学习性,不能替代 真实世界覆盖,也需要验证 factuality、layout 与 image-text correspondence。
128K 激活:长视频不是把 frame 全部塞进去
最后 0.3T token 分两步把 context 从 8K 扩到 32K,再扩到 128K;每步都是 \(4\times\)。RoPE base 从 50,000 调到 800,000。每个 substage 使用 25% long data 和 75% 前一阶段短数据 replay,以同时保留 short-context ability。
long data 不只有文本,还包括 long interleaved document、video 与 multi-page document。若一段视频 采样 \(F\) 帧,每帧平均 \(L_v\) 个 patch,2×2 merge 后的视觉长度近似
因此 128K 是多模态 token budget,不是可无损容纳任意小时数视频。frame sampling、resolution、 temporal coverage 与文本 prompt 会争用同一个 context。
报告的 NIAH 表在 65,536 token 以内对 text / video 都为 100%,在 65,536–131,072 区间分别为 87.0% / 91.7%。这证明作者 synthetic retrieval setup 内的 needle recall,不等于长视频推理、 跨镜头因果或完整文档理解。NIAH 需要与真实任务共同阅读。
数据不是一袋“图文对”
报告把多模态 pretraining data 分成六类,每类解决不同的接口:
| data family | 主要学习内容 | 典型失败 |
|---|---|---|
| caption | 基础 image-text alignment 与视觉知识 | synthetic caption 幻觉 |
| interleaving | 多图关系、网页 / 教材顺序、长 context | 图文顺序错位 |
| OCR | dense text、手写、表格、公式、multi-page | 只读字不理解 layout |
| knowledge | 教材、论文、diagram 与学科视觉知识 | infographic 被退化为 OCR |
| video | long-range coverage 与短时空感知 | sparse frame 漏掉瞬时事件 |
| agent | screenshot grounding、action、multi-step GUI | action space / OS 偏置 |
interleaving data 特别依赖顺序:网页中的图片若与前后段落错配,模型学到的是错误 cross-modal reference。OCR 数据则加入 rotation、distortion、color 与 noise augmentation;multi-page OCR 的目标 不只是字符识别,还要在整本扫描材料中建立上下文。
GUI agent 数据来自 Desktop、Mobile 与 Web action spaces,包含 screenshot-action、dense grounding 和带 reasoning 的 multi-step trajectory。模型在真实桌面上的成功率仍取决于坐标规范、窗口尺寸、 权限、observation freshness 与执行器,不能由静态 grounding benchmark 代替。
Post-training:Instruct 与 Thinking 是两条能力层
joint SFT 同时更新 vision encoder、projector 与 language model,混合 pure text 和 vision-language instruction。system / user prompt 被 mask,只监督 assistant answer 与 special tokens;先在 32K 训练 一 epoch,再在 128K 训练一 epoch,中间重新 warm up learning rate。
Kimi-VL-Thinking 随后加入:
- 小而高质量的 multimodal long-CoT SFT,激活 planning、evaluation、reflection 与 exploration;
- 以 Kimi k1.5 同类 KL-regularized online policy mirror descent 做 RL;
- length reward、curriculum sampling 与按实例成功率的 prioritized sampling。
目标为
每轮把当前 policy 作为下一轮 reference。部署时仍是普通 autoregressive generation;“thinking”表示 policy 学会在 token history 中执行较长探索,不表示 inference server 显式运行一棵搜索树。
报告的 test-time scaling 曲线也提醒,更多 thinking token 不总有收益:MathVision 从 1K 到 16K 持续改善,MathVista 约 4K 后趋于饱和。合理策略应按 task / uncertainty 分配预算,而不是所有请求都 固定生成最长 CoT。
四维并行怎样接住视觉长序列
Kimi-VL 训练结合 Data、Expert、Pipeline 与 Context Parallelism:
- DP 扩大 batch;
- EP 分布 MoE experts,并让不同 DP group 的 token 共同填充本卡 experts;
- PP 把 vision tower 与部分 decoder layer 放在首 stage,按实测时间而非层数均分;
- CP 沿 sequence 切分长 text / visual tokens,并配合 FlashAttention。
ZeRO-1 分片 optimizer state,selective activation checkpointing 对低计算、高显存算子重算。极长 sequence 时扩大 recomputation 范围。报告称其优化后 training throughput 比一个 7B dense VLM 高约 60%;该数字依赖作者 cluster、batch、input mixture 与并行配置,不是 MoE 的普适速度比。
视觉数据以原始格式保存在 S3-compatible object store,loader 在线完成 shuffle、mixture、tokenize、 loss mask、packing 与 augmentation。几何 augmentation 必须同步更新 2D coordinates / orientation; 恢复训练则要持久化 random state 与 worker state,确保 interruption 后的数据序列与未中断 run 一致。
评测应该问“哪种视觉负载”
报告覆盖 college-level VQA、general perception、multi-image、math、OCR、OS agent、long document、 long video 与 video perception。如此宽的表格适合确认能力面,却不适合用一个平均分替代诊断。
至少应分开:
- perception:小物体、文字、坐标和时空变化是否被 encoder 保留;
- retrieval:目标是否在长视觉 context 中被找到;
- reasoning:找到证据后是否完成数学、知识或因果推断;
- acting:grounding 是否转化为正确 GUI action;
- test-time compute:Thinking token、采样次数与工具是否一致。
每项复测还需记录 image preprocessing、最大 pixels / patches、多图顺序、video frame sampler、output cap、prompt template 与 scorer。作者在多个 benchmark 上报告的优势是其 protocol 下的 model-system 结果,不能只归因于 MoonViT 或 MoE 的某一个组件。
报告自己承认的上限
Kimi-VL 的 limitation 很具体:
- activated language capacity 只在约 3B 量级,专业知识与强语言依赖任务仍受限;
- complex multi-step reasoning 尚未触及上限;
- 虽有 128K window,attention capacity 与小模型相当,极长高密度 context 仍不充分。
除此之外,公开材料没有给出完整训练 corpus、逐源比例、dedup / contamination 结果、全部 optimizer 超参数、RL prompts 与 reward model。MIT 许可覆盖官方 repository 的代码许可面;第三方数据、模型 输入和权重使用仍应分别阅读对应条款,不能由一个仓库 license 替代全部 provenance。
Kimi-VL 之后:同一谱系的三次改写
| work | vision path | language / sequence path | 训练重点 |
|---|---|---|---|
| Kimi-VL | SigLIP-init MoonViT + 2D RoPE | 16B-A3B Moonlight,full attention | native resolution、128K、multimodal RL |
| K2.5 | MoonViT-3D,image/video fully shared | K2 1T MoE,256K | 约 15T joint training、zero-vision SFT、Agent Swarm |
| K3 | from-scratch MoonViT-V2 | KDA + Gated MLA + AttnRes + LatentMoE,1M | 三条信息流与原生视觉共同训练 |
三者共享 lineage,却不能互换 encoder 名称或训练结论。Kimi-VL 证明的是一套高效、开放的 native-resolution VLM 配方;K2.5 把它放大并扩到视频 / parallel agents;K3 又改变了视觉初始化与 backbone。沿完整分叉关系可回到 Kimi 多模态家族与 Kimi 技术谱系。
Reference
- Kimi-VL: Mixture-of-Experts Vision-Language Model for Multimodal Reasoning
- Moonshot AI Kimi-VL official technical report, pinned revision
- Moonshot AI Kimi-VL official repository and checkpoints
- Patch n' Pack: NaViT, a Vision Transformer for Any Aspect Ratio and Resolution
- Sigmoid Loss for Language Image Pre-Training
- CoCa: Contrastive Captioners are Image-Text Foundation Models
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- Muon is Scalable for LLM Training