量化:格式、误差与真实执行路径
量化用更少 bit 表示权重、activation 或 KV Cache。它可以降低模型驻留、HBM 读取和通信量,也可能增加 scale 元数据、反量化、校准和专用 kernel。一个“4-bit checkpoint”只有存储意义;只有执行路径真正使用低比特矩阵乘或减少关键路径字节时,才可能带来延迟收益。
基本映射
对 \(b\) bit 仿射量化,给定实数范围 \([x_{\min},x_{\max}]\):
对称量化常固定 \(z=0\),scale 由绝对最大值决定:
量化误差为
减小 group size 通常提高局部拟合,却增加 scale / zero-point。若每组 \(g\) 个值,scale 和 zero-point 分别占 \(b_s\)、\(b_z\) bit,则有效位宽近似为
总内存应按
计算,而不是只用 \(Nb/8\)。
对称 groupwise reference
下面沿最后一维分组,用每组绝对最大值计算对称 scale。最后一维长度必须整除 group_size;输出依次是整数码、每组 scale 和反量化张量。全零 group 使用安全除数,但保存的 scale 仍为零。
import torch

def symmetric_groupwise_quantize(x, bits, group_size):
    if x.ndim == 0 or group_size <= 0 or x.shape[-1] % group_size or not 2 <= bits <= 8:
        raise ValueError("bits and group size must validly tile the last dimension")
    qmax = 2 ** (bits - 1) - 1
    groups = x.reshape(*x.shape[:-1], -1, group_size)
    scale = groups.abs().amax(dim=-1, keepdim=True) / qmax
    divisor = torch.where(scale > 0, scale, torch.ones_like(scale))
    code = torch.round(groups / divisor).clamp(-qmax, qmax)
    dequantized = code * scale
    return code.to(torch.int8).view_as(x), scale, dequantized.view_as(x)

x = torch.tensor([[0., -1., 0.5, 0.25], [3., -2., 1., 0.]])
code, scale, restored = symmetric_groupwise_quantize(x, bits=4, group_size=4)
assert code.min() >= -7 and code.max() <= 7
error = (x - restored).abs().reshape(*scale.shape[:-1], 4)
assert torch.all(error <= scale / 2 + 1e-6)
zero_code, zero_scale, zero = symmetric_groupwise_quantize(torch.zeros(4), 4, 4)
assert torch.equal(zero_code, torch.zeros(4, dtype=torch.int8))
assert zero_scale.item() == 0 and torch.equal(zero, torch.zeros(4))
try:
    symmetric_groupwise_quantize(torch.ones(2, 3), 4, 2)
except ValueError:
    pass
else:
    raise AssertionError("groups cannot cross rows")
scale 的 axis、尾 group 与零值语义在这里都是可测试契约。reference 没有 bit packing、zero-point、outlier 通道或低比特 GEMM;生产收益只有在目标 kernel 直接消费这套码值与 metadata 时成立,不能用反量化后的数值正确性替代执行路径验证。含 scale metadata 与误差断言的更多实验见手撕:推理引擎。
四个独立维度
量化方案至少要分别声明:
- 对象:weight、activation、KV、embedding 或通信 tensor;
- 格式:INT、FP8、FP4 或其他编码;
- 粒度:per-tensor、per-channel、per-token、per-group、block;
- 执行:存储 dtype、输入 dtype、乘法 dtype、accumulator dtype 与输出 dtype。
常见部署语义:
| 记法 | 权重 | Activation | 典型目标 |
|---|---|---|---|
| W8A16 | 8 bit | FP16 / BF16 | 降低权重读取 |
| W4A16 | 4 bit | FP16 / BF16 | 大幅减小驻留与 decode 带宽 |
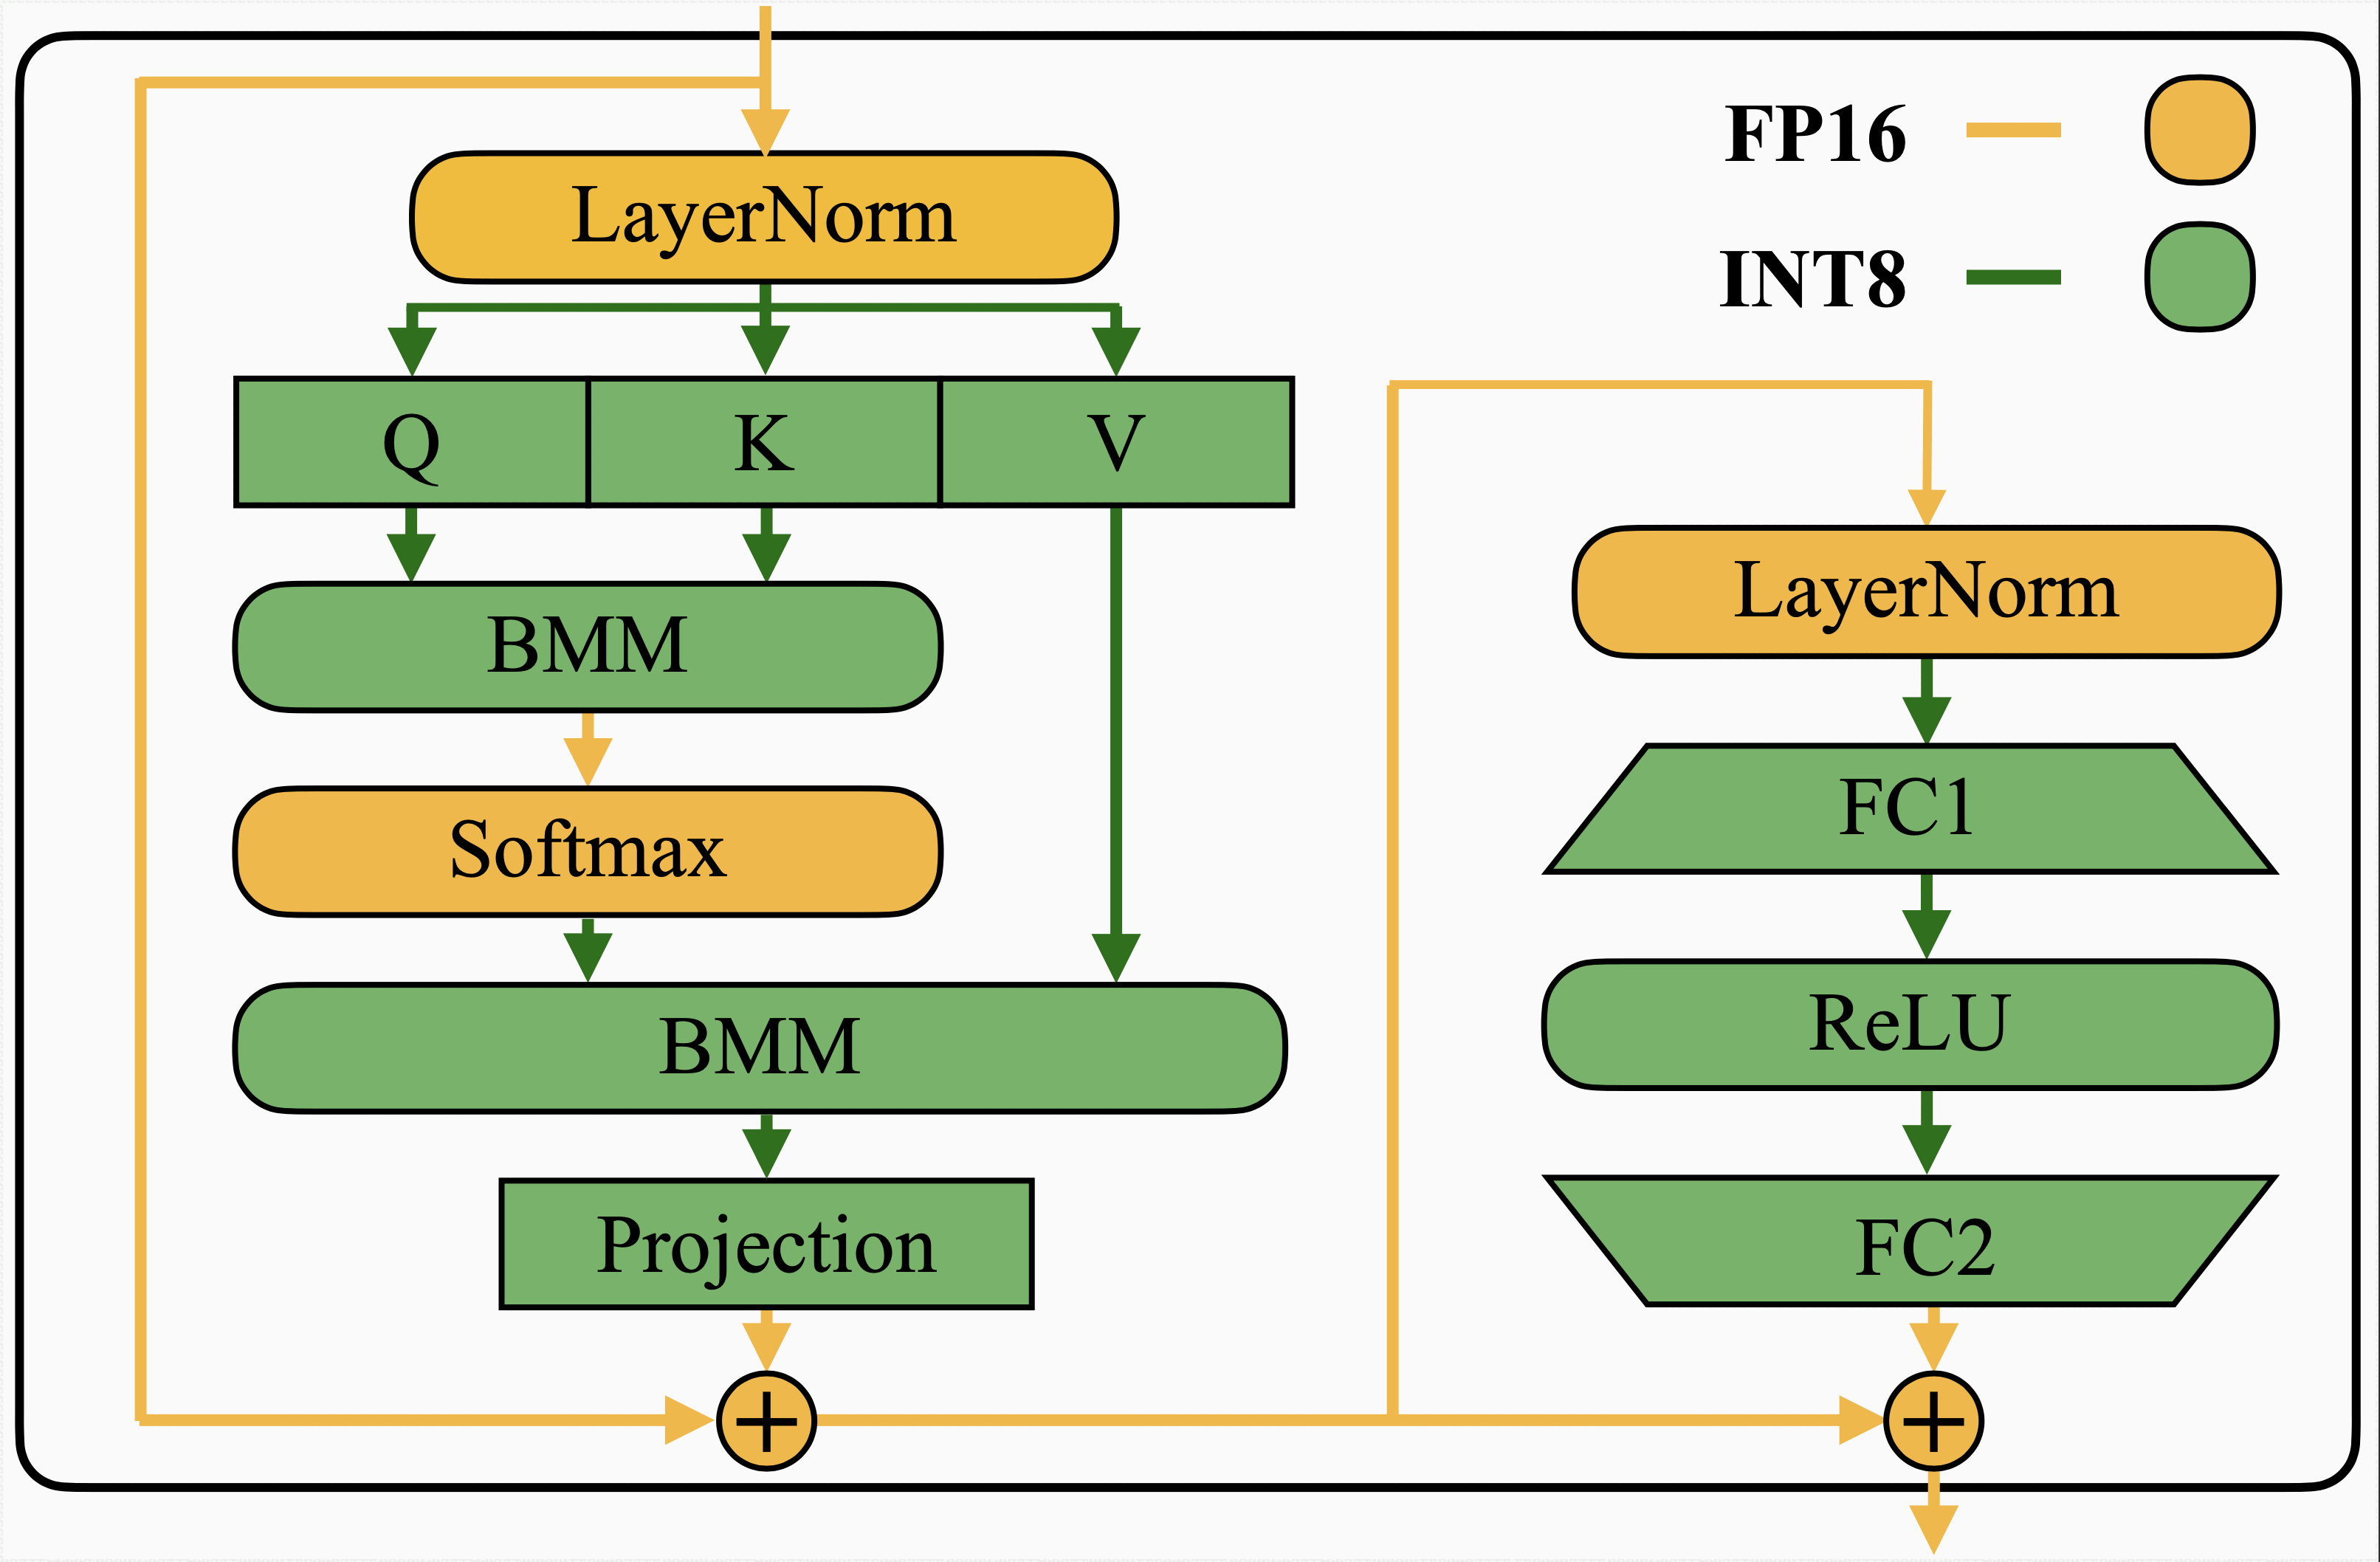
| W8A8 | 8 bit | 8 bit | 同时加速权重和 activation 路径 |
| W4A8 | 4 bit | 8 bit | 更激进的低比特 GEMM |
| FP8 | FP8 | FP8 或混合 | 利用浮点动态范围和硬件矩阵单元 |
| FP4 / 混合 FP4 | FP4 | FP4 / FP8 / BF16 | 高压缩,强依赖 scaling 与硬件 |
这些缩写不能说明 group size、outlier、scale 格式或 accumulator,必须展开完整配置。
Weight-only
decode 常反复读取全部权重,weight-only 量化因此可能直接降低 HBM 流量。prefill 是否加速取决于低比特 GEMM 的实际吞吐;若 kernel 先把整块权重反量化到高精度并写回 HBM,收益会显著减小。
它们的论文结果依赖模型、group、校准数据和实现。选择时应先问目标硬件是否有对应 kernel,再比较相同模型、相同数据和相同质量门槛。
Weight–Activation
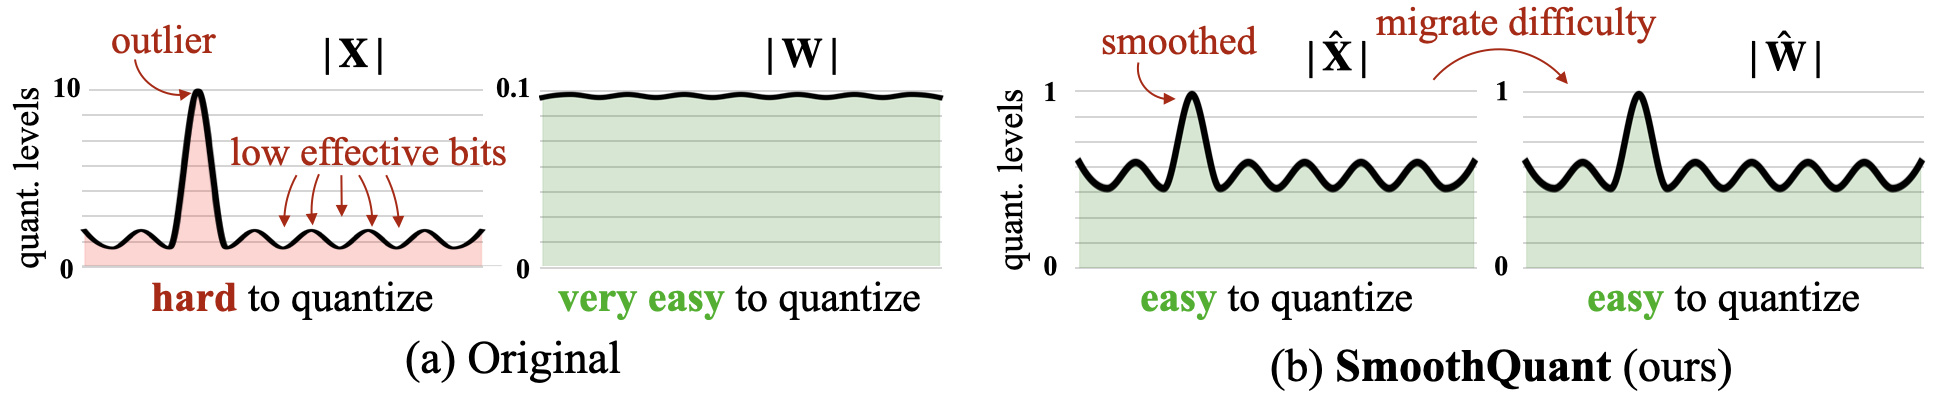
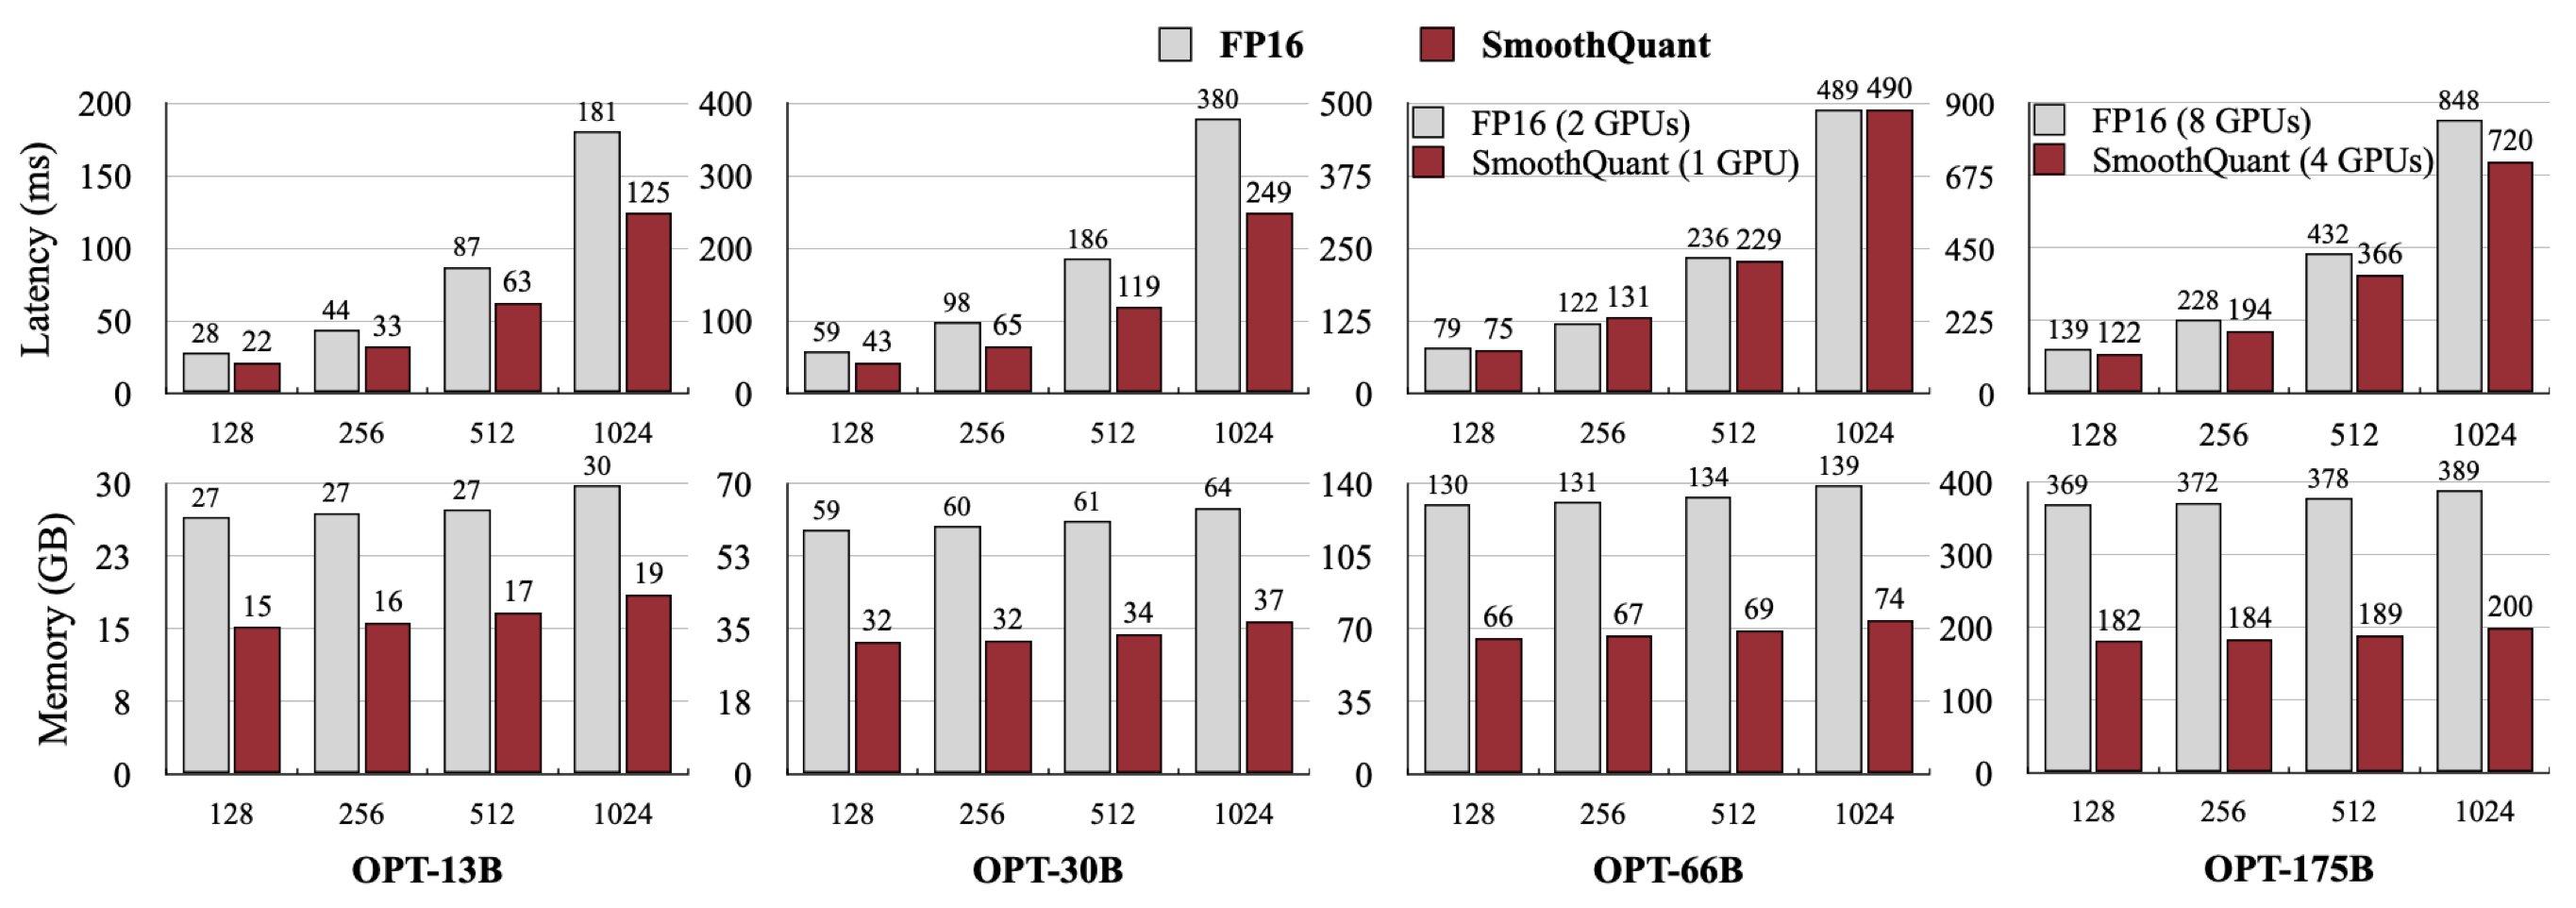
activation 的 outlier 会让低比特范围被少数极值主导。LLM.int8() 把异常维度保留为高精度路径;SmoothQuant 利用离线等价缩放把量化难度从 activation 迁移到 weight。
对线性层 \(Y=XW\),引入逐通道正数 \(\alpha\):
实数运算中两者等价,但新的 \(X\) 与 \(W\) 范围不同,量化误差也随之改变。实现必须把缩放融合进相邻算子或权重,避免新增关键路径 kernel。
FP8、MXFP8 与 FP4
FP8 不是一种单一格式。E4M3 与 E5M2 在精度和动态范围间取舍,scale 还可能使用 delayed、current 或 block scaling。NVIDIA Transformer Engine 的 FP8 说明区分了格式与 scaling recipe。
截至 2026-07,较新的硬件专用路径还包括:
它们属于活跃演进的软件与硬件接口。页面中的 bit、tile、scale 和支持矩阵必须随明确的软件版本与设备更新,不能把某一代 GPU 的结果外推到其他平台。
从 SFT 延续到 RL 的 QAT
部署量化若只在训练结束后转换,rollout policy 看到的分布可能与 learner 计算梯度时不同。Quantization-Aware Training(QAT)可以从 SFT 开始模拟或直接执行目标低精度路径,并在在线 RL 中继续保持相同 format,使 rollout、old log-prob 重算与 learner 尽量处在同一数值语义下。
Kimi K3 技术报告给出一个 MoE 实例:routed expert 权重采用 MXFP4、expert 输入采用 MXFP8,非 expert 路径保持较高精度,QAT 从 SFT 延续到 RL,rollout 与 trainer 使用同一方案。通用设计要点是按参数族声明格式,而不是把模型统称为“FP4”:
tensor family and layer scope
storage / compute / accumulator formats
block and scale layout
fake-quant or native low-bit operator
forward, backward and optimizer behavior
rollout/trainer kernel revision
high-precision exceptions and fallback counters
低精度路径仍可能因硬件、kernel 或 graph shape 回退。若 rollout 与 learner 的实际 fallback 比例不同,就应把差异视为 behavior-policy mismatch,而不是普通数值噪声。K3 的完整后训练与部署组合见 Kimi K3。
DeepSeek-V4:expert 与 indexer 两条 FP4 路径
DeepSeek-V4 把 MXFP4 QAT 同时用于:
- MoE expert weights:FP32 master weight 先量化为 FP4,再解量化成 FP8 复用既有训练 kernel;
- CSA Lightning Indexer 的 Q/K:cache、载入和 score matmul 都走 FP4;
- index score 从 FP32 降到 BF16:报告称 top-\(k\) selector 加速 \(2\times\),KV 选择 recall 为 99.7%。
作者称在当前权重满足 scale-ratio 条件时,FP4 子块 scale 可以被 FP8 E4M3 更大的指数范围完整吸收,因此 FP4→FP8 dequantization 无额外信息损失。这个“lossless”只指给定 scale 布局下的格式转换,不表示 FP32→FP4 量化无损;报告也没有公开那个 scale-ratio 阈值。
backward 对 forward 中的 FP8 模拟权重求梯度,并以 STE 传回 FP32 master;rollout 与在线服务则直接用 native FP4,使 behavior path 看见实际部署误差。teacher 与 reference model 也进入同一 QAT 边界,避免 full-vocabulary OPD 比较的是另一套数值策略。
KV Cache 量化
KV 量化降低长上下文的容量和 decode 读取量,但误差会在每一层、每个后续 token 中被反复使用。key 与 value 的统计性质可能不同:
- key 的通道可能有稳定 outlier;
- value 的 token 间范围可能差异更大;
- RoPE 前后的 key 分布不同;
- residual window 可以让最近 token 保留高精度。
KIVI 采用 key per-channel、value per-token 的非对称设计;KVQuant 研究逐通道和 pre-RoPE key 等选择。它们是近似方法,必须验证长上下文质量、cache kernel 和 metadata,而不能只看节省比例。
Kernel 决定实际收益
对一次线性层,粗略时间可写为
低 bit 只减小其中部分项。真实 kernel 还受以下因素影响:
- \(M,N,K\) 是否对齐低比特 tile;
- group scale 能否向量化读取;
- dequant 是否融合到 GEMM;
- zero-point、outlier 与 permutation 是否增加分支;
- TP / EP 是否把 GEMM 切得过小;
- graph capture 和 workspace 是否稳定;
- 不支持的 shape 是否回退到高精度。
vLLM 的量化支持文档展示了运行时格式与硬件支持是独立矩阵。它适合核对当前实现能力,不应代替方法原论文和本地基准。
校准与转换
校准集应覆盖真实域、语言、长度、模板、工具调用和多模态输入。只用少量随机文本可能看不见 activation outlier 和长上下文误差。转换产物至少记录:
source weight identity
quantization algorithm and implementation version
bit format, signedness and packing
scale / zero-point axis and group size
calibration dataset identity and preprocessing
excluded layers and outlier policy
KV format and residual-window policy
expected kernel and supported hardware
量化不是不可追溯的文件压缩;这些元数据决定能否正确加载和复现。
正确性契约
- pack / unpack 与 scale layout 有一一对应定义;
- padding bit 和尾 group 不会被当作有效权重;
- accumulator 精度足以覆盖 reduction 范围;
- scale 为零、全零 group、NaN / Inf 和极端 outlier 有明确定义;
- graph / distributed path 不会误用另一种 quant schema;
- checkpoint 声明的 kernel 不可用时,fallback 明确且可观测;
- KV 量化的 scale 随 block 生命周期一起复制、迁移和回收;
- 近似误差由任务质量门槛约束,而不是仅凭 tensor MSE。
常见失效
- 文件缩小但 latency 不变:运行路径反量化到 FP16 GEMM;
- prefill 变慢、decode 变快:低比特小 batch 有利,大 GEMM kernel 不成熟;
- 短评测无损,长上下文崩溃:KV 误差或 position 区间未覆盖;
- 平均质量稳定,结构化输出退化:边界 token 的 logit 排名变化;
- 某些 batch 突然变慢:shape fallback 或 graph bucket 缺失;
- 跨卡结果不同:scale、packing 或 collective dtype 不一致;
- 显存节省低于预期:metadata、padding、workspace 和高精度残留未计入。
何时不用
- 目标硬件没有稳定的对应 kernel;
- 权重已不是关键路径,瓶颈在 KV、队列或网络;
- 模型很小且低并发,反量化固定开销占主导;
- 缺少代表性校准和任务质量集;
- 极端长上下文、代码精确性或结构化输出无法通过回归;
- 频繁切换格式会破坏 graph、cache 和部署可维护性。
验证
验证分四层:
- 表示:pack / unpack、scale、尾 group 与极端值;
- 算子:linear、attention、KV read 与高精度 reference 比较;
- 模型:perplexity、任务质量、长上下文、代码和结构化输出;
- 系统:真实 shape 下的 TTFT、TPOT、goodput、峰值显存、功耗和成本。
报告必须包含硬件、模型、格式、group、calibration、kernel、batch / 长度分布、warmup、fallback 比例与质量门槛。只给“INT4 比 FP16 快多少”没有可迁移性。
数值表示的基础边界见精度与数值,把压缩收益放回请求分布与硬件关键路径的方法见推理基准与可靠性。
GLM-5 的异构 W4A8/W8A8 部署
GLM-5 在 Ascend Atlas 案例中按模块分配精度:常规 attention 与 MLP 使用 W8A8,体量最大的 MoE experts 使用 W4A8;QuaRot 用正交旋转削弱 outlier,Flex_AWQ_SSZ 用于 scale calibration。芯片章节的工程目标是让约 750B 参数、每 token 约 40B 激活参数的模型装入单台 Atlas 800T A3。架构表的 744B 排除了 embedding 与 output layer,公开权重索引约 753.864B;三者的计数边界见 GLM-5 模型账本。
这种“标准块保精度、专家块压权重”的策略利用了 MoE 权重容量远大于单 token 激活路径,但它不自动保证 expert routing、稀有领域和长尾 token 不受损。复现报告至少要补齐 calibration corpus、group/scale 粒度、router 与 expert 分层误差、长上下文回归和每个 fallback kernel 的比例。
报告的 \(50\%\) 长序列部署成本降幅缺少完整硬件对照、并发、输入输出长度和服务目标,只能作为团队测量。量化与 Lightning Indexer、Sparse Flash Attention、MLAPO 及运行时调度的组合见 GLM Agentic Engineering。
Reference
- GPTQ
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration
- SpQR
- AQLM
- LLM.int8()
- SmoothQuant
- NVIDIA Transformer Engine 的 FP8 说明
- MXFP8
- NVFP4
- Kimi K3 Technical Report
- OCP Microscaling Formats
- DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
- QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs
- GLM-5: from Vibe Coding to Agentic Engineering