多模态数据、训练与系统
多模态模型的能力不是由一张架构图单独决定的。图文如何配对、视频怎样采帧、音频如何切块、不同样本怎样混合和打包,会一路改变 loss、梯度、显存、通信和最终评测。
一条完整的数据路径是:
只报告“用了多少图文对”无法重建这条路径。样本数、媒体时长、token 数、loss 权重与计算量是五种不同分母。
数据单位先于数据规模
多模态数据至少有四种层次:
| 层次 | 例子 | 必须保存的关系 |
|---|---|---|
| Asset | 图片、PDF、音频、视频、机器人 observation | 来源、版本、hash、解码参数 |
| Relation | caption–image、字幕–片段、动作–观测 | 配对范围、时间或空间对齐、置信度 |
| Example | 一轮问答、交错文档、trajectory | 输入输出角色、工具和目标 |
| Sequence | tokenized/packed 样本 | 边界、位置、attention/loss mask |
同一张图可以有多个 caption,同一视频可以切出多个片段,同一机器人轨迹也可以生成多个训练窗口。若 train/test split 在派生 example 之后才做,同一原始 asset 可能跨集合泄漏。
因此 provenance 应绑定原始对象,而不是只绑定最终 JSON 行。至少记录:
source and retrieval revision
asset digest and license surface
decoder and preprocessing version
relation or annotation provenance
split group
derived example recipe
tokenizer / processor revision
从弱配对到交错序列
CLIP 与 ALIGN 证明了大规模网页图文弱配对可以形成可迁移表示,也同时暴露了噪声、重复与 batch negatives 对目标的影响。
图文 pair 只描述一个局部关系。网页、教材和长文档还包含:
- 图片与前后段落的引用;
- 多图的顺序和比较;
- caption、图注、表格与正文的层级;
- 跨页实体和章节结构。
Flamingo 使用交错图文语料训练 few-shot 多模态模型;Multimodal C4 进一步系统化了从网页构建交错图文数据的过程。提取时若把 DOM 顺序、图注或重复导航文字处理错,模型学到的不是“长上下文”,而是稳定的错误邻接。
视觉指令数据又改变了监督形式。LLaVA 展示了利用语言模型辅助构造视觉指令数据的路线。合成问题和回答可以扩大格式与推理覆盖,却不能恢复图像中本来没有的证据;生成器的事实错误、回答风格和拒答习惯也会被学生继承。
统一模型进一步要求数据本身携带任务协议。Chameleon 的混合模态自回归序列需要可靠的媒体边界与离散 token;Qwen2.5-Omni 的流式音视频输入还需要真实时间对齐。两者都说明“把资产放进同一个样本”远远不够,sequence layout、position、mask 与输出目标也是数据的一部分。
数据族对应不同能力
一个完整 mixture 通常包含:
| 数据族 | 主要作用 | 典型风险 |
|---|---|---|
| image–text pair | 全局语义与检索 | 弱对应、重复、文字捷径 |
| interleaved document | 多图关系与长上下文 | 顺序错位、跨页泄漏 |
| OCR/layout | 文字、表格、公式和坐标 | 识别正确但结构错误 |
| audio/speech | 内容、说话人、声学事件 | 转录遗漏、身份与许可 |
| video | 运动、顺序、长时事件 | 稀疏采样漏事件 |
| media generation | 可逆表示与条件生成 | 审美偏差、数据来源 |
| GUI/agent trajectory | 状态、动作与工具闭环 | 环境过期、权限与副作用 |
| robot trajectory | 观测、动作与动力学 | 时间、坐标、硬件不一致 |
| pure text replay | 保持语言能力 | 挤占媒体训练预算 |
“多模态比例 40%”只有连同采样单位才有意义。它可能表示 40% example、40% sequence、40% token、40% loss 或 40% compute,结论完全不同。
四种 mixture 权重
设模态或任务 \(m\) 的样本采样概率为 \(p_m\),平均有效 token 数为 \(\bar T_m\),loss 权重为 \(\lambda_m\),单 token 平均计算为 \(c_m\)。它对训练的四种占比近似为:
以及
这只是记账近似。attention 的成本依赖序列长度,vision/audio encoder 有独立计算,MoE routing 与动态 padding 也使 \(c_m\) 不恒定。但它足以说明:长视频样本概率很低,仍可能主导 token 和算力。
DataComp 在固定模型与训练预算下系统比较数据选择策略,强调数据质量不能脱离计算预算评估。多模态 mixture 也应采用同样的等预算思想,而不是只比较原始样本总量。
Loss reduction 是训练配方
把所有 token 直接求平均:
会让 token 更多的目标获得更大总影响。若希望各任务按显式权重贡献,可先在任务内部归一:
下面的 reference 固定“先按目标有效 token 求均值,再按显式权重组合”。复制相同媒体 token 不会仅因数量翻倍而改变该目标的平均值;缺失目标也不会用零值稀释其他目标。
import torch

def objective_balanced_loss(token_loss, objective, valid, weights):
    token_loss = torch.as_tensor(token_loss)
    objective = torch.as_tensor(objective, device=token_loss.device)
    valid = torch.as_tensor(valid, device=token_loss.device).bool()
    if token_loss.shape != objective.shape or token_loss.shape != valid.shape:
        raise ValueError("loss, objective and valid must have the same shape")
    total = token_loss.new_zeros((), dtype=torch.float32)
    stats = {}
    for kind, weight in weights.items():
        selected = valid & objective.eq(kind)
        if selected.any():
            mean = token_loss[selected].float().mean()
            total = total + float(weight) * mean
            stats[kind] = (int(selected.sum()), mean.detach())
    if not stats:
        raise ValueError("batch contains no supervised token")
    return total, stats

loss = torch.tensor([1., 3., 10., 10., 10.])
kind = torch.tensor([0, 0, 1, 1, 1])
valid = torch.ones(5, dtype=torch.bool)
total, stats = objective_balanced_loss(loss, kind, valid, {0: 1., 1: 1.})
torch.testing.assert_close(total, torch.tensor(12.))
duplicated = objective_balanced_loss(
    torch.tensor([1., 3., 10., 10., 10., 10., 10., 10.]),
    torch.tensor([0, 0, 1, 1, 1, 1, 1, 1]),
    torch.ones(8, dtype=torch.bool), {0: 1., 1: 1.},
)[0]
torch.testing.assert_close(duplicated, total)
这不是“自动平衡”算法。\(\lambda_m\) 仍决定容量分配;不同目标的 loss 单位、梯度尺度和学习速度也不相同。分布式训练还要先 all-reduce 每个目标的 numerator 与 denominator,不能平均各 rank 的局部均值。
课程学习解决的是状态转换
常见训练阶段包括:
- 单模态 encoder/tokenizer 预训练;
- bridge alignment;
- 联合多模态预训练;
- 长上下文或高分辨率扩展;
- 指令与 grounding;
- 偏好、RL、安全与生产适配。
阶段存在的原因不是仪式,而是参数状态不同:
- 随机 projector 会向成熟 LLM 注入陌生分布;
- 高分辨率会改变 token 长度和位置外推;
- 联合训练会造成文本遗忘或模态竞争;
- 指令数据格式单一时,模型可能忘记开放式预训练能力;
- 生成 tokenizer 或 codec 的版本变化会改变整个 target space。
因此每次阶段切换都应记录 optimizer 是否重置、learning rate 是否 warm up、哪些组件解冻、数据 replay 比例、位置参数和 loss mask 是否改变。
Kimi-VL 公开了 vision stage、alignment、joint pretraining、cooldown 和长上下文阶段,是观察这种状态转换的具体案例;它的一套配方不能直接外推为所有模型的固定顺序。
Packing 同时改变统计与系统
变长媒体若按 batch 最大长度 padding,浪费近似为
按长度分桶可以降低 padding,却会改变 batch 中样本分布;sequence packing 进一步把多个样本放入同一长序列,必须阻断跨样本 attention 与 loss。
NaViT 展示了不同分辨率图像的 packing;FlashAttention 从 IO 角度降低 exact attention 的内存访问。两者解决的是不同层:
- packing 决定 token 如何组成 batch;
- attention kernel 决定给定布局如何执行;
- 两者都不能替代正确的 sample boundary、position 和 mask。
动态分辨率还会产生 straggler。即使平均 token 数不变,少数超长图片或视频也可能决定一步的 wall time。吞吐需要同时报告:
examples / second
raw media seconds or pixels / second
modality tokens / second
supervised tokens / second
FLOPs or accelerator utilization
step and tail latency
只报文本 tok/s 会把 encoder 和媒体预处理藏在分母之外。
分布式语义不能由框架默认
多模态训练常同时使用 data、tensor、pipeline、context 和 expert parallelism。每一种并行都可能改变目标或边界:
- 对比学习的 negatives 是否跨 data-parallel rank;
- variable-length sequence 如何沿 context parallel 切分;
- vision encoder 与语言层如何平衡 pipeline stage 时间;
- 媒体 token 的 MoE routing 是否造成 expert 热点;
- gradient accumulation 中各模态出现频率是否一致;
- loss numerator/denominator 在何时、按什么 group 汇总。
Megatron-LM 给出大规模 Transformer 模型并行的早期系统路径;多模态系统在此基础上还多出异构 encoder、变长媒体和不同输出 head,不能只复用语言模型的 batch accounting。
数据加载器是可复现性边界
在线数据管线可能执行:
恢复训练若只保存模型和 optimizer,而不保存 sampler、worker、shuffle buffer 和随机增强状态,后续看到的数据序列已经改变。网络重试、损坏资产跳过和远端对象更新也会造成不可见漂移。
可复现 checkpoint 应绑定:
- 数据 manifest 与 asset digest;
- processor、decoder 和 augmentation 版本;
- mixture scheduler 与 curriculum step;
- sampler、shuffle 与 worker RNG;
- tokenizer、codec 与 codebook;
- packing 和 mask builder;
- world size、parallel group 与 global batch 定义。
完全逐 bit 重放有时成本过高,但至少应区分可重放、统计等价和不可恢复三种承诺。
质量、去重与污染
多模态去重不能只对文本做 hash:
- 同图不同压缩、裁切、水印和分辨率;
- 同视频的片段、转码和镜像;
- 同音频的采样率、速度和背景混合;
- 同文档的扫描版、HTML 版与截图;
- benchmark 题目被改写成 caption、问答或合成轨迹。
应在 asset、表示和语义层分别查重,并按来源 group 做 split。删除近重复也有代价:大量合法模板、常见物体和少数语言可能被误伤,需要报告不同阈值下的保留分布。
数据许可、人物身份、说话人、地理与文档隐私也应在原始 asset 层处理;后续转成 embedding 或 token 不会消除来源责任。
实现契约
- 原始 asset、relation、example、sequence 和 batch ID 可追溯;
- split 在原始来源 group 上完成,派生样本继承 split;
- 每个 mixture 权重注明 sample/token/loss/compute 分母;
- 每个目标的 numerator、denominator 和 distributed reduction 明确;
- media processor、tokenizer、codec 与 decoder 版本固定;
- packing 后 sample、media、episode 与 target 边界仍可恢复;
- 空模态、损坏 asset、超长输入和截断策略显式;
- dataloader、shuffle、augmentation 与恢复状态可审计;
- 每阶段冻结组件、optimizer、schedule 与 replay 比例记录;
- 训练、离线评测和服务使用兼容 preprocessing;
- throughput 同时给出媒体、token、监督和 wall-time 分母;
- benchmark contamination 在 asset 与派生文本两侧检查。
失效模式
- 样本比例冒充 token 比例:少量长视频主导训练。
- 扁平平均吞噬小模态:高 token 目标压过稀有任务。
- 局部均值错误聚合:各 rank 分母不同,却直接平均 loss。
- 错误交错关系:网页图片与附近但无关文字被强配对。
- 合成风格塌缩:数据量增加,答案形式和偏差却更单一。
- 跨 split 派生泄漏:同一 asset 的不同问答进入训练和测试。
- Packing 穿透:相邻样本共享 attention 或位置。
- 动态 shape 尾延迟:均值吞吐正常,长媒体拖慢整步。
- 恢复漂移:sampler 与 augmentation 状态未保存。
- 文本遗忘:媒体比例提高后纯文本能力持续下降。
- 协议漂移:训练 crop、视频采样或 codec 与服务不一致。
- 名义数据规模:重复、损坏和无效 pair 被计入总量。
评测与消融
| 问题 | 应记录的证据 |
|---|---|
| 数据是否真的有用 | 等 token、等 compute 的 source/quality ablation |
| mixture 是否合理 | sample、token、loss、gradient、compute 五种占比 |
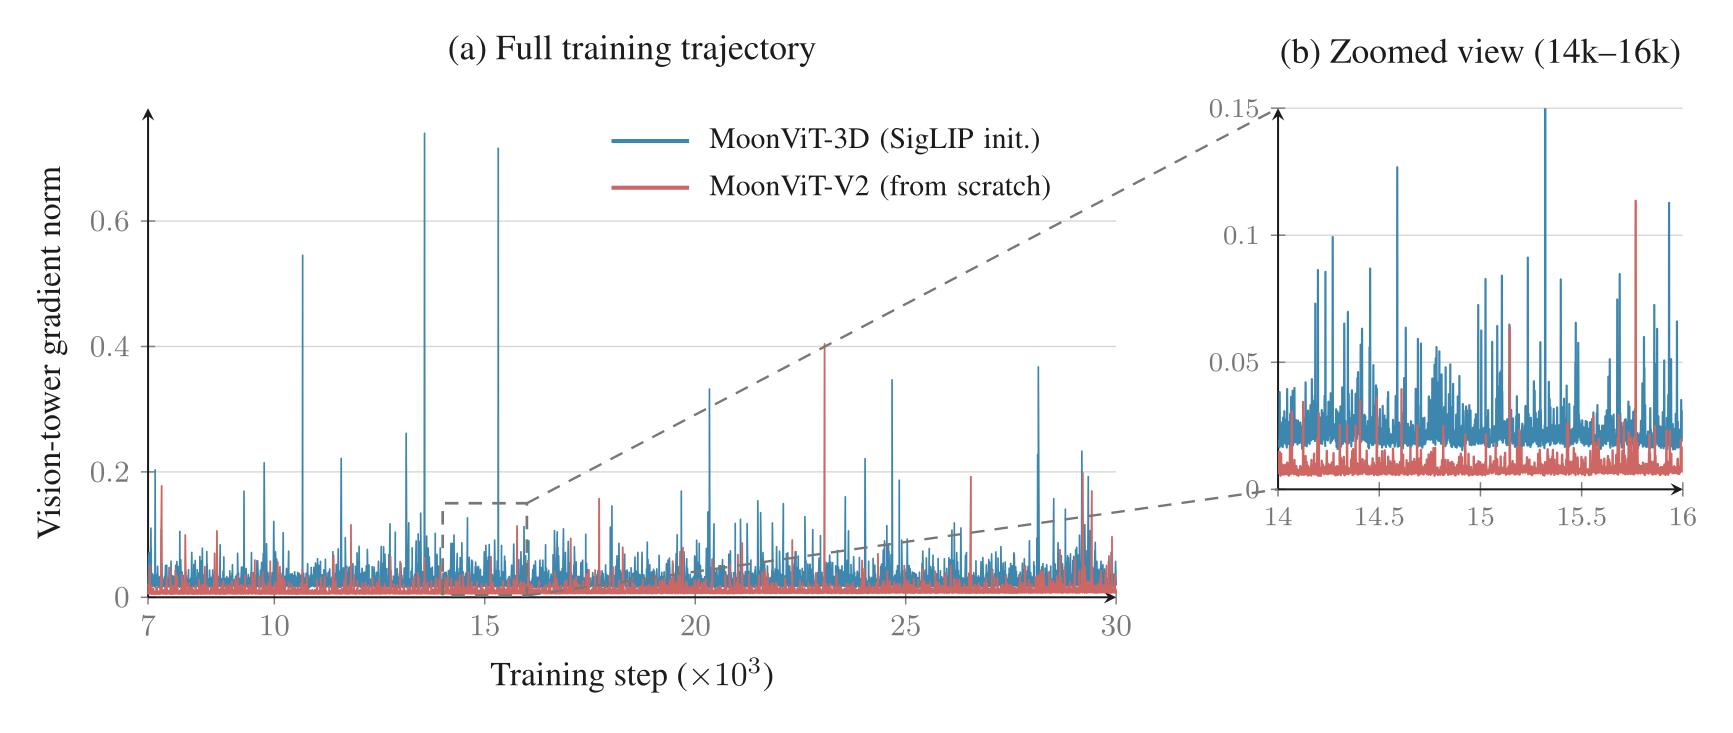
| 是否发生模态竞争 | 单模态留出集、梯度范数/夹角、遗忘曲线 |
| packing 是否正确 | unpack 往返、跨样本泄漏探针、padding 极值测试 |
| curriculum 是否必要 | 固定总预算的阶段顺序与 joint-from-start 对照 |
| 系统是否高效 | encoder、packing、attention、communication 分段 profile |
| 结论是否可复现 | 数据 revision、processor、RNG、world size 与 checkpoint |
| 是否存在污染 | asset、文本、表示近邻和时间切分审计 |
应同时保留“作者报告”“本地复现”“独立评测”和“尚未公开”四种状态。数据规模不能替代 provenance,训练 loss 下降也不能替代模态依赖、生成质量、闭环行为和真实系统成本。
信号与 token 接口见表示、采样与 Tokenization,跨模态计算路径见对齐、桥接与融合,packing 后的位置和信息流见空间、时间、位置与 Mask。
packing、loss 分母与模态 mask 的组合验证见多模态手撕实现。
Reference
- Radford et al., Learning Transferable Visual Models From Natural Language Supervision
- Jia et al., Scaling Up Visual and Vision-Language Representation Learning With Noisy Text Supervision
- Gadre et al., DataComp: In Search of the Next Generation of Multimodal Datasets
- Zhu et al., Multimodal C4: An Open, Billion-scale Corpus of Images Interleaved With Text
- Alayrac et al., Flamingo: a Visual Language Model for Few-Shot Learning
- Liu et al., Visual Instruction Tuning
- Dehghani et al., Patch n' Pack: NaViT, a Vision Transformer for any Aspect Ratio and Resolution
- Dao et al., FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- Shoeybi et al., Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism
- Team Chameleon, Chameleon: Mixed-Modal Early-Fusion Foundation Models
- Kimi Team, Kimi-VL: Mixture-of-Experts Vision-Language Model for Multimodal Reasoning
- Xu et al., Qwen2.5-Omni Technical Report