优化器家族
优化器把梯度转换为参数更新。大模型配方不能只写一个名字:参数分组、更新尺度、weight decay、精度、分片与通信共同决定实际算法。
SGD 与动量
最基本的更新为
动量维护平滑方向:
它的状态较小,但不同参数方向共享相同的标量学习率,对尺度差异很大的 Transformer 参数较难直接调优。
AdamW
Adam 维护一阶与二阶矩:
经 bias correction 后,AdamW 把 weight decay 与自适应更新解耦:
常见实现不对 bias、norm scale 或 embedding 的某些参数做 decay。若参数分组规则不同,即使超参数同名,更新也不相同。
最小语义实现
adamw_step 原地更新参数及两个 moment。输入 step 从 \(1\) 开始;bias correction 只作用于自适应梯度项,decoupled decay 则直接乘到参数上。示例与 PyTorch 在相同 FP64 状态下逐元素对齐。
import torch

@torch.no_grad()
def adamw_step(parameter, gradient, first, second, step, lr,
               betas=(.9, .999), eps=1e-8, decay=0.):
    assert step >= 1 and parameter.shape == gradient.shape == first.shape == second.shape
    beta1, beta2 = betas
    first.mul_(beta1).add_(gradient, alpha=1 - beta1)
    second.mul_(beta2).addcmul_(gradient, gradient, value=1 - beta2)
    first_hat = first / (1 - beta1 ** step)
    second_hat = second / (1 - beta2 ** step)
    parameter.mul_(1 - lr * decay)
    parameter.addcdiv_(first_hat, second_hat.sqrt().add(eps), value=-lr)

parameter = torch.tensor([1., -2.], dtype=torch.float64)
gradient = torch.tensor([.2, -.4], dtype=torch.float64)
first, second = torch.zeros_like(parameter), torch.zeros_like(parameter)
adamw_step(parameter, gradient, first, second, 1, lr=.1, decay=.01)
reference = torch.tensor([1., -2.], dtype=torch.float64, requires_grad=True)
reference.grad = gradient.clone()
torch.optim.AdamW([reference], lr=.1, weight_decay=.01).step()
torch.testing.assert_close(parameter, reference)
assert first.ne(0).all() and second.gt(0).all()
这段代码没有替代参数分组、AMP unscale/finite check、全局梯度裁剪、状态 dtype 与分片恢复;它们必须发生在明确顺序中,且不能把 norm/bias 的 decay 选择藏进优化器名称。更多边界断言见训练目标:AdamW。
Muon
Muon 一类方法对二维矩阵参数的动量更新做近似正交化,使不同奇异方向的更新尺度更均衡。抽象地说,先得到矩阵更新 \(M\),再近似
实际实现通常不显式做完整 SVD,而使用 Newton–Schulz 迭代等低成本近似。Muon is Scalable for LLM Training 强调 weight decay 与按参数调整更新尺度对扩展到更大训练的重要性。
Muon 通常只应用于隐藏层的二维矩阵;embedding、norm、bias 和标量参数仍使用 AdamW 或其他优化器。因此“使用 Muon”实际上是混合优化器与参数路由规则。
Per-Head Muon
Q/K/V projection 通常把多个 head 沿输出维堆在同一个矩阵中。若对整张 momentum matrix 一次 Newton–Schulz orthogonalization,所有 head 共享归一化尺度与迭代;高范数 head 会主导这张堆叠矩阵 的谱,小范数 head 得到的校正相对不足。
Kimi K3 技术报告把 Q、K、V 的 momentum 沿 head 轴切为
然后分别近似每个 \(M_h\) 的 polar factor:
每个 head 因而先在自己的谱尺度下被标准化,再拼回 projection shape。作者报告这使大规模训练中的 head 更新更均衡、稳定性更好;tall per-head block 的 Newton–Schulz 也略便宜。它不是把所有矩阵都 改成 per-head:只有参数布局中确实存在 head 轴的 Q/K/V projection 适用,输出投影、MLP、embedding 等仍走各自既定的 Muon 或 AdamW 分组。
下面用精确 SVD 充当小矩阵语义真值;生产优化器应换成经过 scale 与精度校准的 Newton–Schulz kernel。 把任一 head 的 momentum 乘正标量,不应改变该 head 的 exact polar update。
import torch

def polar_factor(matrix):
    u, _, vh = torch.linalg.svd(matrix.float(), full_matrices=False)
    return u @ vh

def per_head_polar(momentum, heads):
    assert momentum.ndim == 2 and momentum.size(0) % heads == 0
    blocks = momentum.reshape(heads, momentum.size(0) // heads, momentum.size(1))
    return torch.stack([polar_factor(block) for block in blocks]).reshape_as(momentum)

torch.manual_seed(0)
momentum = torch.randn(6, 8)
update = per_head_polar(momentum, heads=3)
blocks = update.reshape(3, 2, 8)
gram = blocks @ blocks.transpose(-1, -2)
torch.testing.assert_close(gram, torch.eye(2).expand(3, 2, 2), atol=1e-5, rtol=1e-5)
scaled = momentum.reshape(3, 2, 8).clone()
scaled[0] *= 100
torch.testing.assert_close(per_head_polar(scaled.reshape(6, 8), 3), update, atol=2e-5, rtol=2e-5)
真正实现还必须固定 Q/K/V 的 fused 或 separate layout、GQA 下各自 head 数、tensor-parallel shard 边界、momentum dtype、Newton–Schulz steps 与更新 scale。若一个 head 横跨 rank,局部 reshape 后独立正交化会改变算法。K3 的优化器与混合主干关系见 Kimi K3。
DeepSeek-V4:Hybrid Newton–Schulz 与矩阵所有权
DeepSeek-V4 也把 Muon 用于大多数二维 hidden weights,但它不是 K3 Per-Head Muon 的复刻。对归一化动量矩阵 \(M_0=M/\lVert M\rVert_F\),V4 使用
十次迭代分两段:前八步取 \((a,b,c)=(3.4445,-4.7750,2.0315)\)快速把奇异值推近 1,最后两步取 \((2,-1.5,0.5)\)稳定到 polar factor 附近。embedding、prediction head、RMSNorm,以及 mHC 的 static bias / gate 仍归 AdamW;所以参数路由仍是算法的一部分。
V4 还把 ZeRO 分片边界对齐到完整逻辑矩阵:用 knapsack 把矩阵分配给 rank,MoE 的 up、gate、down 分别组织,但不在一次正交化内部任意切开。梯度经 stochastic BF16 all-to-all 到 owner,再在本地 FP32 累加。详见 V4 系统闭环。
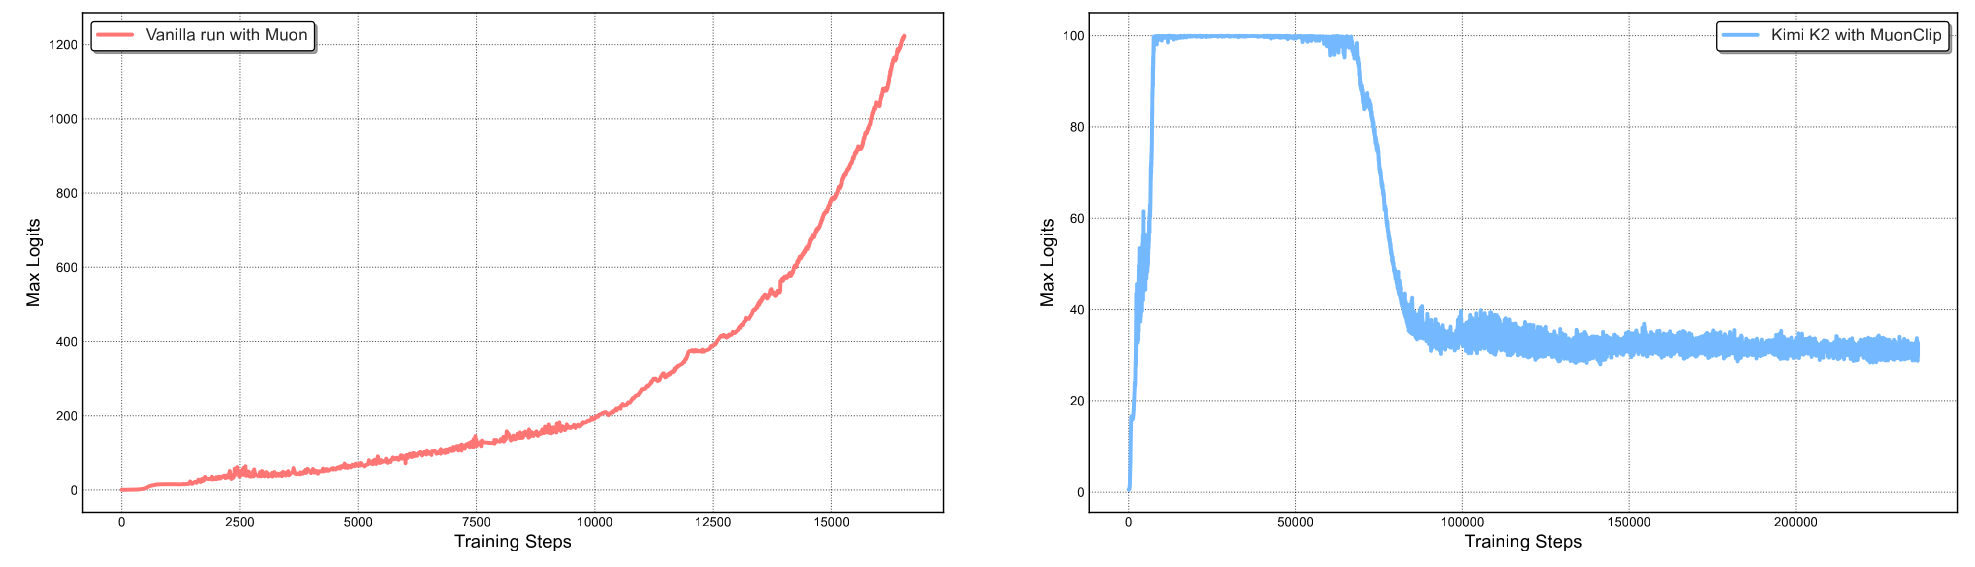
V4 的 query 与 compressed KV 逐 head RMSNorm,因而没有沿用 scalable Muon 中的 QK-Clip。这个选择只说明该架构已有另一条 logit 范围控制路径,不能推广成 Muon 普遍不需要 QK-Clip。
更新尺度
观察相对更新量比只看梯度范数更直接:
不同层的 \(\rho_l\) 若相差数个数量级,可能意味着参数化、学习率、正交化 scale 或分组异常。还应按 attention、MLP、embedding、norm 和 router 分组观察。
Gradient clipping
全局范数裁剪为
分布式实现必须先得到正确的全局范数。按 rank 局部裁剪会改变算法;ZeRO/FSDP 下参数已分片,更需要由框架统一归约。裁剪可以限制偶发尖峰,不能修复错误数据、loss mask 或 overflow。
学习率日程
常见配方由 warmup、峰值和 decay 组成。比较两个优化器时,要区分:
- 相同峰值学习率;
- 各自调优后的学习率;
- 相同训练 token 或相同 wall-clock;
- 相同 batch 与梯度噪声尺度;
- 相同 weight decay 和参数分组。
只给新优化器更多调参预算,结论会混入搜索偏差。
状态、显存与分片
AdamW 通常为每个参数保存两个 FP32 moment,某些实现还保留 FP32 master weight。Muon 对矩阵保存动量,并增加正交化临时 buffer。优化器状态可由 ZeRO stage 1/FSDP 分片;更新计算和分片通信仍应计入 step time。
低精度 optimizer state 能节省内存,但量化误差可能集中在小梯度或稀有参数上。应同时评估训练 loss、下游质量、恢复一致性与异常尖峰。
可复现清单
optimizer implementation and version
parameter-group selection
learning rate, betas or momentum
epsilon, weight decay and exclusions
update scaling / orthogonalization iterations
warmup and decay in tokens
gradient clipping and accumulation
state/master-weight precision
distributed sharding and communication
resume conversion rules
混合精度与故障诊断见优化与稳定性,状态分片见集合通信与分片。
Muon Split:正交化的矩阵边界会改变更新
Muon 不是逐元素缩放,而是对二维更新矩阵做近似正交化;怎样 reshape 参数因此属于算法定义。GLM-5 的 Muon Split 在 MLA 的 Q/K/V up-projection 上先按 attention head 切分,再分别正交化。若把所有 heads 拼成一个大矩阵,Newton–Schulz 迭代会耦合不同 head 的奇异谱;分头处理则允许各 head 获得不同更新尺度。
设第 \(h\) 个 head 的动量矩阵为 \(M_h\),Muon Split 计算
而不是
两者一般不相等。复现时必须固定 head layout、transpose、normalization、迭代次数以及 Q/K/V 是否分别处理。GLM-5 报告没有公开所有优化器超参数与消融,因此只能复现运算边界,不能据此还原完整训练配方。架构动机见 GLM-5 架构。
Reference
- On the Importance of Initialization and Momentum in Deep Learning
- Decoupled Weight Decay Regularization
- Muon: An Optimizer for Hidden Layers in Neural Networks
- Muon is Scalable for LLM Training
- Kimi K3 Technical Report
- DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
- GLM-5: from Vibe Coding to Agentic Engineering