规划、评测与安全
具身模型必须在两种时间尺度上同时工作:高层决定“下一步完成哪个子目标”,低层在几十到几百毫秒内修正轨迹。把所有决策交给一个同步大模型,通常既慢又难以验证;把高层语义全部交给传统控制器,又无法覆盖开放指令与新场景。
合理的系统不是单模型神话,而是职责清晰的闭环。
层级决策:语义计划与运动控制分开
设高层在时刻 \(t_k\) 选择 skill 或子目标 \(z_k\):
低层在该子目标下执行:
高层适合处理对象语义、顺序、工具和权限;低层适合处理几何、接触与快速反馈。接口必须定义:
- skill 的 initiation condition;
- 可观察的 success/failure/timeout;
- 参数与坐标;
- interruption 和 recovery;
- 高层何时重新感知,而不是盲目等待。
只在 prompt 中写“先规划再执行”不构成层级控制。若子目标没有终止条件、状态反馈和独立错误处理,它只是一段无法验证的文字。
SayCan:语言可取不等于环境可行
SayCan 把语言模型对 skill 的相关性与 value/affordance 结合。简化地写:
语言模型回答“哪一步符合指令”,affordance/value 回答“当前环境能不能做到”。这种分工比让 LLM 凭文本猜物理可行性可靠,但 value 只覆盖已训练的 skill 与状态;它不知道的对象、损坏的传感器和未授权区域仍需要显式拒绝。
VLA、世界模型与高层 reasoning
三种常见闭环各有适用范围。
直接 policy
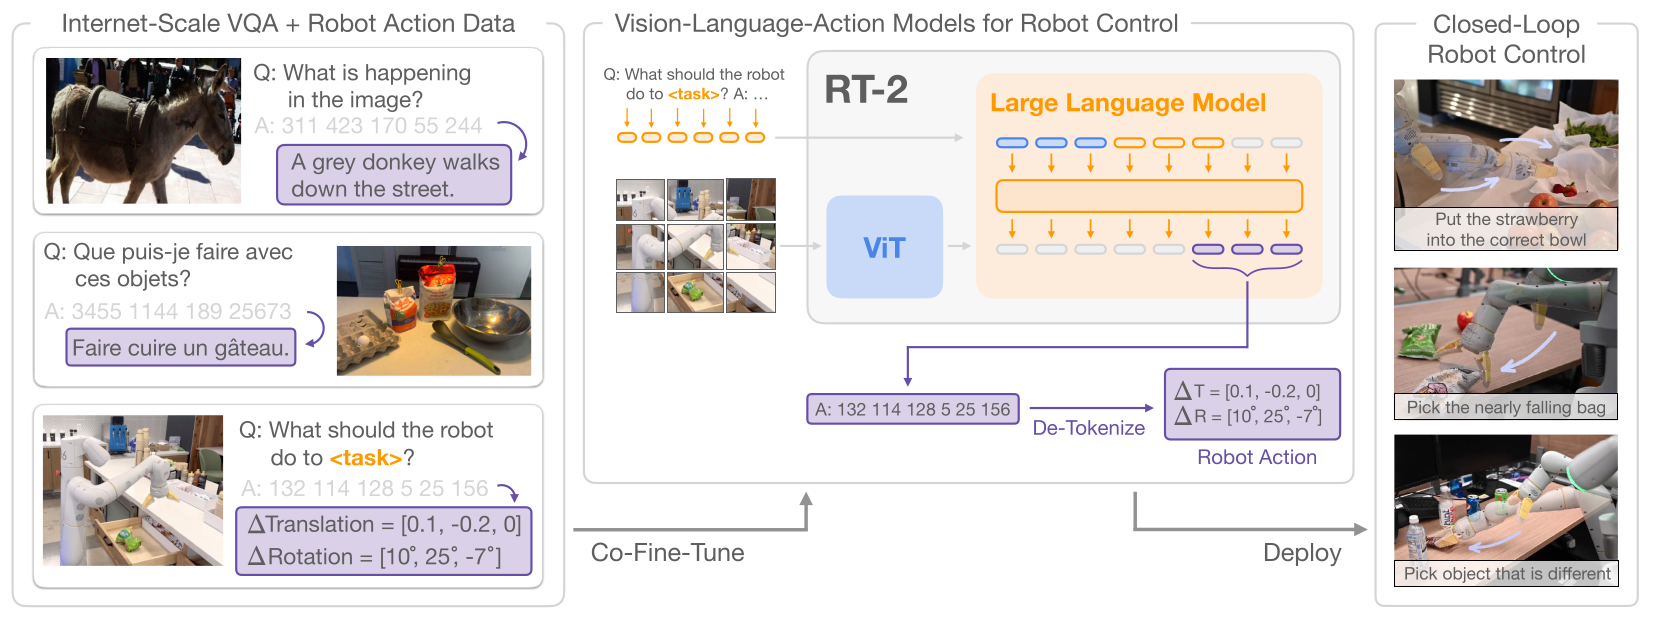
VLA 直接输出 action chunk,延迟低、接口短;遇到长程任务、失败恢复或约束变化时,需要额外 state machine 或 planner。
世界模型 MPC
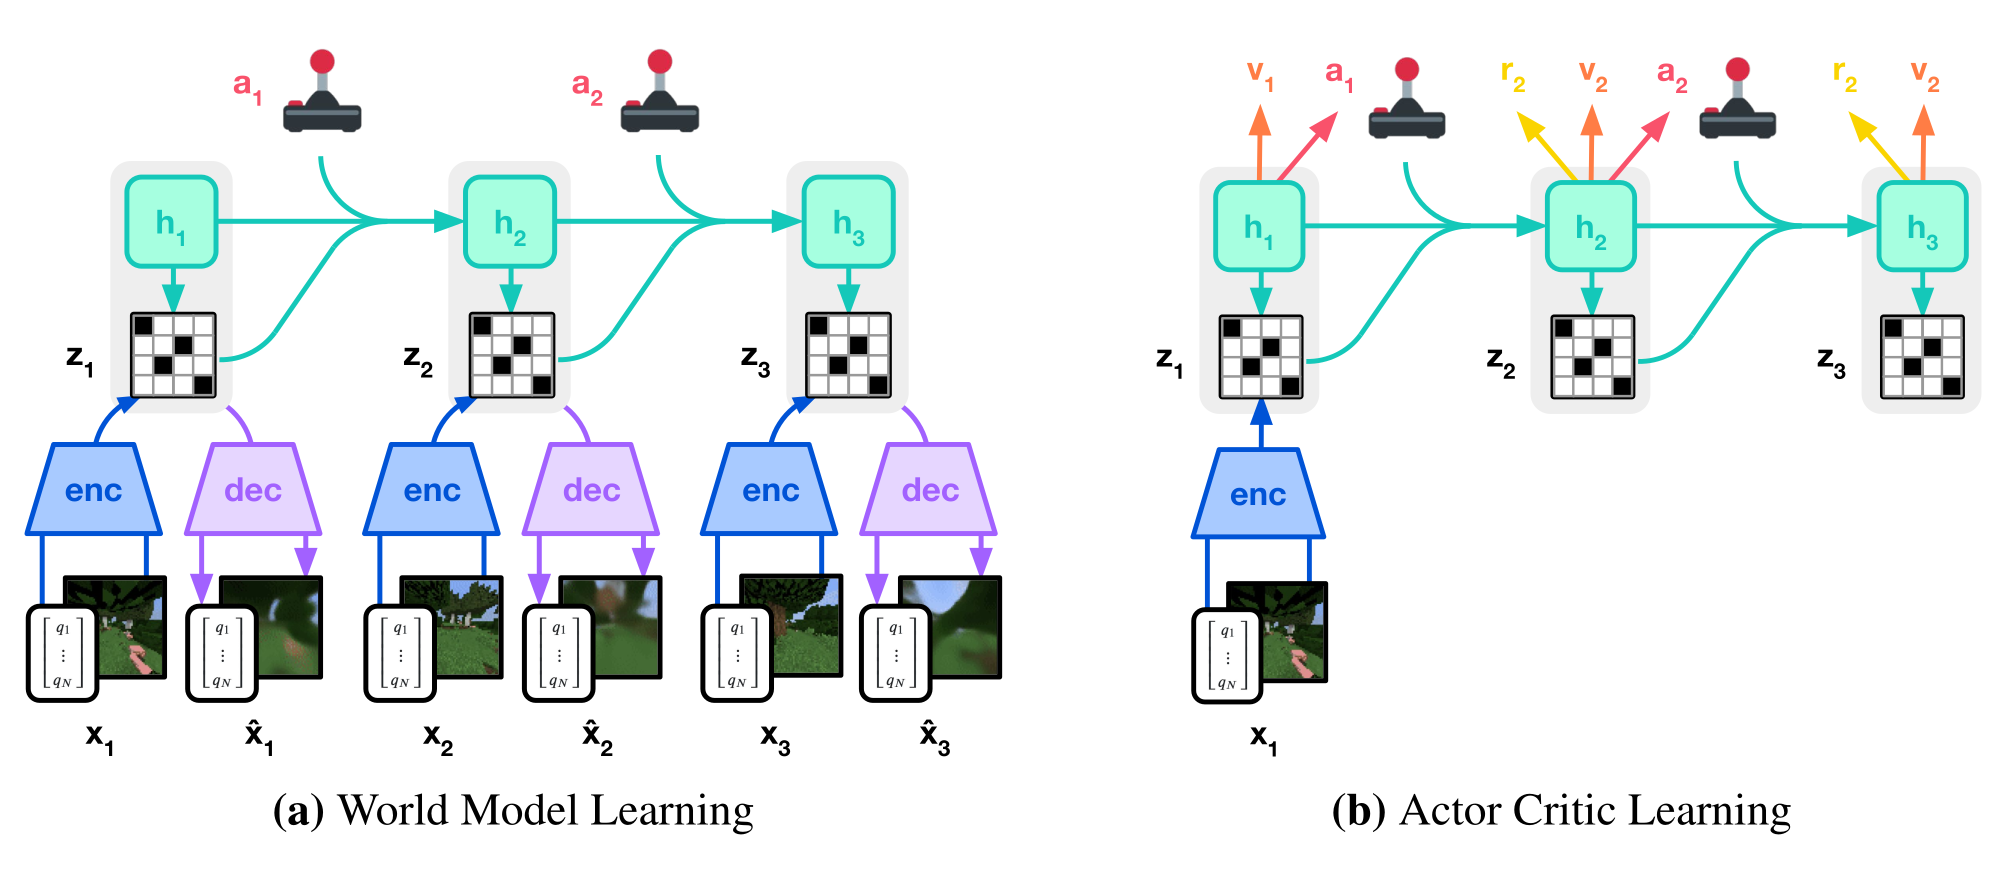
世界模型可以显式比较反事实动作,每次只执行第一步再重规划。代价是 rollout 计算、模型偏差和目标函数。最小 CEM 见动力学、想象与规划。
高层 reasoning + 低层 VLA
高层模型生成结构化子目标或工具调用,低层 VLA 执行并反馈状态。Gemini Robotics-ER 与 Robotics VLA 的公开双模型叙述属于这一路线。高层输出必须受 schema、对象绑定和权限检查约束;自然语言 chain-of-thought 不是安全证明。
系统还可让世界模型为 VLA 提供候选轨迹检查,或让 policy 给 CEM/MCTS 提供 proposal。比较时要拆开各模块贡献,而不是只给组合系统最终分数。
Receding horizon 与异步 runtime
一次 policy inference 可能比低层控制周期慢很多。可行架构通常是:
camera / proprioception
        └─ timestamped observation queue
                    └─ policy server
                           └─ action chunk + source timestamp
                                      └─ runtime supervisor
                                             └─ interpolator/controller
                                                    └─ robot
低层 controller 继续高频运行,policy server 异步更新 action chunk。runtime supervisor 负责:
- 丢弃基于过期观察生成的动作;
- 在新 chunk 到达前插值或进入安全 hold;
- 新观察显著改变状态时取消旧 chunk;
- 执行 workspace、joint、speed、force 与碰撞约束;
- policy/network 超时后 fail safe;
- 分开记录 requested、filtered 与 executed action。
不能用“模型输出 50 步”推断实时频率。应报告:
最小 runtime guard
下面只展示可单元测试的 freshness、急停和边界拒绝。它不是碰撞检测器,也不能替代经验证的低层安全控制。
import torch
def gate_action(action, low, high, observation_age, max_age, estop=False):
    action, low, high = map(torch.as_tensor, (action, low, high))
    if estop or observation_age > max_age:
        return torch.zeros_like(action), False, "stop-or-stale"
    if action.shape != low.shape or low.shape != high.shape:
        raise ValueError("action contract mismatch")
    if torch.any(~torch.isfinite(action)) or torch.any(action < low) or torch.any(action > high):
        return torch.zeros_like(action), False, "invalid-or-out-of-bounds"
    return action, True, "accepted"
action, accepted, reason = gate_action([.2, -.1], [-1., -1.], [1., 1.], .03, .1)
assert accepted and reason == "accepted"
stopped, accepted, _ = gate_action([.2, -.1], [-1., -1.], [1., 1.], .2, .1)
assert not accepted and torch.equal(stopped, torch.zeros(2))
真实 guard 不应简单把所有越界动作 clamp 后继续执行:越界本身可能说明坐标、归一化或策略已经失效,默认拒绝更容易暴露错误。安全停机动作也不一定是全零,需由具体机器人控制器定义。
评测从问题定义开始
机器人 benchmark 的百分比只有连同协议才有意义:
- robot 与末端执行器;
- observation/action schema;
- checkpoint、finetune 与训练数据重叠;
- task variant、初始状态和 reset;
- 每项 trial 数与随机化;
- success 判定者;
- control rate、latency 与 hardware;
- human intervention、retry 与筛选;
- 仿真器和 benchmark 版本。
同名 LIBERO、CALVIN 或 SimplerEnv 结果也可能使用不同 observation、action head、language augmentation、初始状态和 evaluation wrapper。
一张覆盖完整闭环的评价矩阵
| 层级 | 指标 | 关键切片 |
|---|---|---|
| 开放环动作 | NLL、MSE、token accuracy、calibration | action dim、chunk 位置、边界与多峰 |
| 短程闭环 | success、progress、完成时间 | 物体、姿态、场景、相机 |
| 长程 | 子目标完成率、重规划、恢复 | 步数、错误位置、记忆 |
| 泛化 | 新对象、指令、任务、场景、embodiment | 逐轴改变,不混成一个 OOD |
| 鲁棒 | 遮挡、移动物体、延迟、丢帧、标定漂移 | 扰动强度曲线 |
| 安全 | collision、violation、intervention、unsafe success | 风险类别与暴露时长 |
| 系统 | p50/p95/p99 latency、jitter、Hz、显存 | edge/server、batch、网络 |
成功与安全必须分开
设 episode 成功为 \(S_i\in\{0,1\}\),安全违规数为 \(C_i\),则至少同时报告:
以及
只报 success 会把“撞到旁边物体后完成任务”计为正常成功。对少量真实机器人 trial,还应给置信区间,而不是把 8/10 与 9/10 解读成稳定排名。统计基础见统计推断。
开放环不能预测闭环
多个动作可能到达同一目标,所以低 MSE 不一定必要;接触任务中毫米级误差又可能造成失败,所以低 MSE 也不充分。建议建立分层回归测试:
- action codec 与 shape;
- 离线 held-out trajectory;
- 仿真 closed-loop;
- hardware-in-the-loop;
- 受控真实任务;
- 扰动、恢复和安全;
- 长时间 soak test。
每一层通过才扩大权限和场景。仿真成功不能直接跳到无人监督真实部署。
泛化要逐轴切开
“OOD”至少包含:
- 视觉:背景、光照、相机、遮挡;
- 对象:实例、类别、材质、尺寸;
- 语言:改写、组合、否定、指代;
- 动作:新轨迹、速度、接触方式;
- 任务:新技能组合与长程顺序;
- embodiment:新机器人、夹爪与自由度;
- 动力学:载荷、摩擦、柔性与延迟。
若同时改变五个轴,失败无法归因;若只换背景就称“开放世界”,结论又过宽。当前较新的 VLA-Arena、ForesightSafety-VLA 等预印本尝试把鲁棒性、安全和长程问题细分,但截至 2026-07-28 仍很新,应作为诊断框架而不是公认统一标准。
分层安全栈
模型输出不应直接越过安全控制。一个可审计的栈至少包含:
- 指令与权限层:用户、任务、对象和区域授权;
- 语义计划层:禁用动作、危险物体与必要确认;
- runtime supervisor:staleness、通信、状态机、动作拒绝;
- 几何与动力学层:碰撞、工作区、速度、力、关节限制;
- 底层控制层:稳定控制、watchdog、安全 PLC/急停;
- 运营层:日志、回放、事件响应、维护和人员隔离。
上层模型可以建议,下层约束必须拥有最终否决权。一个语言模型说“安全”不能覆盖力矩传感器、碰撞模型或硬件急停。
环境也是不可信输入
具身模型会看到屏幕、标签、二维码和其他人的语音。它们属于 observation,而不是自动获得权限的指令。攻击面包括:
- 环境文本 prompt injection;
- 伪造 AprilTag/二维码与视觉标记;
- 传感器 spoofing 或 replay;
- policy server 与机器人之间的消息篡改;
- 旧 observation/action chunk 重放;
- dataset poison 与后门触发物;
- 高层 tool call 越权。
防护需要来源标记、能力最小化、消息认证、nonce/timestamp、执行前策略检查和物理安全层。Agent 安全的一般原则见智能体安全。
世界模型的安全边界
世界模型可在执行前预测碰撞或失败,但它也是 learned component:
尤其在长尾危险状态上,训练数据往往最少。较安全的用法是:
- 用模型筛掉明显危险候选,而不是独自批准动作;
- uncertainty 高时缩短 horizon、降速或请求接管;
- 用独立几何/动力学约束再次检查;
- 把真实 near-miss 和 intervention 回灌评测;
- adversarially 搜索 model exploitation。
SafeVLA 等工作研究 constrained/safe RL 与 VLA 的结合,但论文 benchmark 上的改进不等价于具体机器人部署认证。
标准与治理不能被 benchmark 替代
- ISO 10218-½ 在 2025 年修订机器人与机器人系统安全要求;
- ISO/TS 15066 涉及协作机器人;
- ISO 13482 涉及 personal care robots;
- NIST AI RMF 提供 Map、Measure、Manage 等通用 AI 风险治理框架。
这些标准适用范围、风险评估与合规责任需由具体产品和专业团队判断。语言安全集、仿真 collision rate 或模型卡都不能自行构成认证。
上线前的最小审计问题
- observation、command、executed action 是否各有 timestamp;
- action frame、unit、normalization 与 robot config 是否版本一致;
- policy 超时、网络断开和传感器失效时做什么;
- 谁能下达哪些动作,环境文字能否改变权限;
- requested/filtered/executed action 是否可追踪;
- success 是否把 collision 与人工救援排除;
- 新场景是否从低速、受限 workspace 和人工监护开始;
- 是否有独立急停和无需模型参与的安全状态;
- 训练数据、权重、代码与论文图表许可证是否分别核对;
- 产品预览、作者报告和本地复现是否清楚分层。
动作与数据接口见状态、动作与策略和 VLA 与数据谱系;世界模型的 rollout bias 与规划见动力学、想象与规划。
闭环策略、回报和终止语义的组合练习见强化学习手撕实现。
Reference
- Ahn et al., Do As I Can, Not As I Say: Grounding Language in Robotic Affordances
- Sutton, Precup, and Singh, Between MDPs and Semi-MDPs: A Framework for Temporal Abstraction in Reinforcement Learning
- Assran et al., V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning
- Google DeepMind, Gemini Robotics 1.5
- Google DeepMind, Gemini Robotics-ER 1.6 Model Card
- SafeVLA: Towards Safety Alignment of Vision-Language-Action Models via Constrained Learning
- VLA-Arena: A Comprehensive Evaluation Benchmark for Vision-Language-Action Models
- ForesightSafety-VLA: A Benchmark for Foresight Safety in Vision-Language-Action Models
- ISO, Robotics Sector and Safety Standards
- NIST, AI Risk Management Framework