全模态 Any-to-Any 系统
“全模态”最容易被输入列表误导。一个系统能上传图片、转写语音、调用图像生成器,并不说明它在同一模型内联合理解和生成。更有解释力的定义是输入—状态—输出计算图:
这里至少要问:
- 哪些模态进入同一个可训练状态 \(h\);
- 哪些输出由共享主干直接生成,哪些来自外部模型或工具;
- 输入和输出能否交错、流式和被打断;
- 模态时间、位置、权限与失败怎样贯穿整个系统。
Any-to-Any 描述的是接口目标,不是一种固定架构。


从多任务共享到交错全模态
早期统一模型主要共享中间主干。MultiModel 为图像、音频和文本设置模态专用前后端,再让共享 encoder–mixer–decoder 处理多项任务。Perceiver IO 用 latent bottleneck 接受不同结构输入并产生灵活输出。这类工作证明参数可以跨模态复用,但任务通常仍由独立输入/输出 adapter 定义。
第二阶段强调共享语义空间。CLIP 连接图像与文本,CLAP 连接音频与文本,ImageBind 进一步把图像、文本、音频、深度、热成像和 IMU 绑定到共同空间。共享 embedding 适合检索和条件接口,却不天然可逆,不能直接生成高保真媒体。
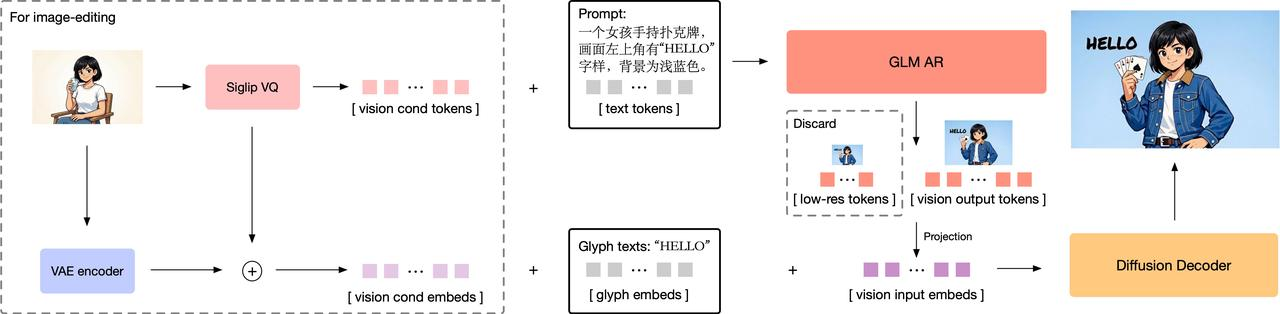
第三阶段把不同模态编入一个序列或联合主干。Chameleon 以离散图像 token 和文本 token 做 mixed-modal early fusion;Transfusion 在同一 Transformer 中对文本使用 next-token loss、对连续图像使用 diffusion loss;Janus 为理解和生成保留不同视觉编码路径,再共享自回归主干。它们说明“统一”可以发生在 token、参数、序列或训练目标的不同层级。
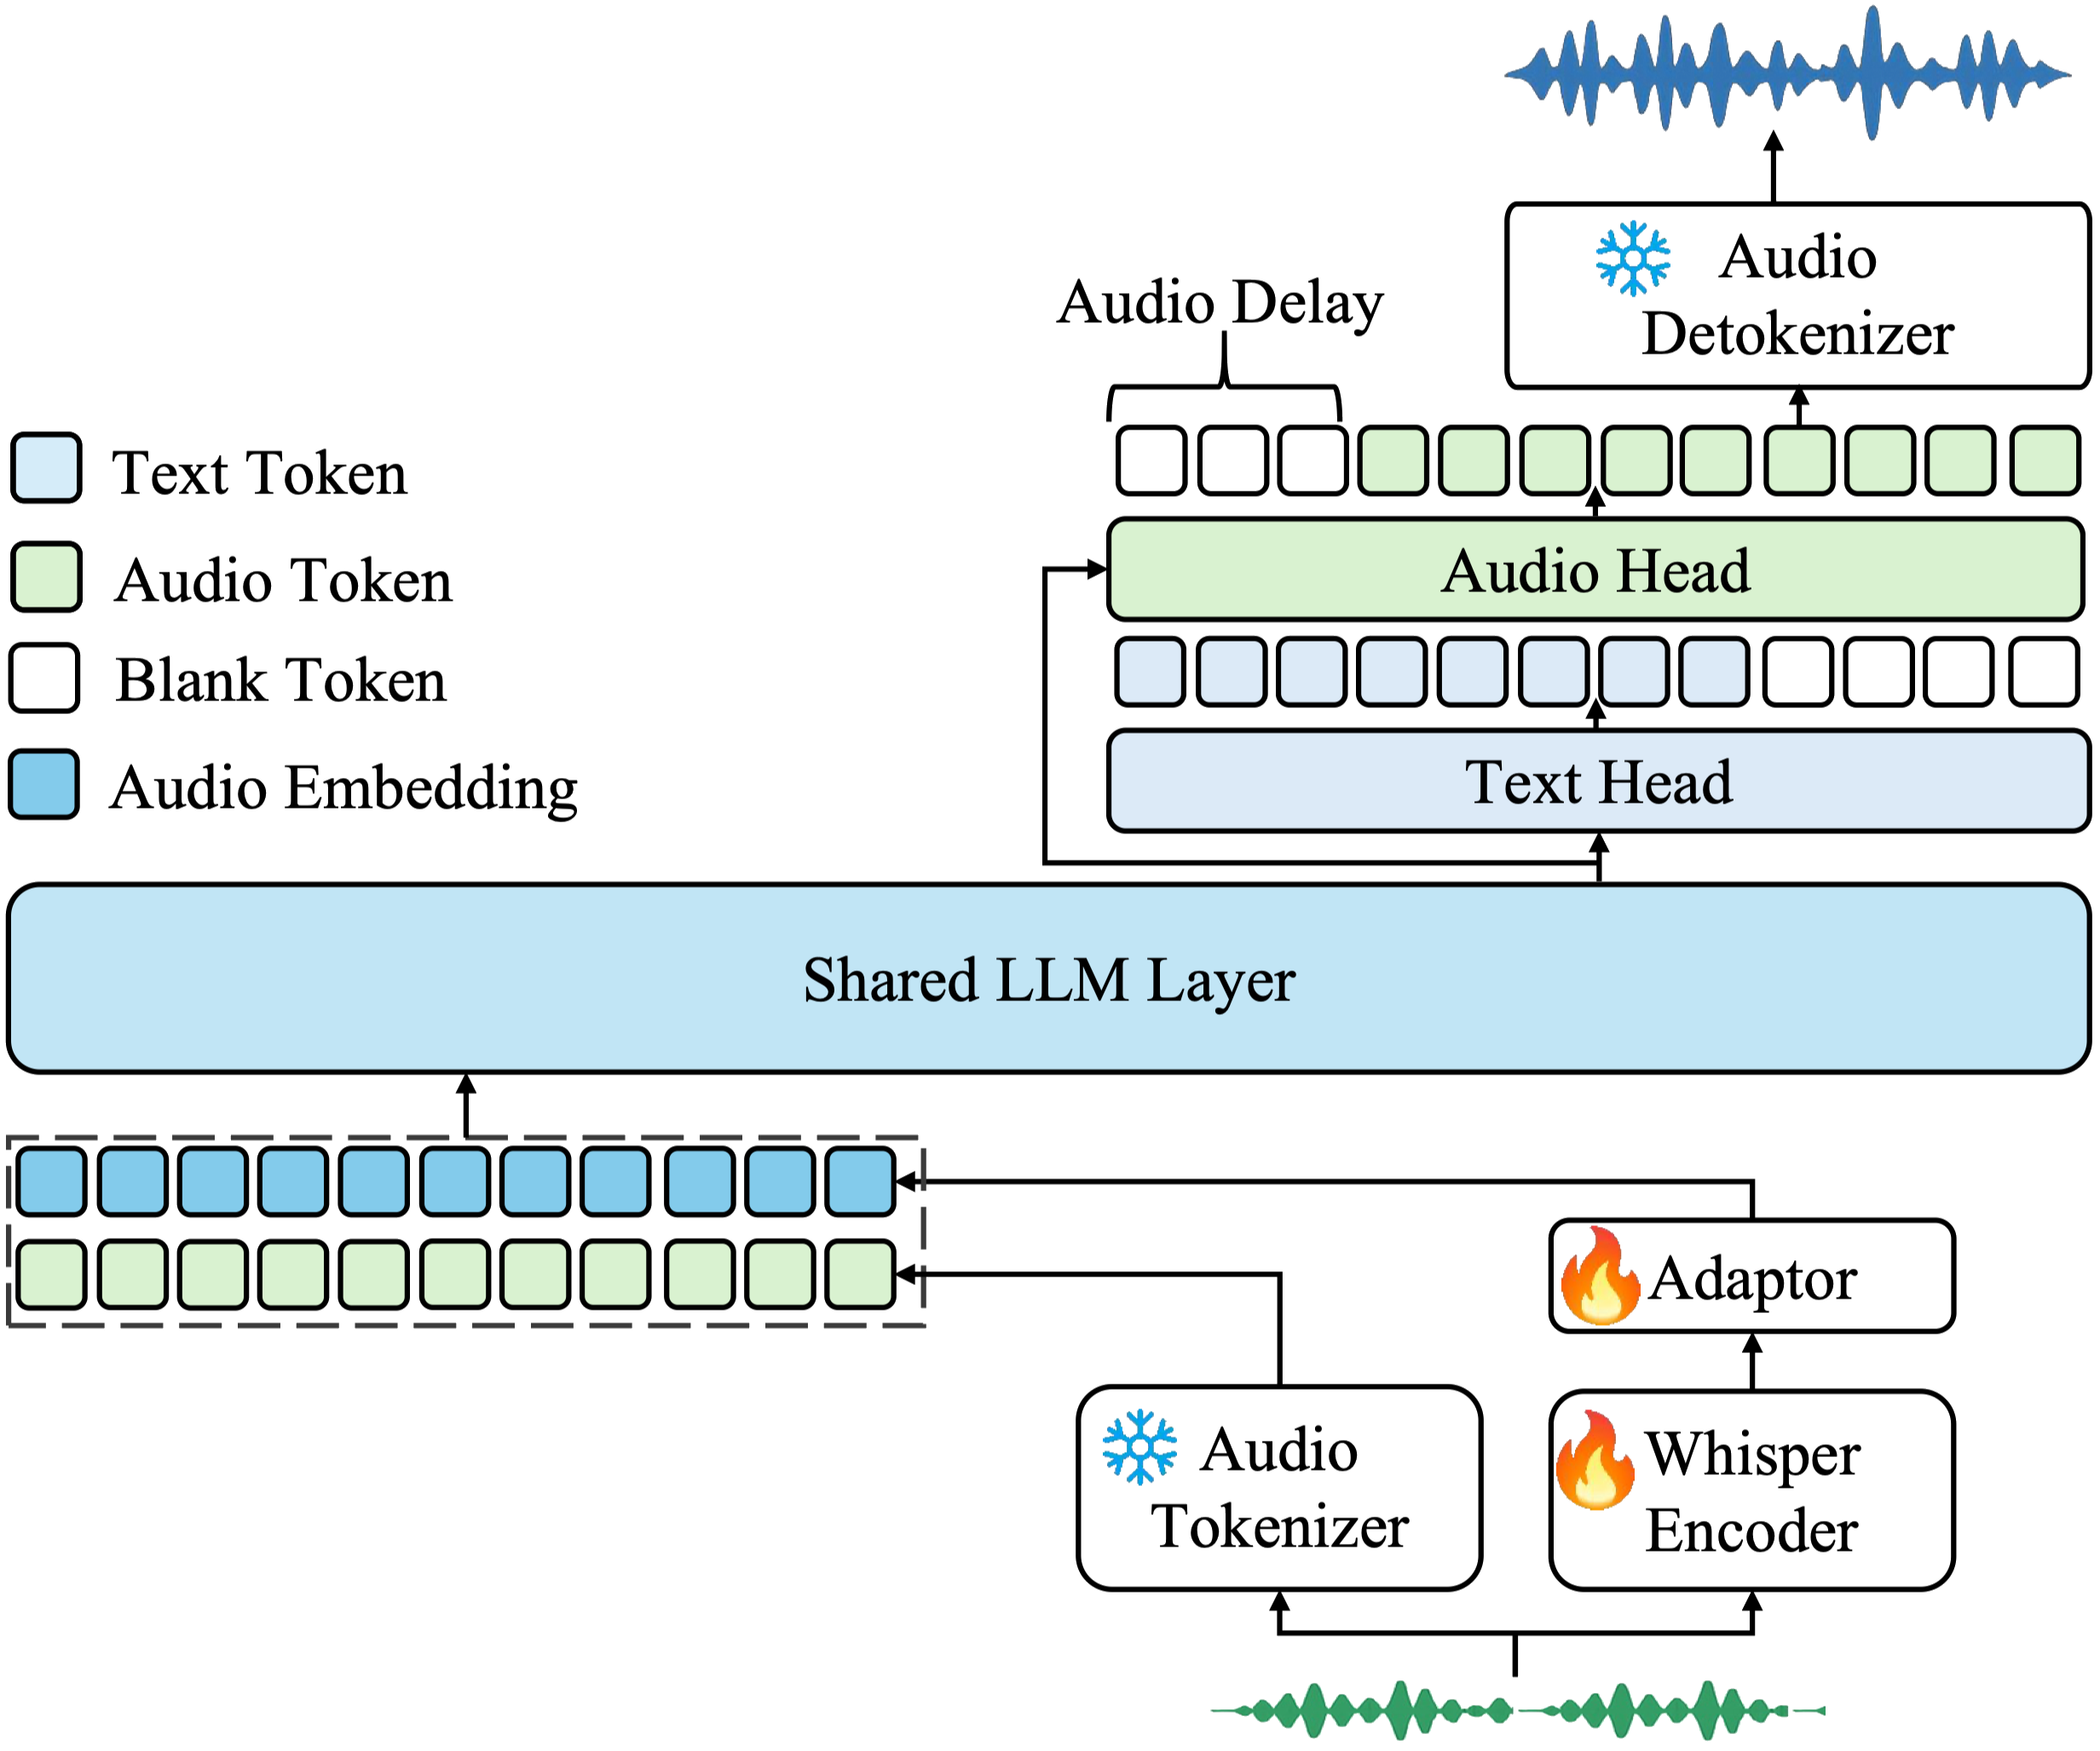
实时语音与视频又提出第四个要求:系统不能等所有输入结束后才一次性输出。Moshi 探索全双工语音交互,Qwen2.5-Omni 用 Thinker–Talker 和多模态旋转位置处理连续输入与流式语音输出。公开产品如 GPT-4o 也披露了跨文本、视觉和音频的实时接口,但未公开细节不能被补写成确定架构;能力、系统卡和研究机制应分开表述。
五种“统一”
| 层级 | 共享了什么 | 仍可能分离什么 |
|---|---|---|
| API | 同一个会话入口 | 后端模型、状态与训练 |
| 语义空间 | embedding/contrastive space | decoder 与高保真细节 |
| 序列 | token stream 与 attention | encoder、tokenizer、loss |
| 主干参数 | Transformer block | input/output head、专家 |
| 目标与数据 | 联合 end-to-end 训练 | 采样器、运行时、安全层 |
一个系统可以在较低层“统一”而在较高层继续路由。例如共享语言推理主干,但图像用 diffusion decoder、语音用 codec LM、动作交给独立 policy。这样的模块化不比单体模型低级;它可能更容易升级、审计和隔离故障。
两类核心架构
统一离散序列
若所有模态都能离散化,可写成
优点是训练、缓存和约束解码接口统一;代价包括:
- 高保真媒体需要大量 token;
- 不同码本熵与 token rate 差异大;
- raster/codec 顺序给空间和时间引入人为因果;
- 交叉熵会被 token 数最多的模态主导;
- tokenizer 重建上限成为整个系统上限。
连续—离散混合
文本可继续使用交叉熵,图像、声音或动作 latent 使用 diffusion/flow:
共享 Transformer 可以通过模态 embedding、attention mask 和专家路由处理不同位置。混合目标减少媒体离散化压力,却需要同时管理:
- 哪些位置是 context,哪些是生成 target;
- diffusion 时间 \(t\) 与序列位置的关系;
- 不同模态 loss 的分母;
- 文本 decode 与连续 solver 能否并发;
- CFG 或条件 dropout 怎样穿过共享主干。
理解与生成统一详细比较表示与目标;本页关注它们怎样成为可交互系统。
输入流不是静态 batch
实时会话可以同时到达:
- 用户语音 chunk;
- 摄像头 frame;
- 屏幕或工具结果;
- 系统事件;
- 模型自己的 partial 输出。
每个 packet 至少应携带
capture time 描述事件在世界中何时发生,arrival time 描述系统何时收到。网络抖动会让两者顺序不同;直接按到达顺序拼 token 会制造错误因果。
下面的最小实现把已到达 packet 按采集时间稳定排序,并拒绝读取超过当前事件时间的未来输入。它没有解决跨设备时钟校准,但把两个时间轴显式分开。
from dataclasses import dataclass
@dataclass(frozen=True)
class Packet:
    modality: str
    capture: float
    arrival: float
    payload: object
def visible_packets(packets, now, event_time):
    ready = [p for p in packets if p.arrival <= now and p.capture <= event_time]
    return sorted(ready, key=lambda p: (p.capture, p.arrival, p.modality))
packets = [Packet("video", .9, 1.2, "frame"), Packet("audio", 1., 1.1, "chunk")]
assert [p.modality for p in visible_packets(packets, 1.15, 1.)] == ["audio"]
assert [p.modality for p in visible_packets(packets, 1.3, 1.)] == ["video", "audio"]
真实 runtime 还要定义时钟同步、late packet、drop policy、重采样、去重和过期状态取消。
输出流怎样并发
文本、语音和图像的完成语义不同:
- 文本可逐 token 提交;
- 语音需要 codec frame、vocoder buffer 和可播放边界;
- 图像/视频可能经过多步 solver,早期预览不等于最终结果;
- 动作一旦执行,不能像文本一样撤回。
因此输出调度器需要“可见”“可播放”“可提交”“可执行”四种状态,而不是一个 finished 布尔量。
语音 full duplex 尤其需要两条并发流:
用户插话时,系统应停止尚未播放的音频、废弃受旧上下文影响的 decode/cache,并保持已听输入状态。若只暂停播放器而不取消模型状态,后续响应仍可能建立在过时计划上。
模态路由与专家
共享所有参数可能产生负迁移:
- 高频音频 token 淹没低频文本;
- 重建目标鼓励低层细节,语义目标鼓励不变性;
- 视觉生成梯度与语言 reasoning 梯度竞争;
- 实时语音要求 causal,离线图像理解偏好双向上下文。
常见缓解方式包括:
- 模态专用 encoder/decoder;
- modality-specific LayerNorm、AdaLN 或 adapter;
- 共享 attention + 专用 FFN expert;
- 按任务路由的 loss head;
- 分阶段冻结、联合训练与 cooldown;
- replay 或 mixture floor 防止旧模态遗忘。
路由本身必须评测。若某个专家只在训练中被使用、推理中 collapse 到少数专家,名义容量不会变成实际能力。
Any-to-Any 不等于一次完成所有任务
一个自然的系统可能分两阶段:
- Thinker 维护多模态状态、计划和语义输出;
- Renderer/Talker/Policy 把语义状态转成媒体或动作。
这样可以让语言推理与高频生成采用不同速率,也允许安全层检查最终动作。风险是接口丢信息:若 Thinker 只输出文字摘要,精确韵律、像素布局或运动轨迹可能无法传给生成器。
另一种单体路线让共享 hidden state 直接条件化多个输出 head。它减少显式信息瓶颈,却让训练、缓存和故障隔离更复杂。判断时应画出真实数据流,而不是用“端到端”作为优劣结论。
评测是一张输入—输出矩阵
系统有输入集合 \(\mathcal I\) 和输出集合 \(\mathcal O\),评测至少覆盖矩阵
以及多输入、多输出组合。只测 image→text 和 text→image,不能证明 image+audio→speech 或 video→image editing。
| 维度 | 需要报告 |
|---|---|
| 单模态基础 | 每个 encoder/decoder 的独立上限 |
| 跨模态依赖 | 替换、静音、遮挡、时间打乱后的变化 |
| 交错输入 | 多轮、多媒体、segment 绑定与指代 |
| 并发输出 | 文本/语音/媒体一致性和提交顺序 |
| 时间 | 首包、稳定 partial、打断、端到端延迟 |
| 成本 | encoder、prefill、decode/solver、cache 与带宽 |
| 鲁棒性 | 缺失模态、late packet、重连和状态恢复 |
| 安全 | 媒体内注入、身份/声音滥用、动作权限 |
对组合任务还要保留因果对照:静音后答案是否失去声音证据,替换图片后描述是否变化,打乱视频后事件顺序是否变化。单一主观偏好无法定位是感知、推理还是 renderer 改善。
系统边界与安全
媒体内容属于不可信输入。图片中的文字、音频中的口令、视频字幕或网页截图都不能自动提升工具和动作权限。系统至少需要:
- 把感知内容与控制指令分离;
- 对身份、声纹和参考图取得授权;
- 记录生成媒体来源与编辑历史;
- 对外部模型、搜索和工具调用显示真实路由;
- 对语音播放、文件写入和物理动作设置不同提交门槛;
- 在缓存、日志和训练反馈中分别处理原始媒体与派生表示。
全模态系统的优势是信息流更连贯,风险也是信息流更连贯:一个模态中的恶意或错误内容可能影响另一模态输出,必须在共享状态和输出执行之间保留边界。
怎样阅读公开系统
对快速变化的模型,先建立可核验矩阵:
- 接受哪些原始模态,是否需要外部预处理;
- 直接输出哪些模态,是否调用独立生成器;
- 是否支持交错输入、流式输出和打断;
- 哪些架构、数据和指标有论文或系统卡;
- 哪些仅有产品演示,哪些有开放代码与权重;
- 版本何时核验,更新后哪些结论可能失效。
截至 2026-07-28,公开系统的能力迭代快于完整架构披露。机制章节应以可复核论文为主,产品页用于记录接口、模型卡和限制,不应由演示反推未公开训练方法。
交错媒体、模态 mask 与流式时钟的组合测试见多模态手撕实现。
Reference
- Kaiser et al., One Model To Learn Them All
- Jaegle et al., Perceiver IO: A General Architecture for Structured Inputs and Outputs
- Girdhar et al., ImageBind: One Embedding Space To Bind Them All
- Team Chameleon, Chameleon: Mixed-Modal Early-Fusion Foundation Models
- Zhou et al., Transfusion: Predict the Next Token and Diffuse Images with One Multi-Modal Model
- Wu et al., Janus: Decoupling Visual Encoding for Unified Multimodal Understanding and Generation
- Défossez et al., Moshi: a Speech-Text Foundation Model for Real-Time Dialogue
- Xu et al., Qwen2.5-Omni Technical Report
- OpenAI, GPT-4o System Card
- Gemini Team, Gemini: A Family of Highly Capable Multimodal Models