模型并行
当一个模型层、完整模型或长序列无法在单设备上高效运行时,需要沿张量、层、序列或专家维度切分。组合并行的目标不是让并行度乘积等于 GPU 数,而是让每种通信匹配合适的互联和计算粒度。
Megatron 的 tensor parallel 与 ZeRO 的状态分片解决的是不同复制对象。分布式训练系统给出从数据并行到多维并行的历史主线,Megatron 与 ZeRO 则用最小张量账本展示二者怎样组合而不混淆。
Tensor Parallel
设线性层 \(Y=XW\)。
Column parallel
按输出维切分权重:
每个 rank 计算一部分输出。若下一算子可直接消费分片,暂时无需 all-gather。
Row parallel
按输入维切分:
局部结果需要 all-reduce 或 reduce-scatter。Megatron-LM 通过组合 column/row parallel,使 Transformer MLP 和 attention 中的通信落在少数边界。
Tensor-parallel 线性层
为贴合公式,weight 使用 [in,out] 约定。column parallel 沿输出维切权重并拼接局部结果;row parallel 同时沿输入维切输入和权重,再对局部结果求和。reference 返回完整张量,以便直接与 dense 路径比较。
import torch

def column_parallel_linear(x, weight, parts):
    assert weight.shape[1] % parts == 0
    shards = torch.chunk(weight, parts, dim=1)
    return torch.cat([x @ shard for shard in shards], dim=-1)

def row_parallel_linear(x, weight, parts):
    assert x.shape[-1] % parts == 0
    xs = torch.chunk(x, parts, dim=-1)
    shards = torch.chunk(weight, parts, dim=0)
    return torch.stack([xi @ wi for xi, wi in zip(xs, shards)]).sum(dim=0)

torch.manual_seed(0)
x, weight = torch.randn(3, 8), torch.randn(8, 12)
dense = x @ weight
torch.testing.assert_close(column_parallel_linear(x, weight, 4), dense)
torch.testing.assert_close(row_parallel_linear(x, weight, 4), dense)
assert column_parallel_linear(x, weight, 4).shape == (3, 12)
核心不变量是每个 shard 对全局维度恰好覆盖一次。生产实现通常让 column 输出继续保持分片,并用 all-reduce 或 reduce-scatter 实现 row 的求和;bias placement、process group、通信 dtype 和异步生命周期不属于这个单进程 reference。并行 linear 与 pipeline bubble 的组合实验见手撕:分布式与容错。
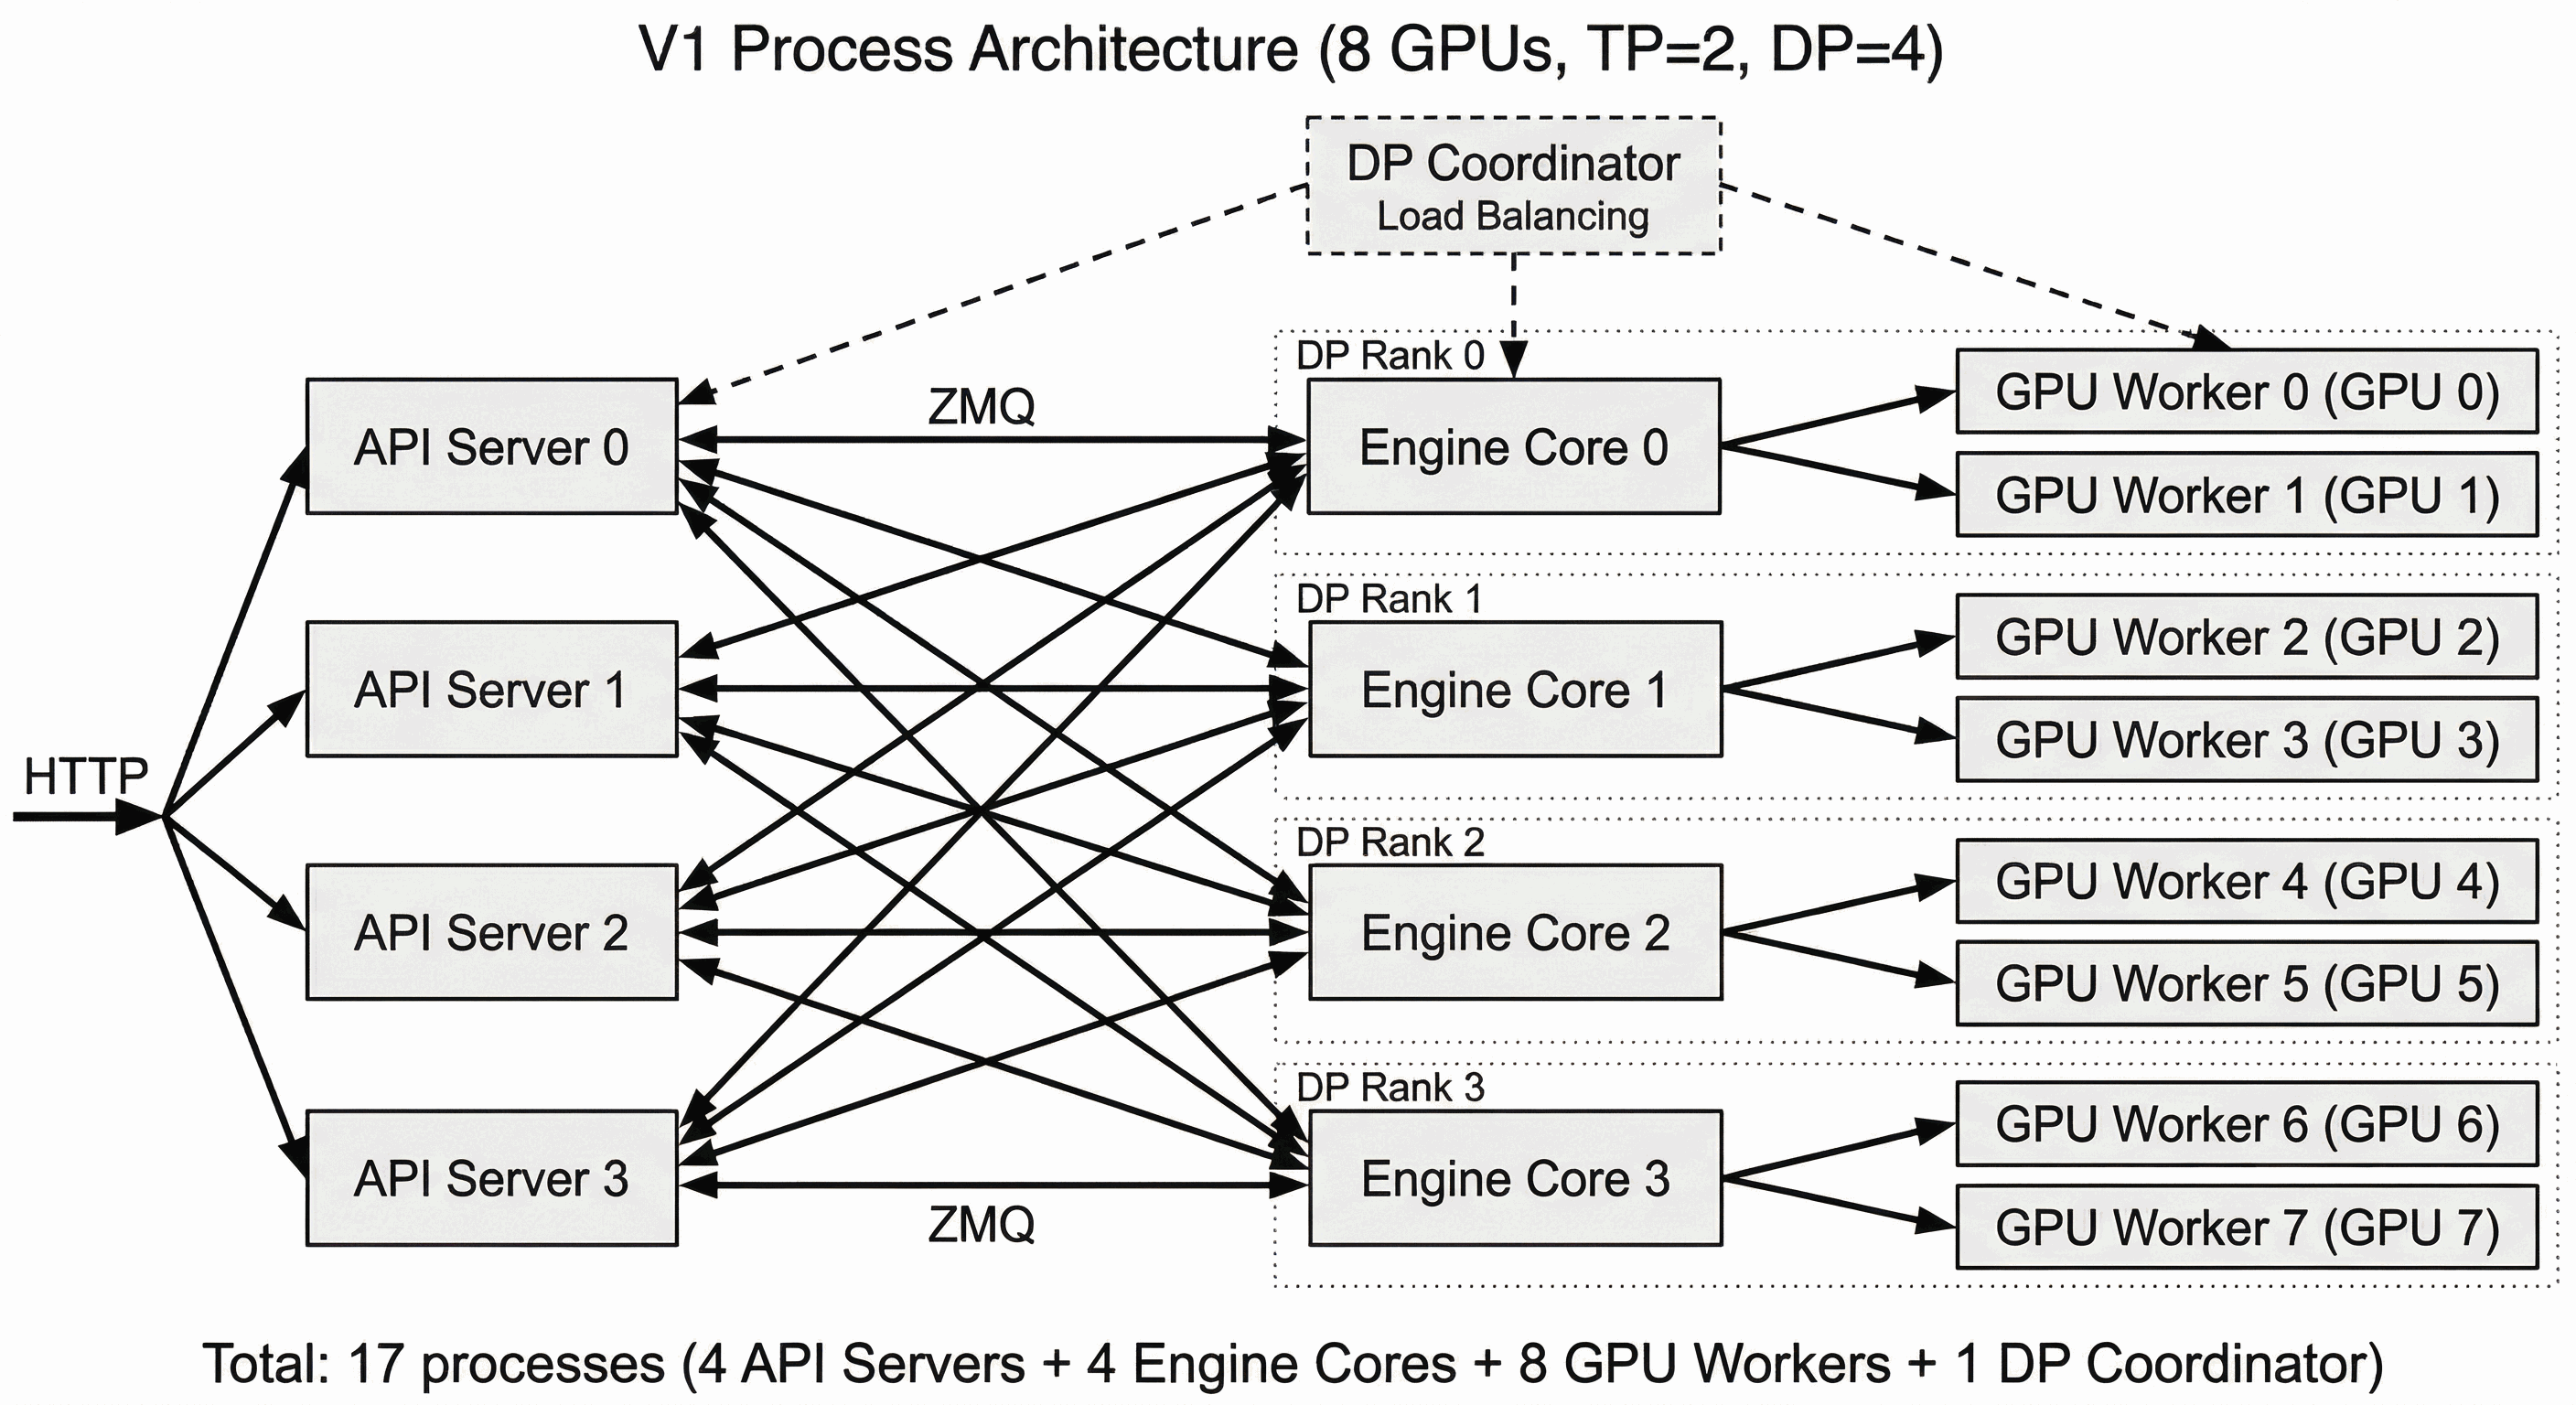
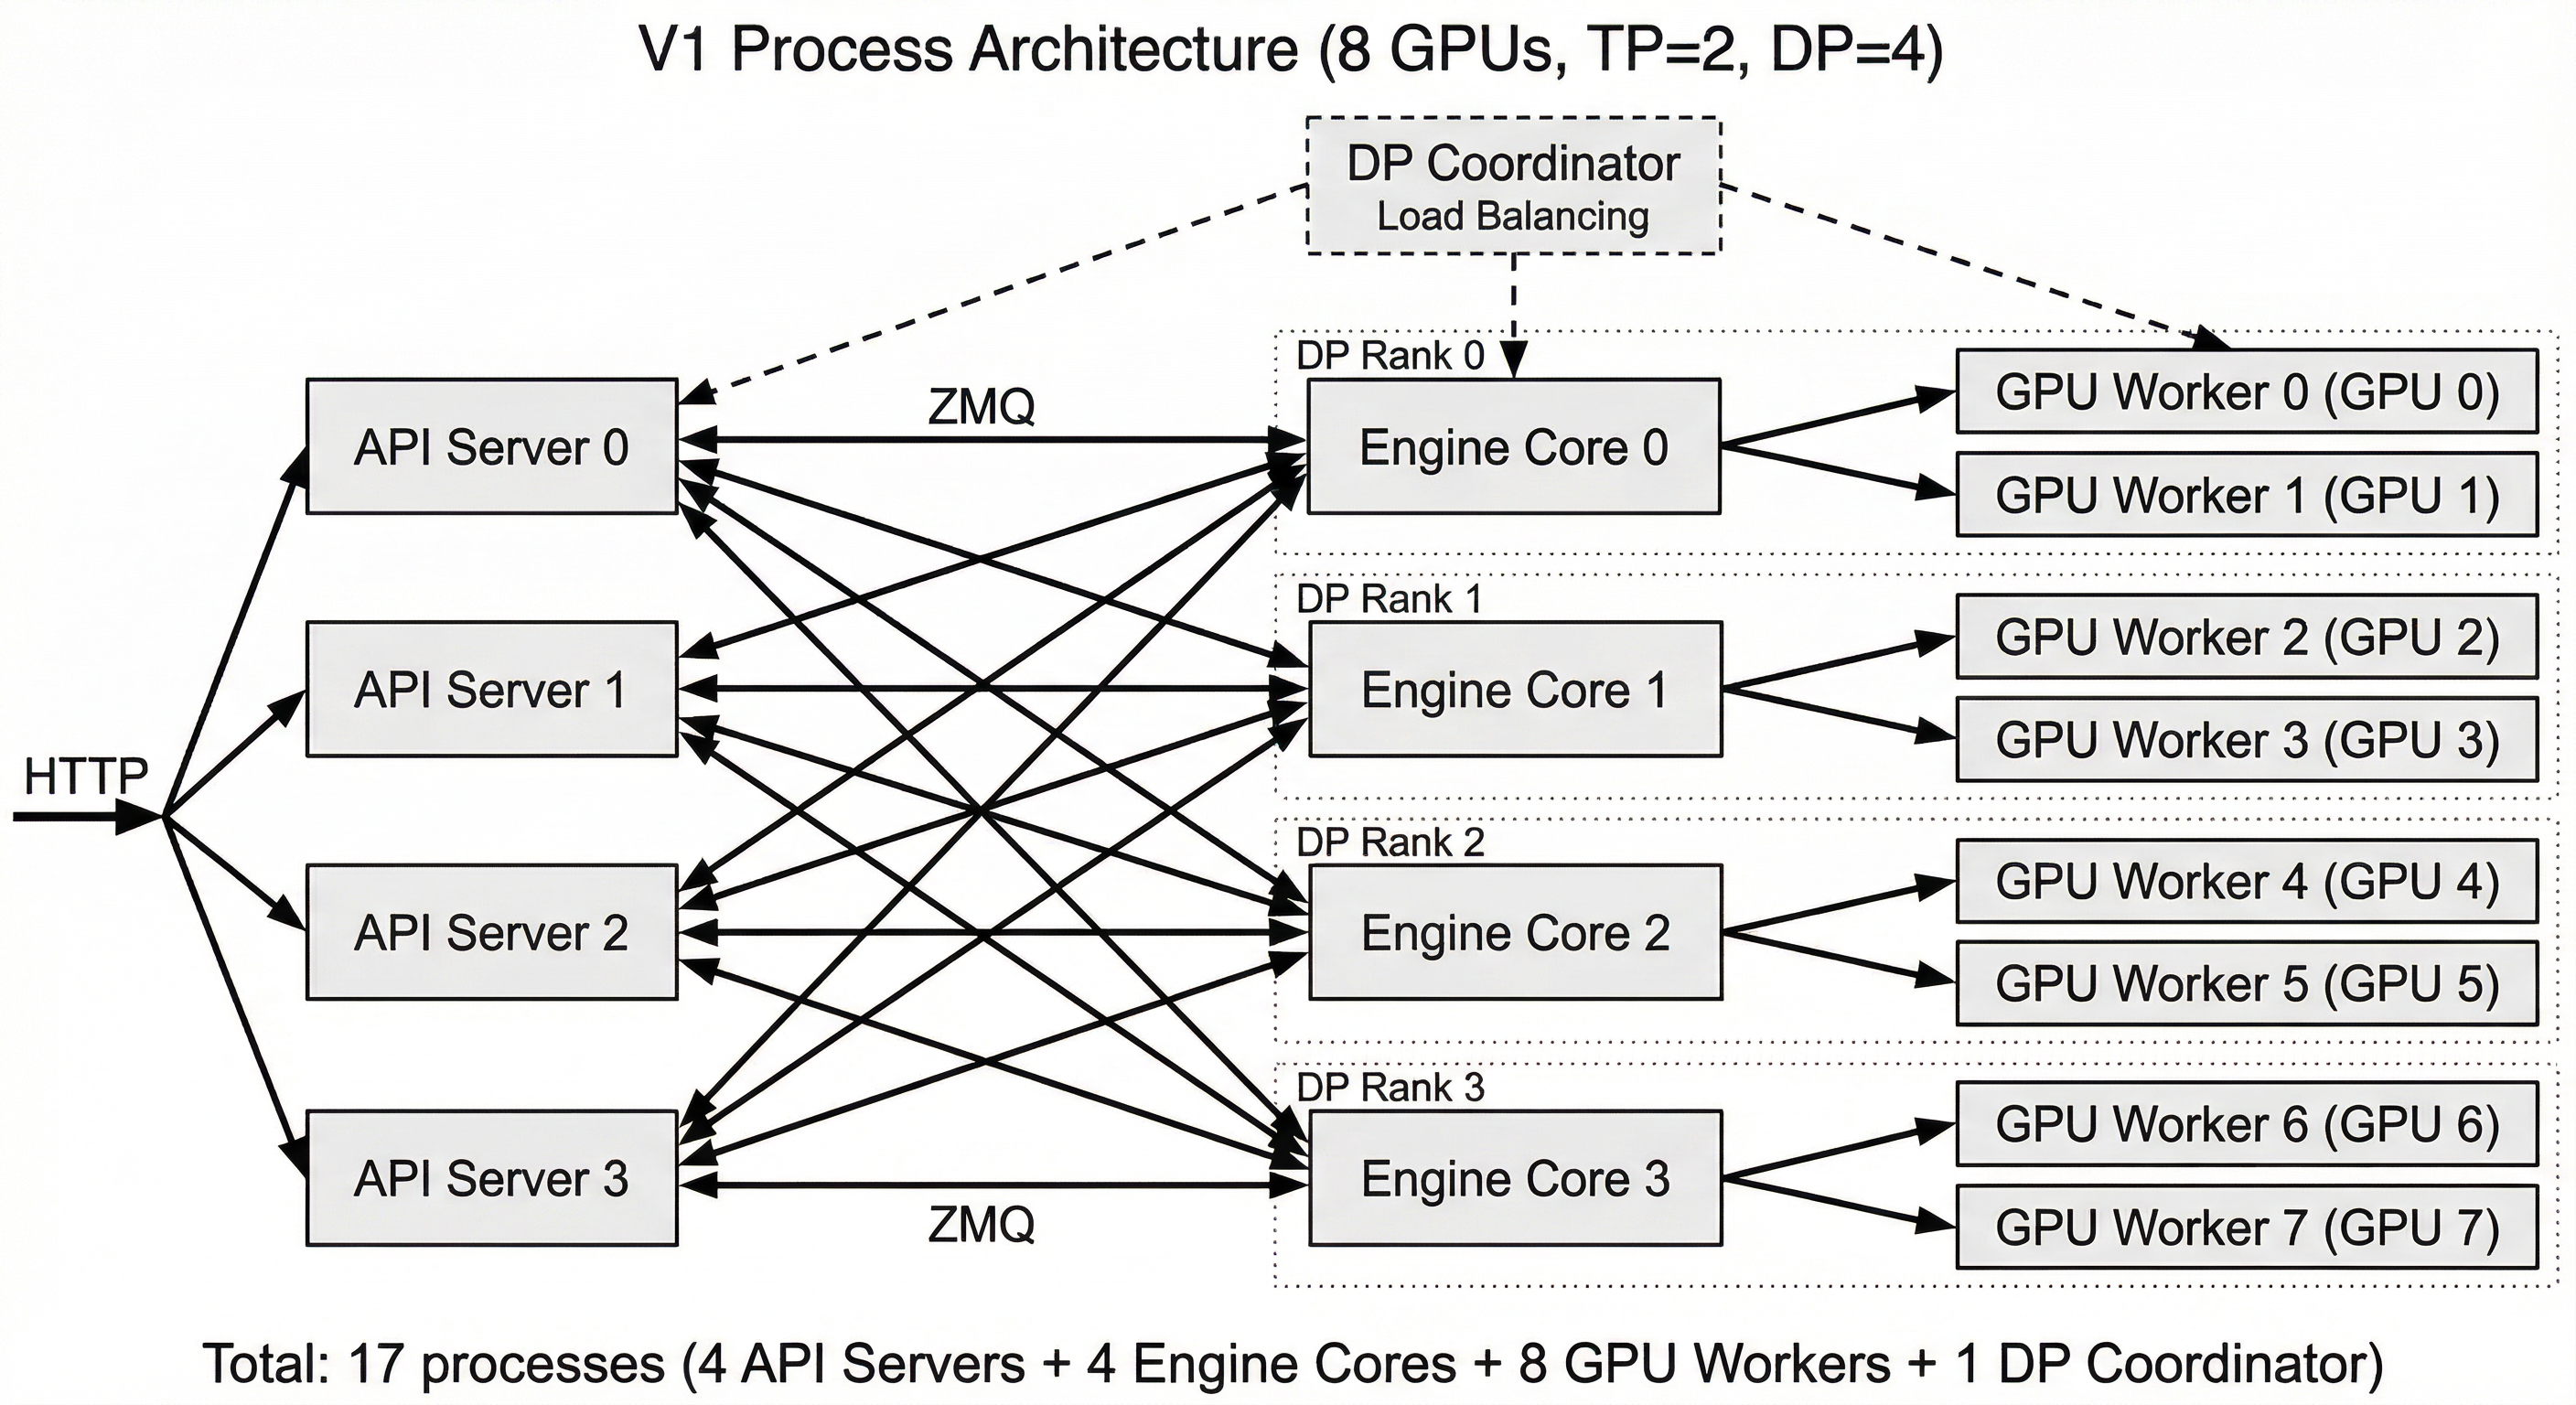
TP 通信频繁、粒度随每层发生,通常优先放在 NVLink/NVSwitch 等高速节点内互联。
Sequence Parallel
tensor parallel 后,部分 norm、dropout 和 residual activation 仍在每个 TP rank 重复。sequence parallel 沿 token 维分片这些逐 token 操作,在需要进入 column-parallel 层时做布局转换。它主要节省 activation,而不是把 attention 的完整上下文自动分片。
Pipeline Parallel
将连续层分配给 \(p\) 个 stage,再把 batch 拆成 \(m\) 个 microbatch。简单 GPipe 调度先完成所有 forward,再完成 backward,空泡比例近似
GPipe 展示了这种批次流水。1F1B 在 warmup 后交错 forward/backward,降低在途 activation 峰值;interleaved schedule 让一个设备持有多个虚拟 stage,以更细粒度填空泡。
零空泡方向
反向可分为输入梯度与参数梯度两部分。输入梯度位于关键路径,参数梯度通常有更灵活的调度空间。Zero Bubble Pipeline Parallelism 利用这种分解搜索更紧凑的同步 schedule。所谓 zero bubble 依赖理想平衡、内存预算和 optimizer 同步条件,实际系统仍可能受 stage 不均、通信和 host launch 限制。
Context Parallel
长序列 attention 需要每个 query 访问远端 K/V。context parallel 将 token block 分布到多个设备,可采用:
- all-gather K/V 后本地 attention;
- ring 传递 K/V block,并在线合并 softmax 统计;
- 分层或局部—全局 pattern;
- 与 sequence parallel、head parallel 混合。
Ring Attention 让 K/V block 沿环传递,并尝试用本地 block attention 覆盖通信。每个 query block 的 softmax 需要跨 block 保持全局最大值和归一化分母,不能独立 softmax 后简单相加。
仿射状态的 context parallel
若序列模块的一个 segment 可压缩成
两个相邻 segment 的变换可结合:
这个 combine 具有结合性,因此每个 context rank 可先本地计算固定大小的 \((M,\widetilde S)\),再 all-gather 并做 prefix scan,而不必收集整段 token 状态。下面用小矩阵验证组合方向:
import torch

def compose_affine(first, second):
    ma, ba = first
    mb, bb = second
    if ma.ndim != 2 or mb.shape != ma.shape or ba.shape != bb.shape:
        raise ValueError("affine summaries must align")
    return mb @ ma, mb @ ba + bb

ma, mb = torch.tensor([[2., 0.], [0., .5]]), torch.tensor([[1., 1.], [0., 2.]])
ba, bb = torch.tensor([1., -1.]), torch.tensor([.5, 2.])
x = torch.tensor([3., 4.])
mc, bc = compose_affine((ma, ba), (mb, bb))
torch.testing.assert_close(mc @ x + bc, mb @ (ma @ x + ba) + bb)
Kimi K3 技术报告把这一路线称为 KDA Context Parallelism(KCP)。其收益依赖局部 state 计算、固定大小 summary 通信和 scan 是否能重叠;只有递推确实可写成结合的 segment summary 时才成立,不能套到任意 attention。具体部署见 Kimi K3,KDA 算法入口见 Kimi Linear。
压缩 Attention 的 context parallel
DeepSeek-V4 CSA/HCA 按固定 token block 生成 compressed entries,block 可能跨 context rank。V4 的协议先把每个 rank 尾部 \(m\) 个元素作为 halo 传给下一 rank,本地生成固定数量、带 padding 的压缩项,再 all-gather,最后按全局因果可见性 fused select-and-pad。
padding 不是任意对齐:query 只能访问已经完整闭合的压缩块;当前未完成块由 SWA 路径处理。如果各 rank 独立从本地起点分块,压缩边界、position bias 和 top-\(k\) 候选都会随 CP degree 改变,模型语义不再保持。训练框架与 cache layout 见 V4 系统闭环。
Expert Parallel
MoE 将专家放在不同 rank,token 经 all-to-all dispatch 到目标专家,再 combine 回原顺序。通信发生在 token 表示上,而 TP 通信发生在层内部分结果上。两者组合时需要决定:
- 专家内部是否再做 TP;
- EP group 是否跨节点;
- shared expert 放在哪里;
- token permutation、padding 和负载统计;
- dispatch 与 expert GEMM 怎样重叠。
路由与容量见 Mixture of Experts。
组合成多维网格
总 world size 可写为
但并非每个维度都能任意同时使用。EP 与 DP 可能共享或正交分组;CP 影响序列 batch;PP 又要求 stage 参数和计算平衡。
常见映射原则:
- TP 放在最快互联内;
- PP 的相邻 stage 尽量有稳定点对点带宽;
- EP 根据 all-to-all 流量与专家大小决定是否跨节点;
- DP 容忍较低频的大 collective,可跨更大范围;
- CP 的持续 K/V 交换需要专门评估拓扑。
内存与计算的选择顺序
- 先做显存账本,确定是状态、activation 还是单层放不下。
- 用 activation checkpointing 与状态分片解决可复制部分。
- 单层放不下或 GEMM 过大时加入 TP。
- 模型深度与集群规模继续增加时加入 PP。
- 长序列受限时加入 CP/SP。
- MoE 根据专家布局加入 EP。
这个顺序不是硬规则,但能避免在问题尚未定位时同时引入五种通信。
验证矩阵
- 单卡 FP32 reference 与分布式 logits/loss 对齐;
- 每个并行维度单独启用,再组合;
- 固定 seed 下比较一个 optimizer step;
- 记录参数、梯度和 optimizer shard 的全局覆盖;
- 做强扩展、弱扩展与拓扑变换;
- 注入 rank 失败并验证 checkpoint 恢复;
- 分别报告计算、通信、空泡和未重叠时间。
collective 语义见集合通信与分片,算子效率见 Kernel 与性能。