GLM 演化案例
GLM 家族总览负责语言、代码、多模态、语音、生成与 Agent 分支的公开产物边界;本页集中追踪通用语言主干的版本变化。
GLM 的版本史不能只按模型名排列。早期的 General Language Model 是一种预训练目标,GLM-130B 是 130B(约 1300 亿参数)的双语扩展,ChatGLM 把模型带入对话与工具使用,GLM-4.5 以后又转向 MoE、推理与 Agent。论文、权重、参考代码、API 和许可证往往在不同日期发布;只有把它们拆开,才能判断某个结论究竟适用于哪一个对象。
六个彼此独立的版本维度
| 维度 | 回答的问题 | 常见误读 |
|---|---|---|
| paper | 哪些机制、数据、实验被正式披露 | 把论文日期当成模型上线日 |
| weights | 哪个 checkpoint 可以下载 | 把同名 API 当成公开权重的逐位副本 |
| code | 是否有训练、推理或仅示例代码 | 看到仓库就推断完整训练栈已公开 |
| API | 服务端暴露哪个模型标识与行为契约 | 用今天的 API 行为解释历史 checkpoint |
| license | 代码与模型参数分别允许怎样使用 | 用仓库的 Apache-2.0 覆盖权重的单独许可 |
| date | 首次论文、修订、权重与服务各在何时发生 | 用一个月份代表全部发布事件 |
因此,本页的箭头表示 公开谱系或阶段转换,不表示所有内部机制逐代原样继承。
事件台账
| 日期 | 阶段 | paper | weights / code | API | license 边界 |
|---|---|---|---|---|---|
| 2021-03-18 | GLM | blank infilling 论文 | 参考实现 | 无同名公共旗舰 API 证据 | 代码仓库为 MIT |
| 2022-10-05 | GLM-130B | 双语 130B 报告 | 权重、训练日志与工具 | 不是后来 ChatGLM API 的同义名 | 代码为 Apache-2.0;参数采用单独的非商业研究许可 |
| 2023-03-14 | ChatGLM-6B | 后由家族报告回顾 | 6B 权重与推理代码 | 产品服务与仓库 checkpoint 分开记录 | 代码与参数许可分离,参数不是无条件 Apache-2.0 |
| 2023-06-25 | ChatGLM2-6B | 家族报告统一回顾 | 第二代 checkpoint | 同名在线服务可能继续更新 | 参数采用 ChatGLM2-6B 专用许可 |
| 2023-10-27 | ChatGLM3-6B | 家族报告统一回顾 | Base、Chat 与 Agent 工具链 | 工具协议属于模型—运行时接口 | 代码为 Apache-2.0;参数许可另列,商业使用曾要求登记 |
| 2024-06-05 / 06-18 | GLM-4 | GLM-4 / All Tools 报告 | GLM-4-9B、Chat、1M 与 4V | GLM-4、Air 与 All Tools 服务不能由 9B 权重替代解释 | 仓库代码为 Apache-2.0;各 checkpoint 以对应模型卡为准 |
| 2025-04-14 | GLM-4-0414 | 没有新的家族总报告 | 32B 系列发布记录 | 产品 checkpoint 更新 | 不沿用旧模型的参数许可作推断 |
| 2025-07-28 / 08-08 | GLM-4.5 | 技术报告 | Base、Chat、Air 与 FP8 权重,代码仓库 | 发布时同步提供 API | 公开权重模型卡标注 MIT;代码仓库为 Apache-2.0 |
| 2025-09-30 | GLM-4.6 | 继续引用 GLM-4.5 报告 | 公开权重,实现入口 | GLM-4.6 API 与发布说明 | 权重模型卡标注 MIT;不能把报告日期改写为 4.6 论文日期 |
| 2025-12-22 | GLM-4.7 | 继续引用 GLM-4.5 报告 | 公开权重,实现入口 | GLM-4.7 API 与发布说明 | 权重模型卡标注 MIT;Preserved Thinking 还依赖服务或客户端的上下文协议 |
| 2026-02-12 / 02-17 | GLM-5 | 技术报告 | BF16 / FP8 权重与部署入口 | 2 月 12 日进入发布台账 | 代码仓库为 Apache-2.0;公开权重模型卡标注 MIT |
| 2026-04-07 | GLM-5.1 | 没有独立的同规模总报告,模型卡仍引用 GLM-5 报告 | GLM-5.1 权重 | 长程 Agent 更新 | 权重模型卡标注 MIT;不能把 5.1 的后训练结论倒写进 5.0 报告 |
| 2026-06-16 | GLM-5.2 | 以技术博客补充新机制,仍以 GLM-5 报告作为家族论文 | GLM-5.2 权重 | 1M context、effort control 与新模型标识同步上线 | 权重标注 MIT;博客披露不等于完整训练报告 |
日期取论文首次公开日或官方发布台账日。对同一行中的两个日期,前者和后者分别对应不同公开事件,不应合并成模糊的“发布日期”。
第一阶段:blank infilling 是起点,不是永恒标签
2021 年 GLM 的核心问题是:能否用一个模型同时覆盖自然语言理解、无条件生成和条件生成。它把输入中的若干 span 替换为占位符,再按随机顺序自回归地恢复这些 span。若被遮蔽的片段为 \(s_1,\ldots,s_m\),训练目标可写成
其中 \(\pi\) 是片段的随机生成顺序。二维位置编码分别表达原文本位置与片段内部位置,使模型既能看到双向上下文,又能自回归地产生缺失片段。
这解释了家族名称的来源,却不能推出 GLM-4.5 或 GLM-5 仍以同一目标、同一 attention mask 或同一位置编码训练。后续报告若没有明确披露,就应把继承关系标成未知,而不是从品牌名补齐。
第二阶段:GLM-130B 把问题变成规模与稳定性
GLM-130B 将双语预训练推到 130B 参数,并把训练发散、loss spike、并行效率与 INT4 部署写进同一份报告。它的重要性不只是参数量,而是公开了大规模训练“为什么会失败”:
- 模型结构与目标要能在中英文数据上共同扩展;
- 张量并行、流水并行与数据并行必须围绕真实硬件拓扑协同;
- loss spike 需要监控、回滚和配方调整,不能只靠最终 loss 曲线解释;
- 权重量化属于部署工件,不能由浮点 benchmark 直接替代验证。
这里建立的是工程经验谱系。它不意味着 ChatGLM-6B 是 130B checkpoint 的简单缩小,也不意味着后续 API 复用了完全相同的 tokenizer、位置编码或训练数据。
第三阶段:ChatGLM 从对话对齐走向工具协议
ChatGLM-6B、ChatGLM2-6B 与 ChatGLM3-6B 的共同变化,是模型从“续写一个序列”转向“在多轮协议中扮演 assistant”。这至少增加四层对象:
- chat template 与角色 token;
- 指令数据、偏好对齐与安全约束;
- 长上下文和多轮状态管理;
- function call、代码解释器与 Agent runtime。
ChatGLM3 的工具调用尤其说明:工具能力不是模型权重的一个单独分数。schema 如何注入、模型如何产生结构化参数、运行时怎样执行、结果如何回填,都会改变最终行为。2024 年的 GLM-4 All Tools 把浏览器、Python、文生图与用户函数纳入统一决策流程,进一步把评测单位从“单次回答”推向“模型—工具—环境”的闭环。
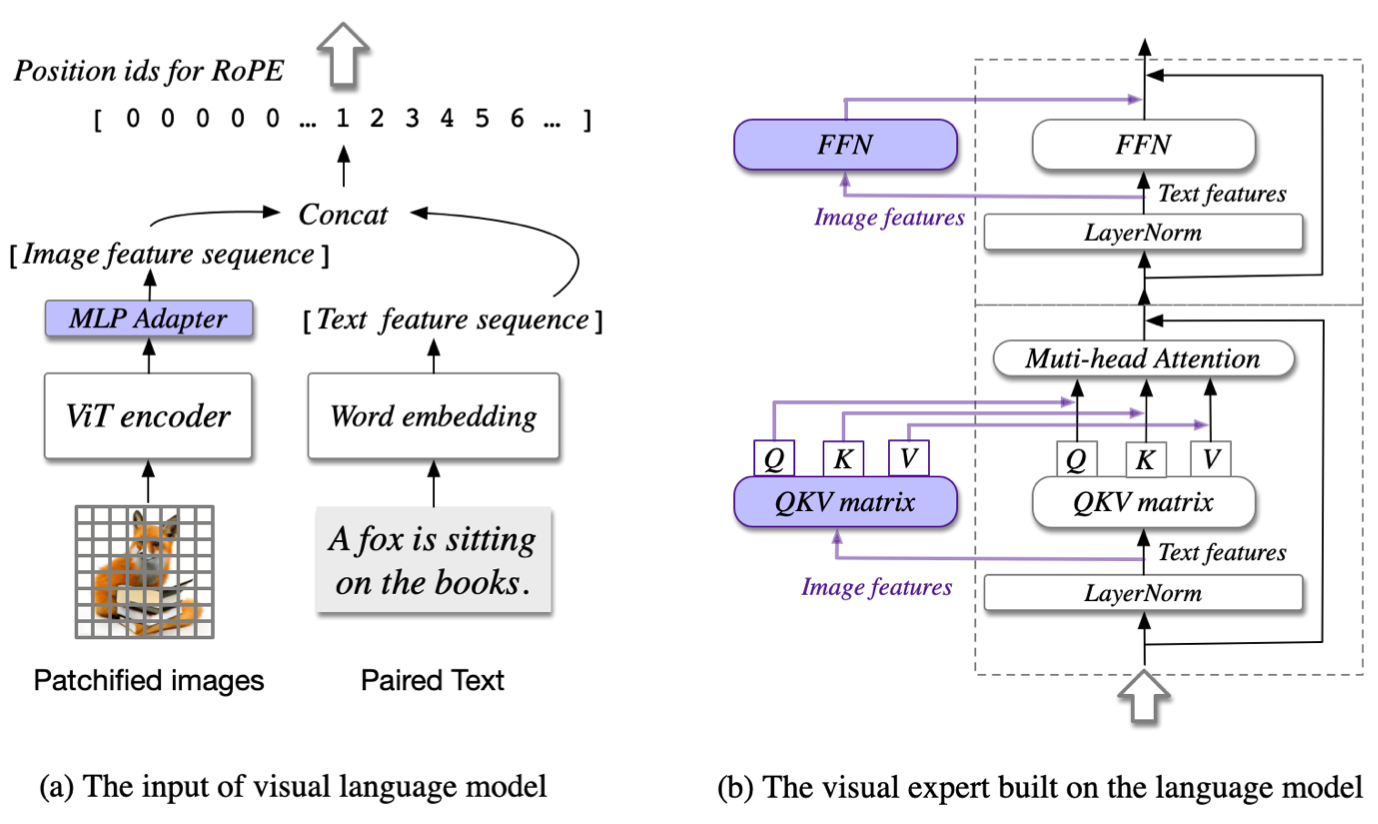
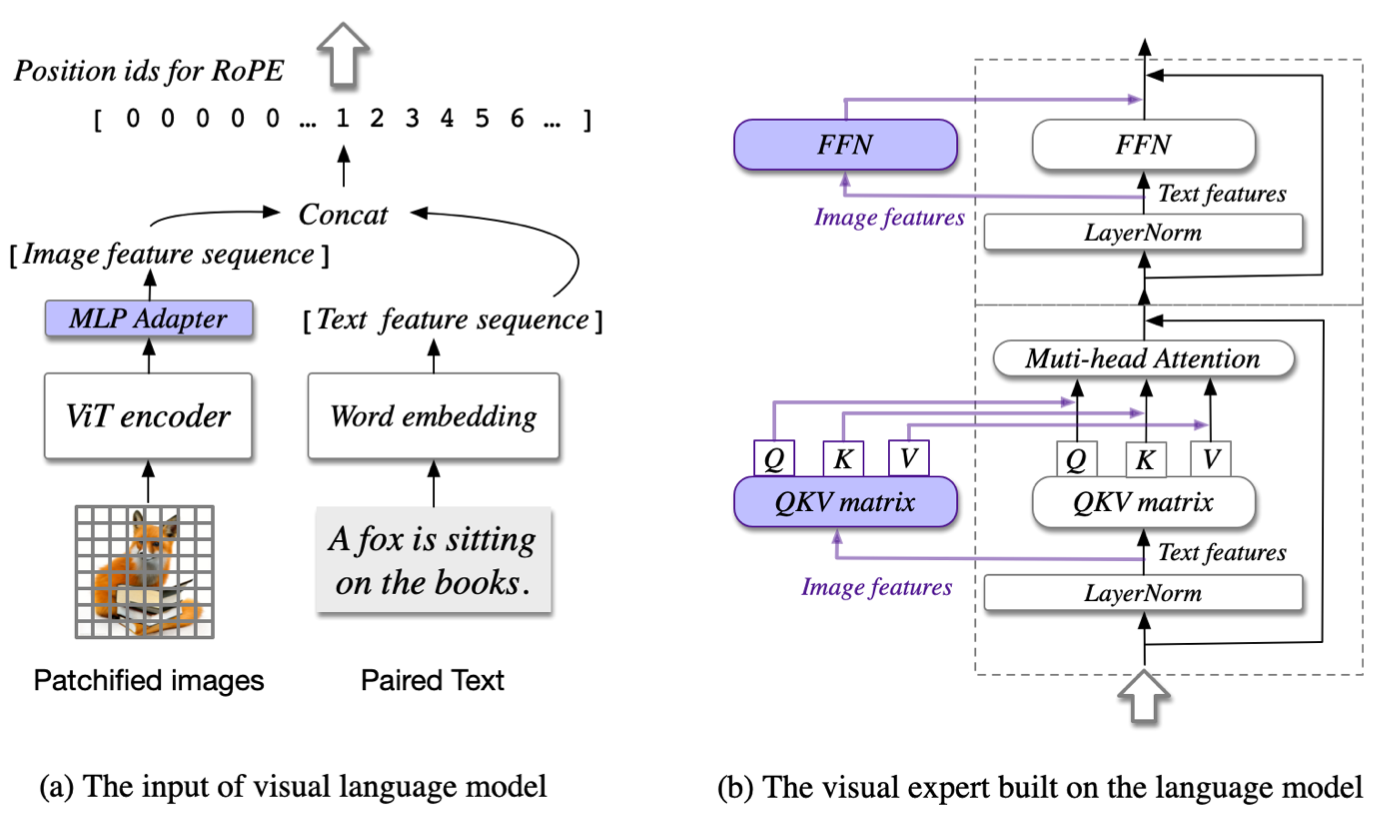
第四阶段:GLM-4.5 重写模型主干
GLM-4.5 是清晰的架构分界点:主干转向稀疏 MoE,并把 reasoning、coding 与 agentic task 放进同一模型。公开报告给出的主线包括:
- 355B 总参数、32B 激活参数的 GLM-4.5,以及 106B / 12B 的 Air;
- loss-free balance routing 与 sigmoid gate;
- GQA、partial RoPE、QK-Norm 与更深的网络;
- Muon 优化器;
- thinking / non-thinking 双模式;
- 以 slime 支撑异步 rollout 与大规模 Agentic RL。
4.6 与 4.7 更像同一公开架构上的连续 checkpoint:4.6 把 context 从 128K 扩到 200K 并强化 coding / tool use;4.7 增强 interleaved thinking,引入 preserved thinking 与 turn-level thinking。它们的模型卡仍引用 GLM-4.5 报告,所以“能力更新已公开”和“完整训练配方已重新披露”是两件事。
第五阶段:GLM-5 把注意力、规模与 Agentic RL 合流
GLM-5 把总参数扩到约 744B、激活参数约 40B,预训练 token 增至约 28.5T,并采用 DeepSeek Sparse Attention。DSA 先用轻量 indexer 为 query 选择历史 token,再只对 top-\(k\) 项执行主 attention:
它同时改造 MLA head 配置、共享三步 MTP 参数,并把推测解码、训练内存、长序列并行、国产加速器部署与 Agentic RL 放进同一系统。详细机制与报告证据见 GLM-5 深读和引用图谱。
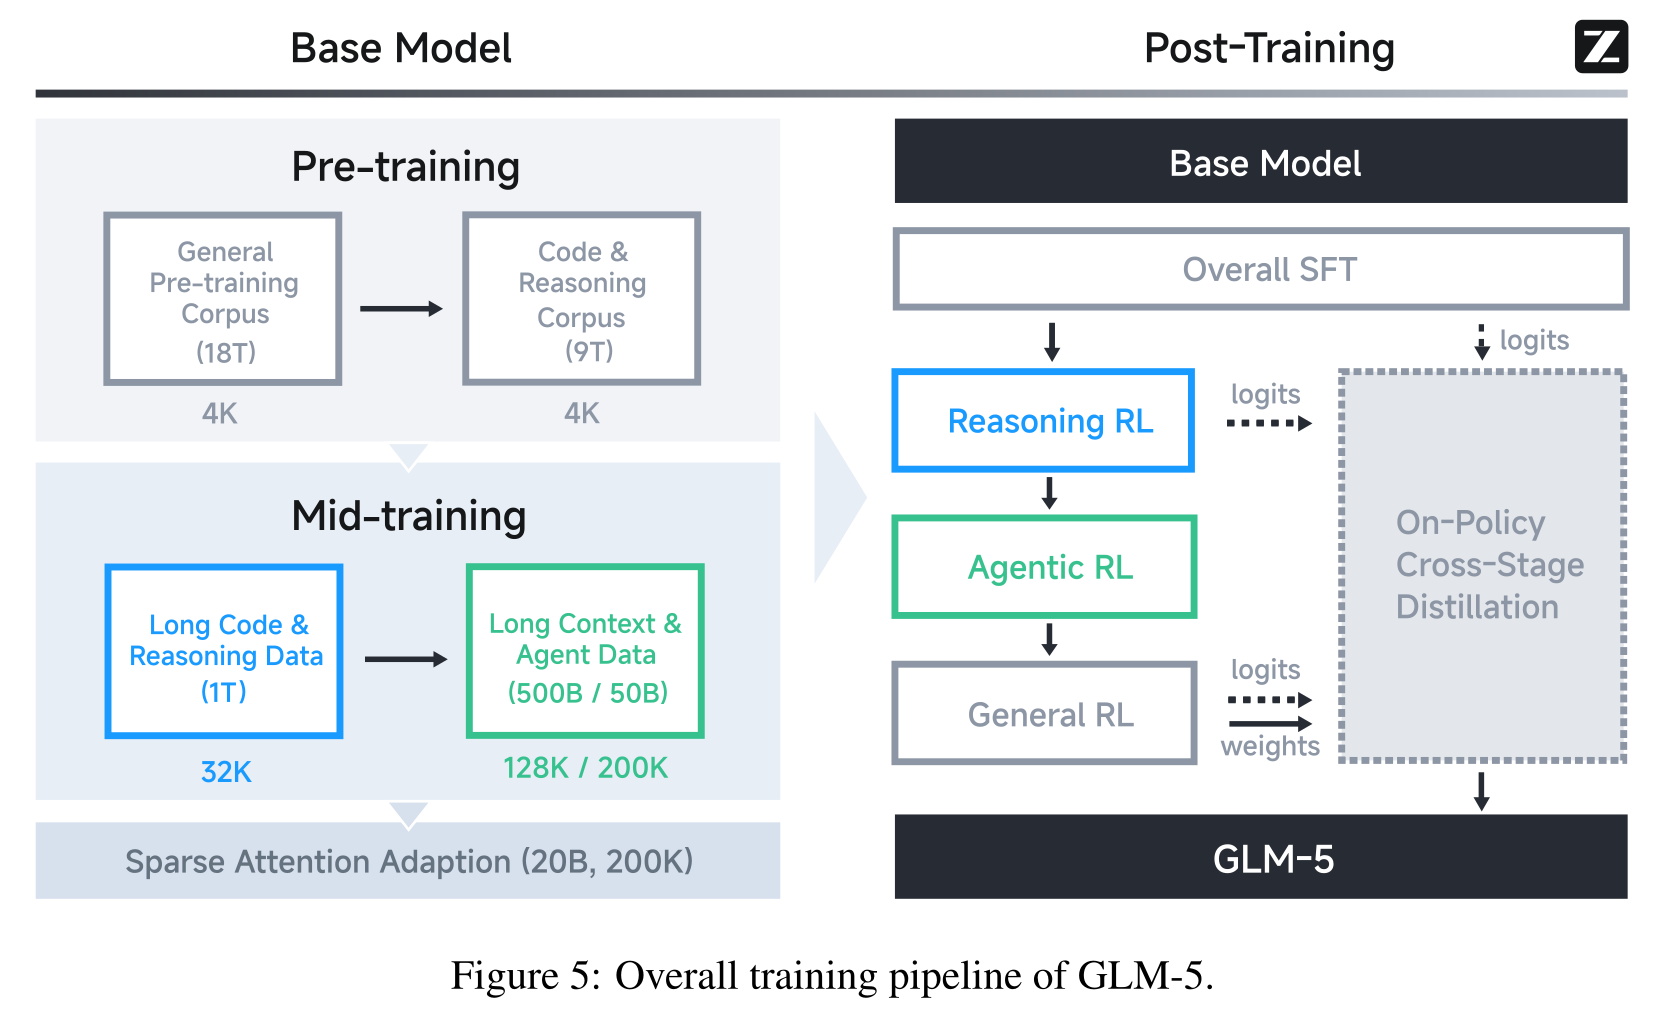
这里有两项不能被整齐时间线掩盖的报告内冲突:
- 正文称网络有 80 层;超参数附录写 3 个 dense layer 加 75 个 MoE layer,即 78 层,公开配置同样给出 78;
- Agentic RL 开头展示的简化目标没有显式 policy ratio / log-prob,且若只对组内中心化 reward 求和会恒为零;后文的 token-level importance ratio 与 masking 才提供实际优化线索。
因此,报告足以解释设计方向,却不足以逐行重建完整训练器。
第六阶段:5.1 与 5.2 是报告之后的演化
GLM-5.1 将重点推向更长时间的自主工程执行。它有新的权重、模型卡与 API 发布记录,但没有一份与 GLM-5 报告同等粒度的新总报告。能够安全写入谱系的是“checkpoint 与公开能力界面发生更新”;未披露的数据混合、RL 细节和消融不能从 5.0 或 5.2 反推。
GLM-5.2 再把最大 context 推到 1M,并公开两项可定位的新设计:
- IndexShare:每四个稀疏注意力层共享一套 indexer 结果,降低长上下文下的索引开销;
- MTP 更新:在多步草稿中共享 index 与 KV,引入 rejection sampling 和端到端 total-variation loss,提高推测解码接受长度。
这两项披露来自 5.2 技术博客和模型卡,而不是 2 月发布的 GLM-5 报告。后续的 IndexCache、Bebop、Single-Rollout Asynchronous Optimization 与 CompactionRL 可以解释长上下文服务和长程 RL 的进一步演化,但它们是报告之后的上下文节点,不能伪装成 GLM-5 正文引用。
如何阅读下一次更新
每次出现新版本时,先建立一行独立事件,而不是覆盖旧条目:
- paper 是否新增了可核对的结构、训练数字和消融;
- weights 是 base、post-trained、量化版还是只提供 API;
- code 是完整训练栈、推理适配器还是部署示例;
- API 是否改变 context、thinking、tool-call 或计费语义;
- license 对代码、参数、数据与衍生物分别怎样规定;
- benchmark 是否使用相同 harness、预算、日期与 judge。
只有这些列都能落到具体来源,版本箭头才表示知识;否则它只是一条产品时间线。
Reference
- GLM: General Language Model Pretraining with Autoregressive Blank Infilling
- GLM-130B: An Open Bilingual Pre-trained Model
- ChatGLM: A Family of Large Language Models from GLM-130B to GLM-4 All Tools
- GLM-4 official repository
- GLM-4.5: Agentic, Reasoning, and Coding Foundation Models
- GLM-4.5 official release
- GLM-4.6 official release
- GLM-4.7 official release
- GLM-5: From Vibe Coding to Agentic Engineering
- GLM-5 official repository
- Z.AI model release ledger
- GLM-5.1 official model card
- GLM-5.2 official release
- GLM-5.2 official model card