调度与服务
在线推理不是把离线 generate 包装成 HTTP。请求随机到达,prompt 与输出长度事前未知,KV Cache 随生成增长;一个错误的入场决定会在数秒后变成 OOM 或尾延迟。服务层的目标是在质量约束下,把有限的计算、显存和网络转化为满足 SLO 的 goodput。
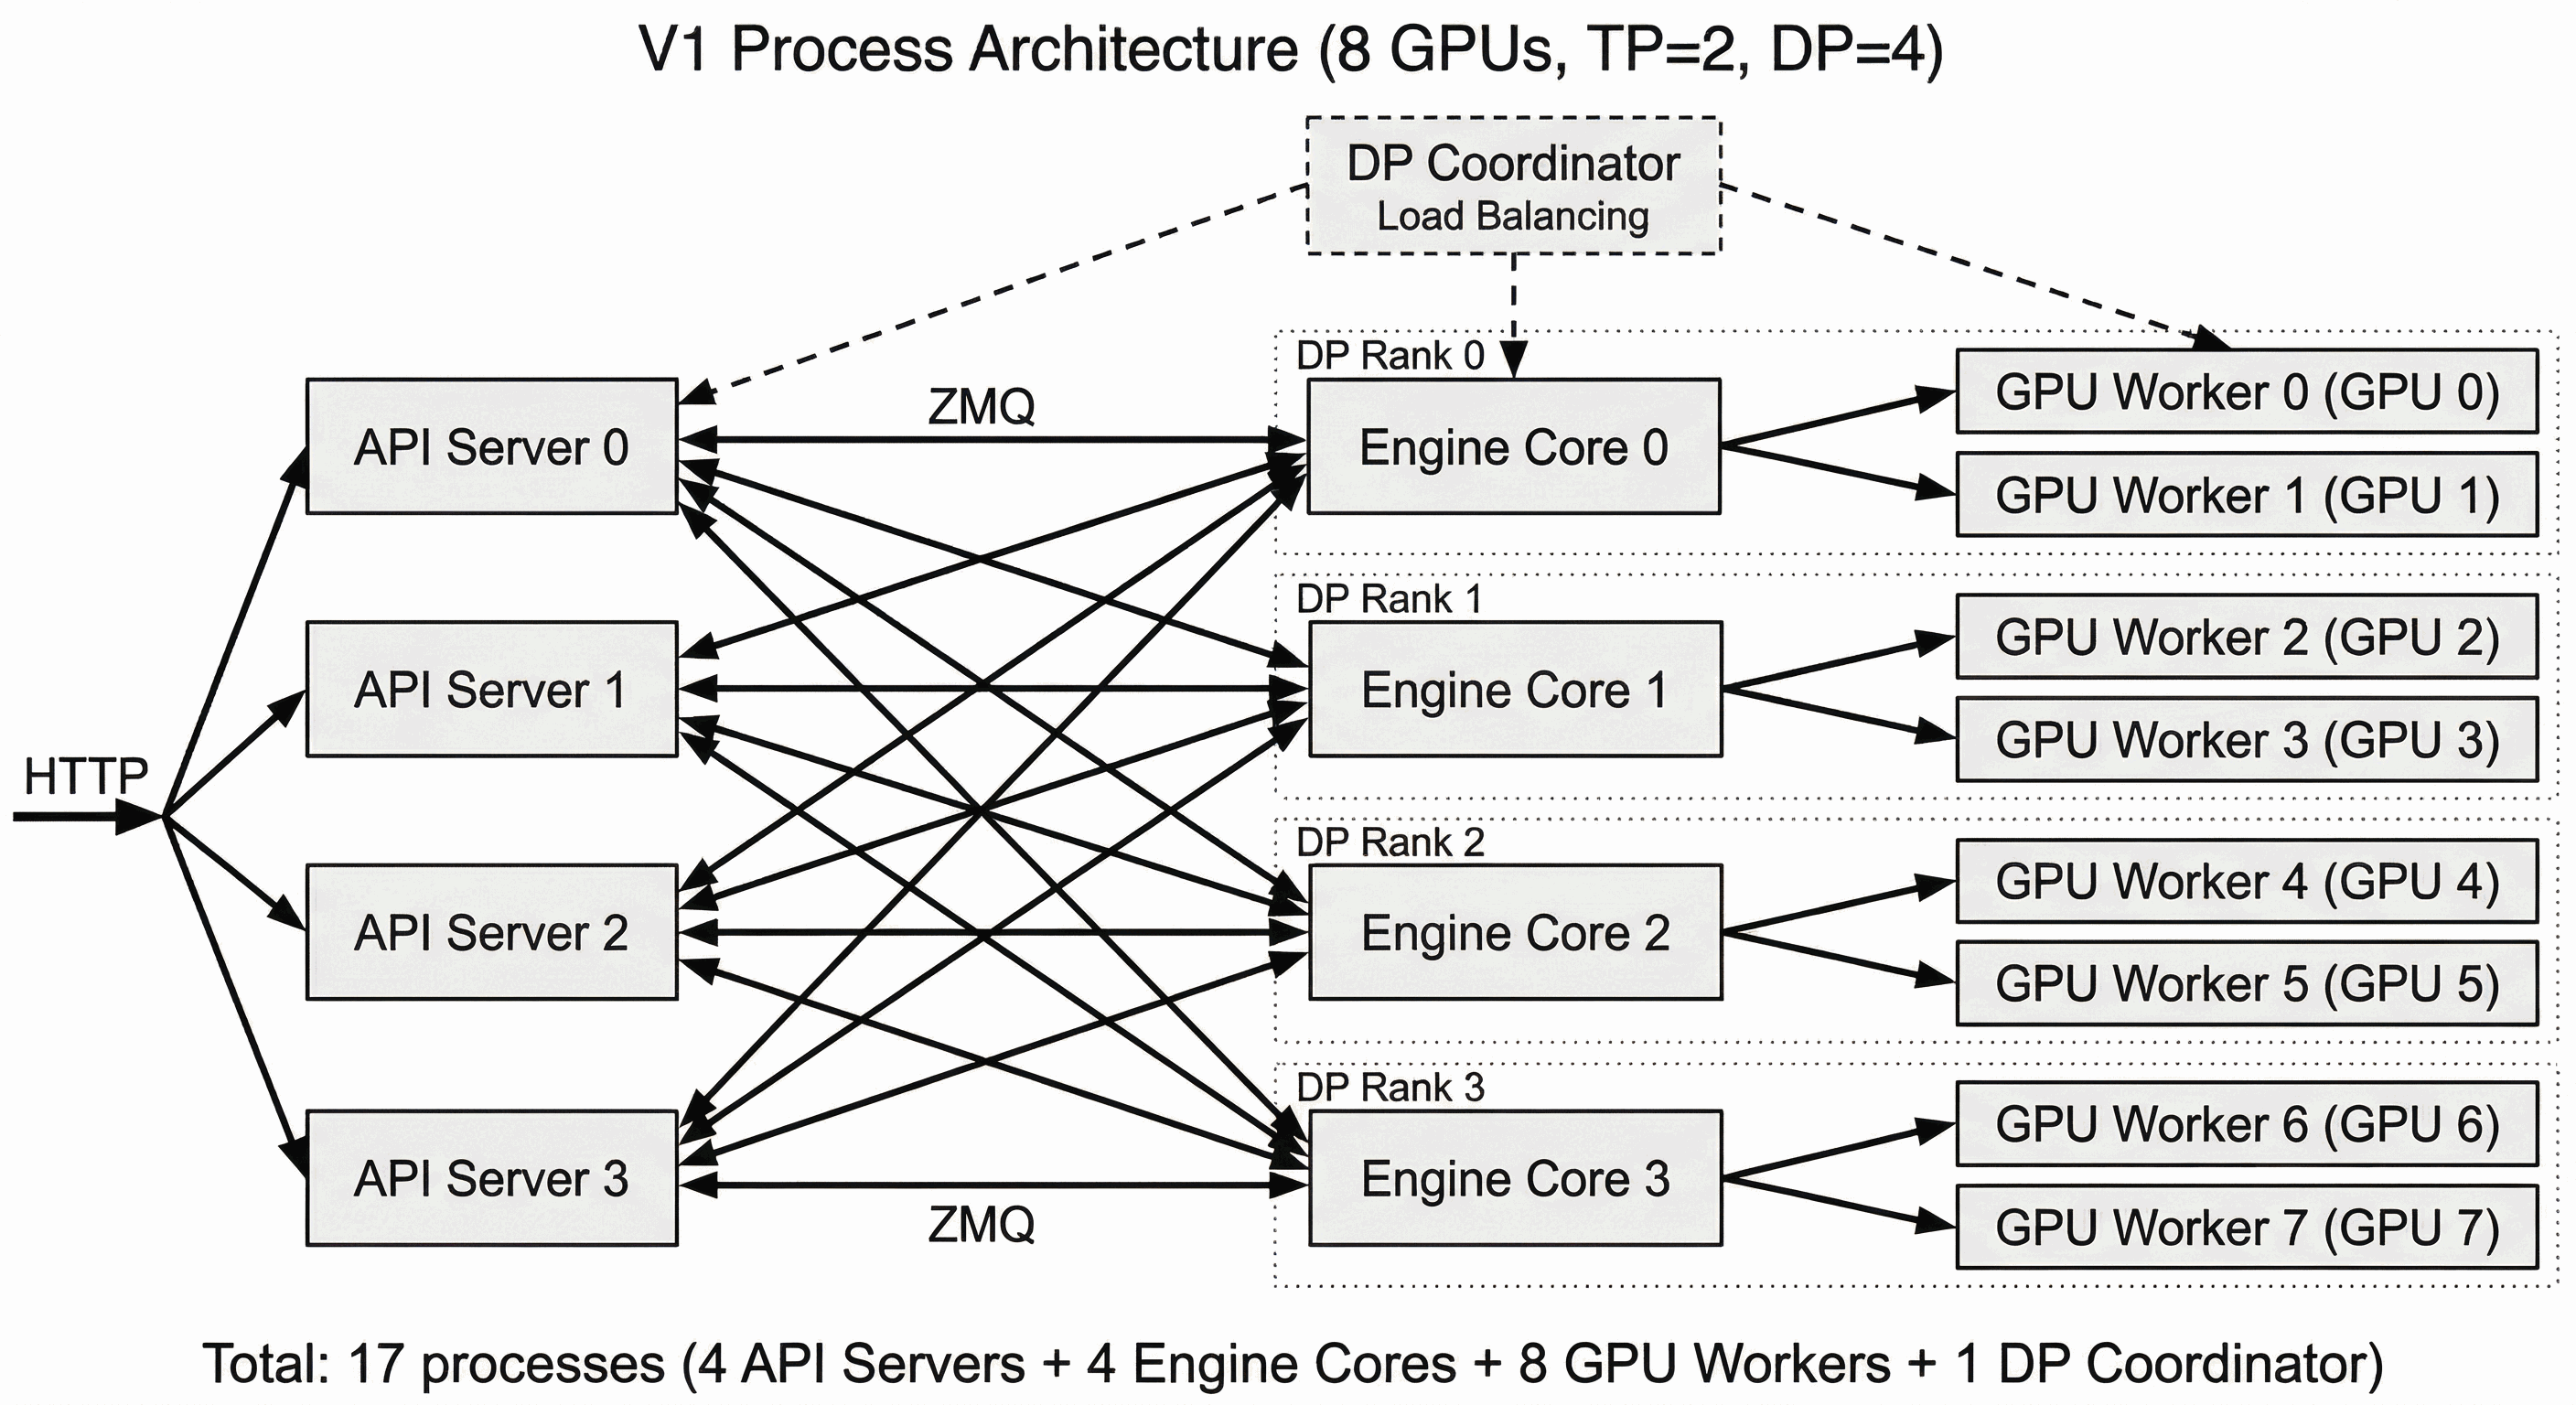
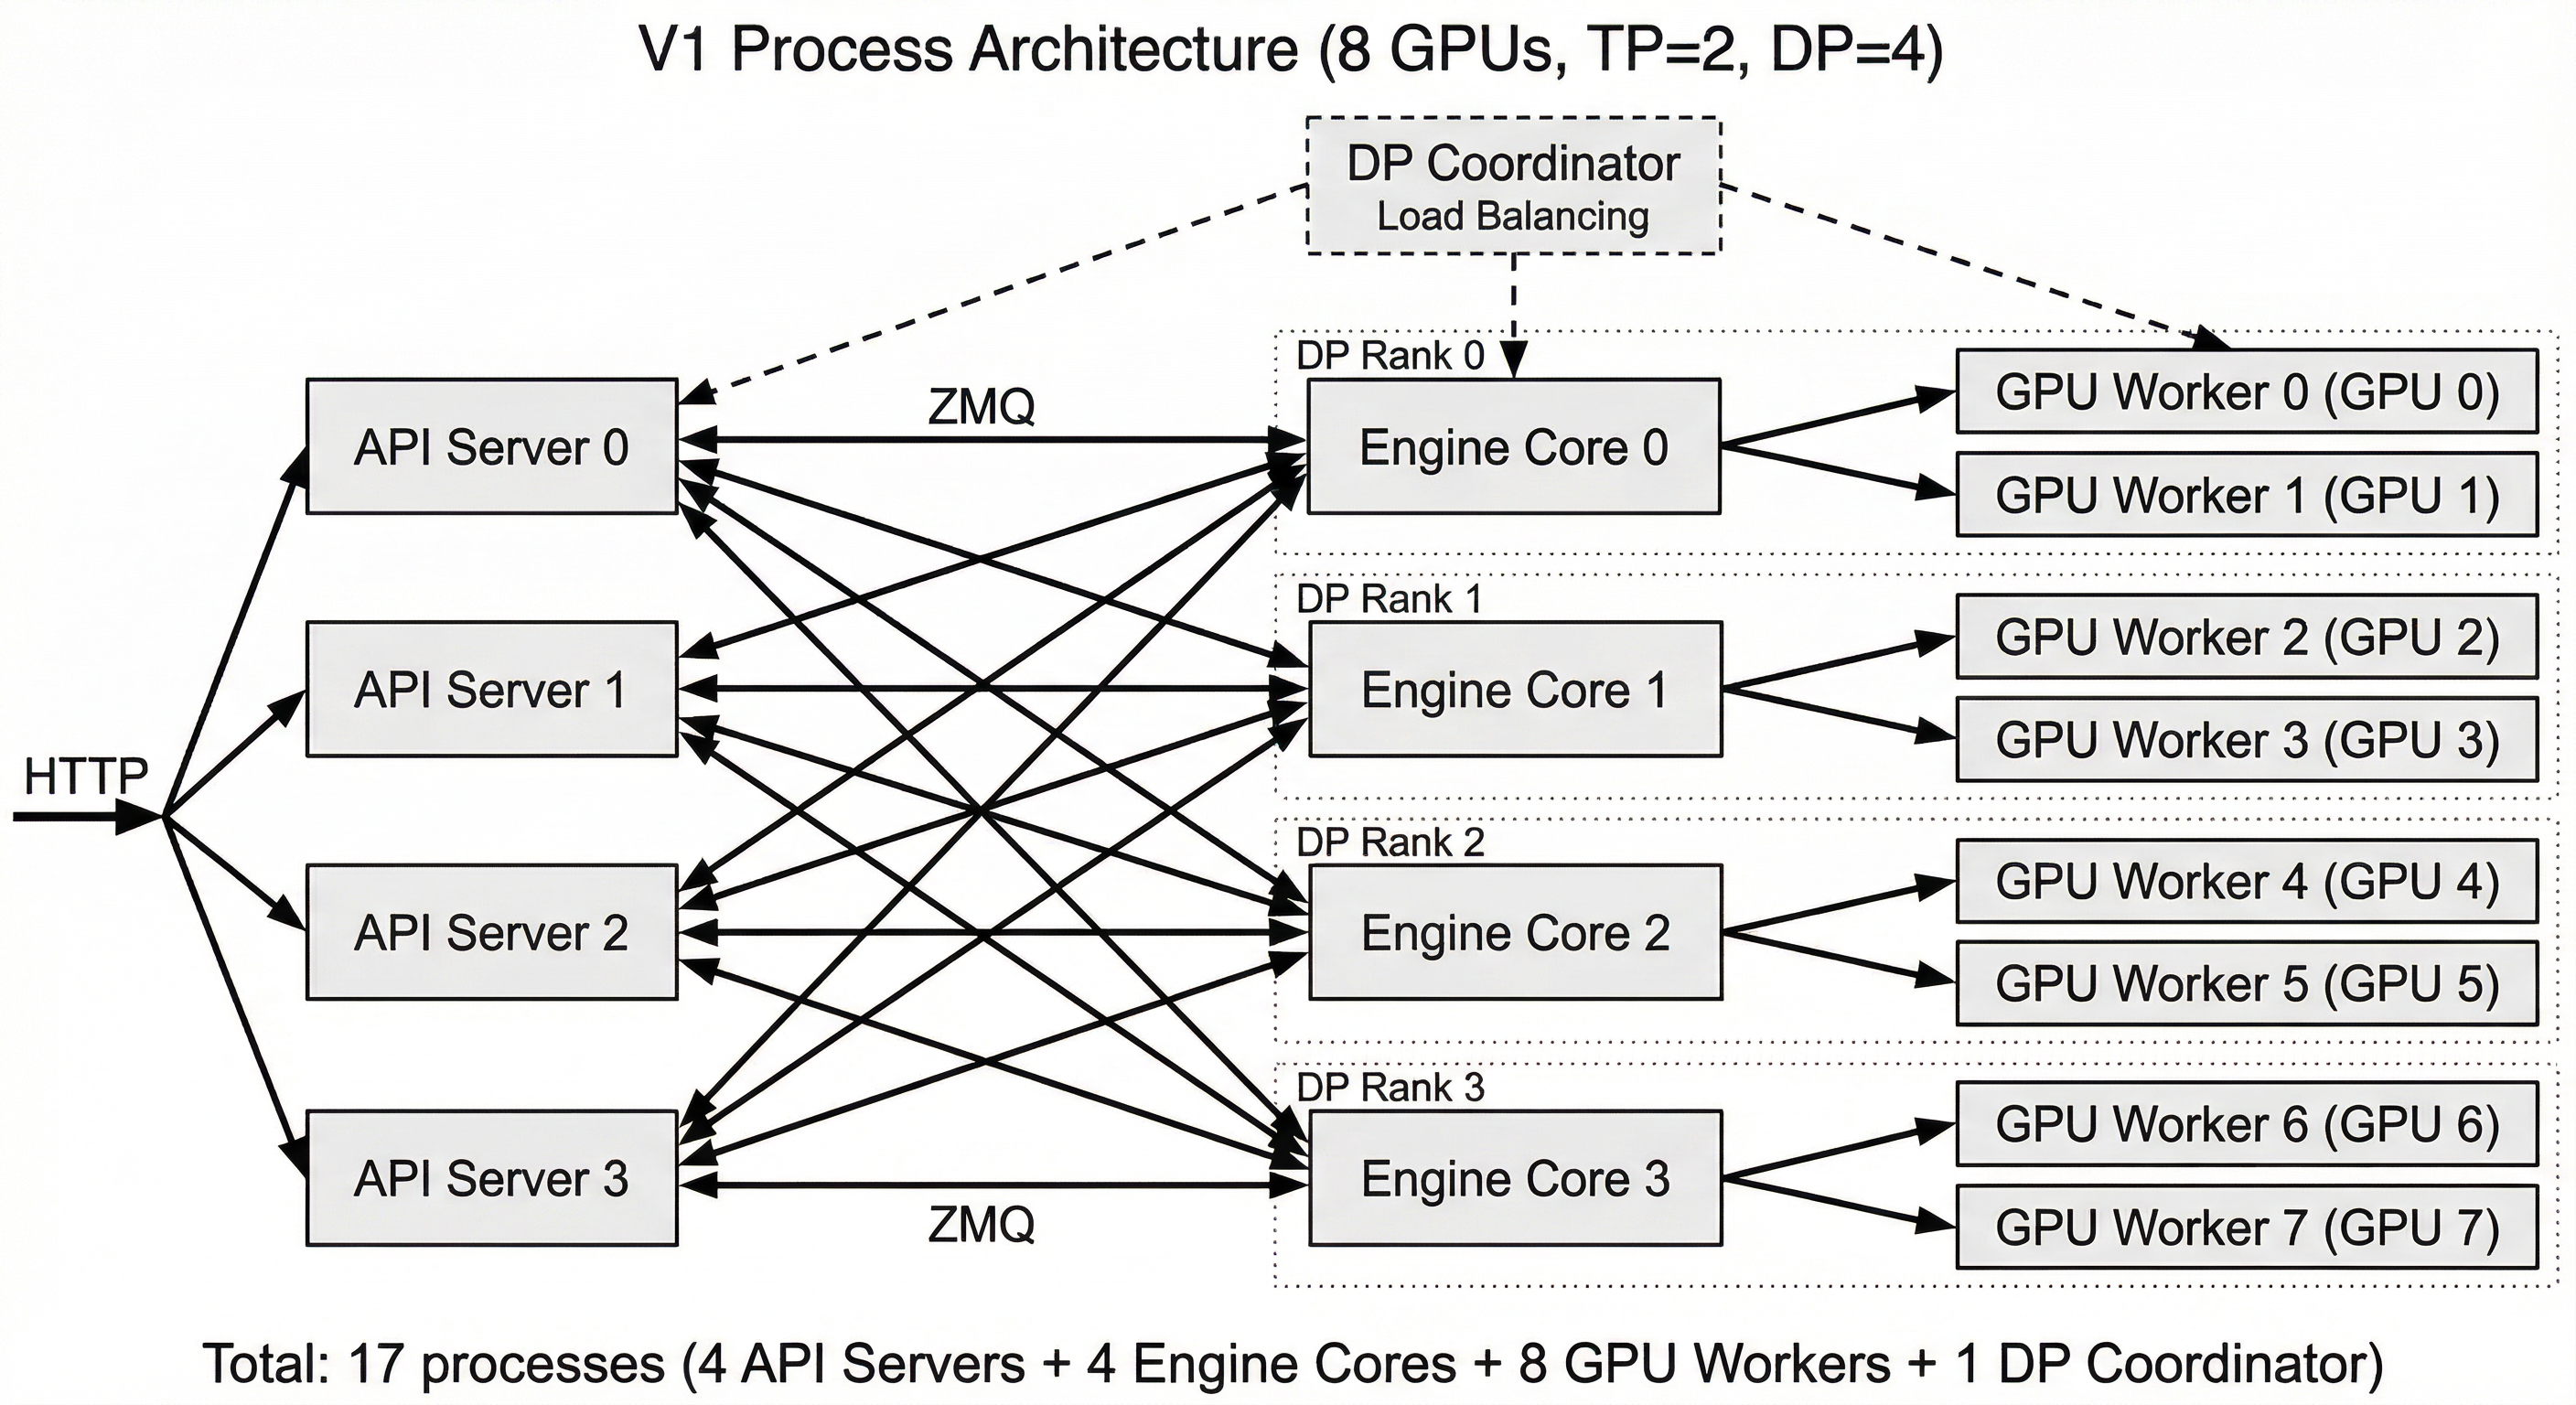
本页给出系统全景。单引擎状态见推理运行时,队列与容量算法见调度与 goodput,测量和故障验证见基准与可靠性。
服务目标
请求延迟可拆为
首 token 延迟为
共置引擎中 \(T_{\mathrm{KV\ transfer/install}}\) 通常退化为本地状态提交;P/D 分离或远程复用时,它可能成为主要项。decode 体验还要看相邻 token 延迟 ITL,或每输出 token 时间 TPOT。平均值会掩盖排队、长 prefill 和垃圾回收造成的尖峰,因此服务契约应同时声明 p50、p95、p99 与超时比例。
goodput 衡量真正可交付的容量:
“全部 SLO”可以同时包含 TTFT、TPOT、E2E、错误率和输出质量。面向 LLM 服务的 goodput 分析说明,仅以请求吞吐或 token 吞吐比较系统会忽略请求是否按时完成。
请求到执行的控制面
gateway
-> authentication and quota
-> tokenizer / request validation
-> admission control
-> model-aware router
-> engine scheduler
-> prefill / decode execution
-> sampler and detokenizer
-> streaming and accounting
每层只能承诺自己可观察的状态。gateway 的“已接收”不等于 GPU 已入场,prefill 完成不等于 decode 有容量,token 在 GPU 上产生也不等于客户端已经收到。
资源账本
一个请求的增量资源至少包括:
其中 prompt 长度已知,输出长度通常只能预测或由上限约束。admission 不能只检查当前 free memory;还要考虑已入场请求未来增长、graph workspace、临时 all-gather、prefix 命中和抢占恢复成本。
对到达率 \(\lambda\)、系统平均在途请求数 \(L_q\)、平均停留时间 \(W\),Little's law 给出
当输入流量接近可服务速率时,队列和尾延迟会迅速增长。稳定运行需要容量余量,而不是把离线峰值 tokens/s 当作生产上限。
机制分层
引擎内
Orca 提出迭代级调度:每个生成 step 都可移除完成请求并加入新请求,避免静态 batch 被最长序列锁住。现代引擎通常进一步结合:
- paged KV 与 block budget;
- chunked prefill;
- CUDA Graph shape bucket;
- prefix cache;
- adapter / grammar / quantization compatibility;
- 抢占、swap 或 recompute。
这些机制共享同一批状态,不能分别实现后再假设自然组合正确。
副本间
router 需要综合:
- 模型、权重、tokenizer 与 adapter 版本;
- 队列长度和本轮 token budget;
- KV 空间与 prefix 命中;
- tenant、优先级、deadline 与配额;
- GPU 健康和网络拓扑;
- P/D 分离后的 decode reservation。
只按最短队列路由会丢失 cache locality;只追求 cache hit 又可能把热前缀压到单个副本。Preble 研究了共享前缀工作负载中的分布式调度权衡,但具体策略仍要用本地流量和失败域验证。
集群层
集群层负责副本数、模型放置、版本排空和过载策略。Kubernetes Gateway API Inference Extension 的 InferencePool 把模型感知 endpoint selection 与普通流量入口分离,提供了一种控制面边界;它不替代引擎内 token / KV 调度。
过载与公平
过载行为必须是显式策略:
| 策略 | 适合场景 | 风险 |
|---|---|---|
| 有界排队 | 短暂突发 | 排队预算估错后集体超时 |
| 明确拒绝 | 严格交互 SLO | 需要客户端退避与容量信号 |
| 降低输出上限 | 可协商质量/长度 | 改变产品语义 |
| 路由到其他模型 | 有等价服务层级 | 质量、价格与合规变化 |
| 抢占低优先级请求 | 有明确等级 | 重算和 starvation |
多租户公平不能只看请求数:一个长 prompt 和一个短 decode 的成本不同。公平记账至少要选定 token、GPU time、KV-time 或成本单位,并说明 prefill 与 decode 怎样折算。Virtual Token Counter 提供了一种面向 LLM 服务公平性的研究路线。
正确性契约
服务状态至少满足:
- 请求任一时刻只属于一个明确状态和一个 owner;
- admission 成功意味着所需模型版本和资源策略已经确定;
- token 序号、采样 RNG counter 和流式发送序号单调;
- cancel、timeout、finish 和重试幂等;
- finish reason 与实际停止条件一致;
- 同一请求的 tokenizer、模板、adapter、grammar 和模型版本不可中途漂移;
- 计费、日志和客户端可见 token 使用同一口径;
- 慢客户端不能阻塞 GPU 调度线程,但 backpressure 必须有界。
P/D 分离时,还必须在 prefill 前预留或有界承诺 decode 容量;否则会产生已经计算完成却无处安装的 KV。
常见失效
- 队列看似很短,TTFT 却很高:队列长度没有按 token cost 加权;
- 吞吐提升,TPOT 恶化:长 prefill 或大 batch 阻塞 decode;
- cache 命中率高,goodput 下降:路由热点或查找 / 安装成本超过节省;
- 显存仍有余量却 OOM:workspace、临时 buffer 或碎片未进入账本;
- 扩容后没有线性收益:模型加载、prefix 冷启动、网络或 router 成为瓶颈;
- 重试产生重复输出:请求 ID、KV install 或 stream cursor 不幂等;
- 平均延迟稳定,少数租户饥饿:缺少成本公平和最大等待界限。
何时保持简单
- 单模型、低并发且静态 batching 已满足尾延迟时,不必引入复杂抢占;
- 前缀重复低时,不应为 cache locality 牺牲负载均衡;
- prompt 很短且阶段干扰有限时,共置通常比 P/D 分离简单;
- 请求成本相近、无租户等级时,复杂公平算法可能只增加调度开销;
- 没有端到端 SLO 时,先建立测量口径,再做 scheduler 微调。
验证
压测矩阵至少覆盖:
- prompt / output 的联合长度分布,而非只测四个固定点;
- Poisson、burst 与 trace replay 到达过程;
- greedy、sampling、grammar、beam 和 speculative verify;
- 单模型、多 adapter、多租户与版本滚动;
- prefix cache 冷启动、稳定热态和热点漂移;
- TTFT、TPOT、E2E、goodput 与拒绝率;
- KV 水位、抢占、recompute、swap 和 OOM;
- 客户端取消、慢消费、worker crash、网络抖动和过载;
- 与相同硬件、相同质量和相同请求流的简单基线比较。
容量结论必须附带硬件、并行布局、dtype、模型版本、调度参数、并发和测量窗口。缺少这些条件的“每秒 token”不能用于生产规划。