缓存复用:从前缀命中到分布式 KV
大量请求会重复 system prompt、few-shot 示例、共享文档或多轮对话前缀。若这些 token 的模型状态完全兼容,可以直接复用其 KV,跳过重复 prefill。难点不在“保存一个 hash”,而在确认语义身份、选择 worker、管理生命周期,并判断查找和搬运是否真的比重算便宜。
分页与 block 所有权见 KV Cache;本页只讨论精确前缀复用及其多层存储,不把有损 KV 淘汰混入同一概念。
收益模型
设请求共有 \(T\) 个 prompt token,命中最长公共前缀 \(h\) 个 token。复用成立的必要收益条件是
净收益可写为
命中率本身不是目标。一个远程长前缀命中可能很有价值,一个本地短前缀命中也可能因索引与 block 安装而变慢。容量规划还要看每字节的重用价值:
其中 \(p_i\) 是再次命中的估计概率,\(C_i^{\mathrm{saved}}\) 是可节省的 prefill 成本。这个式子只是逐出排序的启发式,不能替代租户配额和 SLO。
语义身份
字符串相同不等于模型输入相同。cache key 至少包含:
exact token ids
model and weight version
tokenizer and prompt-template version
adapter / LoRA version
multimodal input identity and preprocessing version
RoPE and position configuration
KV dtype, quantization and layout schema
tenant and permission boundary
采样参数通常不影响已经计算出的 prompt KV,但改变 attention、position 或 adapter 的任何配置都会影响 cache。若服务允许模型滚动升级,旧版本条目必须隔离并在排空后回收。
跨租户内容即使字节完全相同,也不能默认共享。是否允许 deduplication 是数据隔离和侧信道策略,而不是普通性能开关。
最长前缀查找
精确复用需要找到 token 序列的最长兼容前缀。最简单的是固定 block hash 链;更灵活的是 radix tree。SGLang 中的 RadixAttention 将共享前缀组织为 radix tree,并把节点与 KV 生命周期关联。
一个安全的命中流程是:
- 先验证模型、adapter、layout 和安全域;
- 按 token ID,而非解码字符串,查找最长前缀;
- 对命中的完整 block 增加引用;
- 最后一个非满 block 只读共享;
- 请求继续写入前执行 copy-on-write;
- 原子提交 block table 与 computed-token count。
若 tokenizer 会把相同文本编码为不同 token,或模板在不可见位置插入控制 token,字符串级缓存会产生静默错误。
最长命中应沿父前缀逐块推进:即使目录中偶然存在更长孤儿 key,也不能跳过缺失的中间 block。下面的 identity 是模型、adapter、布局与安全域组成的不可变元组,cache value 代表已发布的只读 KV block chain。
def longest_cached_prefix(token_ids, identity, cache, block_size):
    if block_size <= 0:
        raise ValueError("block_size must be positive")
    hit = (0, None)
    for end in range(block_size, len(token_ids) + 1, block_size):
        key = (identity, tuple(token_ids[:end]))
        if key not in cache:
            break
        hit = (end, cache[key])
    return hit
identity = ("model-v3", "adapter-0", "bf16-layout", "tenant-a")
tokens = [11, 12, 13, 14, 15]
cache = {
    (identity, (11, 12)): "blocks-0",
    (identity, (11, 12, 13, 14)): "blocks-0-1",
}
length, handle = longest_cached_prefix(tokens, identity, cache, 2)
assert (length, handle) == (4, "blocks-0-1")
assert longest_cached_prefix(tokens, identity[:-1] + ("tenant-b",), cache, 2) == (0, None)
assert longest_cached_prefix([11], identity, cache, 2) == (0, None)
命中长度只覆盖完整共享 block;非满尾块继续写入前仍要 copy-on-write。生产目录必须防 hash collision、原子增加引用并在远端数据 checksum 与 install 完成后才发布 computed-token count;这段查找本身不授权跨租户共享。
多层缓存
KV 可以驻留于 GPU、CPU、节点间内存或持久存储。层级越远,容量越大,访问越慢:
| 层级 | 适合内容 | 主要约束 |
|---|---|---|
| GPU 本地 | 高频、即将复用的热前缀 | 显存机会成本 |
| CPU / pinned memory | 中热、大前缀 | PCIe / CXL 带宽与 pinned memory |
| 远端内存 | 跨副本共享 | 网络、拓扑、隔离与 install |
| 持久层 | 极长、低频或跨重启 | 序列化、版本和冷延迟 |
Mooncake 研究了把 KV Cache 作为分布式资源池的一条路线;LMCache 提供了多层 KV 复用的公开实现。它们说明了可行的系统边界,不保证远程层对每个模型、网络和流量分布都有收益。
多层查找可采用逐层探测,也可让目录直接返回位置。无论哪种方式,目录命中都不等于数据可用;只有版本校验、传输完成、checksum 通过并安装到目标 block 后,decode 才能开始。
混合序列模型的联合缓存
混合 attention/recurrent 模型不只有一种前缀状态。以 KDA 与 MLA 交替的模型为例,同一前缀可能同时需要:
- MLA 层逐 token 的 KV pages;
- KDA 层在某个 token 边界上的 recurrent state;
- 两类状态共享的 position、模板、权重与量化 identity。
复用长度必须取二者都完整可用的最长共同边界,不能因为 KV 命中更长就让 KDA 从不一致状态继续。KDA state 通常远大于单个 hash metadata,却不必在每个 token 保存;可以只在 hash endpoint、turn boundary 或其他稀疏边界做 snapshot,再从最近 snapshot replay 剩余 token。
Kimi K3 技术报告披露了一套统一 paged pool:物理 block 可在 1024–6144 token 间选择,细粒度 hash 可取 512 token,并对 KDA state 使用稀疏 snapshot。具体数字是其服务配置;可迁移的是把 查找粒度、物理分配粒度和状态快照粒度解耦。完整设计见 Kimi K3。
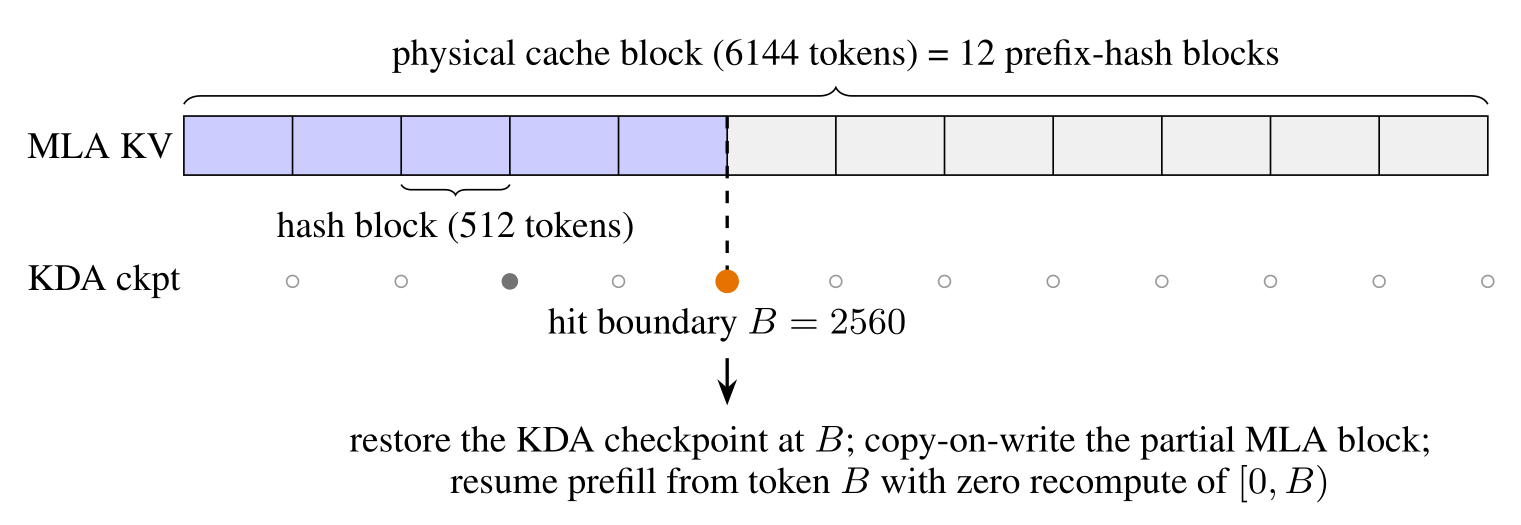
联合查找应分两阶段:先在目录中定位最长兼容 hash chain,再确认每个模型层组的数据实际存在且 checksum/版本一致。发布与失效也必须跨组原子化:共享前缀续写前 copy-on-write,任何 MLA page 或 KDA snapshot 失效时,对应 joint entry 一并失效,避免部分命中进入 decode。
V4:压缩块持久化与 SWA 恢复
DeepSeek-V4 的联合状态不是 recurrent state,而是 CSA/HCA compressed entries、Lightning Indexer 状态、未完成压缩 tail 与 SWA KV。只有完整闭合的压缩块可以直接持久化;tail 取决于后续 token,恢复时必须从原始 token 重建。
SWA 有三种空间—恢复策略:
- 每层窗口全量保存,恢复快但磁盘量最大;
- 每隔 \(p\) 个 token 保存一次最近窗口的 checkpoint,命中后从最近 checkpoint 重算尾部;
- 完全不保存,为恢复各层末尾窗口,最多重算 prefix 最后 \(n_{\mathrm{win}}L\) 个 token。
第三种方案的 \(n_{\mathrm{win}}L\) 是报告给出的最坏重算 token 上界,不是每层各自重放同一段后再简单相加的实现处方。报告估计全量 SWA KV 约为 compressed cache 的 8 倍,因此磁盘最省方案可能有意义;真实选择仍取决于命中率、存储带宽、prefill 余量与 p99 恢复延迟。具体 cache layout 见 V4 系统闭环。
路由、放置与逐出
cache-aware routing 同时面对两个相反目标:
- 把请求路由到已有前缀的 worker,减少 prefill;
- 避免热前缀导致单个 worker 排队。
一个可解释的 worker score 可以按统一时间单位组合:
Preble 研究了分布式前缀复用中的路由与负载均衡。实际部署还要加入失败域、tenant 配额、adapter 驻留和 decode KV 余量。
逐出策略不能只用 LRU。长前缀重算成本高,但也占用更多空间;共享节点可能被大量后代引用;租户配额和敏感数据还会要求主动清除。逐出前必须确认引用数为零,并等待全部 GPU event 完成。
与其他机制的边界
- Prefix reuse:输入 token 和模型状态一致时,跳过重复 prefill,语义精确;
- Prompt memoization:缓存最终文本或结构化结果,只有应用允许答案复用时才成立;
- KV quantization:保存同一 token 的近似 K/V,属于有损表示;
- Window / eviction:丢弃历史 token,改变注意力可见集合;
- Semantic cache:用相似度复用不同输入的结果,会改变产品语义;
- P/D transfer:把当前请求的 KV 从 prefill 移到 decode,不一定发生跨请求复用。
这些机制可以组合,但必须分别报告命中定义、质量影响和成本。
正确性契约
- key 使用精确 token IDs 和不可变 schema version;
- 一个 cache entry 在发布后只读;
- 共享尾块续写前 copy-on-write;
- 引用计数、目录记录和物理 block 所有权一致;
- install 幂等,同一请求重试不会产生两份 owner;
- 过期、撤权、模型升级和租户删除能主动失效;
- 未通过完整性校验的远端条目永不进入 decode;
- 日志不默认记录 prompt、token 或可反推出内容的 cache key。
常见失效
- 高命中率但 TTFT 不降:命中前缀短、远端加载慢或 install 串行;
- 热 key 把单机压垮:路由只看命中,没有队列惩罚;
- 升级后出现偶发 logits 漂移:key 未绑定权重、adapter 或 RoPE;
- 显存泄漏:取消、失败或 COW 分支没有正确递减引用;
- 缓存污染:低价值长前缀挤掉高频短前缀;
- 跨租户泄漏:deduplication 绕过隔离边界;
- 目录命中却读取失败:数据生命周期和目录更新不是同一提交协议。
何时不用
- 前缀重复率低或每次只重用很短片段;
- prefill 已很便宜,而查找、传输和安装无法隐藏;
- 模型、adapter 或模板频繁变化,条目很快失效;
- 安全域不允许共享,而单租户流量不足以形成命中;
- GPU 显存更应该用于活跃 decode KV;
- 缺少版本化 schema 和可验证的失效机制。
验证
功能测试覆盖 exact hit、partial hit、miss、hash collision、非满尾块 COW、模型升级、adapter 切换、租户撤权和远端部分写入。对每种命中路径,把复用后的 logits 与完整 prefill reference 对齐。
性能测试同时报告:
- token-level、request-level 和 byte-weighted hit rate;
- 命中前缀长度分布;
- lookup、load、transfer、install 与 saved prefill time;
- GPU / CPU / remote 各层容量和逐出率;
- 路由后的队列倾斜;
- 冷启动、稳定热态和热点漂移;
- TTFT、goodput、显存机会成本和失败恢复。
只报告命中率会把大量无价值短命中误判为成功。
分页、引用计数与复用收益的完整小实验见推理引擎手撕实现。