DeepSeek-V4 引用图谱:103 项证据的来路与作用
DeepSeek-V4 技术报告采用 author–year 引用格式,末尾书目没有官方数字编号。本页按报告渲染后的字母顺序,为 103 项实际引用分配稳定序号;这组序号只服务于检索和覆盖校验,不应反向写成论文原有编号。
报告源码的 main.bib 含 263 条记录、262 个唯一 key,其中只有 103 个唯一 key 进入正文引用与最终书目;未被正文引用的是 159 个唯一 key。区分这些数字很重要:前者是作者工作区中的候选文献库,后者才是报告公开论证链。103 个 cited key 全部可以在书目中解析到,没有缺失项或重复引用 key。
| 分组 | 项数 | 在报告中的主要角色 |
|---|---|---|
| DeepSeek 家族与直接方法谱系 | 13 | 架构、训练、后训练的第一方前身与后续方向 |
| 注意力、残差、MTP 与基础结构 | 11 | CSA / HCA、mHC、MTP 的结构原语与比较基线 |
| 优化、数据、稳定性、蒸馏与量化 | 13 | Muon、训练语料、OPD、QAT 和数值稳定性 |
| 训练、推理、kernel 与 sandbox 系统 | 18 | MoE 通信、编译器、确定性执行、缓存和隔离环境 |
| Base model 通用评测 | 28 | 知识、语言理解、代码、数学和长上下文测量 |
| Reasoning、形式化、长上下文与 Agent 评测 | 20 | test-time scaling、证明系统、软件工程和工具代理 |
| 合计 | 103 | 每个稳定序号恰出现一次 |
家族演化可与 DeepSeek 时间线对读;分布式训练、服务系统和评测方法分别见训练系统谱系、推理运行时谱系与评测谱系。
DeepSeek 家族与直接方法谱系:13 项
- [7] Kimi K2:作为同时代开放 MoE 与 agentic model 基线进入引言,也提供规模化 Muon 的邻近实现语境。
- [17] Engram:报告只把 conditional memory / sparse embedding 列为未来方向,并未声称 V4 已经采用。
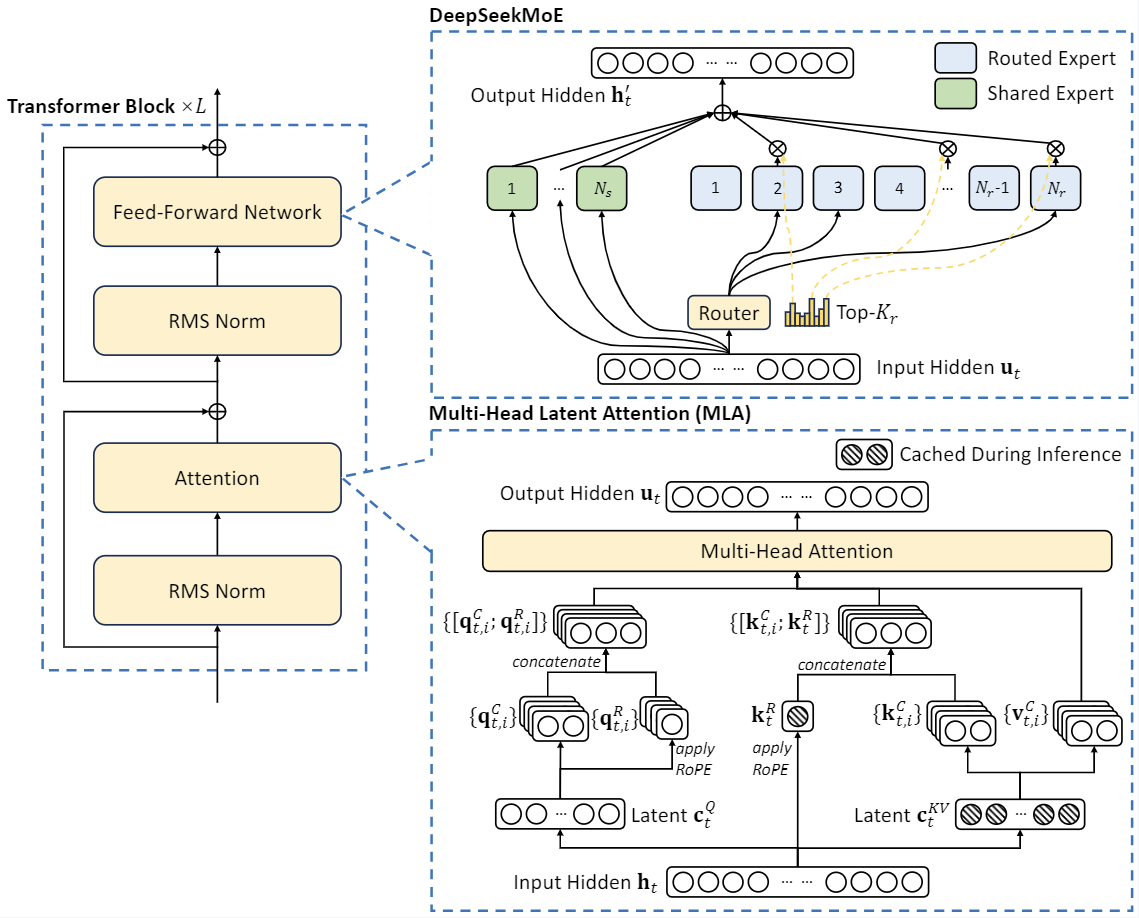
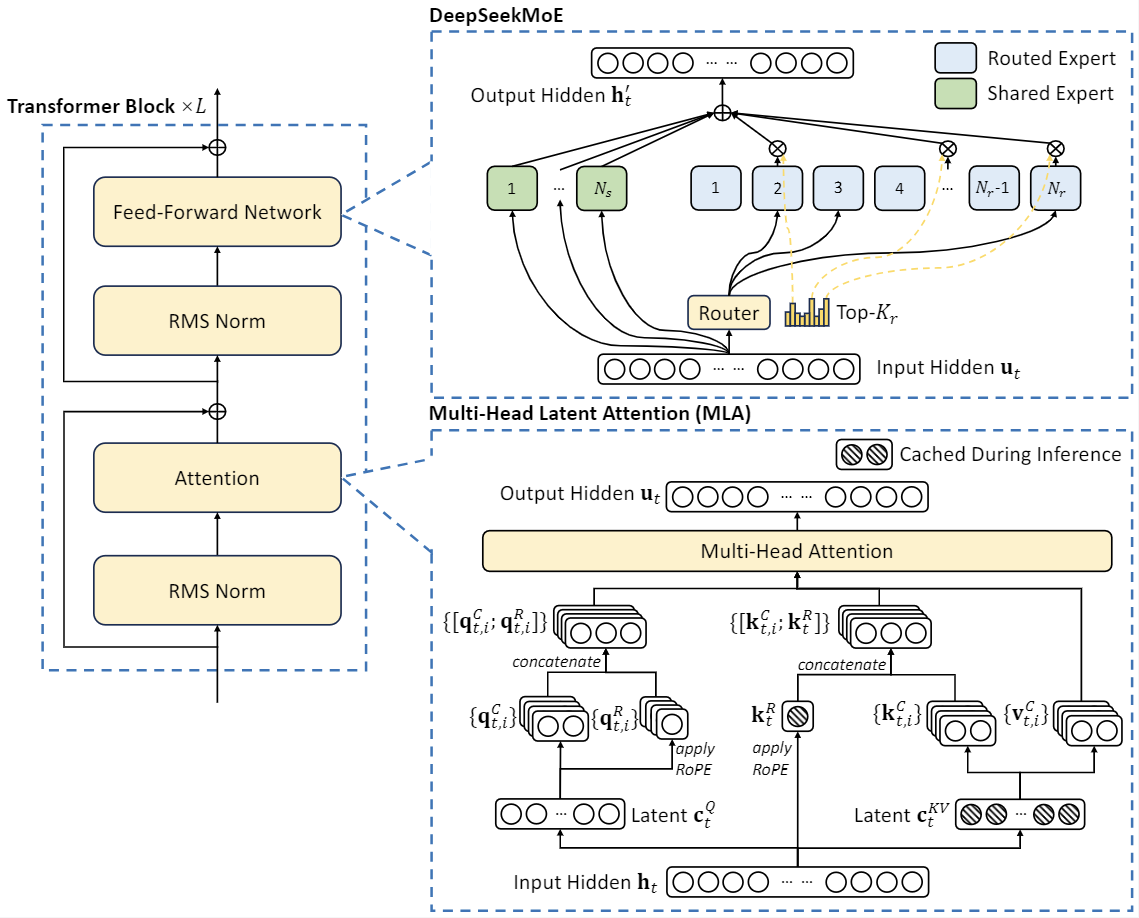
- [19] DeepSeekMoE:以细粒度 routed experts 与 shared experts 奠定 V4 FFN 的直接结构基础。
- [22] DeepSeek-Coder-V2:提供预训练中的 Fill-in-Middle 数据策略。
- [23] DeepSeek-V3:是 backbone、DeepSeekMoE、MTP、数据处理和训练框架的直接前身,也是 V4 多处“未特别说明的配置”的来源。
- [24] DeepSeek-V2:建立 DeepSeekMoE 与 MLA 的家族主干,说明 V4 的压缩注意力并非凭空出现。
- [26] DeepSeek-R1:连接 reasoning test-time scaling、GRPO 与 V4 domain specialist 的强化学习阶段。
- [27] DeepSeek-V3.2:直接提供 DSA / Lightning Indexer、可扩展 RL 与 agentic data synthesis;V4 的 CSA 是先压缩序列,再在压缩条目上执行这条稀疏选择路线。
- [57] MiniMax-M2:引言中的同期开放 agentic model 基线,不是 V4 方法来源。
- [71] Qwen3:引言中的开放模型能力基线,用于放置 V4 的时代位置。
- [79] DeepSeekMath-V2:为形式化数学评测中的“自然语言候选解—自验证—Lean 证明”管线提供直接前身。
- [87] Auxiliary-Loss-Free Load Balancing:给出 expert-wise bias 的无辅助损失均衡方法;V4 在其上增加轻量 sequence-wise balance loss。
- [93] mHC:完整给出 Manifold-Constrained Hyper-Connections 的数学定义、稳定性动机与系统优化,是 V4 residual path 的直接方法来源。
这组文献形成清晰的家族主线:
这里的箭头表示可核对的继承或扩展关系,不表示每个新组件都来自上一代。CSA、HCA、anticipatory routing、loss-spike detection / rollback control、grouped output projection、Quick Instruction 与 DSec 都应首先引用 V4 报告本身。
注意力、残差、MTP 与基础结构:11 项
- [5] GQA:为报告的 BF16 GQA8 KV-cache 成本对比提供基线。
- [35] Better & Faster LLMs via Multi-token Prediction:给出 decoder-only 模型的 MTP 训练目标;V4 沿用 V3 的 MTP 配置。
- [50] EAGLE:连接 MTP feature 与 speculative decoding,但报告正文没有把 DSpark 作为 V4 训练方法。
- [70] ProphetNet:是 future n-gram prediction 的早期序列到序列前身。
- [76] Hash Layers:支持 V4 在最前几层用 token-ID hash routing 的 MoE 取代 dense FFN。
- [80] Multi-Query Attention:CSA 与 HCA 的 compressed entry 同时作为共享 key 和 value,各 query head 复用同一 KV head。
- [81] GLU Variants Improve Transformer:提供 SwiGLU 基础,也解释 Muon 实现为何按 up、gate、down 三类矩阵分别组织 expert 参数。
- [83] RoFormer:提供 RoPE;V4 只旋转 head 尾部维度,并对 attention output 施加负位置旋转以恢复相对位置语义。
- [86] Attention Is All You Need:定义 V4 仍然保留的 Transformer 总体骨架,也构成稠密注意力的复杂度基线。
- [92] Attention Sinks:为每个 attention head 的可学习 sink logit 提供方法背景。
- [101] Hyper-Connections:把 residual stream 扩展为多条宽通道,是 mHC 要稳定化的直接前身。
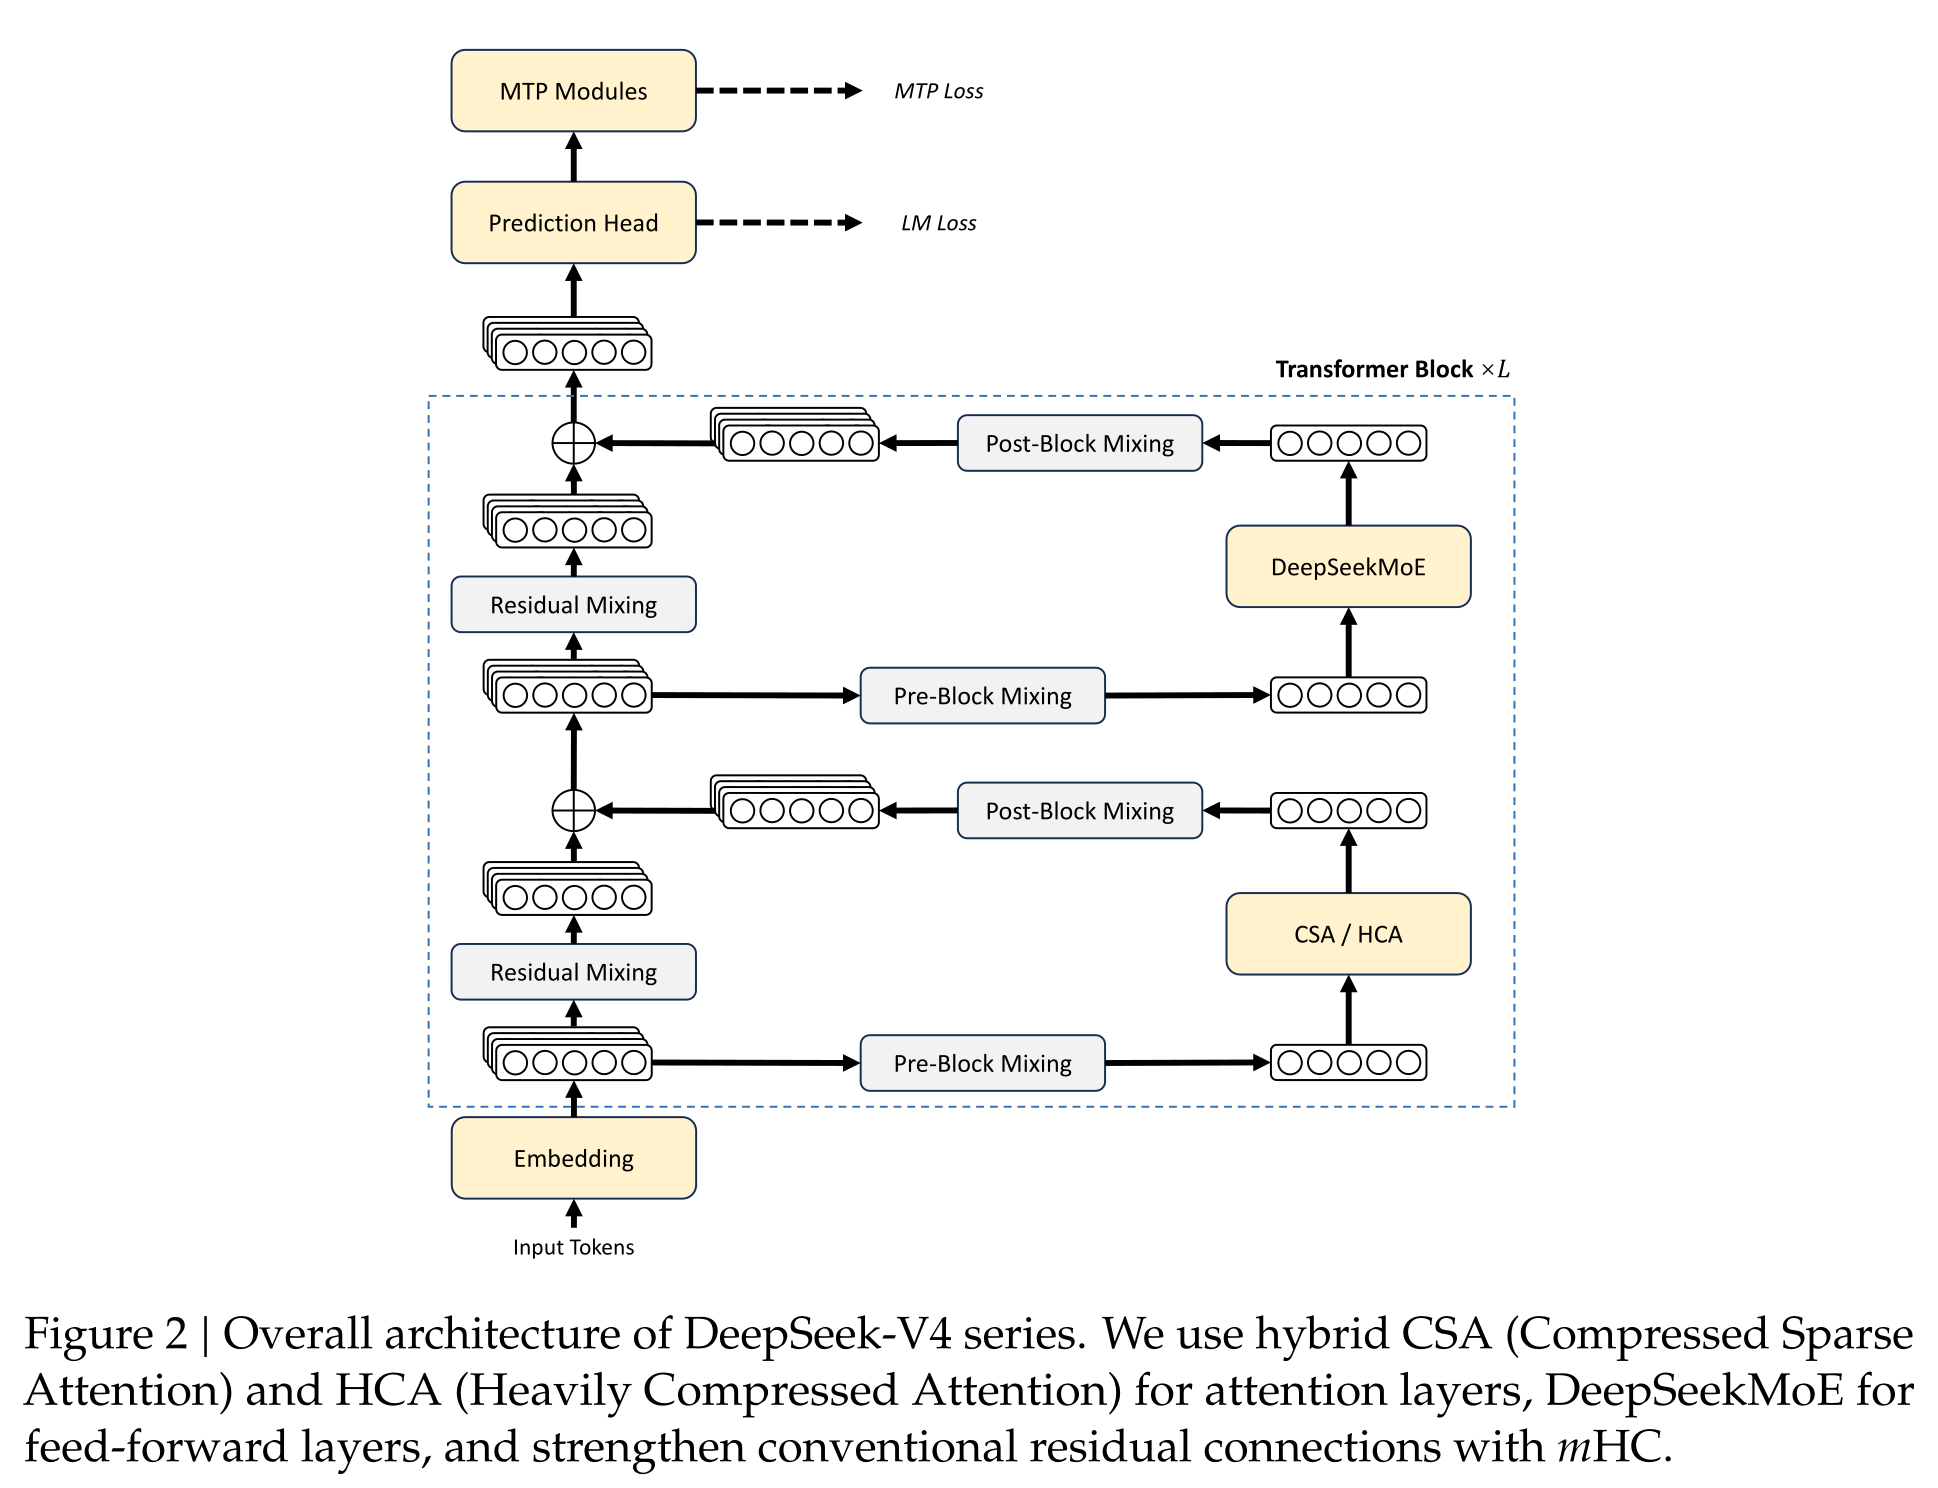
CSA 与 HCA 共同使用 shared \(K=V\) MQA、partial RoPE、learnable attention sink、局部 sliding-window branch 和 grouped low-rank output projection,但二者处理远程信息的方式不同:
| 路径 | 长程表示 | 选择方式 | 主要作用 |
|---|---|---|---|
| CSA | 约每 4 token 压成一个重叠条目 | Lightning Indexer 取 top-\(k\) | 保留 query-dependent 远程检索 |
| HCA | 约每 128 token 压成一个非重叠条目 | 对全部压缩条目做 dense attention | 提供便宜、稳定的全局概览 |
| SWA | 最近 token 保持未压缩 | 固定局部窗口 | 补偿压缩块内部的细粒度信息 |
一层前溯可以连接 Sparse Transformer、Longformer、BigBird 和 Compressive Transformer,但这些只是稀疏模式与时间压缩的历史背景;报告没有把 CSA / HCA 归因于其中任一工作。
mHC 的数学背景还包括 Deep Residual Learning、Birkhoff polytope 和 Sinkhorn–Knopp 矩阵缩放。这些节点解释“identity path、doubly stochastic、non-expansive 与乘法闭包”,但不属于 V4 的 103 项正式书目。
优化、数据、稳定性、蒸馏与量化:13 项
- [12] Neural Combinatorial Optimization:报告把其中的数值 clipping 作为稳定性先例之一。
- [29] Fewer Truncations Improve Language Modeling:启发按来源和长度组织 document packing,减少训练样本截断。
- [36] MiniLLM:以 reverse KL 训练生成式 student,是 full-vocabulary OPD 的蒸馏背景。
- [43] Quantization and Training of Neural Networks:提供 fake quantization 与 quantization-aware training 的经典方法。
- [45] Muon:对隐藏层二维权重的 momentum update 做 Newton–Schulz 近似正交化,是 V4 主优化器的原点。
- [51] Muon is Scalable for LLM Training:提供 weight decay、Nesterov、RMS rescaling 与 QK-Clip 等大模型 Muon 配方;V4 采用前三者,但以 per-head normalization 避免 QK-Clip。
- [52] AdamW:用于 embedding、prediction head、RMSNorm 和 mHC 的静态 bias / gate 等不适合矩阵正交化的参数。
- [53] On-Policy Distillation:student 在自身 rollout 上接受 teacher 分布监督,是多专家能力合并的核心方法。
- [59] Nesterov 加速:进入 V4 Muon momentum update 的 look-ahead 形式。
- [66] gpt-oss Model Card:同时提供 attention sink、SwiGLU clamping 与 MXFP4 expert quantization 的工程先例。
- [75] Gemma 2:以 logit soft-capping 提供大模型数值范围控制的邻近经验。
- [77] Microscaling Data Formats:定义 MXFP4 等 microscaling 格式,支撑 expert weights 与 CSA indexer QK path 的低精度表示。
- [102] How to Synthesize Text Data without Model Collapse?:为过滤批量自动生成、模板化 web 内容提供数据质量动机。
优化链不能简化成“把 AdamW 换成 Muon”。V4 的实际边界是按参数语义分组:二维 hidden weights 使用 Muon,其他参数继续使用 AdamW;MoE expert 的 up、gate、down 矩阵仍按逻辑矩阵分别正交化;ZeRO 只负责把这些完整逻辑单元分配给不同 rank。理论上可继续阅读 Shampoo 与 polar decomposition,但它们属于 Muon 的一跳数学背景,不是报告直接引用。
后训练的两段式结构则是:
OPD 不是简单地把多个 checkpoint 做权重平均。student 先按自己的 policy 生成轨迹,再由对应 teacher 对完整词表分布打分,优化 reverse KL。FP4 QAT 同时进入 student、teacher 与 reference path,使训练时看到的量化误差更接近部署时分布。
训练、推理、kernel 与 sandbox 系统:18 项
- [3] Firecracker:为 DSec 的 microVM 提供轻量虚拟化与强隔离。
- [4] FlashMoE:启发把 experts 划成更小 waves,在一个分布式 kernel 中细粒度重叠 dispatch、GEMM 与 combine。
- [11] QEMU:提供 DSec 的 fullVM 执行底座。
- [15] TVM:TileLang host codegen 使用 TVM-FFI 的紧凑调用约定和 zero-copy tensor interop。
- [20] Flash-Decoding:其 split-KV 能改善长序列 decode 利用率,但会破坏 V4 要求的 batch invariance。
- [21] Z3:TileLang 把整数表达式翻译为 QF_NIA,用于 layout、越界、barrier 与 hazard 分析。
- [25] 3FS:支撑 DSec 镜像、sandbox 状态与大规模并发执行的分布式文件系统。
- [30] Hymba:作为 hybrid-head architecture,暴露不同 layer cache policy 与维度给 PagedAttention 带来的管理问题。
- [33] EROFS:为 container 镜像提供可压缩、只读、按需加载的基础层。
- [47] DADI / OverlayBD:为 microVM 提供共享只读 base layer 与本地 copy-on-write layer。
- [60] cuBLAS:是高性能 GEMM 基线,但常规执行次序不能满足 token 对 batch 位置完全不敏感的目标。
- [67] Stream-K:解释 split-K 提高小 batch 利用率的同时为何引入 reduction-order 非确定性。
- [72] ZeRO:为 Muon optimizer state、gradient 与按需 teacher loading 提供分片基础。
- [73] TorchFX:追踪计算图并为被标记 tensor 生成最小重算子图,实现 tensor-level activation checkpointing。
- [88] TileLang:承担 CSA / HCA、Muon、全词表 KL 等 fused kernel 的快速开发与生产落地。
- [97] Jenga:是 heterogeneous KV cache manager 的直接比较对象;V4 因压缩率和 entry width 跨层变化而需要专用布局。
- [98] Comet:分别重叠 dispatch–Linear-1 与 Linear-2–combine;V4 进一步把 expert 分 wave 做更细的流水。
- [99] DeepGEMM:替换不满足 batch invariance 的常规 GEMM 路径,也承载开源 MegaMoE fused kernel。
这一组可以拆成四条独立但相互咬合的系统链:
| 约束 | 前置工作 | V4 落点 |
|---|---|---|
| MoE 通信尾延迟 | FlashMoE、Comet | wave-based MegaMoE,把通信与两个 expert GEMM 融为一个流水 |
| kernel 开发与正确性 | TVM、Z3、TileLang | host codegen、形式化整数分析、默认关闭 fast math |
| 可复现训练与推理 | Flash-Decoding、cuBLAS、Stream-K、DeepGEMM | batch-invariant attention / GEMM 与 deterministic reduction |
| agent 环境规模 | 3FS、EROFS、OverlayBD、Firecracker、QEMU | DSec 统一 API、分层镜像、轨迹日志、抢占恢复 |
推理缓存还应补上正文明确讨论、却没有进入书目的 PagedAttention / vLLM。V4 的 SWA state cache、CSA / HCA 压缩条目、Lightning Indexer cache 具有不同长度、精度、生命周期与 embedding width,不能简单塞进“所有层同尺寸、同 block policy”的经典 paged layout。报告的 on-disk KV cache 是自身系统设计;除非明确标为 DeepSeek 系统史背景,不应把它写成 Mooncake 的直接继承。
Base model 通用评测:28 项
- [8] LongBench-v2:评估 base model 在真实长文档、多文档、代码仓库与结构化数据上的理解和推理。
- [14] HumanEval:测量函数级代码生成。
- [16] FACTS Parametric:测量参数知识的事实性。
- [18] GSM8K:测量小学数学文字题。
- [31] SuperGPQA:覆盖 285 个研究生学科的高难度知识评测。
- [32] DROP:要求在段落上完成离散推理和数值操作。
- [34] MMLU-Redux:修订 MMLU 的错误与歧义,降低评测噪声。
- [37] SimpleQA Verified:以人工复核问题测量短答案事实性。
- [38] Chinese-SimpleQA:测量中文事实知识与长尾本地知识。
- [39] MMLU:多学科 few-shot 理解基线。
- [40] MATH:测量竞赛式数学问题求解。
- [41] C-Eval:中文多学科考试评测。
- [42] MultiLoKo:测量 31 种语言的本地知识。
- [44] LiveCodeBench:以持续更新题目降低污染,测量 post-trained model 的代码竞赛能力。
- [46] TriviaQA:测量开放域问答与远程监督证据利用。
- [48] CMMLU:中文多任务语言理解评测。
- [61] MMMLU:把 MMLU 扩展到多语言设置。
- [69] Humanity’s Last Exam:测量跨学科、难检索的 frontier knowledge 与 reasoning。
- [74] GPQA:测量 graduate-level、难以直接检索的科学问答。
- [78] WinoGrande:对抗式 Winograd 常识消歧。
- [82] MGSM:以多语言 chain-of-thought 设置测量数学推理。
- [84] BIG-Bench Hard:聚合传统模型表现较差的高难度 reasoning 任务。
- [89] MMLU-Pro:以更多选项、更强 reasoning 和更严格筛选提高 MMLU 难度。
- [91] CMATH:测量中文小学数学能力。
- [94] CLUE:报告取其中 CLUEWSC 测量中文指代消歧。
- [96] HellaSwag:测量对抗式常识续写。
- [100] AGIEval:以人类标准化考试测量 foundation model。
- [103] BigCodeBench:测量复杂指令、多函数调用与更现实的代码生成。
这 28 项主要定义“测量什么”,而不是解释“模型为什么变强”。Base 表格由统一内部 harness 重跑 V3.2、V4-Flash 与 V4-Pro,适合做同协议代际比较;它仍不能单凭一个平均分证明某一架构组件有效。CSA、HCA、mHC、Muon 和数据规模的贡献需要受控 ablation,而报告没有为所有组件给出完整可分解实验。
Reasoning、形式化、长上下文与 Agent 评测:20 项
- [1] GDPval-AA:以 Elo 测量现实经济任务中的 agent 产出质量。
- [2] Aristotle:是高计算预算形式化数学管线的比较系统。
- [6] LeanExplore:为 Lean agent 提供开放的声明与 tactic 语义搜索。
- [9] MathArena:以新发布竞赛降低污染;报告使用 Apex 与 Apex Shortlist。
- [10] MCP-Atlas:在真实 MCP server 上测量工具发现、参数构造和多步执行。
- [13] Seed-Prover 1.5:提供 Putnam-200 protocol 与形式化 proving baseline。
- [28] SWE-Bench Pro:强调长 horizon、复杂 repository 与更严格软件任务。
- [49] Tool Decathlon:测量跨多种真实工具的长程 agent 执行。
- [54] CorpusQA:从千万 token corpus 中构造分析与推理问题,报告在 1M 输入上评测。
- [55] IMOAnswerBench:要求稳健、可评判的完整数学答案。
- [56] Terminal-Bench 2.0:测量真实命令行环境中的长程任务执行。
- [58] Lean 4:提供形式化证明语言、编译器和严格 verifier。
- [62] MRCR:以多轮、多 needle retrieval 测量百万 token 上下文。
- [63] Learning to Reason with LLMs:把 reasoning model 与 test-time compute 放入历史背景。
- [64] SimpleQA:原始短答案事实性评测,与后来的 Verified 版本应区分。
- [65] SWE-bench Verified:人工复核的 repository issue resolution 子集。
- [68] GDPval:定义现实、高经济价值专业任务;GDPval-AA 则是对应的动态评分与 leaderboard 层。
- [85] PutnamBench:把 Putnam 竞赛题形式化到 Lean,支撑 Putnam-200 与 2025 frontier test。
- [90] BrowseComp:测量难检索事实上的浏览、证据搜集与长程搜索。
- [95] SWE-smith:正式文献是软件工程训练数据生成工作;SWE-bench Multilingual 官方页面沿用该 citation key,报告据此标注 multilingual issue-resolution 评测。
评测图谱至少要保留四层对象:
- dataset / task:问题、代码仓库或工具环境是什么;
- harness:模型获得哪些搜索、Python、Lean、terminal 或 MCP 工具;
- budget:reasoning effort、采样数、tool-call 上限和 context 上限;
- verifier / metric:exact match、resolved rate、Elo、Lean kernel 还是人工 rubric。
例如 Putnam 结果包含两个不同 regime:一边是固定 Putnam-200、Pass@8、LeanExplore 和有限工具;另一边是先生成并自验证自然语言候选解,再以更高预算驱动 formal agent。把二者压成一个“数学分数”,会抹掉 test-time system 的贡献。
SWE-bench Multilingual 的引用也需要留下注记:其官方页面定义 300 个任务、42 个仓库和 9 种语言,并要求引用 SWE-smith;因此 [95] 是官方推荐的 citation record,却不能据标题误写成“论文专门提出了 Multilingual benchmark”。
七条主链
| 主链 | 历史节点 | V4 落点 |
|---|---|---|
| 长程 token mixing | Transformer → MQA / GQA → MLA → DSA | CSA 的压缩后稀疏检索、HCA 的重压缩 dense 全局通道、局部 SWA |
| depth mixing | residual identity → Hyper-Connections → mHC | 4 路 residual stream、Birkhoff manifold、Sinkhorn projection |
| sparse width | DeepSeekMoE → auxiliary-loss-free routing → Hash Layers | 全层 MoE、早期 hash routing、sequence-wise balance safeguard |
| optimizer | AdamW / Nesterov → Muon → scalable Muon | hybrid Newton–Schulz、按逻辑矩阵更新、ZeRO-aware sharding |
| post-training | R1 / GRPO → domain specialists → OPD / MiniLLM | 多 teacher 全词表 reverse-KL consolidation |
| low precision | QAT → MX formats → gpt-oss | FP4 experts、FP4 indexer QK cache / compute、BF16 score |
| system | FlashMoE / Comet → TileLang / DeepGEMM → DSec | MegaMoE、确定性 kernel、百万 token RL、可抢占 sandbox |
一跳实现与相邻工作
下列节点不属于 103 项正式书目,却是复现、验证或理解 V4 时最有价值的一跳:
- 官方 V4 model collection:区分 Flash / Pro、Base / post-trained、原始 checkpoint / DSpark 附件。
- 官方 inference reference:给出压缩器、attention mask、模型转换和本地执行代码。
- Transformers DeepSeek-V4 文档:把 CSA、HCA、SWA、shared \(K=V\)、partial RoPE 与 grouped projection 对应到可执行模块和配置项。
- DeepSpec / DSpark:发布后附加的 speculative decoding 模块;它不改变底座 checkpoint,不应回写成报告训练阶段的一部分。
- MegaMoE pull request:公开报告所述 fused MoE communication–computation pipeline。
- DeepSeek context caching:服务层的磁盘 prefix cache 说明;产品计费接口与报告中的内部 cache layout 是两个观察层。
- DeepSeekMath:GRPO 的更早方法来源,R1 再把它推到大规模 reasoning RL。
- PagedAttention:理解 V4 为何需要 heterogeneous cache manager 的关键系统背景。
这组一跳扩展只回答“怎样实现、怎样复现、从哪里演化而来”。二跳以后若继续展开,应沿明确问题前进,而不是把所有 paper 的参考文献再次无差别铺平:CSA / HCA 追踪 sparse retrieval 与 temporal compression,mHC 追踪 residual topology 与 matrix scaling,Muon 追踪 matrix geometry,OPD 追踪 reverse-KL sequence distillation,MegaMoE 追踪 expert-parallel overlap。