GPU 执行模型
模型公式描述“要算什么”,GPU 执行模型解释“为什么同样的 FLOPs 会有数量级不同的时间”。性能取决于工作怎样被切成 thread block、warp 和 tile,数据怎样在 HBM、cache、shared memory 与 register 之间移动,以及计算、搬运和同步能否形成稳定流水。
本页以 CUDA 术语说明核心机制,但分析方法同样适用于其他加速器:先找并行执行单元和存储层级,再建立 tile、带宽、同步与调度模型。
从 kernel 到 warp
一次 kernel launch 创建 grid;grid 由 thread block 组成,block 被调度到 SM。一个 block 内的线程以 warp 为基本执行批次。NVIDIA 当前 CUDA 模型中,一个 warp 通常包含 32 个线程,完整语义以 CUDA Programming Guide 为准。
关键边界是:
- 不同 block 通常不能依赖全局同步;
- 同一 block 可通过 shared memory 和 block-level barrier 协作;
- warp 内分支不一致会造成路径串行化;
- block 使用的 register 和 shared memory 会限制同一 SM 上可驻留的 block 数;
- kernel 完成不代表所有异步跨设备操作都已经完成。
“线程更多”不自动意味着并行度更高。若每个线程占用过多 register,resident warp 数反而下降;若大量 warp 都在访问同一低带宽资源,occupancy 较高也可能无助于吞吐。
存储层级
可以把一次访问的选择写成:
| 层级 | 典型作用 | 设计问题 |
|---|---|---|
| register | 每线程标量、局部累加器 | 容量最小;过量会 spill |
| shared memory | block 内 tile 与协作缓存 | bank conflict、容量、barrier |
| L1 / texture cache | SM 附近复用 | 命中行为依架构和访问模式 |
| L2 | 跨 SM 的片上缓存 | 容量竞争与持久化策略 |
| HBM | 大模型权重、激活、KV | 带宽高但远慢于片上复用 |
| host / peer memory | 数据输入、offload、跨设备 | 链路、NUMA、pinning、同步 |
性能优化的核心不是“尽量少用 HBM”这一句,而是让每个从 HBM 读入的 tile 在片上产生足够计算,并保持访问连续、对齐和可合并。
Tile 的容量约束
以矩阵乘法 \(C_{M\times N}=A_{M\times K}B_{K\times N}\) 为例,一个 block 处理 \(M_t\times N_t\) 输出 tile,并按 \(K_t\) 分块。忽略额外 padding 时,双缓冲 shared memory 的数量级为
累加器 register 数量则与 \(M_tN_t\) 成正比。增大 tile 会提高复用,却同时减少 resident block、增加尾部浪费并提高寄存器压力。最优 tile 由 shape、dtype、硬件代际和数据布局共同决定,不是一个固定常数。
Tensor Core 还要求矩阵维度、layout 与 dtype 满足特定指令 tile。边界 shape 通常通过 padding、predicate 或专门 kernel 处理;padding 的 FLOPs 应与模型有效 FLOPs 分开报告。
Tile 小账本
下面对一次 \(K_t\) 迭代建立可核对账本。输入是输出 tile、reduction tile、元素字节数、流水 stage 数和 shared-memory 上限;输出包括 A/B 双缓冲容量、有效 FLOPs、从 HBM 读取一次 A/B 的字节数和理想算术强度。
def gemm_tile_ledger(m_tile, n_tile, k_tile, element_bytes, stages, smem_limit):
    assert min(m_tile, n_tile, k_tile, element_bytes, stages) > 0
    operand_elements = m_tile * k_tile + k_tile * n_tile
    hbm_bytes = element_bytes * operand_elements
    smem_bytes = stages * hbm_bytes
    flops = 2 * m_tile * n_tile * k_tile
    return {
        "smem_bytes": smem_bytes,
        "flops": flops,
        "hbm_bytes": hbm_bytes,
        "arithmetic_intensity": flops / hbm_bytes,
        "fits_smem": smem_bytes <= smem_limit,
    }

ledger = gemm_tile_ledger(64, 64, 32, element_bytes=2, stages=2, smem_limit=48 << 10)
assert ledger["smem_bytes"] == 16_384
assert ledger["flops"] == 262_144
assert ledger["arithmetic_intensity"] == 32 and ledger["fits_smem"]
账本的不变量是流水 stage 只扩大驻留容量,不会把同一 tile 的逻辑 HBM 读取重复计入;乘加按 \(2\) FLOPs 统计。它尚未计入 accumulator register、C 的读写、padding、cache miss 和重读,因此是乐观上界而非 kernel 性能预测;把 tile 放回完整显存与通信账本的组合实验见手撕:分布式与容错。
Coalescing、对齐与 bank conflict
连续线程访问连续地址,才能把多个内存请求合并。常见退化包括:
- stride 导致一个 warp 跨越许多 cache line;
- 不满足向量化 load/store 对齐;
- transpose 或非连续 tensor 触发额外 copy;
- shared memory 多线程落到同一 bank;
- GQA、paged KV 或 MoE permutation 产生间接寻址;
- 为少量有效元素加载完整 tile。
逻辑上“只读一次”的 tensor 也可能因 cache miss 或 layout 不合适被重复从 HBM 读取。有效带宽必须依据 profiler 的真实 transaction,而不是只用 tensor 大小估计。
Latency hiding 与 occupancy
当一个 warp 等待内存时,SM 可切换到另一个 ready warp。足够的 resident warp 有助于隐藏延迟,但 occupancy 只是手段:
高 occupancy 不等价于高利用率。计算密集 GEMM 可能用较低 occupancy 换取更大的 register tile;低指令级并行、依赖链长或带宽饱和时,再增加 warp 也不会提速。
应结合以下指标判断:
- eligible warps per cycle;
- stall reason;
- achieved occupancy;
- tensor / vector pipe utilization;
- HBM、L2 与 shared-memory throughput;
- register spill 与 local-memory transaction。
流水与异步搬运
同步 tile 循环可抽象为:
使用双缓冲和异步 copy 后,稳态下界接近
这要求下一 tile 的地址、buffer 生命周期和依赖能提前确定。错误的 barrier 可能读到未完成数据;过多 stage 又会吃掉 shared memory 和 register。
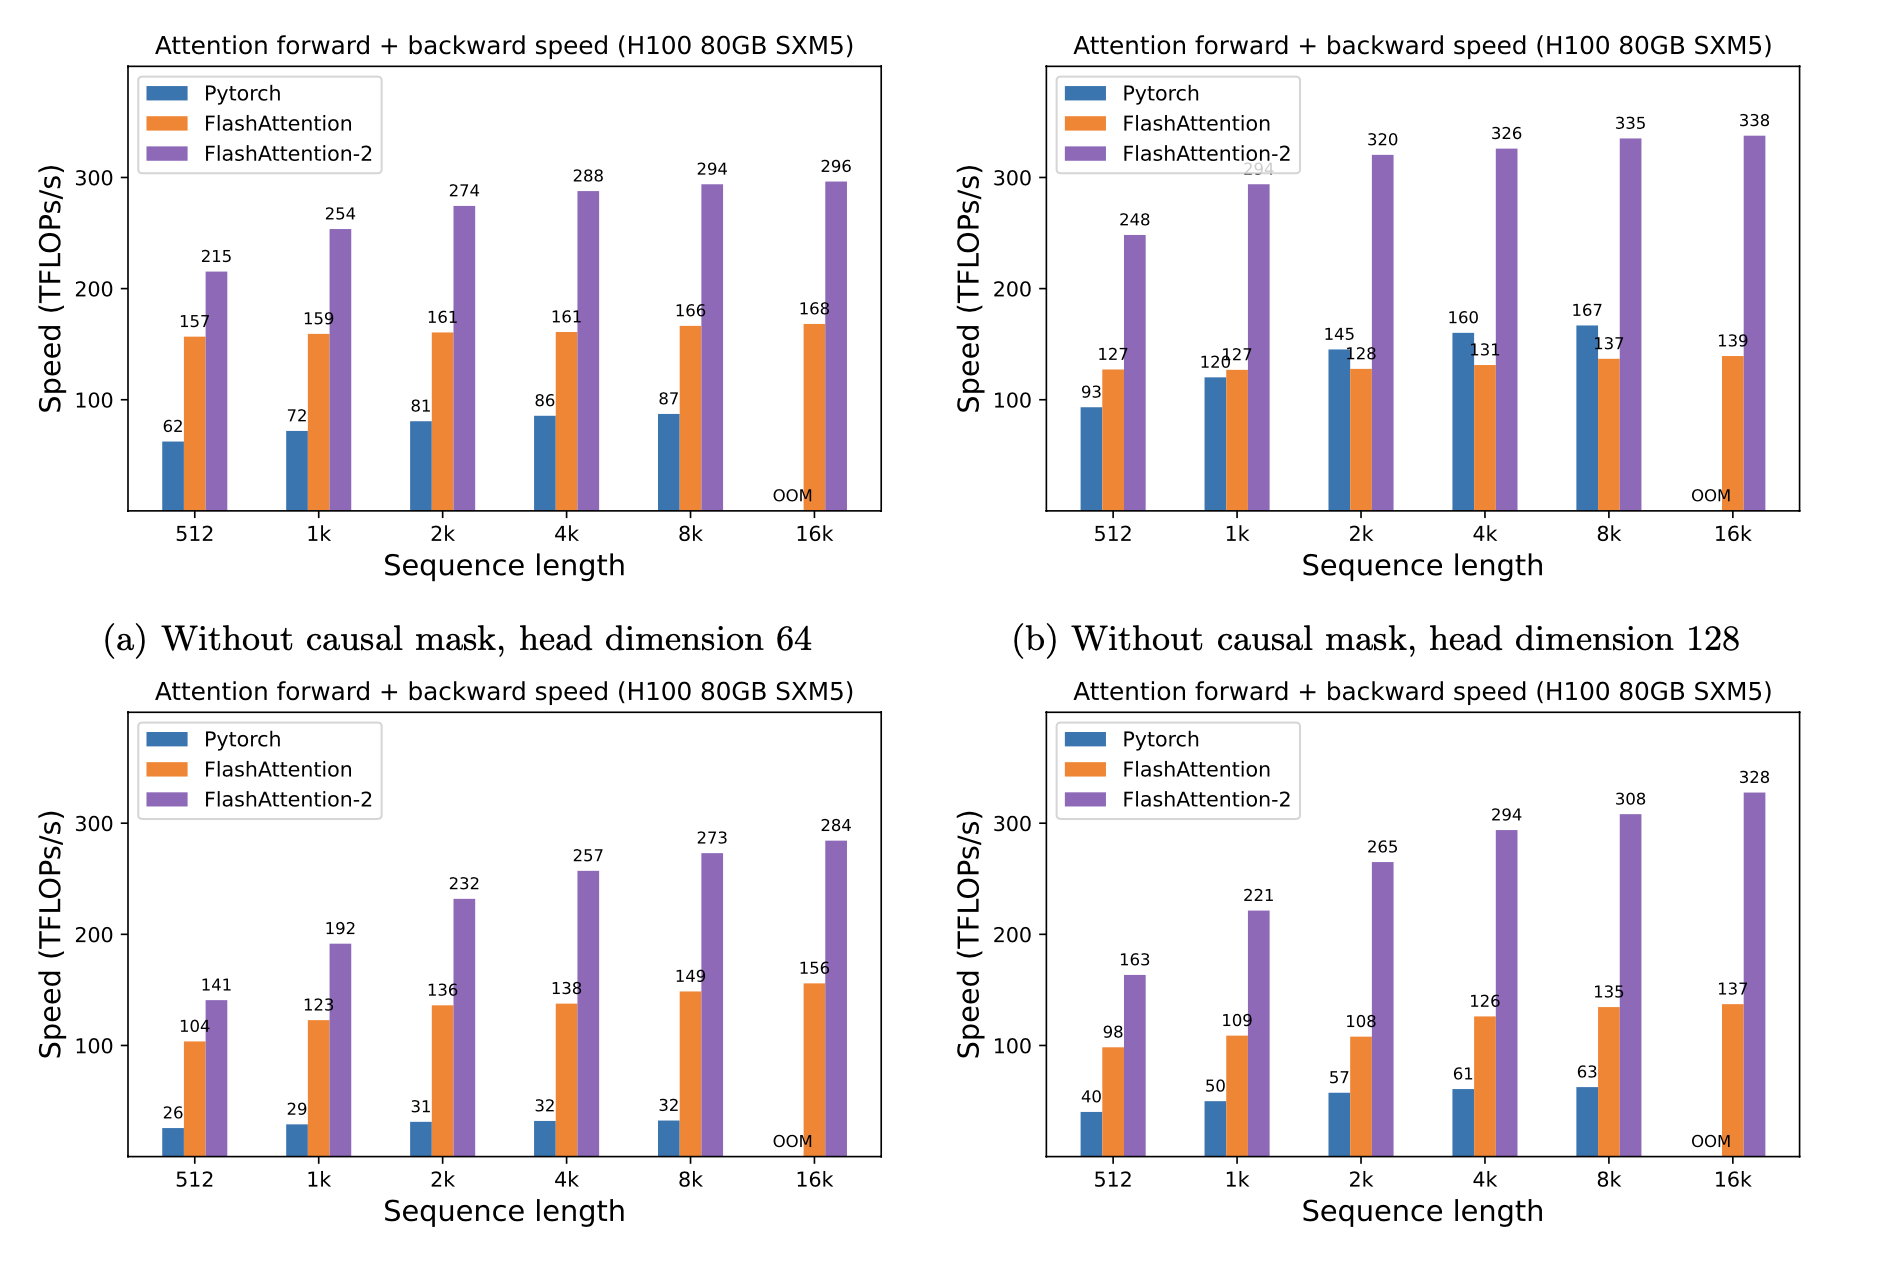
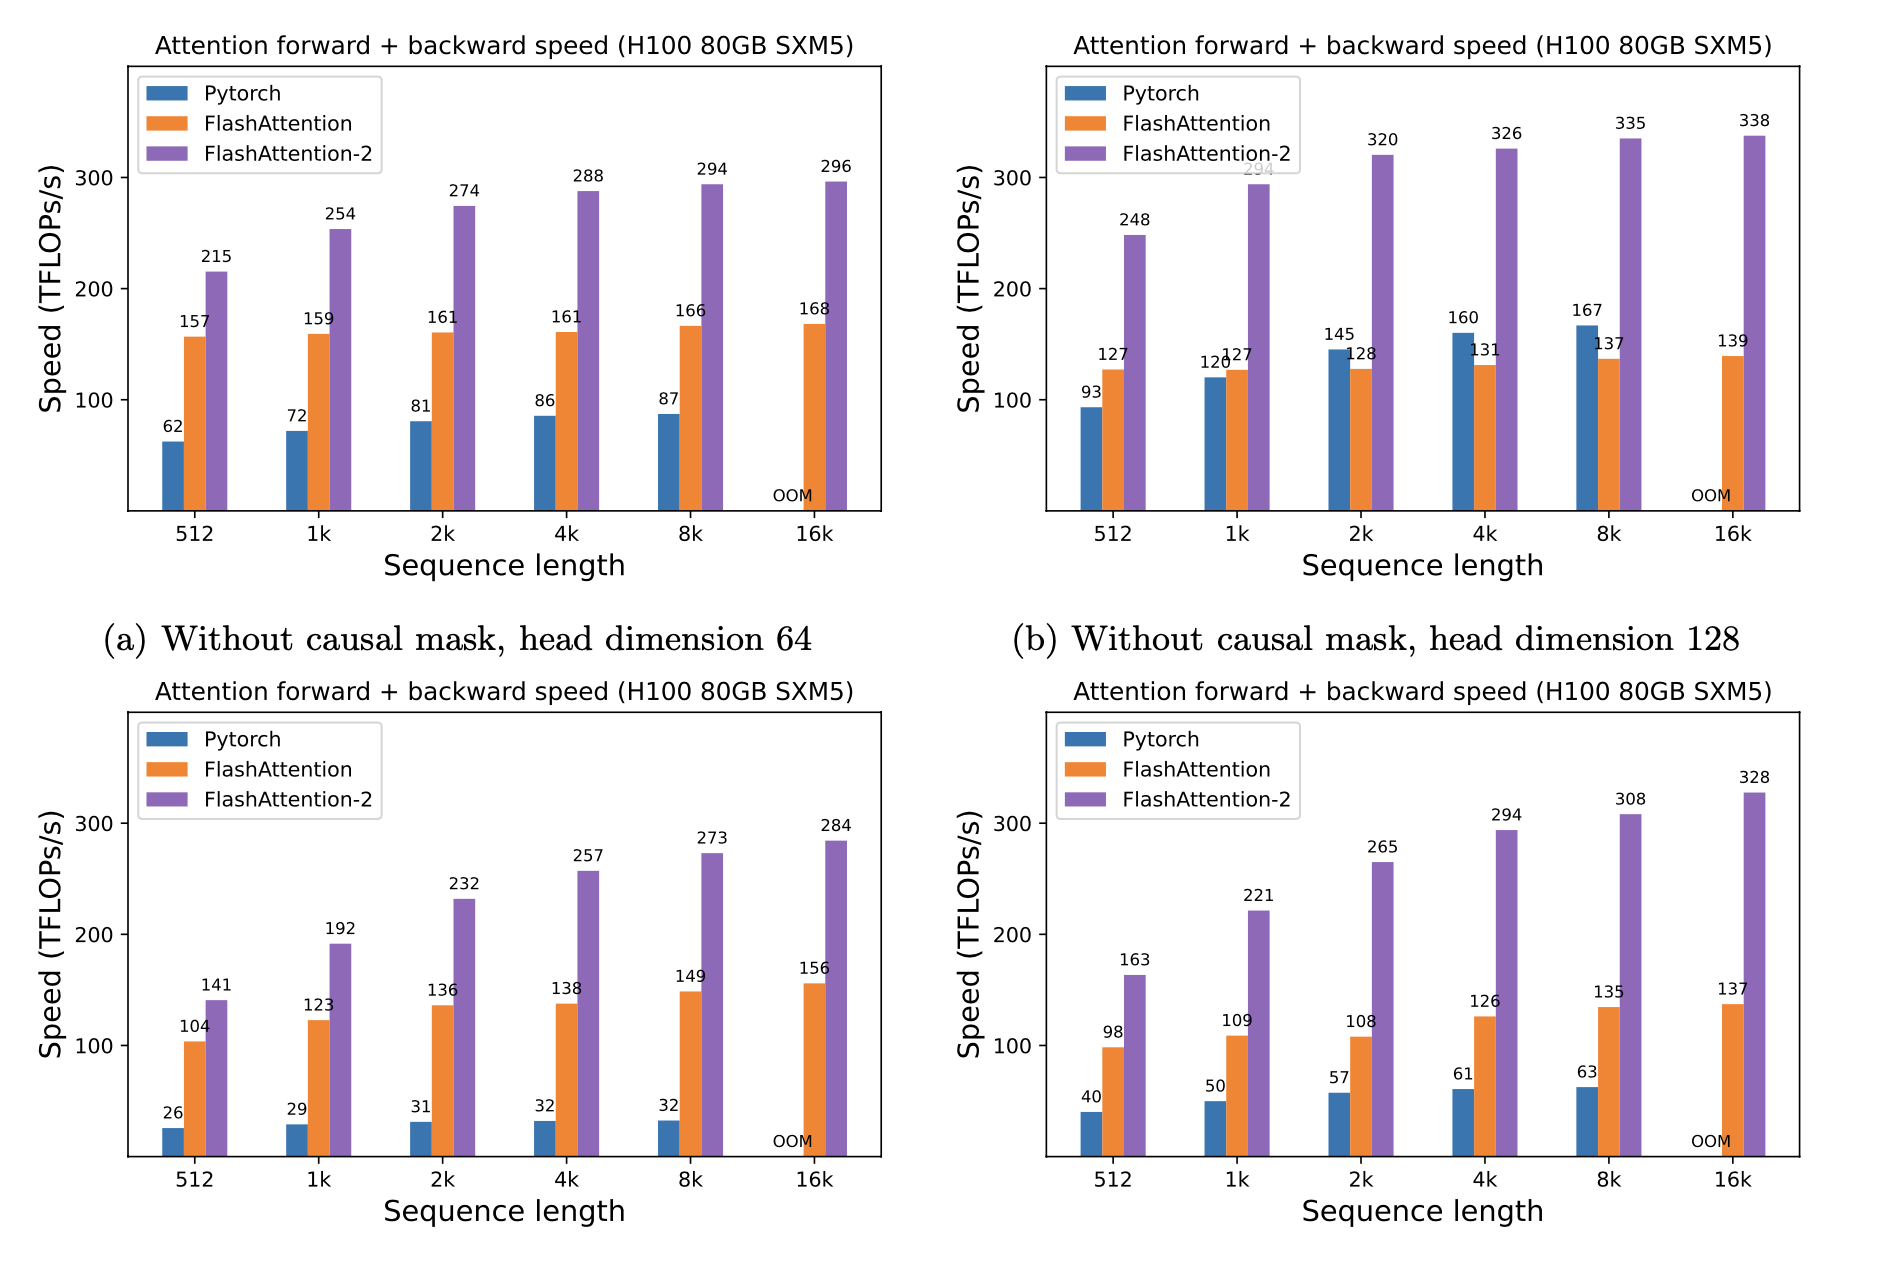
Hopper 上的 TMA 可把多维 tensor 搬运交给专门硬件;warp specialization 可令 producer warp 负责搬运、consumer warp 负责矩阵计算或 softmax。FlashAttention-3 展示了这种异步性在 attention 中的组合方式。这是硬件特定优化,不应把“TMA”写成所有 GPU 的通用实现要求。
Warp specialization
同一 block 内的 warp 不必做完全相同的工作。可以划分为:
- producer:发起 global-to-shared 搬运;
- consumer:执行 Tensor Core GEMM;
- reduction / epilogue:处理 softmax、scale 或写回。
收益来自减少职责切换并增加流水重叠,代价是更复杂的 barrier、buffer ownership 和负载平衡。若 tile 太小、阶段数不足或 producer 成为串行瓶颈,specialization 可能不如同构 warp。
Fusion 的收益与上限
若未融合序列把中间 tensor 写入并再次从 HBM 读取,融合可节省近似
但融合会增加:
- kernel 参数与动态分支;
- register live range;
- 编译时间和 cache 变体;
- 数值语义耦合;
- graph capture 与调试难度。
若 register spill、occupancy 下降或融合后无法使用高效库 GEMM,端到端反而可能变慢。应优先融合 bandwidth-bound 的 pointwise / reduction 边界,而不是为了减少 kernel 数盲目扩大算子。
Launch、CUDA Graph 与动态 shape
小 batch decode 和大量小算子容易受 CPU launch latency 控制。假设每步有 \(K\) 个 kernel,平均 launch 开销为 \(t_l\),不能被隐藏的上界为
CUDA Graph 可复用稳定的 launch 图和地址,减少调度开销。在线推理通常需要:
- 固定或分桶后的 shape;
- 可复用输入、输出和 workspace 地址;
- 预分配 KV 与采样状态;
- graph 外处理真正动态的控制面;
- 模型、adapter、dtype 与 kernel 版本参与 cache key。
shape bucket 太少会 padding 浪费,太多会增加 capture 时间、显存和编译缓存。graph replay 不应掩盖 stale pointer、已释放 KV block 或跨流依赖错误。
编译与 autotune
Triton tutorials 展示了以 tile 和 program instance 表达 GPU kernel 的方式;CUTLASS 则提供更接近硬件指令和 collective kernel 的模板。二者解决的是不同抽象层的问题。
autotune 的搜索空间通常包括:
- tile shape;
- warp 数与 pipeline stage 数;
- split-\(K\) 或 persistent 策略;
- vector width;
- epilogue fusion;
- shared-memory layout。
候选选择必须按硬件、dtype、shape、stride、mask 和软件版本缓存。线上请求不应在关键路径触发无界编译或 autotune;应预热主流 bucket,并给冷 shape 设计有界 fallback。
正确性契约
一个 GPU kernel 至少声明:
- 输入、输出 shape、stride、layout、dtype 与 alignment;
- 尾部 tile 的 predicate 和越界保护;
- mask、causal offset 与 padding 语义;
- accumulator、reduction、舍入与 saturation;
- 输入输出是否允许 alias,哪些 buffer 会被修改;
- shared-memory stage 与 barrier 的 happens-before;
- stream、event 和异步 copy 的生命周期;
- graph capture 安全性与地址稳定要求;
- deterministic 与 RNG replay 边界。
优化版本必须保留独立 reference path。只比较随机正态输入不足以发现全 mask、极端长度、非连续 stride、NaN、重复索引和 page 边界错误。
何时不用自定义 kernel
- 算子已经映射到高度优化且稳定的库实现;
- shape 很少执行,编译和维护成本超过运行收益;
- 目标硬件多样,而优化依赖单一代际特性;
- 算子不在 critical path;
- 动态控制流和稀疏模式无法稳定分桶;
- 数值、backward 或高阶梯度契约尚未建立;
- 融合会破坏可观测性或可靠 fallback。
成熟系统通常保留多条路径:库 kernel、自定义快路径和语义清晰的 reference,而不是让所有 shape 强行经过一个“大一统”kernel。
验证流程
- 用小 shape reference 验证 forward、backward 和边界 mask。
- 覆盖对齐与非对齐维度、连续与非连续 stride、空输入和最大支持 shape。
- 使用 sanitizer 或等价工具检查越界、race 和未初始化读取。
- 记录 register、shared memory、occupancy、spill 与各层带宽。
- 分离 compile、warmup、allocation、host-device copy 和稳态执行时间。
- 报告中位数和尾部分位,不以单次最小值代表性能。
- 把 kernel 放回真实 step 或请求 trace,使用 Amdahl 上限核对端到端收益:
其中 \(f\) 是原始关键路径中该 kernel 的占比。
自定义 Triton kernel 若需进入编译图,应遵守 PyTorch 官方集成契约;平台级 benchmark 还应记录驱动、runtime、时钟与功耗状态。
从算术强度判断优化上限见性能模型,attention 的具体数据流与 online softmax 见 Attention Kernel。
异构加速器上的融合不能只换 API
GLM-5 报告的 Ascend 案例同时改变量化格式、稀疏 attention kernel、MLA preprocessing、D2H sampling overlap、parallel layout 与 communication。这样的 full-stack adaptation 说明性能可移植性的单位不是单个算子名字,而是完整 execution graph。
例如 MLAPO 把 13 个小算子融合后,收益可能来自 launch 减少、中间张量不落 HBM,以及 Vector/Cube 单元并行;换到另一硬件若执行单元、片上存储或调度方式不同,保持“13-op fusion”这个数字没有意义。可迁移的是依赖图和成本分解,平台特定的是 tile、buffer、pipeline 与通信 overlap。
因此跨硬件“性能相当”至少要对齐模型 revision、量化误差、输入输出长度、batch、并发、SLO、功耗和总节点成本。GLM-5 报告没有公开足够数据重建其单节点对双集群比较,相关数字只能保留作者口径。