SAO 与 CompactionRL:长程 Agentic RL 的两条轴
长程 Agentic RL 同时受两种物理约束支配:一条沿 wall-clock time 展开,轨迹越长、完成时间越不齐,同步等待和 policy lag 越严重;另一条沿 context space 展开,交互历史不断增长,最终必须截断、检索或压缩。2026 年的 SAO 与 CompactionRL 分别处理这两个方向:
- SAO 让单条 rollout 完成后即可进入异步训练队列,并用 critic、token 级行为概率与严格双侧筛选控制方差和策略漂移;
- CompactionRL 在固定工作窗口内生成摘要、重建上下文,并让执行 token 与摘要 token 共同接受最终任务奖励。
它们不是同一个算法的两个名字,也不是“彻底淘汰 GRPO”的结论。更准确的理解是:当 prompt 内成组采样成为同步屏障,或者一次任务被压缩成数量不定的训练段时,critic-based、token-level、single-rollout PPO 提供了一种更自然的接口。
先把两个瓶颈分开
设一次任务产生交错轨迹
其中 \(a_t\) 是模型生成的 action,\(o_t\) 是环境返回的 observation。轨迹会同时变长和变慢,但两者造成的问题不同:
| 轴 | 直接现象 | 训练层后果 | 目标 |
|---|---|---|---|
| 时间轴 | rollout 时长重尾,快样本等待慢样本 | 同步屏障、数据变旧、learner 与 behavior policy 分离 | 尽早消费完成的轨迹,同时限制 off-policy |
| 空间轴 | prompt、工具输出与推理不断占用上下文 | 超出窗口;压缩后一个任务变成可变数量的 segment | 在固定峰值窗口内继续任务,同时保持跨段信用 |
SAO 主要改变“轨迹何时可训练”;CompactionRL 主要改变“轨迹以什么状态表示继续、怎样跨段训练”。一个系统可以同时需要二者。
为什么成组优势在这里不顺手
GRPO 对同一 prompt 采样 \(G\) 条 rollout,并用组内 reward 统计量形成 advantage:
这在可并行生成、长度相近、每个 prompt 能稳定取得多个结果的任务上很方便,因为无需训练 critic。长程 agent 场景却会暴露两个结构性摩擦。
时间轴:组本身是 barrier
如果同一组的完成时间为 \(t_1,\ldots,t_G\),这一组最早只能在
后计算组内优势。先完成的轨迹既不能单独更新,又会在等待期间相对 learner 变旧。SAO 删除的是这道 prompt-level group barrier,而不是删除异步系统固有的 policy lag。
空间轴:一个 rollout 不再对应一个训练样本
若第 \(g\) 条 rollout 经压缩后得到 \(K_g\) 个 segment,\(G\) 条 rollout 会展开成
个训练段。把 segment 当组成员,会让压缩次数多的 rollout 在统计中重复出现;只在完整 rollout 上归一化,又不能直接给独立执行的每个段提供 token-level credit。CompactionRL 因而改用 value function。
这不是对 GRPO 的普遍否定。若环境便宜、同 prompt 多样采样有价值、组内 reward 有足够方差且同步等待可控,group-relative baseline 仍可能更省显存和实现成本。方法选择的完整坐标见推理 RL 配方地图与推理策略优化谱系。
共同底座:critic 回到闭环
两项工作的公开实验都使用 group size \(1\)、token-level advantage、value pretraining、每批两次 critic update 与一次 policy update,以及 VAPO 中的 length-adaptive GAE:
其中 \(l\) 是 response length;critic 侧使用 \(\lambda_{\mathrm{critic}}=1\)。这组设置说明它们共享 value-based 长序列训练的若干工程选择,但论文没有把二者正式定义为“VAPO 的两个子类”。
CompactionRL 把一个 rollout 拆成长度不同的多个 segment 后,究竟为跨段折扣选用哪个 \(l\) 对应的 \(\lambda\),论文没有进一步披露。公式可读不等于所有实现自由度已经消失。
公开证据还需要进一步拆开:
| 事实 | SAO | CompactionRL |
|---|---|---|
| 方法论文给出完整目标与消融 | 是 | 是 |
| 论文明确使用 slime | 未披露 | 是 |
| 方法级训练代码随论文公开 | 未发现 | 未发现 |
| 论文称已用于 GLM-5.2 RL pipeline | 是 | 是 |
最后一行是两篇方法论文各自给出的部署声明,不是独立复现实验。当前 GLM-5.2 技术博客与公开模型卡没有逐项确认 SAO 或 CompactionRL 配方;较早的 GLM-5 技术报告披露了基于 slime 的异步 agentic RL 基础设施,但其中仍按 group-wise rollout 介绍训练流程。因此它只能支持相关系统脉络,不能替代两篇方法论文作为 GLM-5.2 具体训练实现的证据。
SAO:时间轴上的异步稳定性
从“等同组”改成“完成即可进入训练队列”
SAO 为每个 prompt 采样一条 rollout。轨迹完成后即可成为 learner 的可用样本,不必等待同 prompt 的其他候选。这里的 single rollout 是 group size 为 1,不是 learner 每收到一个样本就立刻更新一次;论文实验仍以 128 条轨迹组成 global batch。这样减少了由组内 straggler 额外制造的 staleness,也适配真实在线环境中“一次状态只返回一条后续轨迹”的数据形态。
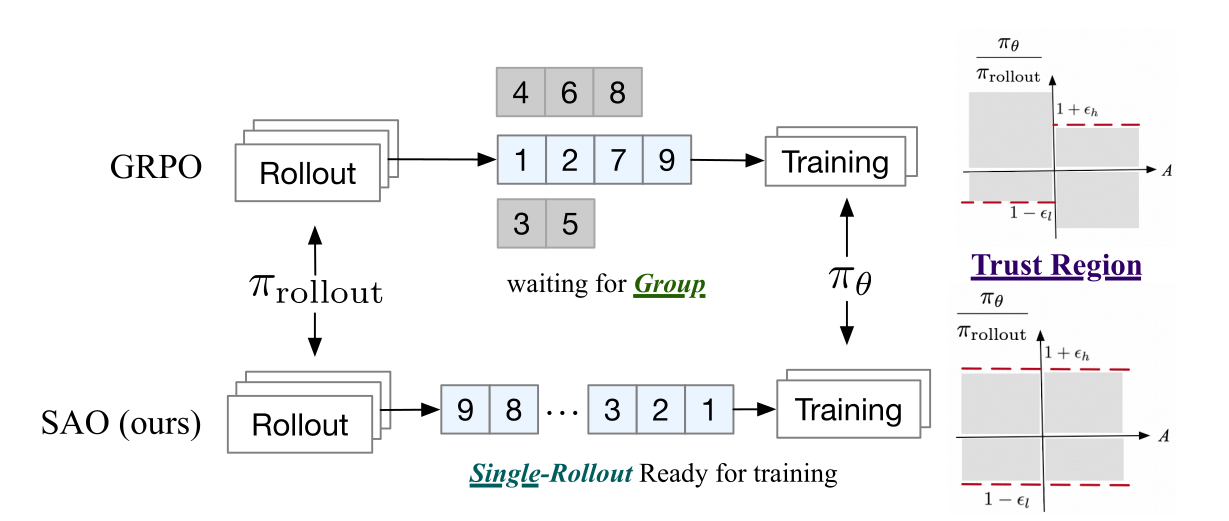
代价同样直接:失去组内 baseline 后,单条 Monte Carlo reward 的方差很高,必须依赖状态相关的 critic。SAO 因而不是一个单独的 scheduler trick,而是“异步消费 + token-level correction + value-model recipe”的组合。
三个 policy 角色
解耦 rollout 与训练时,至少要区分:
- \(\pi_\theta\):learner 当前正在更新的 policy;
- \(\pi_{\mathrm{old}}\):PPO 通常用于构造 ratio 的旧 policy;
- \(\pi_{\mathrm{rollout}}\):实际产生 token 的 inference policy。
经典分解可写成
长轨迹生成期间 rollout engine 可能多次刷新权重,为每个 token 重建对应的完整历史 checkpoint 很昂贵。SAO 保存 rollout 阶段记录的 token log-probability,并计算
论文把这一记录值作为每个可训练 token 的 behavior log-probability proxy,而不是只给整条 episode 附一个版本号。proxy 只有在记录过程覆盖真实采样语义时才等价于 behavior distribution:temperature、top-\(p\)、top-\(k\)、grammar mask 或 routing 若改变了实际分布,却仍保存变换前的 model log-probability,ratio 就不再是严格的重要性比率。
current、old、rollout behavior 与 reference 的统一记号,以及 policy lag 和 engine mismatch 的分解见策略身份、训推分布与策略滞后。
DIS 不是普通 PPO clip
SAO 的 Direct Double-Sided Importance Sampling 定义
并用
普通 PPO 把 surrogate 限在边界上;哪些方向被截断取决于 advantage 正负。DIS 则无论 advantage 正负,只要 ratio 越出双侧区间,就让该 token 完全不参与梯度:
| ratio 区域 | PPO,\(\widehat A_t>0\) | PPO,\(\widehat A_t<0\) | SAO DIS |
|---|---|---|---|
| \(r_t<1-\epsilon_l\) | 保留未裁剪项的梯度 | 进入常数裁剪区 | 丢弃 |
| 区间内部 | 保留梯度 | 保留梯度 | 保留梯度 |
| \(r_t>1+\epsilon_h\) | 进入常数裁剪区 | 保留未裁剪项的梯度 | 丢弃 |
因此 DIS 更像 hard trust gate。它以偏差换稳定性:极端 off-policy token 不再主导更新,但被系统性丢弃的数据可能带来 selection bias。下面实现只冻结“ratio 作为样本权重和门控”的语义;论文公式没有披露 method-specific autograd 实现,复现时必须显式决定 ratio 是否 stop-gradient。
PPO、TIS、IcePop 与 DIS 所使用 ratio、粒度和越界梯度的逐项对照见 Ratio、Clipping 与 Gate。
import math
import torch
def dis_policy_loss(logp, rollout_logp, advantage, action_mask, eps_l, eps_h):
    ratio = (logp - rollout_logp).exp()
    keep = action_mask & (ratio > 1 - eps_l) & (ratio < 1 + eps_h)
    weight = ratio.detach() * advantage.detach() * keep.to(logp.dtype)
    loss = -(weight * logp).sum() / action_mask.sum().clamp_min(1)
    return loss, keep
logp = torch.tensor([0.0, math.log(0.69), math.log(6.1)], requires_grad=True)
loss, keep = dis_policy_loss(
    logp, torch.zeros(3), torch.tensor([1.0, -1.0, 1.0]),
    torch.ones(3, dtype=torch.bool), eps_l=0.3, eps_h=5.0
)
loss.backward()
assert keep.tolist() == [True, False, False]
torch.testing.assert_close(logp.grad, torch.tensor([-1.0 / 3, 0.0, 0.0]))
分母仍是全部有效 action token 数;改用 keep.sum() 会把被拒绝 token 的零贡献重新归一化成“仅在幸存 token 上取均值”,改变公式中的 hard-zero 语义。实验中的区间并不总是数值上很窄:数学任务使用 \(\epsilon_l=0.3,\epsilon_h=5.0\),coding 使用 \(0.8,3.0\)。“strict”指越界后置零,而不是上下界一定接近 \(1\)。
critic 为什么要特殊照顾
单 rollout 成立的前提不是“critic 存在”,而是 critic 足够快地跟上 policy。SAO 报告了四项配套设计:
- 更新速度:每次 policy update 对 critic 做 \(K=2\) 次 update,实验中 critic learning rate 也是 actor 的五倍;
- Frozen Attention:在其 MoE value model 上冻结 attention,并把主要可训练主体限制在 MoE projection;value head 等参数的精确匹配规则没有披露。这是该架构和实验中的正则化选择,不是所有 critic 的通用定律;
- 扩大 value pretraining:减轻 critic cold start,但论文未披露可完整复现的数据规模与方法代码;
- Skip-Observation GAE:只在模型生成的 action token 链上递推 value。
最后一点最容易误解。它不是忽略工具结果:下一段 action 的 value 仍以已经包含 observation 的上下文为条件。它只是不给外部 observation token 本身设置 policy/value 递推位置。动作末 token 到下一动作首 token 的边界写成
这相当于先选定 action-token 时间轴,再在该子序列上做 GAE;terminal、truncation 与跨 turn bootstrap 的通用语义见 Advantage 估计与 GAE。
一个最小实现可以先抽出 action token 索引,再在这条子序列上反向递推:
import torch
def skip_observation_gae(reward, value, action_mask, gamma, lam):
    idx = action_mask.nonzero(as_tuple=False).flatten()
    advantage = torch.zeros_like(value)
    gae = value.new_zeros(())
    for p in range(idx.numel() - 1, -1, -1):
        t = idx[p]
        next_v = value[idx[p + 1]] if p + 1 < idx.numel() else value.new_zeros(())
        delta = reward[t] + gamma * next_v - value[t]
        gae = delta + gamma * lam * gae
        advantage[t] = gae
    return advantage
mask = torch.tensor([True, False, False, True])
reward = torch.tensor([0.0, 0.0, 0.0, 1.0])
v1 = torch.tensor([0.2, 999.0, -999.0, 0.4])
v2 = torch.tensor([0.2, -3.0, 8.0, 0.4])
test_gamma, test_lam = 0.9, 0.8
a1 = skip_observation_gae(reward, v1, mask, test_gamma, test_lam)
a2 = skip_observation_gae(reward, v2, mask, test_gamma, test_lam)
torch.testing.assert_close(a1[mask], a2[mask])
assert torch.count_nonzero(a1[~mask]) == 0
test_gamma 与 test_lam 只用于验证跳过 observation 位置这一机制,不是论文披露的 SAO 超参数:论文未报告精确 \(\gamma\),policy 侧 \(\lambda\) 采用前述 length-adaptive 规则。真实实现还要区分 terminal 与 truncated、action 内部 token、跨 turn reward、padding 和 packed sequence;这些数据契约见轨迹与策略契约。
CompactionRL:空间轴上的压缩信用
它学习“怎么压”,不学习“何时压”
令当前历史为
其中每个 action–observation pair 被视为不可被压缩切开的原子 step。工作上下文预算为 \(C\),剩余空间低于固定阈值时触发压缩:
同一个 trainable policy 接收固定 summary instruction 并生成
随后从以下上下文继续:
论文默认保留最近 \(k=2\) 个完整 step,必要时继续减小 \(k\) 以满足预算。压缩触发器本身是规则,不由 RL 学习;被训练的是 summary 内容以及模型在 summary-conditioned state 下的后续执行。
实验最多压缩三次,因此把一次任务的执行预算扩到峰值窗口的约四倍;这不等于保留四倍原始信息,也不等于拥有一个四倍长度的完整 attention window。summary 与 recent tail 会占用新窗口,旧历史也会不可逆丢失。固定峰值窗口通常有利于限制 KV working set 与后期 attention 成本,但论文没有报告 GPU-hours、FLOPs、吞吐或显存数据,不能据此断言总训练成本必然下降。
摘要为什么是 action
一次压缩 rollout 被分成
每个 \(\sigma_s\) 是 execution segment 或 summarization segment。两者都由同一个 policy 生成,也都使用最终任务 reward \(R(\tau)\)。论文没有额外设计 summary-quality reward,原因是一个“语言上漂亮”的摘要未必保留了后续任务真正需要的文件路径、错误状态和未完成约束。
这让 summary 变成信息瓶颈上的决策:漏掉一个关键状态,之后所有 action 都会在错误 belief 上展开。论文固定执行 agent、只替换 summary agent 时,SWE-bench Verified 的结果在 \(49.0\) 到 \(55.5\) 之间变化,说明 summary quality 足以显著改变终态成功率;但这仍是特定模型、scaffold 与 200 题子集上的结果。
Token-level normalization 修复的是什么
对 batch 内所有可训练 assistant token 的位置集合 \(\mathcal M\),CompactionRL 使用标准 PPO ratio
并在全局 token 集合上平均:
它消除了“先对每个 segment 求均值、再对 segment 求均值”带来的 segment-count bias。需要注意,它赋予的是 每个可训练 token 等权,不是每条 rollout 等权;token 更多的 rollout 在 batch 总和中仍会贡献更多项。若目标是 rollout-balanced optimization,还需要额外的 per-rollout weighting,不能从这条公式自动得到。
Cross-trajectory GAE 修复的是什么
若每个 segment 都被当作独立小轨迹,并把共享终态 reward 放到每段末端,那么早期 action 看起来离成功过近。设 \(\sigma_s\) 有 \(n_s\) 个优化 token,段内 local GAE 为
后续 segment 一共有
个优化 token。CompactionRL 使用
于是 token \((s,i)\) 到最终 outcome 的总折扣指数恢复为
下面代码冻结两个不可约逻辑:全局 token mean,以及按后续优化 token 数修正早期 segment。它不是 rollout collector、critic trainer 或完整 PPO。
import torch
def cross_segment_advantage(local_advantages, gamma=0.99, lam=0.95):
    corrected = [None] * len(local_advantages)
    later_tokens = 0
    for s in range(len(local_advantages) - 1, -1, -1):
        corrected[s] = local_advantages[s] * (gamma * lam) ** later_tokens
        later_tokens += local_advantages[s].numel()
    return corrected
def token_mean(segment_losses):
    return torch.cat([x.reshape(-1) for x in segment_losses]).mean()
local = [torch.ones(2), torch.ones(3)]
corrected = cross_segment_advantage(local)
torch.testing.assert_close(corrected[0], torch.full((2,), (0.99 * 0.95) ** 3))
torch.testing.assert_close(corrected[1], torch.ones(3))
segments = [torch.tensor([1.0, 3.0]), torch.tensor([9.0])]
torch.testing.assert_close(token_mean(segments), torch.tensor(13.0 / 3.0))
assert token_mean(segments) != torch.stack([x.mean() for x in segments]).mean()
这里的“距离”按 optimized token 计数,不是 wall-clock time、工具调用次数或全部 observation token 数;而 cross-trajectory GAE 仍只是 full-trajectory credit assignment 的近似。论文也把这一点列为限制。
两条轴怎样组合
把二者放进同一闭环,可以得到:
task
  -> rollout under fixed context
  -> threshold reached
  -> policy writes summary
  -> context rebuilt, rollout continues
  -> completed rollout enters learner without prompt-group barrier
  -> cross-segment advantage
  -> DIS / PPO policy update + faster critic update
  -> versioned weight refresh
组合时仍有四个不能互相替代的问题:
| 问题 | SAO 是否解决 | CompactionRL 是否解决 |
|---|---|---|
| prompt 内 group straggler | 直接处理 | 通过 group size \(1\) 避开,但不是主题 |
| learner–behavior policy lag | DIS 部分控制 | 依赖底层异步 trainer,论文目标不是校正 lag |
| 固定工作窗口内继续任务 | 否 | 直接处理 |
| 跨压缩边界信用分配 | Skip-Observation GAE 不足以处理 | Cross-trajectory GAE 近似处理 |
还要记录 segment provenance。一次原始任务的所有 execution/summary segment 应共享 immutable trajectory_id,并各自保存 segment_index、context reconstruction recipe、policy version、exact token IDs、rollout 侧记录的 behavior log-probability proxy、action mask、compaction trigger、终止类型与最终 reward。否则系统可能重复消费 segment、把 mixed-policy 轨迹伪装成单一 behavior policy,或在压缩后无法重算同一个状态。
实验到底支持到哪里
SAO
SAO 在 Qwen3-30B-A3B 上报告:
| 设置 | 对照 | 结果 |
|---|---|---|
| 数学工具推理 | SAO vs GRPO + DIS | AIME2025:\(97.3\) vs \(93.5\);BeyondAIME:\(74.8\) vs \(70.8\) |
| Coding agent | SAO vs GRPO + DIS | SWE-bench Verified:\(29.8\) vs \(27.0\) |
| 稳定性 | vanilla GRPO | 论文设置中约 \(160\) step collapse;SAO 训练至约 \(1000\) step |
| critic update | \(K=2\) vs \(K=1\) | AIME2025:\(97.3\) vs \(95.0\);BeyondAIME:\(74.8\) vs \(69.8\) |
这些数字来自 SAO 的主实验与消融,支持“在该 30B backbone、数据、异步 pipeline 与预算下,整套 SAO recipe 优于所测基线”。它们不证明每个异步 RL 系统都应使用同样的 clipping interval、冻结 attention 或 \(K=2\)。论文没有报告 wall-clock、GPU 利用率、训练 FLOPs 或吞吐对照,因而不能从这些结果量化系统加速比。在线学习实验只是按阶段切换写作风格 reward 的模拟环境,不是现实用户流量上的安全在线学习证据。
CompactionRL
CompactionRL 使用 64K 或 80K 峰值工作窗口,最多压缩三次;SWE-bench Verified 只评估随机 200 题子集,所有实验均值来自两次 evaluation run。论文把较大模型写作“106B-A30B”,而 GLM-4.5 官方模型卡将 GLM-4.5-Air 标为 106B 总参数、12B 激活参数;论文实验设置又说明实际训练起点是经过 coding trajectory SFT 的 GLM-4.5-Air-SFT,表中却缩写为 GLM-4.5-Air。下表只写总参数量,并保留这些披露差异:
| 模型 | 方法 | SWE-bench Verified,compacted | Terminal-Bench 2.0,compacted |
|---|---|---|---|
| GLM-4.7-Flash 30B-A3B | base | \(50.5\) | \(13.4\) |
| GLM-4.7-Flash 30B-A3B | PPO without compaction | \(48.0\) | \(12.4\) |
| GLM-4.7-Flash 30B-A3B | CompactionRL | \(56.0\) | \(20.2\) |
| GLM-4.5-Air 106B | base | \(59.8\) | \(21.4\) |
| GLM-4.5-Air 106B | PPO without compaction | \(62.5\) | \(23.6\) |
| GLM-4.5-Air 106B | CompactionRL | \(66.8\) | \(24.5\) |
这些数字来自 CompactionRL 的主实验,支持“训练时经历压缩并优化 summary,能改善同类 compacted inference”。它不支持“压缩对所有使用方式都更强”:关闭压缩进行 single-window evaluation 时,30B CompactionRL 为 \(43.7\),低于 base 的 \(47.5\);106B 为 \(57.3\),也略低于 base 的 \(57.8\)。论文明确把这种 train–test mismatch 列为限制。
消融中,106B 去掉 token-level normalization 后 SWE / Terminal 分别从 \(66.8/24.5\) 降至 \(60.0/21.3\);去掉 cross-trajectory GAE 后为 \(63.0/22.5\)。这说明两项修正与性能相关,但两次评估、单一训练家族和有限 benchmark 还不足以给出跨领域普遍因果结论。
复现时真正要审的接口
Rollout
- 保存 exact token IDs,而不是把文本重新 tokenize;
- 若要把 ratio 解释为严格 importance ratio,保存采样变换后的实际 behavior distribution 对应的 per-token log-probability;否则明确其只是 proxy;
- action 与 summary token 进入 loss,observation、prompt、padding 不进入;
- 明确一个 episode 内是否允许 policy refresh,并保存 per-segment / per-token provenance;
- compaction 不得切开 action–observation 原子 step。
Critic 与 advantage
- value pretraining 数据、return target 与 policy 数据分布一致;
- 分开记录 policy GAE 与 critic target 的 \(\lambda\);
- Skip-Observation 只跳过 observation 位置,下一 action state 仍包含 observation;
- Cross-trajectory correction 的 \(N_{>s}\) 只数优化 token;
- terminal、truncated、infra error 与 verifier failure 不能共享同一个 bootstrap 语义。
归一化与更新
- 明确 loss 是 token mean、segment mean 还是 rollout-balanced mean;
- 同时报告 denominator、segment count 与 response length,避免“loss 下降”只是分母变化;
- 按 policy lag 和 ratio bucket 报告 DIS keep rate,不能只看总 clip fraction;
- 监控 critic explained variance、gradient norm、policy entropy 和 summary length;
- 固定 rollout 数、生成 token、训练 token、峰值 context 与评估 scaffold,再比较方法。
开源边界
slime 公开了异步 rollout 与 PPO 的基础设施入口,GLM-5 技术报告披露了相关的大规模 agentic RL 系统;截至两篇论文 v1,未见论文配方对应的完整 method-level code release。可验证复现应把“框架可用”“目标函数可实现”“论文超参数已披露”和“端到端结果可复现”分成四个不同结论。
最值得记住的五句话
- SAO 去掉的是 prompt group barrier,不是异步 off-policy 本身。
- DIS 是越界 token 置零的 hard gate,不是 PPO 式边界饱和。
- Skip-Observation GAE 跳过 observation token,不跳过 observation 信息。
- CompactionRL 学习 summary 内容;压缩时机仍由固定阈值触发。
- Token-level mean 消除 segment-average 偏置,但不自动给予每条 rollout 相同权重。
继续阅读:Agentic RL 数学与算法、训练系统、长时任务与轨迹契约。
Reference
- Hou et al., Single-Rollout Asynchronous Optimization for Agentic Reinforcement Learning, v1, 2026-07-08。
- Li et al., CompactionRL: Reinforcement Learning with Context Compaction for Long-Horizon Agents, v1, 2026-07-06。
- Yue et al., VAPO: Efficient and Reliable Reinforcement Learning for Advanced Reasoning Tasks。
- Schulman et al., Proximal Policy Optimization Algorithms。
- Shao et al., DeepSeekMath。
- THUDM/slime。
- GLM-5 技术报告。