推理基准与可靠性
推理系统的性能结论只有在工作负载、质量、硬件和失败条件都明确时才可复现。离线吞吐测试回答“设备能做多少工作”,在线可靠性回答“随机到达、取消、版本变化和组件失败时,有多少请求仍按契约完成”。两者需要同一套请求身份、阶段计时和资源账本。
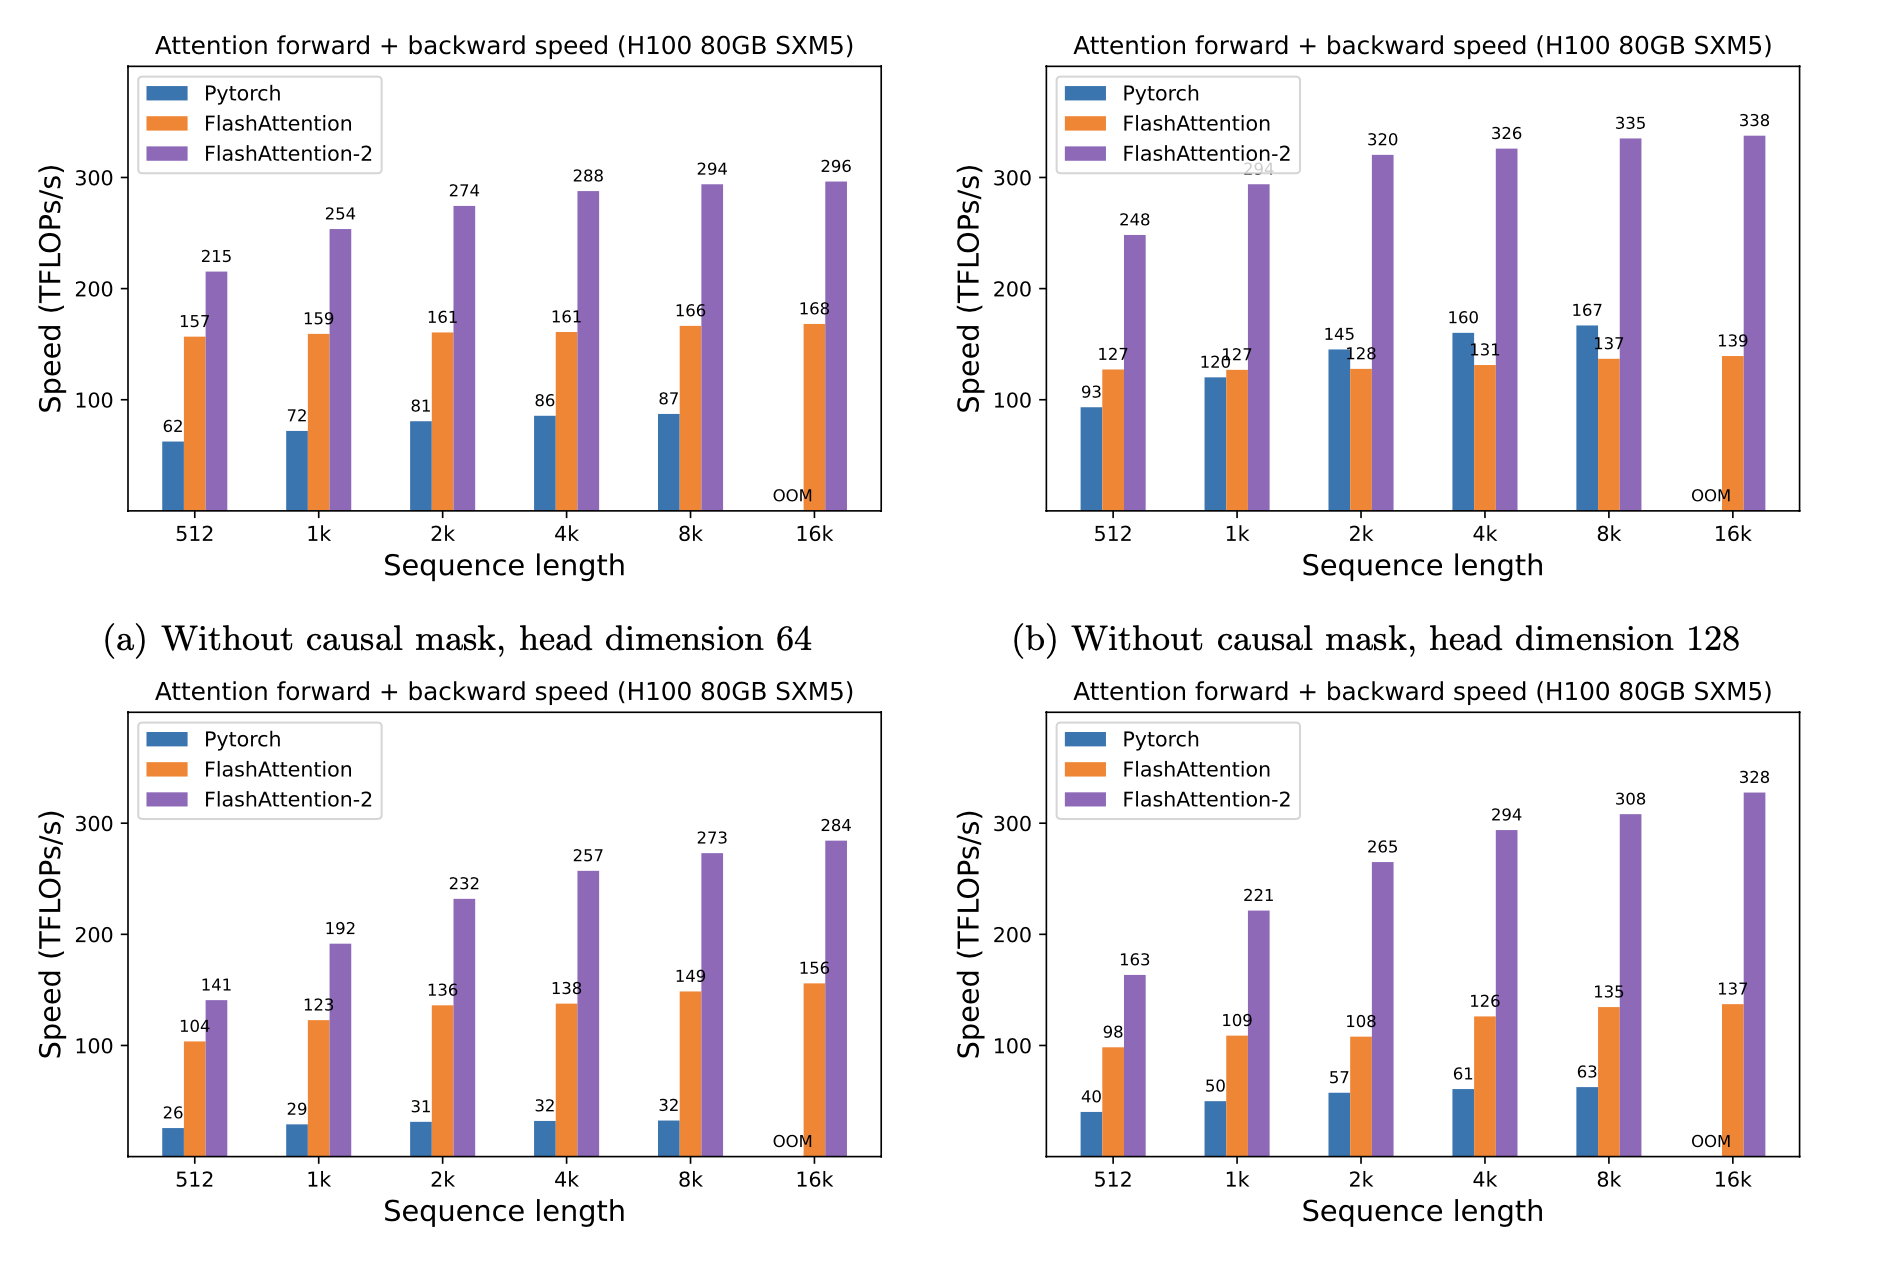
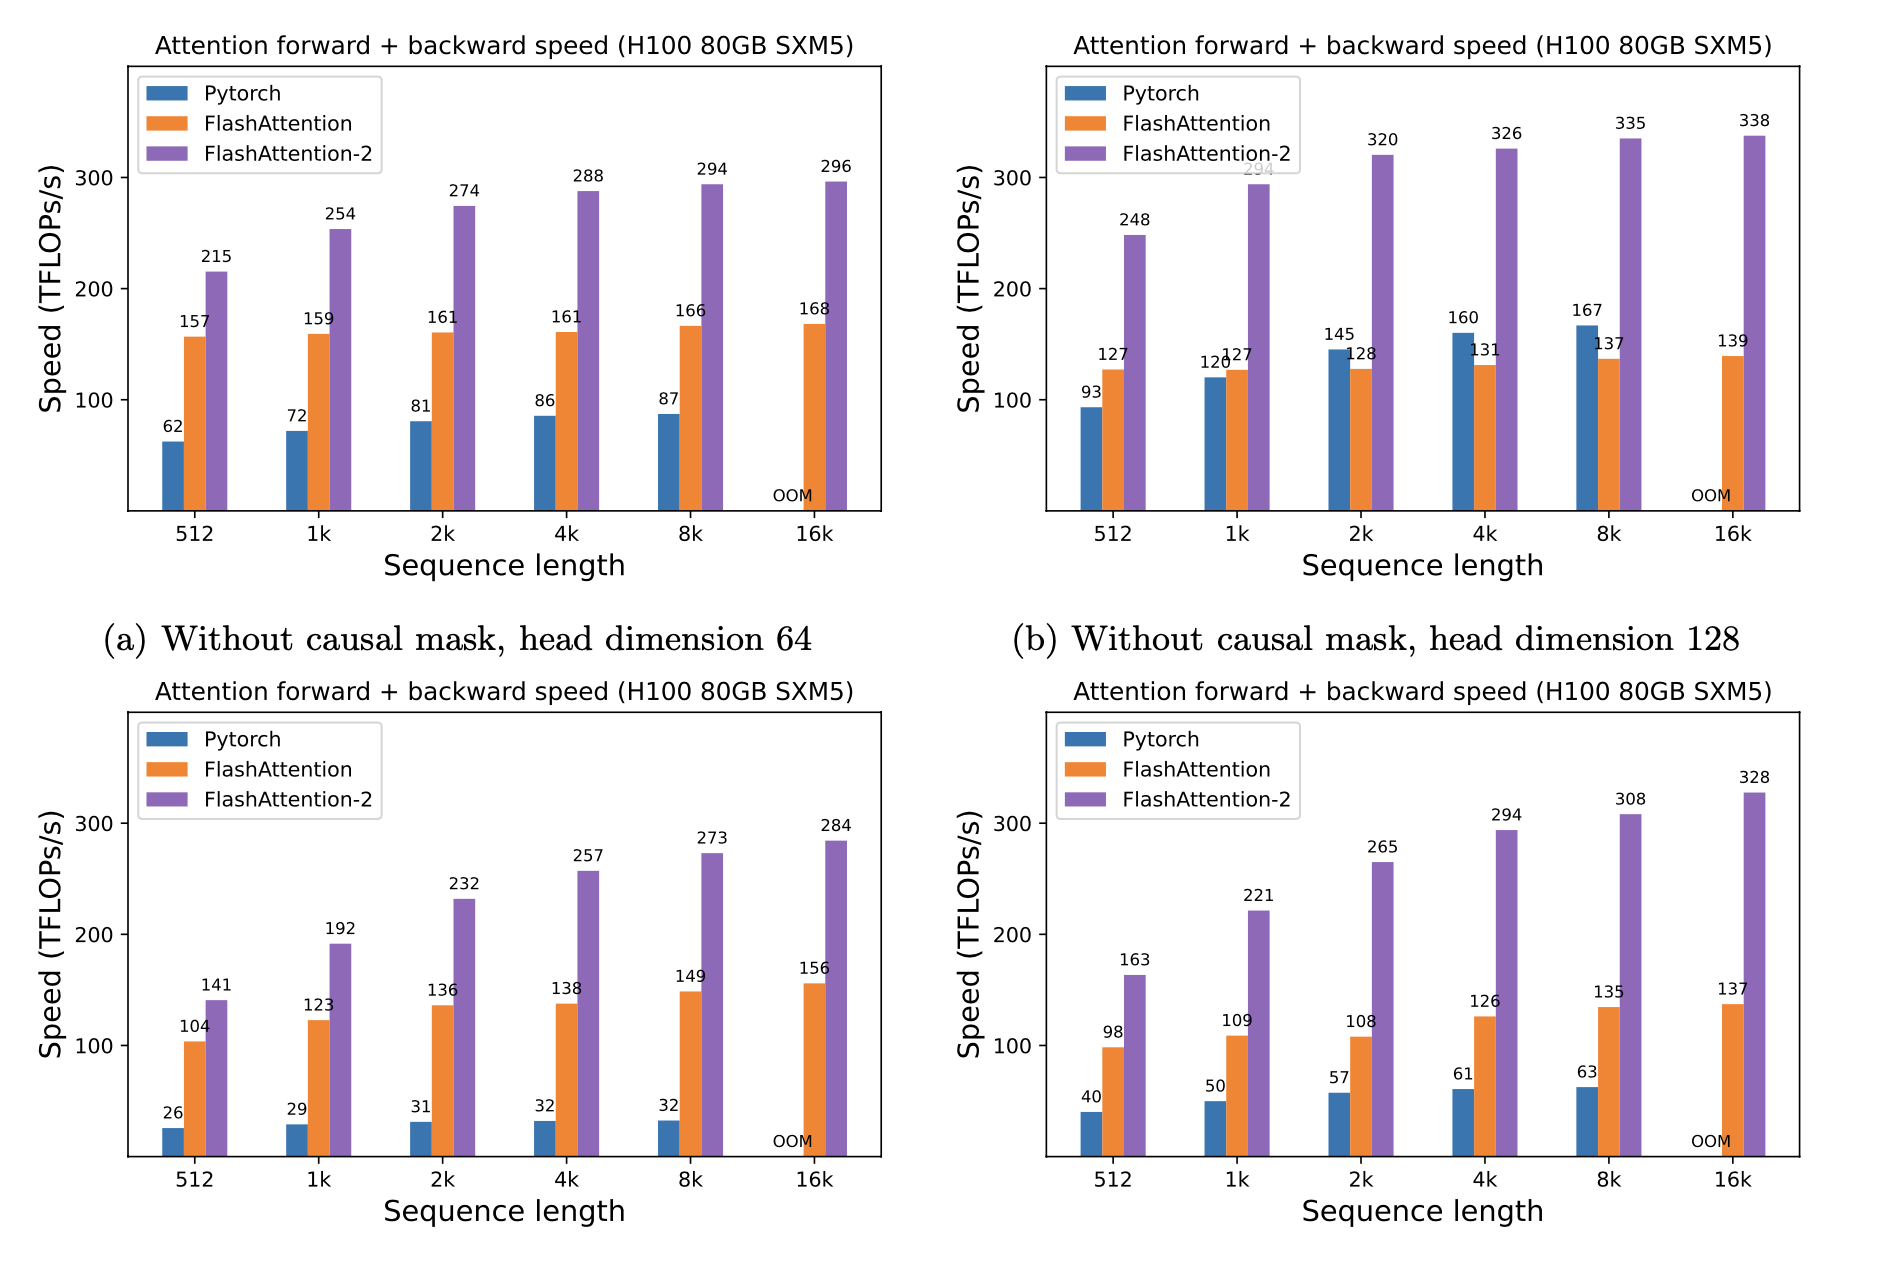
明确测量对象
至少区分三层:
| 层级 | 测量对象 | 适合回答 |
|---|---|---|
| Kernel | 固定 tensor shape 的单算子 | 实现是否接近硬件上限 |
| Engine | tokenizer 之后到 token 产出 | batching、KV、sampling 与调度 |
| Service | 客户端请求到完整响应 | 排队、路由、网络、过载与失败 |
kernel 加速不能直接替代 service 结论;service 延迟也不适合诊断某个 GEMM。每项指标应声明起止事件和时钟位置。
工作负载契约
请求分布至少由以下变量联合定义:
其中 \(P\)、\(O\) 是 prompt / output 长度,\(\lambda(t)\) 是到达过程,\(C\) 是并发,\(S\) 是采样配置,\(H\) 是 prefix 热度,\(A\) 是 adapter / model 混合,\(G\) 是 grammar / multimodal 等执行特征,\(V\) 是版本。
固定输入长度和固定并发适合微基准,却不能代表生产。在线测试应覆盖:
- prompt 与 output 的联合分布;
- 平稳、突发、昼夜变化与热点漂移;
- prefix cache 冷启动、预热和稳定热态;
- greedy、sampling、grammar、beam、speculative;
- 正常完成、客户端取消、超时和慢消费;
- 多模型、adapter、租户和版本切换。
trace replay 更贴近历史流量,但也会固化旧行为;合成边界用于覆盖尚未出现的极端。两者应同时使用。
延迟与吞吐口径
首 token 延迟:
对输出 token 时间戳 \(t_1,\ldots,t_O\),相邻延迟为
平均 TPOT 常写为
但它会隐藏单次 stall;应同时报告 request-level 和 token-level p95 / p99 ITL。
吞吐至少区分:
goodput 则只计满足全部 SLO 的请求:
同一图中混用 output tokens/s 与 total tokens/s 会产生虚假比较。详细容量语义见调度与 Goodput。
寻找服务包络
不要只测一个“最佳并发”。对 offered load 逐级增加,记录:
服务包络是满足 SLO 的最大稳定区域,而不是 OOM 前的最高吞吐。测试应继续穿过饱和点,观察:
- 队列何时非线性增长;
- 拒绝是否及时;
- p99 是否在降载后恢复;
- KV 水位和 allocator 碎片是否回落;
- cache 热点和租户公平是否恶化。
稳态窗口开始前,要单独报告模型加载、JIT / CUDA Graph 编译和 prefix 预热;自动扩容场景则必须把这些冷启动成本计入。
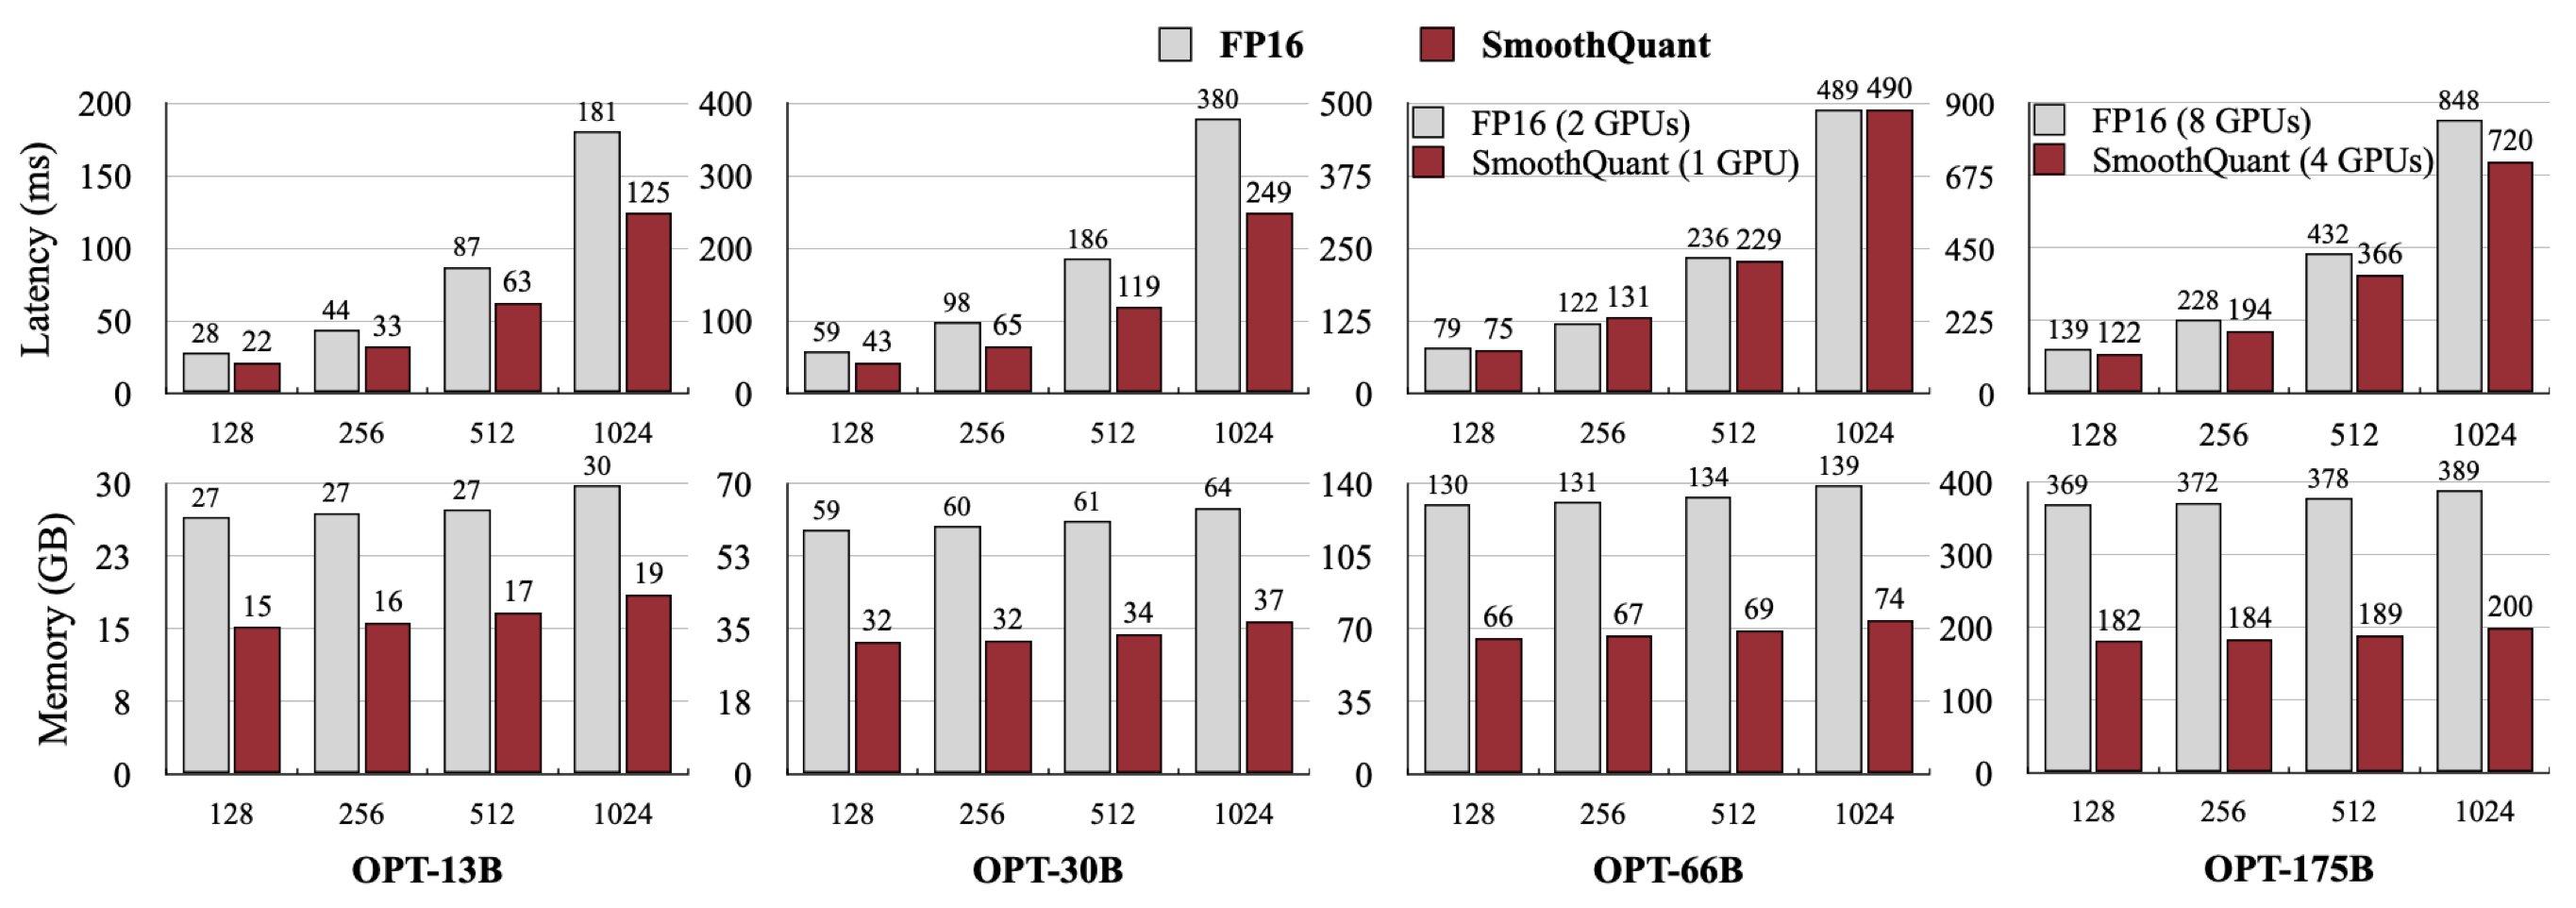
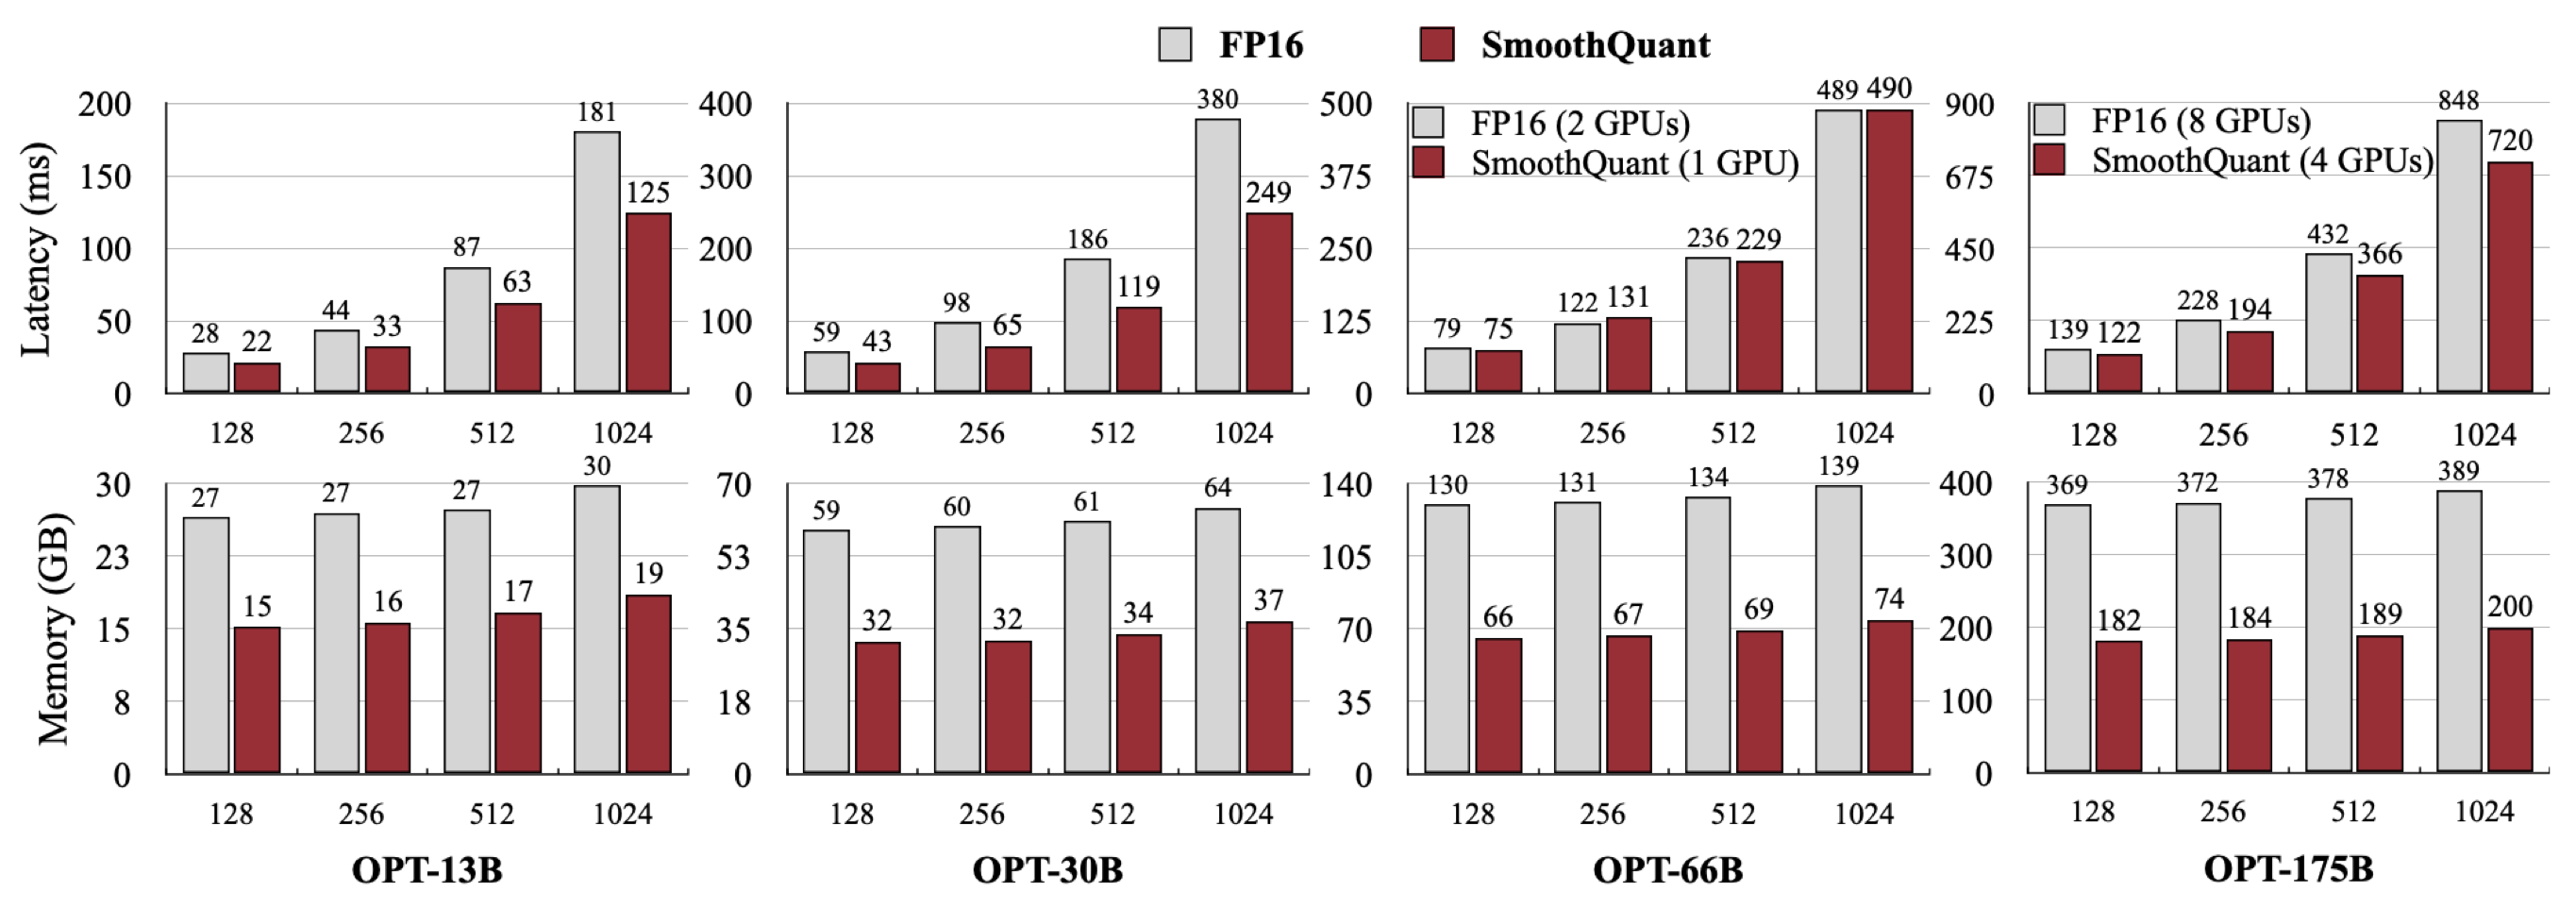
资源和阶段分解
至少采集:
gateway / tokenizer / queue time
prefill and decode execution time
scheduled sequences and scheduled tokens
KV used, reserved, fragmented and evicted
prefix lookup, hit length, load and install time
preemption, recompute and swap
P/D transfer bytes, bandwidth and failures
graph hit, compile and fallback
GPU utilization, memory bandwidth, power and health
streaming backpressure and cancellation latency
vLLM 的指标定义可作为一个引擎级观测实例;OpenTelemetry GenAI semantic conventions 提供跨组件命名的演进中规范。截至 2026-07,这些软件接口仍可能变化,生产仪表盘应固定版本并保留内部稳定 schema。
默认 telemetry 不应记录 prompt、输出、token IDs、cache key 或可还原内容的高基数标签。诊断内容采样需经过独立的数据治理。
正确性优先于速度
性能测试前先锁定输出契约:
model and weight identity
tokenizer and prompt template
sampling parameters and processor order
RNG algorithm and per-request state
quantization and KV schema
parallel layout and kernel versions
stop, detokenization and streaming semantics
精确优化与 reference 比较 logits / token;分布精确采样比较统计分布和状态;近似优化比较任务质量、长上下文、结构化输出和安全回归。若质量门槛不同,速度数字不能直接放在同一排名中。
故障模型
可靠性测试至少覆盖:
| 故障 | 预期行为 |
|---|---|
| 客户端取消 / 断连 | 有界时间内停止调度并释放 KV |
| GPU OOM | 请求明确失败或按策略抢占,不损坏其他请求 |
| Worker crash | 未提交 token 不重复发送;请求有明确重试边界 |
| NCCL / 网络超时 | 集体失败可观测,不无限挂起 |
| KV transfer 部分完成 | decode 不可见,重试安装幂等 |
| Router / gateway 重试 | immutable request ID 防止重复执行或重复计费 |
| 模型滚动升级 | 新旧请求按版本隔离,旧池排空 |
| Cache schema 变化 | 旧条目 miss / 拒绝,不按相似 shape 误读 |
| 存储或目录失联 | 远程 cache 降级为重算,核心生成仍有界 |
GPU 硬件与驱动状态可由 NVIDIA DCGM 及其诊断接口提供部分信号;健康检查仍需结合当前请求错误、collective、温度、ECC 和进程状态。单一 utilization 数值不能判定健康。
生命周期与版本
readiness 和 liveness 回答不同问题:
- liveness:进程是否需要重启;
- readiness:当前是否能接受某模型版本的新请求;
- draining:不再接新请求,但允许旧请求完成;
- healthy capacity:在 SLO 内还能接受多少工作。
滚动升级应使用:
load and validate new replica
canary with bounded traffic
compare correctness and SLO
expand new version
drain old version
invalidate incompatible cache
remove old replica
版本必须贯穿 gateway、tokenizer、model、adapter、KV schema 和 metrics。只升级权重标签而复用旧 cache 是高风险错误。
状态提交边界
流式服务不能假设 exactly-once 网络。需要明确哪些事件已提交:
- 请求通过 admission;
- KV / sampler state 更新;
- token 生成;
- token 写入 stream buffer;
- 客户端确认或连接断开;
- usage / billing 记录。
内部可以使用幂等 request ID、token sequence number 和 install ID;但在任意断点下,系统仍要定义重试会续传、重算还是返回失败。不能同时默许重复 token 和重复计费。
可靠性预算
可用率只是起点。对观察窗口 \(\Delta t\):
更实用的是按错误预算连接 SLO:
还要分别观察失败前恢复时间和数据面回收:
进程恢复不等于容量恢复;模型重新加载、graph 编译和 cache 冷启动可能持续影响 goodput。
常见测量陷阱
- 只报告最小 latency,而非分位数和置信区间;
- 客户端与服务端时钟口径不一致;
- 忽略 tokenizer、网络和 detokenization;
- 预热 cache 测优化方案,却用冷 cache 测基线;
- 输出长度提前固定,改变真实停止行为;
- 把失败或超时请求从分母删除;
- compile、模型加载和恢复窗口被静默排除;
- profiler 本身改变调度或 GPU 时序;
- 只测健康稳态,不穿过过载点;
- 平均 GPU utilization 高,却大量时间在低价值或已超时请求上。
何时不追求复杂基准
探索单个 kernel 时,固定 shape 微基准足够,但不得外推在线容量;离线批处理没有 TTFT SLO 时,可主要看完成时间和成本;低风险内部工具可以采用更小故障矩阵。简化的是测试范围,不是指标定义和基线公平性。
最小发布门
- reference correctness 与质量门槛通过;
- 同硬件、同请求流、同 cache 状态的基线比较;
- cold、warm、steady 和 saturation 四个区域;
- TTFT、ITL / TPOT、E2E、goodput、显存与成本;
- cancel、OOM、worker crash、网络抖动与滚动升级;
- 降载后队列、KV 和错误率能够恢复;
- dashboard、告警和 runbook 使用同一状态与版本语义;
- 结果附带硬件、软件、并行、dtype、配置和测量日期。
只有通过这些门,局部加速才可被解释为可运营的服务改进。