对齐、桥接与融合
多模态系统需要回答两个容易混在一起的问题:
- 不同信号怎样获得可以比较的语义表示;
- 一种模态的信息怎样在另一个模型内部被读取、推理和生成。
前者是 alignment,后者是 fusion。图像和文字在 embedding 空间中相近,并不意味着语言模型能读取图中小字;把视觉 token 拼进语言序列,也不保证模型学会使用它们。架构判断必须沿着
逐层追问:表示保留了什么,接口压缩了什么,哪些参数收到梯度,最终目标又奖励什么。
从共同坐标系到可生成接口
早期跨模态学习常把视觉类别映射到固定标签。自然语言监督把类别表换成了开放描述,但真正形成可复用接口的转折,是大规模双塔对比学习。CLIP 和同期的 ALIGN 分别编码图像与文本,用配对关系学习共同 embedding;推理时,新的文本描述可以直接充当分类器或检索查询。
这类模型善于回答“图与文是否相配”,却不天然生成长文本,也没有要求每个词对应到具体区域。随后出现的桥接模型开始复用已经训练好的视觉 encoder 与语言模型:
- Flamingo 用 Perceiver Resampler 压缩视觉特征,并在冻结语言模型之间插入 gated cross-attention;
- BLIP-2 让 Q-Former 先学会从冻结视觉 encoder 中抽取与语言有关的信息,再接入冻结 LLM;
- LLaVA 用轻量 projector 与视觉指令数据展示了更直接的输入 embedding 路线。
三者不是“桥越复杂越好”的排行榜。Flamingo 面向交错图文与 in-context learning,BLIP-2 面向冻结两端时的表示鸿沟,LLaVA 面向可访问的视觉指令跟随。冻结策略、数据目标和媒体注入位置不同,不能只比较 trainable parameter 数。
再往后,early-fusion 与统一模型让媒体 token 更早进入共享主干。Chameleon 把离散图像和文本 token 放进统一自回归序列。共享序列减少了专用接口,却把模态竞争、位置、mask、token budget 与生成误差带进同一系统。
全局对齐究竟优化什么
设一个 batch 中归一化图像表示为 \(u_i\in\mathbb R^d\),文本表示为 \(v_j\in\mathbb R^d\),温度为 \(\tau\):
CLIP 的对称目标为
它同时要求每张图找到对应文本、每段文本找到对应图像。batch 中其他样本构成 negatives,因此 global batch size、跨设备 all-gather 和重复 caption 会改变目标,而不只是改变吞吐。
这个目标隐含“一行一列只有一个正例”。现实数据可能有:
- 同一图片的多个等价描述;
- 同类图片共享近义 caption;
- 网页中相邻但并非严格配对的图文;
- 一个长文本对应多个区域或多张图。
把这些 pair 全当负例会形成 false negatives。可采用多正例标签、去重、软目标或更细粒度监督,但必须同步修改分母和评测协议,不能只改 dataloader。
SigLIP 把 batch softmax 换成对每个图文 pair 独立计算的 sigmoid loss:
它取消了 softmax 的全局归一化,却没有自动解决错误 pair、多正例和数据偏差。目标形式改变后,logit scale、bias、负例数量和 loss reduction 仍需共同报告。
共同 embedding 也不必只覆盖图像和文本。ImageBind 把图像、文本、音频、深度、热成像与惯性信号映射到共享空间,展示了以图像配对为枢纽连接多种模态的路线。共享空间支持跨模态检索,却仍不等于任意两种模态都获得了同等粒度的直接监督。
对齐粒度决定能力上限
一个 pooled embedding 只能直接监督全局匹配。若任务需要 OCR、定位、计数或关系,训练信号还要落到更细粒度:
| 粒度 | 典型目标 | 能直接约束什么 | 常见盲区 |
|---|---|---|---|
| 全局 | image–text contrastive | 主题与整体语义 | 小目标、文字、关系 |
| Token–region | word/phrase 与 patch/region 对齐 | 指代、区域语义 | 长程组合推理 |
| Matching | paired/unpaired 二分类 | 跨模态兼容性 | 开放式生成 |
| Captioning | 条件 next-token prediction | 可生成描述与知识 | 坐标和事实依赖 |
| Grounding | bbox、point、mask、时间区间 | 可定位证据 | 语言表达与长答案 |
| Joint generation | 文本/媒体 token 或 latent loss | 理解与生成接口 | 目标竞争与序列成本 |
同一系统可以组合多个目标:
\(\lambda\) 不是完整的有效权重。每个目标的样本概率、有效 token 数、loss reduction 和梯度尺度都会改变它对共享参数的实际贡献。
三类桥接瓶颈
设感知 encoder 输出
语言主干宽度为 \(d\)。
Projector:改变维度,不改变长度
线性或 MLP projector:
它结构简单,保留每个输入 token,却把全部 \(N_m\) 传给主干。高分辨率、多图和长视频的 attention、KV cache 与 prefill 成本不会因 projector 参数少而消失。
Resampler:用固定查询换固定预算
给定 \(N_q\) 个 learned queries:
Perceiver IO、Flamingo 和 BLIP-2 展示了不同的 querying 设计。固定 \(N_q\) 让语言主干成本与原始媒体长度解耦,但也形成容量上限:整体语义可能保留,小字、多个小目标和稀有事件更容易被压掉。
Cross-attention:让主干按需读取媒体
语言状态 \(H_t\) 可以在若干层读取媒体 memory:
它避免把所有媒体 token 都放进语言 self-attention,却需要额外管理媒体 K/V、注入层、门控、多个媒体片段和服务缓存。
随后给出的最小 reference 保留 Flamingo 类桥接中最不可约的两个语义:padding 媒体不能影响输出,零初始化门控使新分支在训练开始时严格退化为原文本路径。
import torch
from torch import nn

class GatedMediaCrossAttention(nn.Module):
    def __init__(self, width, heads):
        super().__init__()
        self.text_norm = nn.LayerNorm(width)
        self.media_norm = nn.LayerNorm(width)
        self.attention = nn.MultiheadAttention(width, heads, batch_first=True)
        self.gate = nn.Parameter(torch.zeros(()))
    def forward(self, text, media, media_padding=None):
        if media_padding is not None:
            if media_padding.shape != media.shape[:2]:
                raise ValueError("media_padding must be [batch, media_token]")
            if media_padding.all(-1).any():
                raise ValueError("each sample needs a visible media token")
        value = self.media_norm(media)
        update, _ = self.attention(
            self.text_norm(text), value, value,
            key_padding_mask=media_padding, need_weights=False,
        )
        return text + self.gate.tanh() * update

torch.manual_seed(0)
layer = GatedMediaCrossAttention(width=8, heads=2)
text = torch.randn(2, 3, 8)
media = torch.randn(2, 5, 8)
padding = torch.tensor([[False] * 4 + [True]] * 2)
torch.testing.assert_close(layer(text, media, padding), text)
layer.gate.data.fill_(1)
expected = layer(text, media, padding)
changed = media.clone()
changed[:, -1] = 10_000
torch.testing.assert_close(layer(text, changed, padding), expected)
这是单层语义真值,不包含 media position、交错图文 mask、缓存和高效 kernel。tanh 门控也不是普适最优设计;它只是让“新桥接分支初始不破坏旧主干”成为可验证不变量。
Early fusion 改变的是责任边界
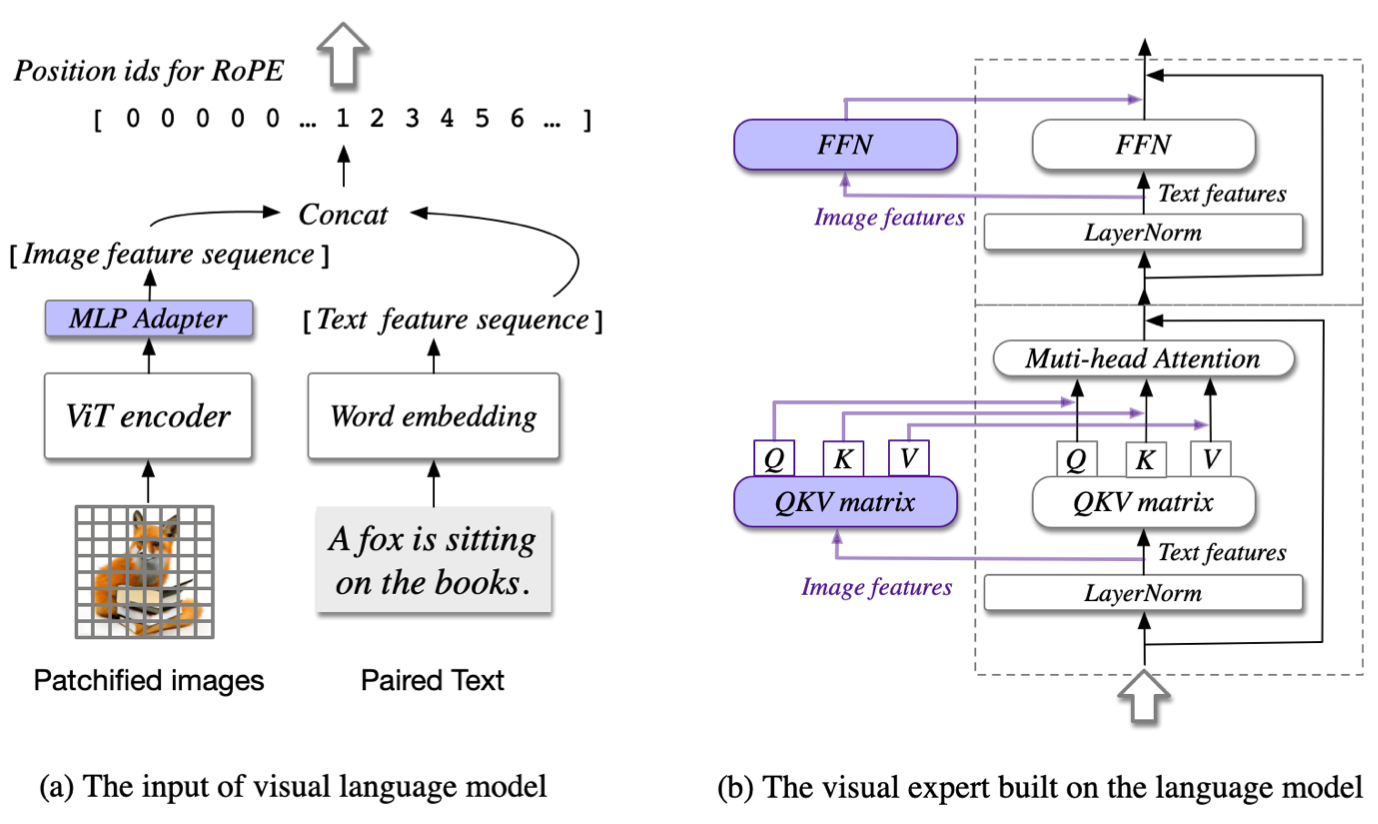
若媒体 token 经过投影后直接与文本拼接:
所有 token 都可以在共享层中交互。接口更统一,但系统必须明确:
- 每个 token 的 modality、segment 与原始坐标;
- 文本、图像、音频和视频分别使用何种位置;
- perception context 是否双向可见;
- generation target 是否因果或被加噪;
- 哪些位置参与哪一种 loss;
- 不同模态是否共享 embedding、norm 和输出 head;
- 高 token 模态是否挤压文本与其他媒体的容量。
“同一个 Transformer”并不等于同一个概率目标。文本 next-token、图像 diffusion latent 和动作 flow 可以共享部分主干,却仍需要不同的时间语义和 loss mask。对应细节应与空间、时间、位置与 Mask 一起核对。
冻结、解冻与联合训练
常见训练阶段可以写成:
- 单模态 encoder 或 tokenizer 预训练;
- 冻结两端,只训练 projector/resampler;
- 解冻桥接层与部分主干;
- 端到端多模态预训练;
- 指令、grounding、偏好与安全训练。
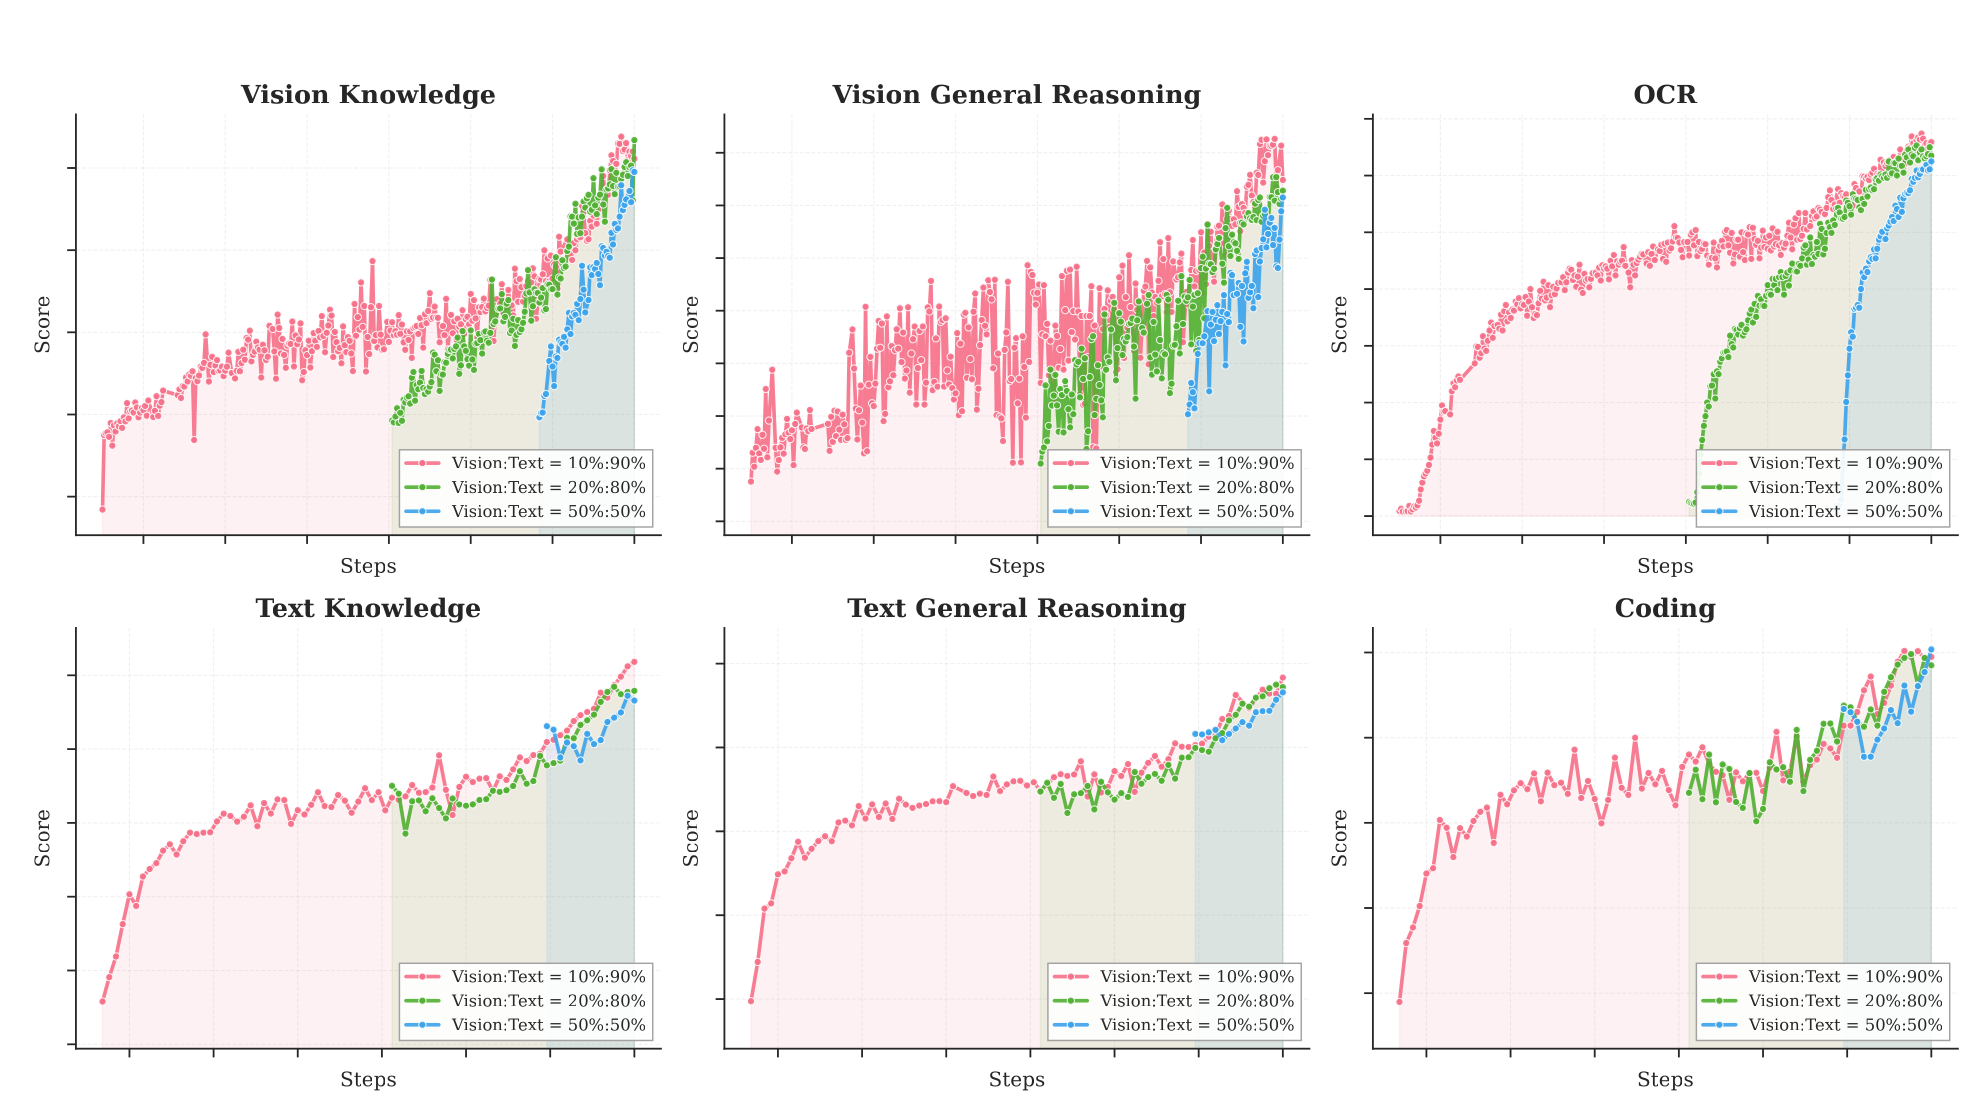
这不是必须遵守的固定配方。选择取决于数据、预算和初始模型:
| 方案 | 启动成本 | 主要收益 | 主要风险 |
|---|---|---|---|
| 冻结 encoder 与 LLM | 低 | 保留原能力、易诊断 | 桥接容量不足 |
| 解冻 LLM | 中 | 语言层适应媒体 | 文本遗忘 |
| 解冻视觉/音频 encoder | 高 | 表示可为生成目标重塑 | 稳定性与显存 |
| 从头联合训练 | 最高 | 表示与主干共同形成 | 数据和优化要求高 |
冻结不仅是 requires_grad=False。BatchNorm、dropout、EMA、quantizer codebook 和 tokenizer 仍可能更新状态;checkpoint 也必须保存 encoder、bridge、processor 与 special token 的一致版本。
实现契约
一个可复现的融合接口至少应固定:
- 每个 encoder 输出的 shape、dtype、normalization 与有效长度;
- projector/resampler 的输入输出 token 数与宽度;
- media placeholder、实际 token 和 segment 的一一对应;
- padding mask 中
True/False的具体语义; - modality、position、attention mask 与 loss mask 分开构造;
- 多图、多段音频、视频 clip 与文本轮次的边界;
- 冻结参数、运行状态和各阶段 trainable parameter;
- 对比目标的 global batch、gather、正例矩阵和 reduction;
- 训练与服务使用相同 processor、tokenizer 和媒体边界 token;
- 空模态、损坏媒体、超出 token budget 时的显式行为。
常见失效
- 表示对齐、细节丢失:检索很好,OCR、计数和空间关系很差。
- 桥接忽略:移除媒体后答案几乎不变,语言先验承担了任务。
- 固定查询过压缩:输入更密集时性能突然下降,而不是平滑退化。
- 占位错位:媒体 token 数变化后,文本位置或 label 整体偏移。
- 错误负例:重复 caption 与同义图片在对比目标中互相排斥。
- 冻结泄漏:名义冻结的模块仍因运行状态或 codebook 更新而漂移。
- 文本遗忘:联合训练提高媒体能力,却破坏纯文本分布。
- 模态吞噬:高 token 数或高 loss 模态支配共享参数。
- 缓存误复用:不同媒体或 processor 版本复用了错误的 encoder/KV 结果。
- 权限混淆:媒体中的文字被解释为高权限控制指令。
怎样评测融合而不是只评最终答案
| 问题 | 最小对照 |
|---|---|
| 模型是否使用媒体 | 移除、替换、shuffle、局部遮挡和反事实媒体 |
| 表示保留了什么 | 全局检索、区域定位、OCR、小目标与关系切片 |
| bridge 是否成为瓶颈 | 扫描 query/token 数、分辨率与媒体数量 |
| 训练是否产生正迁移 | 单模态、冻结桥接、部分解冻、联合训练 paired ablation |
| 模态是否竞争 | 每模态 loss、梯度范数、梯度夹角与遗忘曲线 |
| 系统成本在哪里 | encoder、bridge、prefill、decode、缓存和峰值显存分段 |
| 结论是否依赖协议 | 固定 processor、prompt、token budget、tool 与采样 |
最终指标还应同时报告 language-only baseline 和等计算预算基线。一个更大的 early-fusion 模型优于轻量 bridge,并不能单独证明 fusion 方式更好;收益可能来自数据、主干容量或视觉 token 数。
媒体怎样形成 token 见表示、采样与 Tokenization,位置与可见性见空间、时间、位置与 Mask,数据 mixture 与系统代价见多模态数据、训练与系统。
对比损失、resampler 与跨模态 attention 的组合测试见多模态手撕实现。
Reference
- Radford et al., Learning Transferable Visual Models From Natural Language Supervision
- Jia et al., Scaling Up Visual and Vision-Language Representation Learning With Noisy Text Supervision
- Zhai et al., Sigmoid Loss for Language Image Pre-Training
- Jaegle et al., Perceiver IO: A General Architecture for Structured Inputs and Outputs
- Alayrac et al., Flamingo: a Visual Language Model for Few-Shot Learning
- Li et al., BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models
- Liu et al., Visual Instruction Tuning
- Girdhar et al., ImageBind: One Embedding Space To Bind Them All
- Team Chameleon, Chameleon: Mixed-Modal Early-Fusion Foundation Models