状态空间与线性注意力
标准全注意力保留每个历史 token 的 K/V,并让新 query 直接寻址全部历史。状态空间模型(State Space Model, SSM)与线性注意力改用固定或受控大小的状态压缩历史,目标是在序列变长时保持近似线性的计算与常数级 decode state。
代价是明确的:历史被压入有限状态后,不再拥有无损、任意位置的精确内容寻址。理解这一信息瓶颈,比只记住复杂度更重要。
线性时间序列模型从 RNN、长卷积和结构化状态空间梳理到选择性递推;LSTM 给出门控有限状态的早期转折,S4、Mamba 与 Mamba-2 进一步给出连续系统离散化、scan 等价和最小 selective recurrence。
统一递推
最一般的离散递推可写为
若 \(h_t\in\mathbb R^n\),逐 token 推理只需保留当前状态。固定 \(A,B,C\) 对输入内容使用同一动力学;让它们依赖 \(x_t\) 可实现选择性写入、遗忘和读取。
从连续 SSM 到离散递推
连续线性系统为
以步长 \(\Delta\) 离散化后:
得到
S4 利用结构化状态矩阵和卷积/递推双重视角,使长序列训练与流式推理能够共享同一模型。实际实现通常不会显式计算一般矩阵指数,而会利用对角或特殊结构。
卷积与递推的等价
在参数不随输入变化时,展开递推:
令
即可写成因果卷积。训练可以并行计算卷积,推理使用 recurrent state;两条路径应在相同精度下数值对齐。
Selective SSM
Mamba 让离散化步长和输入、输出映射依赖当前 token:
输入相关离散参数下,状态更新为
输入相关参数使模型能按内容控制“保留还是遗忘”。同时,它破坏了固定卷积核,因此训练依赖硬件感知的 parallel scan 或 chunkwise 算法。Mamba 官方实现是核对算子语义、状态 shape 和增量接口的首选参考。
最小语义实现
selective_scan 接收逐位置、逐状态通道的 a,b,c,x:[T,N] 和可选初态,返回全部输出与终态。参数沿时间变化,因此它覆盖 selective recurrence 的关键语义;把同一序列任意切成两段,携带中间状态后应与整段扫描完全一致。
import torch

def selective_scan(a, b, c, x, state=None):
    assert a.shape == b.shape == c.shape == x.shape
    state = torch.zeros_like(x[0]) if state is None else state
    output = []
    for at, bt, ct, xt in zip(a, b, c, x):
        state = at * state + bt * xt
        output.append(ct * state)
    return torch.stack(output), state

torch.manual_seed(0)
a = torch.sigmoid(torch.randn(7, 4))
b, c, x = torch.randn(7, 4), torch.randn(7, 4), torch.randn(7, 4)
whole, final = selective_scan(a, b, c, x)
left, middle = selective_scan(a[:3], b[:3], c[:3], x[:3])
right, final_from_chunks = selective_scan(a[3:], b[3:], c[3:], x[3:], middle)
torch.testing.assert_close(torch.cat((left, right)), whole)
torch.testing.assert_close(final_from_chunks, final)
Python 循环是递推真值而非训练 kernel;并行 scan、chunk 内矩阵化、padding reset、门控参数化和低精度累积都应逐项与它对照。显式矩阵与 chunk 路径见递推与记忆模型:Selective scan 和 Chunked scan。
State Space Duality
Mamba-2 把一类结构化 SSM 与半可分矩阵联系起来。展开后,位置 \(i\) 对位置 \(j\) 的线性映射可写成
这使序列递推可以按 block 分解,并复用矩阵乘法硬件。它提供 attention 与 SSM 之间的代数桥梁,但不意味着两者具有相同的信息容量或 softmax 归一化。
线性注意力
若核函数满足
则
定义状态
归一化输出为
计算顺序从显式 \(T\times T\) score 矩阵改成固定状态累积。若 feature dimension 很大,状态 \(S_t\) 的二次通道成本仍可能显著。
Retention、衰减与 Delta Rule
RetNet 将带衰减的 retention 写成 parallel、recurrent 与 chunkwise 等价形式。一般状态可写为
简单累加会让新值与旧值叠加而不纠错。Delta rule 用预测误差更新 fast weight:
这里 \(S_{t-1}\in\mathbb R^{d_k\times d_v}\),所以 \(S_{t-1}^\top k_t\in\mathbb R^{d_v}\) 是旧状态对当前 key 的预测,\(k_t(v_t-S_{t-1}^\top k_t)^\top\) 是 \(d_k\times d_v\) 的残差写入。它改善有限状态的关联记忆,但仍受到状态秩、key 冲突和数值稳定性的约束。
Delta-rule 语义核
delta_fast_weight 接收 keys:[T,D_k]、values:[T,D_v] 和逐步写入率,返回每次 写入前 的读取结果与终态。状态只写预测残差;对正交 key、\(\beta=1\),两条关联可被精确写入而不互相覆盖。
import torch

def delta_fast_weight(keys, values, beta, state=None):
    assert keys.ndim == values.ndim == 2 and keys.size(0) == values.size(0)
    assert beta.shape == (keys.size(0),)
    state = values.new_zeros(keys.size(1), values.size(1)) if state is None else state
    reads = []
    for key, value, rate in zip(keys, values, beta):
        prediction = key @ state
        error = value - prediction
        state = state + rate * torch.outer(key, error)
        reads.append(prediction)
    return torch.stack(reads), state

keys = torch.eye(2)
values = torch.tensor([[2., -1.], [.5, 3.]])
reads, state = delta_fast_weight(keys, values, torch.ones(2))
torch.testing.assert_close(reads, torch.zeros_like(values))
torch.testing.assert_close(keys @ state, values)
assert state.shape == (2, 2)
真实模型会增加 batch/head 轴、key 归一化、门控与 chunkwise kernel;相似 key 下的干扰和低精度状态漂移仍需随长度测量。batched 版本与关联回忆压力测试见递推与记忆模型:Delta-rule fast weight。
其他稳定比较对象
- RWKV:以时间混合和通道混合实现 Transformer 风格并行训练、RNN 风格推理。
- Hyena:以长卷积和数据控制门替代标准 attention。
- Griffin:将 gated linear recurrence 与 local attention 混合。
- xLSTM:重新设计 LSTM 的门控、记忆和并行形式。
这些方案应按状态大小、精确寻址、并行训练、decode 成本和 kernel 成熟度比较,而不是排列成单向“继任者”时间线。
Shape 与实现契约
以多 head 状态为例:
实现需要固定:
- recurrent state 的 batch、head 与 feature 维;
- sequence reset 和 padding 位置是否更新状态;
- prefill 使用 scan、chunk 还是逐 token 路径;
- decode state 的 dtype;
- chunk 边界是否携带相同的终态;
- normalization 的 \(\varepsilon\) 与计算精度;
- bidirectional 训练是否可用于 causal decode;
- checkpoint 是否保存卷积状态与 recurrent state 的转换约定。
复杂度不能脱离状态大小
设状态维为 \(n\)。对角 SSM 的逐 token 更新可接近 \(O(n)\);一般矩阵状态可能达到 \(O(n^2)\)。线性注意力若 \(S\in\mathbb R^{d_k\times d_v}\),每 token 更新为 \(O(d_kd_v)\)。
因此报告“关于 \(T\) 线性”时,还必须报告:
- 状态维与 head 数;
- training scan 的额外存储;
- kernel 是否融合;
- 短序列、长 prefill 与单 token decode 的 wall-clock;
- 与 full attention 相同质量下需要的宽度和层数。
失效模式
- 有限状态瓶颈:多个相似 key 覆盖彼此,精确复制失败。
- Recall gap:语言建模 loss 接近,但 associative recall 明显落后。
- 路径不一致:parallel、chunkwise、recurrent 输出随长度漂移。
- 状态污染:padding、请求边界或 batch 重排后未 reset。
- 低精度累积:长序列递推在 FP16/BF16 中漂移或溢出。
- 局部速度错觉:渐近更优,但短上下文 kernel 启动与状态操作更慢。
- 双向泄漏:训练使用未来信息,部署却按 causal state 推理。
- 生态断层:量化、并行、checkpoint 与服务 runtime 缺少对应实现。
Zoology 用受控任务展示了不同序列 mixer 在回忆能力上的结构性差异,适合作为“语言建模平均分数之外”的诊断依据。
验证矩阵
| 验证 | 方法 |
|---|---|
| 代数等价 | 显式下三角矩阵、parallel scan、逐 token 递推对齐 |
| Chunk 边界 | 随机切分同一序列,终态与输出不变 |
| Reset | 拼 batch 与逐样本运行结果相同 |
| 精度 | FP32 参考对照 BF16/FP16,扫描长度逐级扩大 |
| Recall | copy、selective copy、MQAR、冲突 key |
| 长度 | 训练内、训练外、极长流式分别测试 |
| 系统 | prefill、decode、峰值内存、state bytes、吞吐 |
| 质量 | 相同数据、token、激活参数与计算预算比较 |
KDA:逐通道遗忘与误差写入
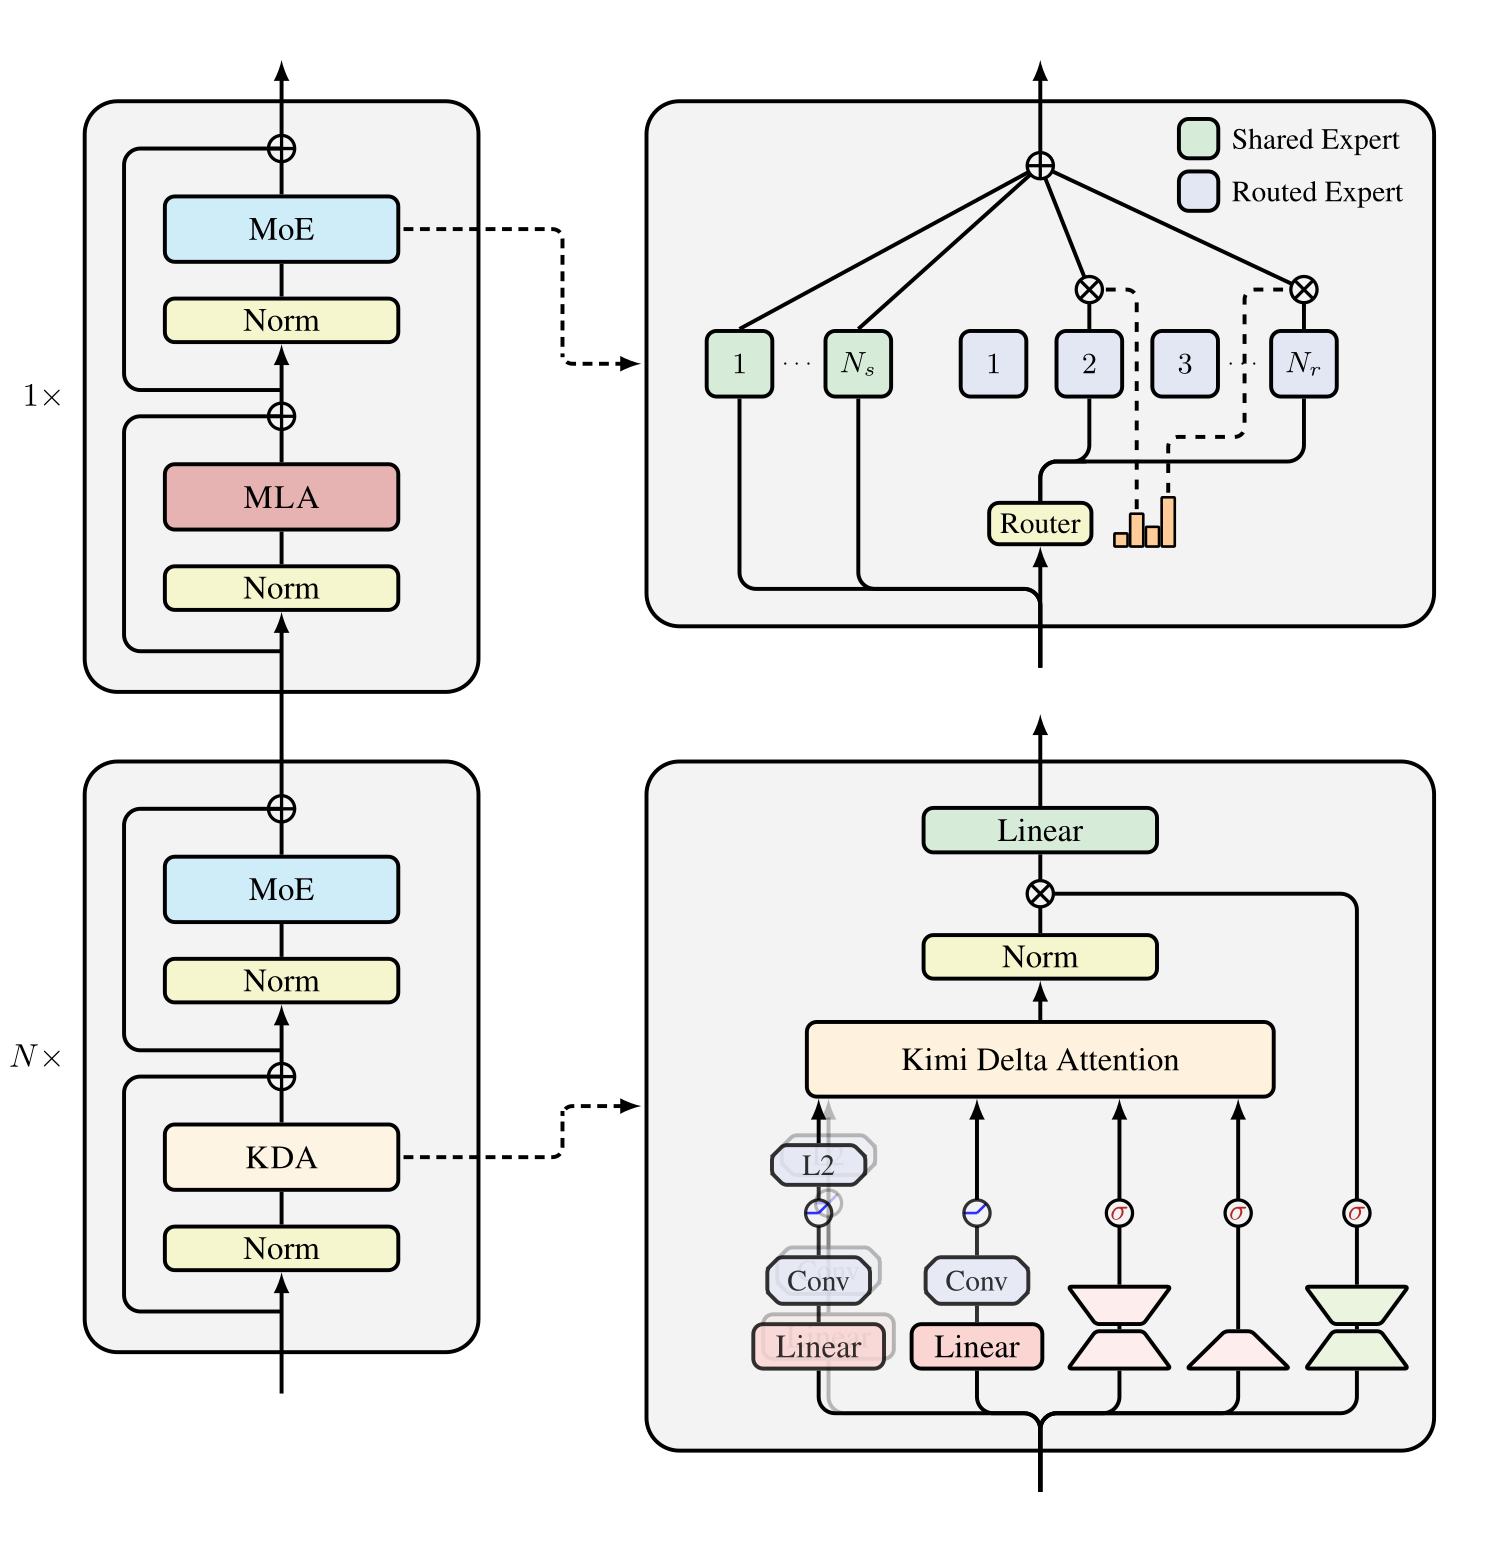
Kimi Linear 把 channel-wise decay 与 delta rule 合成 Kimi Delta Attention(KDA)。对单个 head,先让旧状态按 key channel 衰减,再用当前 key 对旧预测作误差写入:
其中 \(\alpha_t\in(0,1)^{d_k}\) 是逐通道 retention,\(\beta_t\in(0,1)\) 是写入强度。展开第二式可得
这条顺序不能交换:先衰减旧状态,再询问“当前 key 在衰减后的状态中已经预测出什么”。KDA 的 \(q,k\) 经过 ShortConv、Swish 和 L2 normalization,\(v\) 经过 ShortConv 与 Swish;卷积给局部模式, 有限状态负责远程传播。完整投影与 chunkwise UT transform 见 Kimi Linear 论文及其 官方实现;从 fast weights、delta rule 到 K3 有界 decay、FlashKDA 与 KCP 的完整算法—系统链,见 Kimi Linear、KDA 与 FlashKDA。
有界 log-decay 与 chunk kernel
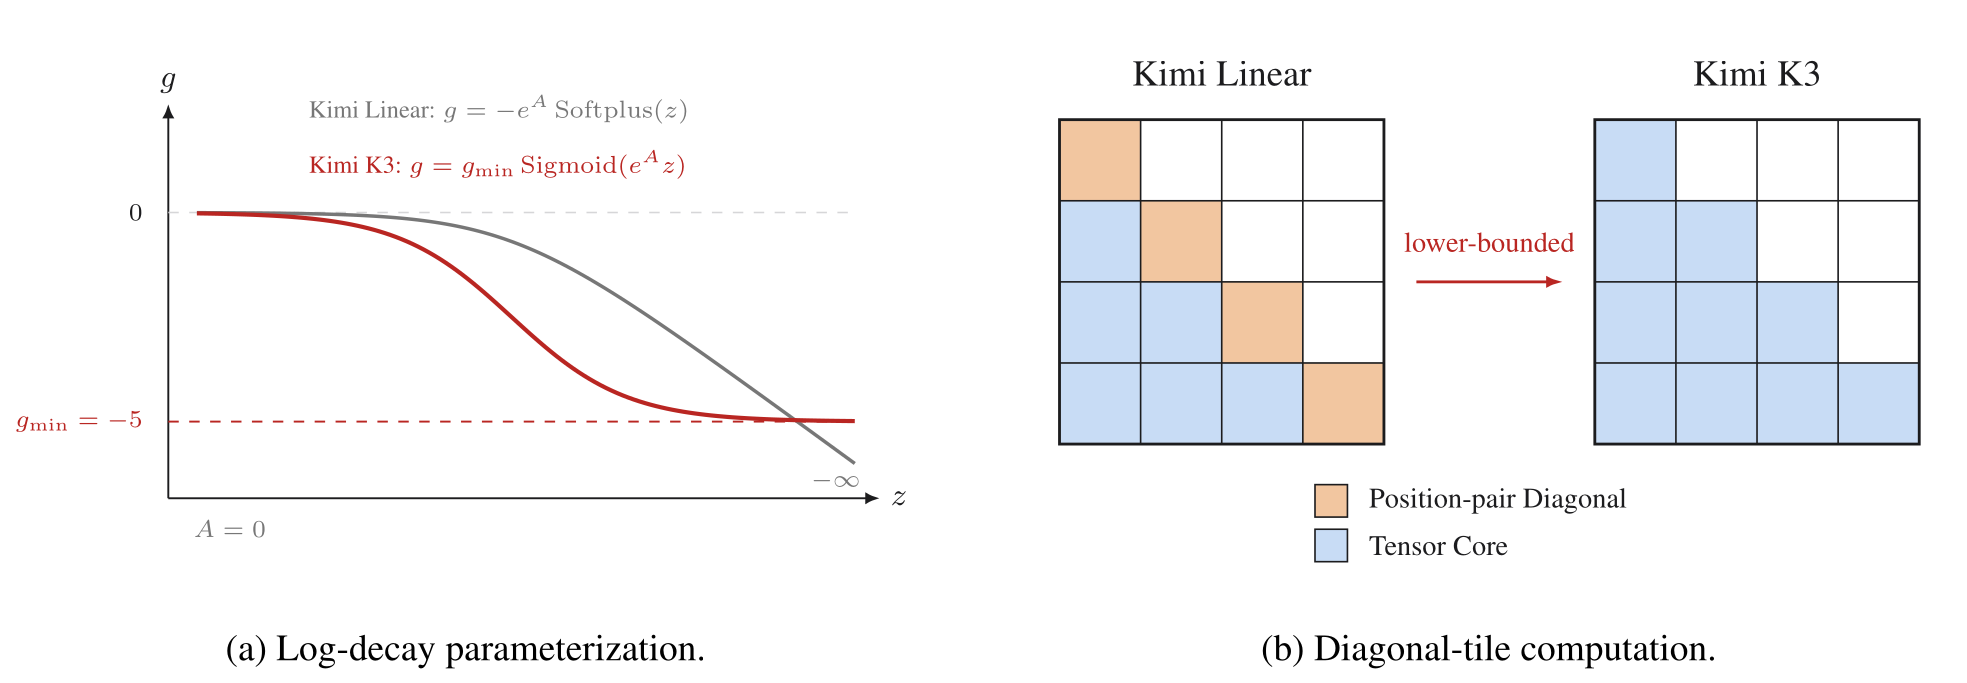
chunkwise KDA 在 chunk 间递推、chunk 内并行。其矩阵化会用累计 retention 的倒数缩放 key;若 \(\log\alpha_t\) 无下界,短 tile 内也可能出现极端倒数,迫使 diagonal tile 回到逐位置计算。 Kimi K3 技术报告把每个 head 的 log-decay 改为
并取 \(g_{\min}=-5\)。于是 16-token tile 的累计 log-decay 落在 \((-80,0)\),倒数严格小于 \(e^{80}\),仍在 BF16 动态范围内;作者据此让 causal diagonal 与 off-diagonal tile 都走 dense Tensor Core GEMM。这个界保证的是中间缩放不因该项溢出,并不自动保证长递推的误差、状态范数或端到端 kernel 都稳定。
K3 还把 recurrent output 做 head-wise RMSNorm 后施加 full-rank、逐通道门:
门控制“本 token 从有限状态读出的哪些通道写回 residual stream”,与控制写入强度的 \(\beta_t\) 不是同一个门。K3 的主干按 3 层 KDA + 1 层 Gated MLA 重复,并让最后一层仍为 全局注意力;完整组合见 Kimi K3。
KDA recurrent reference
下面直接实现上述逐 token 真值。两段执行携带中间状态,应与整段执行一致;有界映射的最小 retention 也由断言锁定。
import math
import torch

def bounded_decay(logit, log_scale, lower=-5.):
    return (lower * torch.sigmoid(log_scale.exp() * logit)).exp()

def kda_recurrence(keys, values, queries, beta, alpha, state=None):
    assert keys.shape == queries.shape and keys.size(0) == values.size(0)
    assert alpha.shape == keys.shape and beta.shape == (keys.size(0),)
    state = values.new_zeros(keys.size(1), values.size(1)) if state is None else state
    output = []
    for key, value, query, rate, decay in zip(keys, values, queries, beta, alpha):
        state = decay[:, None] * state
        state = state + rate * torch.outer(key, value - key @ state)
        output.append(state.T @ query)
    return torch.stack(output), state

torch.manual_seed(0)
keys = torch.nn.functional.normalize(torch.randn(9, 4), dim=-1)
values, queries = torch.randn(9, 3), torch.randn(9, 4)
beta, alpha = torch.sigmoid(torch.randn(9)), bounded_decay(torch.randn(9, 4), torch.zeros(4))
whole, final = kda_recurrence(keys, values, queries, beta, alpha)
left, middle = kda_recurrence(keys[:4], values[:4], queries[:4], beta[:4], alpha[:4])
right, chunked = kda_recurrence(keys[4:], values[4:], queries[4:], beta[4:], alpha[4:], middle)
torch.testing.assert_close(torch.cat((left, right)), whole)
torch.testing.assert_close(chunked, final)
assert alpha.min() > math.exp(-5) and alpha.max() < 1
这段代码没有 ShortConv、head/batch 轴、UT transform 或 fused gate,作用是固定 decay-before-delta、 current-token read 和 chunk state 语义。生产实现还要分别校验 recurrent、chunkwise、prefill 与 decode 路径,并测量状态 dtype、tile size 和累计误差。
公开证据足以确认算法、实现接口与 K3 中的具体组合;还不能据此推出任意数据、规模和 runtime 上线性 注意力都优于 full attention。应把关联回忆、长文推理和端到端吞吐继续作为独立验证轴。
最小 selective scan、delta rule 与路径等价实验见序列模型手撕实现,与精确注意力的缓存比较见 KV Cache。
Reference
- Efficiently Modeling Long Sequences with Structured State Spaces
- Mamba: Linear-Time Sequence Modeling with Selective State Spaces
- Mamba 官方实现
- Transformers are SSMs
- Retentive Network
- RWKV: Reinventing RNNs for the Transformer Era
- Hyena
- Griffin
- Kimi Linear: An Expressive, Efficient Attention Architecture
- MoonshotAI/Kimi-Linear
- Kimi K3 Technical Report