动力学、想象与规划
世界模型最早面对的是一个朴素问题:真实交互昂贵,已经见过的 transition 能否被压进模型,再从模型中生成额外经验或直接规划?从 Dyna 到 Dreamer、MuZero,变化的不是“要不要预测未来”,而是预测什么、怎样使用预测,以及怎样控制模型误差。
Dyna:让真实经验与想象共享更新
对 MDP transition \((s,a,r,s')\),tabular Q-learning 更新为
Dyna 的关键不是某种特定神经网络,而是让两类数据进入同一更新接口:
real transition
  ├─> update value / policy
  └─> update dynamics model
              └─> imagined transitions
                        └─> update value / policy
这奠定了 model-based learning 的三个独立部件:
- model learning:拟合 transition 与 reward;
- planning:查询模型并比较动作;
- policy/value learning:把真实或 imagined experience 变成行为。
把三者都叫“训练世界模型”会掩盖错误到底发生在哪一层。
从像素到 latent dynamics
高维图像中直接预测每个像素既昂贵又容易被纹理支配。World Models 把系统拆成:
VAE 学视觉压缩,RNN 学 latent dynamics,小控制器可以在模型生成的“梦境”中优化。它让表征、动力学和控制可以分别检查,也暴露了一个长期问题:控制器会寻找生成模型的漏洞,而不仅是利用它学到的真实规律。
RSSM:确定性记忆与随机状态
PlaNet 中的 Recurrent State-Space Model(RSSM)把历史压进确定性状态 \(h_t\),用随机变量 \(z_t\) 表示当前不确定状态:
训练时,posterior \(q_\phi\) 读取真实观察;想象时,只能从 prior \(p_\theta\) 推进。一个典型 ELBO 由观察、奖励重建与 KL 组成:
确定性路径保存已知历史,随机路径表达部分可观测和多种可能未来。若把二者都换成一个确定向量,模型容易把随机性平均掉;若随机变量过强,decoder 又可能忽略 recurrent memory。
PlaNet:在 latent 中在线搜索
PlaNet 对候选动作序列在 RSSM 中 rollout,再用 Cross-Entropy Method(CEM)迭代更新采样分布。设序列长度为 \(H\):
保留回报最高的 elite,重新估计 \(\mu,\sigma\),最后只执行第一步并重新观察。这样的 receding-horizon control 把长期开放环错误截成一连串短规划问题。
CEM 最小实现
下面只实现连续动作上的核心搜索。score 接收 [sample,horizon,action_dim] 并返回 [sample];真实系统还要把动作类型、坐标系、动态约束和模型不确定性写入代价。
import torch
@torch.no_grad()
def cem_plan(score, horizon, action_dim, low, high, samples=256, elite=16, rounds=5):
    if not 0 < elite <= samples or horizon <= 0:
        raise ValueError("invalid CEM configuration")
    low, high = torch.as_tensor(low), torch.as_tensor(high)
    mean = ((low + high) / 2).expand(horizon, action_dim).clone()
    std = ((high - low) / 2).expand_as(mean).clone()
    for _ in range(rounds):
        action = mean + std * torch.randn(samples, horizon, action_dim)
        action = action.clamp(low, high)
        value = score(action)
        if value.shape != (samples,):
            raise ValueError("score must return [sample]")
        best = action[value.topk(elite).indices]
        mean, std = best.mean(0), best.std(0, unbiased=False).clamp_min(1e-4)
    return mean
target = torch.tensor([.4, -.2])
torch.manual_seed(0)
plan = cem_plan(lambda a: -(a[:, 0] - target).square().sum(-1),
                horizon=3, action_dim=2, low=-1., high=1.)
assert torch.allclose(plan[0], target, atol=.15)
这个测试只验证优化器能找到一个已知二次目标,不能验证 learned dynamics。部署时还要分别画出:
- 样本数、elite 数、迭代数与成功率;
- planning horizon 与误差;
- 单步 wall-clock time;
- action bounds 命中率;
- 不同随机种子的方差。
Dreamer:把搜索移到训练期
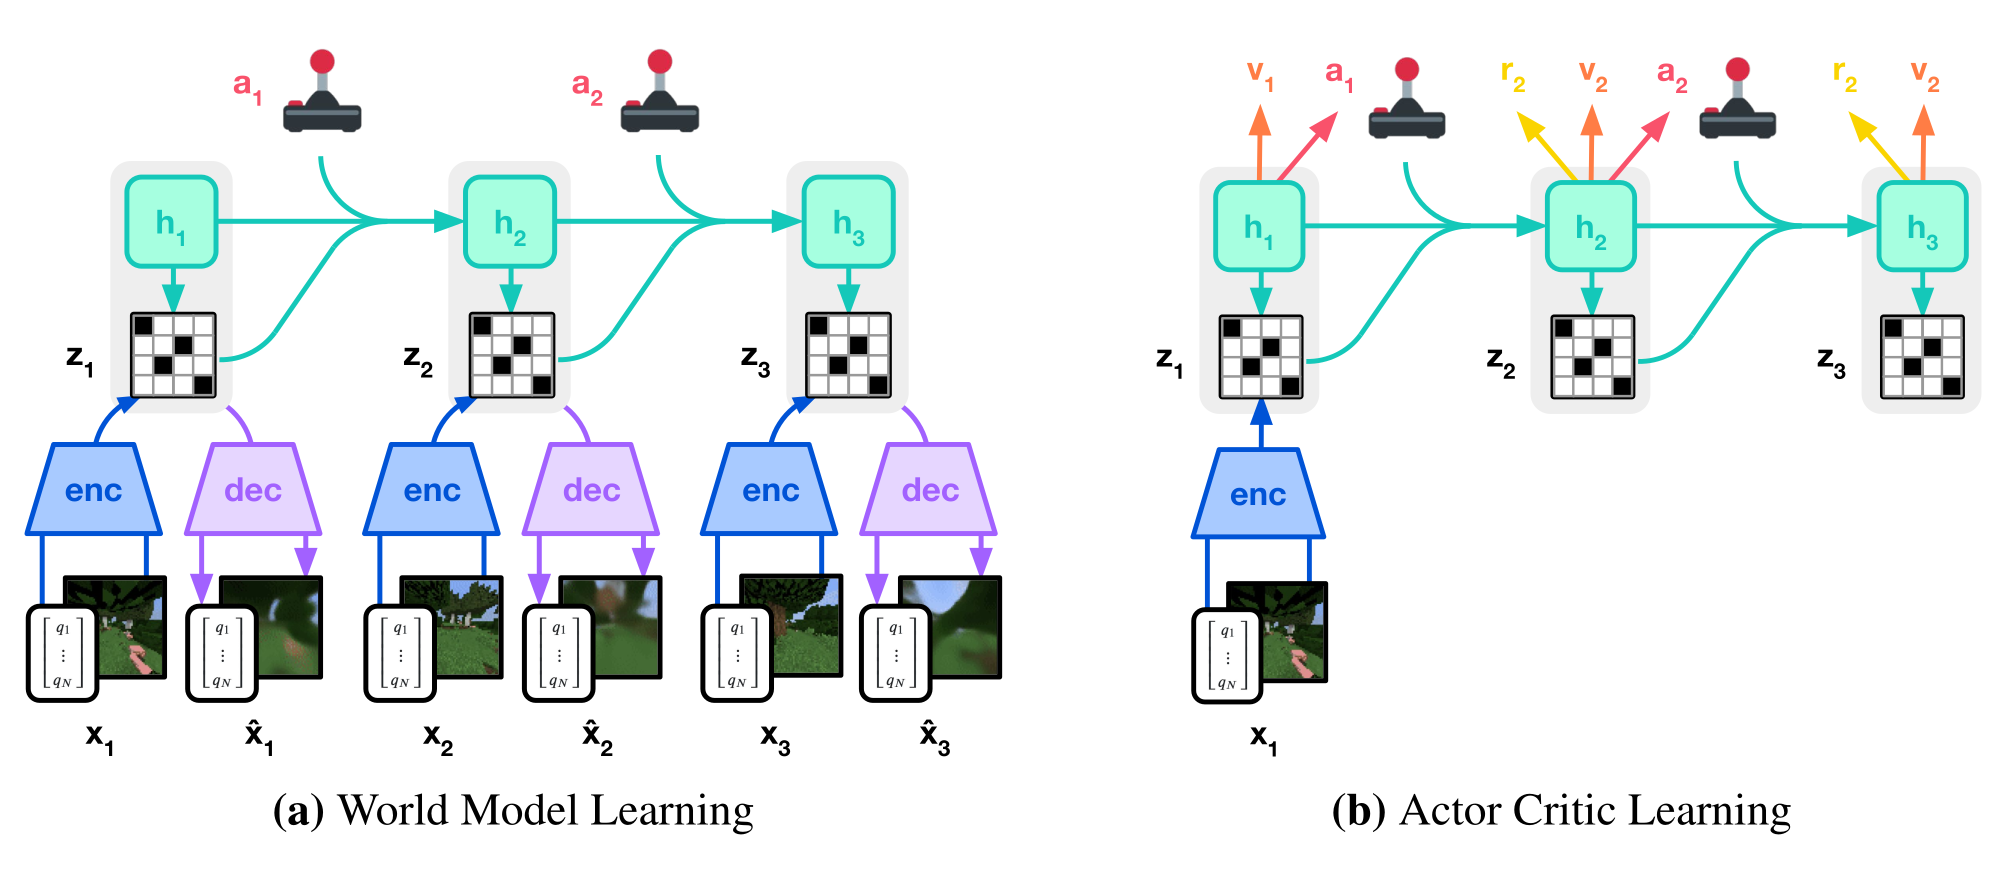
Dreamer 在 RSSM 的 latent imagination 中训练 actor 与 critic:
policy 不再在每个真实时间步运行 CEM,而是通过 imagined trajectory 学会快速给出动作。DreamerV2 采用离散 latent 并在 Atari 上扩展;DreamerV3 用更稳健的归一、损失与优化配方,以单套配置覆盖 150 多项作者评测任务。
DayDreamer 进一步报告了在真实机器人上在线学习的实验。这说明 latent imagination 不只适用于游戏,但不能把某些机器人任务上的样本效率外推为开放世界可靠性。
2025 年公开的 Dreamer 4 把因果视频 tokenizer、interactive dynamics 与 offline Minecraft 数据结合。论文报告了只用离线数据完成长程 Minecraft 目标的结果;截至 2026-07-28,官方项目页可核对论文与演示,未确认有与论文完整训练栈对应的官方代码。第三方实现应标为复现尝试。
MuZero:不重建观察也能规划
MuZero 提出三部分:
- representation \(h\) 把历史变成搜索状态;
- dynamics \(g\) 给出下一 latent state 与 reward;
- prediction \(f\) 给出 policy prior 与 value;
- MCTS 在 latent tree 中搜索,再用搜索 policy 和实际 return 训练网络。
这里没有像素重建约束。模型只需在搜索访问的动作与 horizon 上保持 reward、value 和 policy 一致,因此常称为 value-equivalent model。
这种选择节省了预测无关细节,却改变了可验证性:
- latent rollout 不能直接以画面检查;
- 对训练目标无关的物理问题,表示可能没有答案;
- 搜索分布外的动作仍可能产生无意义 latent;
- value 与 policy 一起出错时,MCTS 可能强化共同偏差。
MuZero 的成绩是作者在围棋、国际象棋、将棋与 Atari 协议中的结果,不能直接证明真实机器人或开放世界的动力学忠实度。
三种规划接口
轨迹优化与 MPC
对动作序列直接优化:
CEM 适合不可微模型和多峰目标;gradient-based planning 可复用可微动力学,但更容易沿模型漏洞走向极端动作。
树搜索
MCTS 更适合离散动作、可逐步展开的状态,以及有 policy prior/value 的模型。搜索预算、根节点噪声、temperature 与树复用都属于算法协议,不能只比较模型参数。
Policy in imagination
actor–critic 把大量搜索摊进训练,部署快;代价是策略可能长期适应同一个错误模型。实践中可以用短真实 rollout、模型 ensemble、不确定性惩罚和周期性再训练限制偏差。
Model bias 怎样进入闭环
设真实转移为 \(P\),学习模型为 \(\widehat P\)。即使在训练分布上
planner 会主动选择让预测回报最大的动作,而这些动作往往不是数据中最常见的动作。于是评测必须加入:
- 随机动作和 planner-selected action 分开统计;
- rollout error 随 horizon 的曲线;
- ensemble disagreement 或 calibrated uncertainty;
- 数据支持区域与 OOD action;
- predicted return 与真实 return 的偏差;
- 用真实 observation 重置后的恢复速度。
典型防线包括短 rollout、MPC 重规划、pessimism、uncertainty penalty、限制动作空间和真实数据回灌。它们降低风险,但不能把错误模型变成正确模型。
失效与评测
| 失效 | 表面现象 | 有效探针 |
|---|---|---|
| posterior collapse | 重建可用,latent 不携带状态 | KL、prior/posterior probe、干预 |
| exposure bias | teacher forcing 好,rollout 崩溃 | free rollout error–horizon |
| 多峰平均 | 预测落在两个可行未来之间 | likelihood、sample coverage、闭环 |
| model exploitation | 预测回报高、真实回报低 | planner action replay、OOD score |
| reward/value 共偏 | 搜索不断放大错误节点 | 独立 verifier、真实 return |
| 计划过时 | 动作序列与新观察冲突 | 扰动、延迟、replan frequency |
| 计算超预算 | 离线成功,实时无法控制 | 端到端 latency 与 jitter |
开放环模型 loss、imagined return、真实 closed-loop return 应同时报告。只给最后成功率又会隐藏模型、planner 与低层控制器各自的贡献;至少需要 model-free、oracle model、短 horizon、无重规划等消融。
预测目标怎样从像素转向 feature、latent action 与交互视频,见预测表征与生成世界;具身层的动作接口与安全边界见状态、动作与策略和规划、评测与安全。
Bellman、模型式规划与策略更新的组合练习见强化学习手撕实现。
Reference
- Sutton, Integrated Architectures for Learning, Planning, and Reacting
- Ha and Schmidhuber, World Models
- Hafner et al., Learning Latent Dynamics for Planning from Pixels
- Hafner et al., Dream to Control
- Hafner et al., Mastering Atari with Discrete World Models
- Hafner et al., Mastering Diverse Domains through World Models
- Wu et al., DayDreamer: World Models for Physical Robot Learning
- Hafner et al., Training Agents Inside of Scalable World Models
- Dreamer 4 Project
- Schrittwieser et al., Mastering Atari, Go, Chess and Shogi by Planning with a Learned Model