约束、风险与多智能体强化学习
最大化单一 scalar reward 只是强化学习的一种形式。真实系统还要满足成本、权限和风险约束,并可能与其他策略共同改变环境。Constrained RL 与 Multi-Agent RL 分别扩展目标和环境,但二者都会暴露“把一切加权成一个分数”的局限。
Constrained MDP
Constrained Markov Decision Process 在主回报之外定义成本:
其中
约束表达“达到任务目标,但预算、违规率或风险不得超过阈值”。这与简单 reward penalty
不同:加权和允许足够高的任务 reward 抵消违规,CMDP 则把界限作为独立目标。
Lagrangian 方法
构造
policy 最大化 \(\mathcal L\),dual variable 增大被违反约束的价格。这给出实用优化接口,却不自动保证有限训练过程每一步安全:
- cost estimator 有噪声;
- policy 与 \(\lambda\) 更新时间尺度耦合;
- 未见状态上的 cost 会外推;
- 平均约束可能掩盖 tail catastrophe。
Constrained Policy Optimization 研究 trust-region 下的约束改进,但理论假设和近似不应被直接外推到任意 LLM Agent。
Hard guard 与 learned constraint
权限、支付、删除或外部通信通常不适合作为可学习软惩罚。更稳妥的分层是:
policy proposal
  -> schema validation
  -> permission / policy guard
  -> sandbox or approval
  -> environment execution
  -> reward and cost accounting
RL 可优化获准动作内的效率和成功率;硬 guard 决定哪些动作根本不能执行。较低违规 reward 不能替代访问控制。
Risk-sensitive objective
期望回报会平均掉少数灾难结果。设 \(Z^\pi\) 是需要最小化的 episode loss,在置信水平 \(\alpha\in(0,1)\) 下,CVaR 可写成
它关注超过相应分位点后的平均 tail loss;若从 reward 出发,需要对 lower tail 或 loss \(Z^\pi=-G^\pi\) 保持一致的符号约定。CVaR MDP 把这种风险度量带入序贯决策,但有限样本下的尾部估计通常比均值更不稳定。其他选择包括:
- chance constraint;
- worst-case / distributionally robust objective;
- reachability 与 shield;
- per-state constraint。
选择取决于风险定义。CVaR 控制的是指定 loss 分布的尾部均值,不等于“任何时候都不会违规”;chance constraint、路径级 reachability 与硬运行时 guard 也不能由它自动推出。仅报告 mean success 与 mean cost 不能支持 tail safety。
Markov Game
Markov game 把单智能体 MDP 扩展到多个策略共同作用的环境。\(n\) 个 agent 的形式可写为
联合动作
共同决定转移。每个 agent 的环境因为其他 policy 学习而非平稳;单智能体 replay 数据会更快过时。
Cooperative、competitive 与 mixed
- cooperative:共享或相容 reward;
- competitive:目标存在冲突,但 reward 总和未必为零或常数;零和只是特殊情形;
- mixed / general-sum:合作与冲突会随角色、状态或联合动作变化。
“多个 LLM 一起对话”不自动构成多智能体 RL。必须存在独立策略身份、动作、观察、reward 与学习动态。
Centralized Training, Decentralized Execution
训练时 critic 可以读取联合状态和动作:
执行时每个 actor 只用本地 observation。这样缓解非平稳和信用问题,但需要训练阶段可访问的全局信息,部署不能假装同样可见。
MADDPG 是代表性实例,不是所有协作系统的默认解。
Multi-agent credit
共享 team reward 时,个体贡献难辨。常见方法包括:
- difference reward;
- counterfactual baseline;
- value decomposition;
- centralized critic;
- role-conditioned reward。
对语言 agent,小组最终成功可能来自一个 agent 的关键发现,也可能来自冗余投票。只把 team reward 复制给所有 token,会同时奖励无效消息和关键动作。
Self-play 与 population
Self-play 让 opponent 随训练共同演化,可产生自动 curriculum。它也可能:
- 在封闭群体中形成 exploit;
- 对历史 opponent 遗忘;
- 出现策略循环;
- 过拟合对手接口;
- 将 evaluator 漏洞变成群体规范。
Policy-Space Response Oracles 不只保留当前 opponent,而是维护策略集合,对混合策略训练近似 best response。这样的 population 不能保证自动收敛,却能显式暴露“只克制当前对手、被历史策略反制”的循环。保存 opponent population、matchmaking、版本、cross-play payoff matrix 与适用时的 exploitability 指标,比只报告当前 Elo 更有诊断力;在一般和博弈中,exploitability 也不能不加定义地照搬零和形式。
LLM 多智能体系统
常见角色包括 proposer、critic、verifier、planner 与 executor。需要区分:
- 它们是同一模型的多次采样,还是独立 policy;
- 共享 context 是否泄漏 private state;
- reward 是团队、个体还是角色特定;
- 通信 token 是否是 action;
- judge 是否也是训练参与者;
- 多 agent 增益是否只是更多 inference compute。
比较单 agent 与多 agent 时,应固定总 token、工具调用、wall-clock 与模型调用预算。
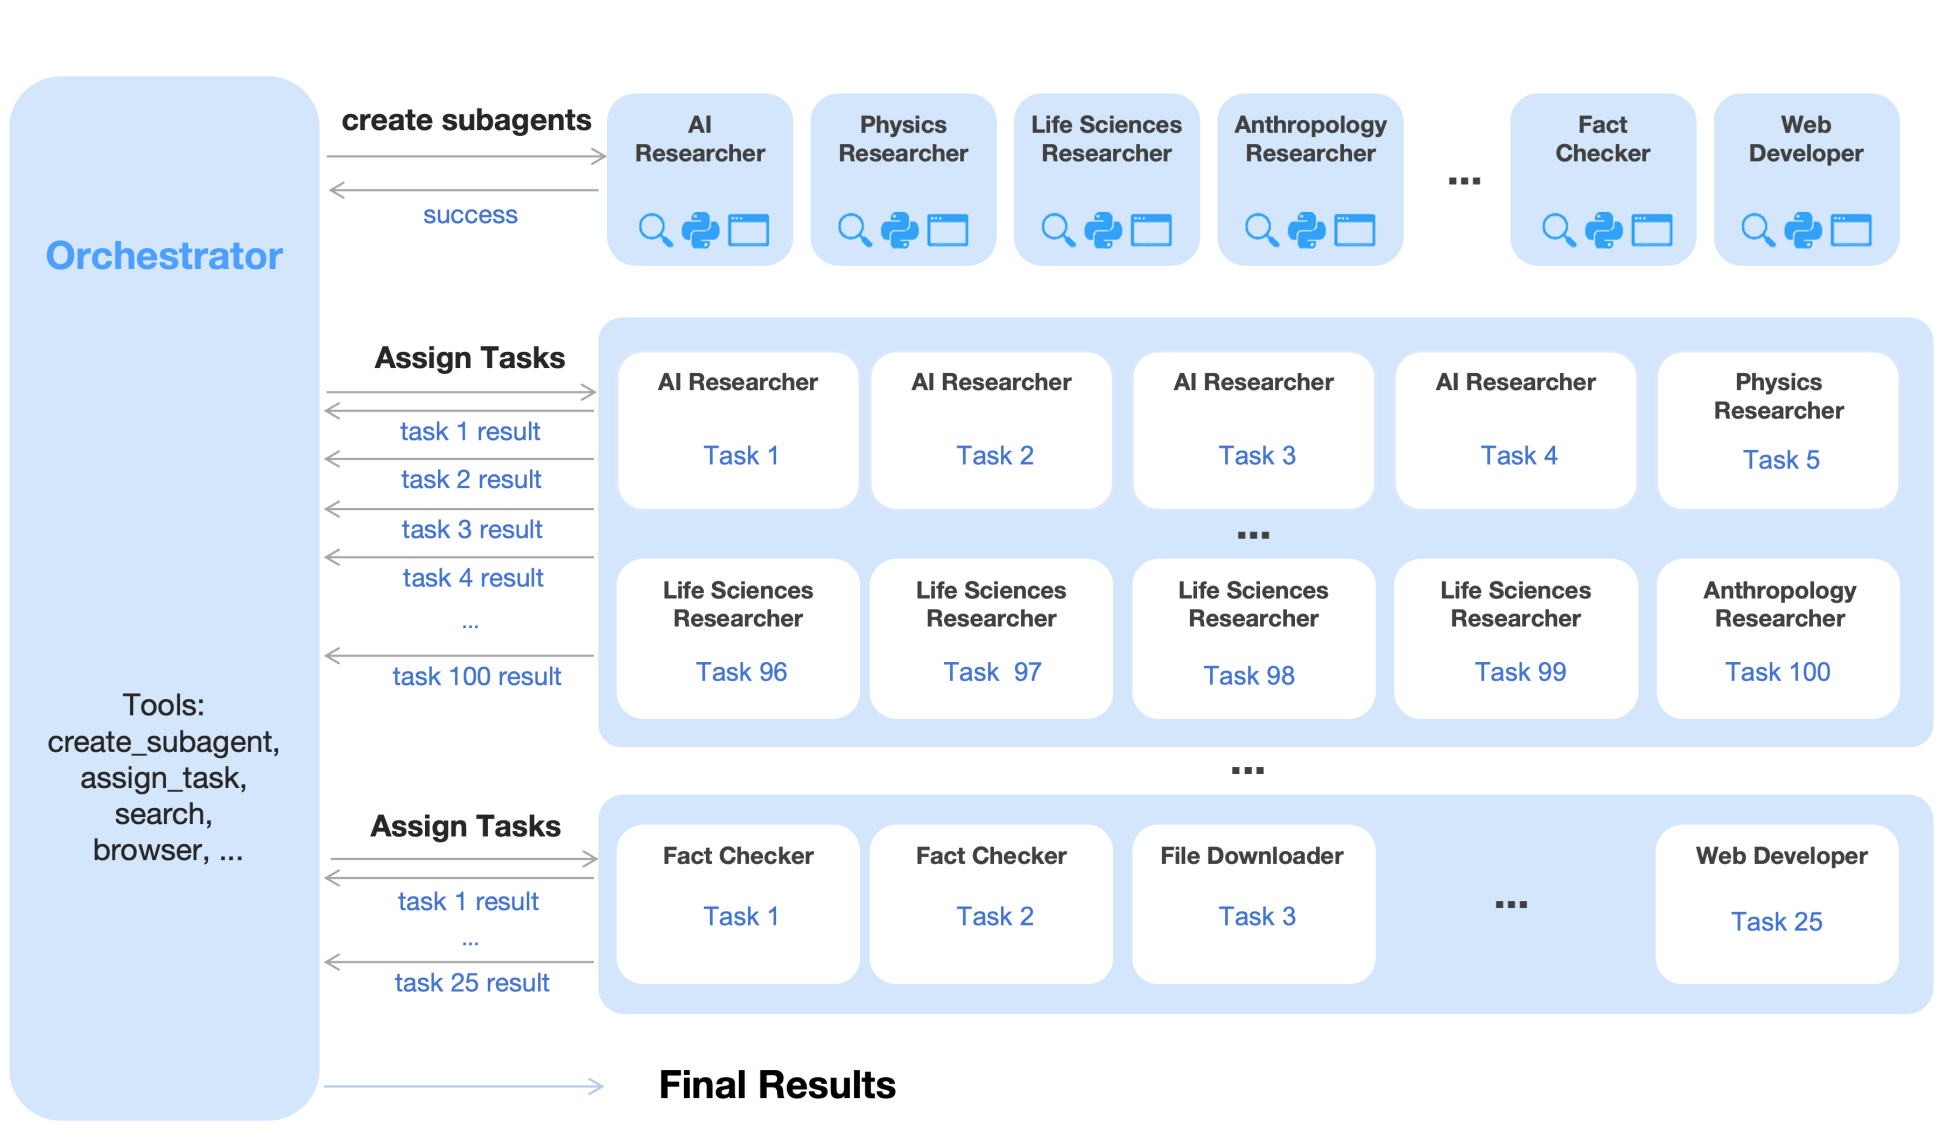
约束与多智能体的交叉
多个 agent 可能共享资源或共同触发外部风险。此时约束需要定义在:
- 个体行为;
- 联合动作;
- episode 总成本;
- per-user / per-resource 配额;
- tail event。
局部 policy 都满足约束,不保证联合动作安全。权限和资源仲裁应由运行时统一执行。
验证
- 分开主 reward、每项 cost 和硬拒绝。
- 报告平均约束、分位数与最坏 episode。
- 在 unseen state 上压力测试 learned cost。
- 多 agent 固定总推理预算与环境机会。
- 保存每个 agent 的 policy version 和观察权限。
- team reward 下审计无效通信和搭便车。
- self-play 对历史 population 与外部策略评测。
- 硬权限由 runtime enforcement 验证,不以 reward 曲线代替。
Agent 权限与副作用见 Agent 安全,训练诱发风险见 Agentic RL 评测,实验统计见强化学习诊断。
Reference
- Altman, Constrained Markov Decision Processes
- Achiam et al., Constrained Policy Optimization
- Rockafellar and Uryasev, Optimization of Conditional Value-at-Risk
- Chow et al., Risk-Sensitive and Robust Decision-Making: A CVaR Optimization Approach
- Littman, Markov Games as a Framework for Multi-Agent Reinforcement Learning
- Lowe et al., Multi-Agent Actor-Critic for Mixed Cooperative-Competitive Environments
- Foerster et al., Counterfactual Multi-Agent Policy Gradients
- Silver et al., Mastering the Game of Go without Human Knowledge
- Lanctot et al., A Unified Game-Theoretic Approach to Multiagent Reinforcement Learning