在线 RL 与可验证奖励
在线强化学习从当前或近期策略采样,再根据 reward、verifier 或环境终态更新策略。它能探索离线数据中不存在的行为,也带来非平稳数据、昂贵 rollout、策略滞后和奖励投机。
InstructGPT 适合核对经典 RLHF 中 SFT、reward model 与 PPO 的角色;DeepSeek-R1 则展示可验证奖励、group-relative 更新与蒸馏之间必须分开的证据边界。两者之间的演进见后训练与对齐。
本页只保留 online rollout 的数据闭环。算法选择先看推理 RL 配方地图;PPO、GAE、GRPO 与分布校正的 canonical 推导分别见 PPO、Advantage 与 GAE、GRPO 和训推分布与策略滞后。
策略与轨迹契约
一次训练更新至少涉及四个不同策略身份:
| 符号 | 角色 | 是否变化 |
|---|---|---|
| \(\pi_\theta\) | 正在计算梯度的新 policy | 当前 update 内变化 |
| \(\pi_{\text{old}}^{\mathrm{train}}\) | PPO surrogate 的冻结更新基准 | 对该批轨迹冻结 |
| \(\mu^{\mathrm{rollout}}\) | 真正产生 token 的 behavior distribution | 由 checkpoint、引擎与采样器共同定义 |
| \(\pi_{\text{ref}}\) | KL 或行为先验的 reference | 通常长期冻结 |
\(\pi_{\text{old}}\) 决定 PPO update ratio,\(\mu\) 决定真实 off-policy correction,\(\pi_{\text{ref}}\) 定义策略偏离。同步且无训推差异时 old 可近似 behavior;这不是由 checkpoint ID 自动保证的事实。完整分解见策略身份、训推分布与策略滞后。
每个 action token 至少记录:
prompt / environment and trajectory ID
token or action ID and action mask
behavior policy version and exact rollout log-prob
old-training policy version and recomputed frozen log-prob
reference version and reference log-prob
reward components and verifier version
terminal / truncated / invalid / timeout / infra error
sampling configuration and RNG
工具 observation、system token、prompt 和 padding 不是 policy action,不应进入 policy ratio。
算法怎样插入数据闭环
在线系统不应在这里重新定义每个 optimizer,而应固定它们消费和产生的数据:
| 环节 | 闭环中的职责 | 深入入口 |
|---|---|---|
| advantage / return | 把 reward 与未来状态变成局部学习信号 | GAE、无 critic baseline、GRPO |
| policy update | 在冻结 old-training 坐标中更新 current policy | PPO、Ratio、Clipping 与 Gate |
| distribution correction | 处理真实 behavior、训练重算与 current 之间的差异 | 训推分布与策略滞后、Off-policy 校正 |
| recipe | 联合采样、归约、长度处理、critic 与系统节奏 | 推理 RL 配方地图 |
一次可审计迭代应按状态转换理解:
prompt/environment snapshot
  -> rollout under recorded behavior distribution
  -> validate terminal, truncation and infrastructure status
  -> score with versioned reward/verifier
  -> freeze old-training coordinates and build targets
  -> update actor/critic under explicit reductions
  -> evaluate held-out capability and failure slices
  -> promote, retain or reject the new policy revision
同步系统可以让 rollout、target 构造与 learner step 严格成批;异步系统则以更高设备利用率换取 policy lag、队列选择偏差和更复杂的版本治理。无论使用哪种算法,都应同时核算生成 token、保留样本、训练 token、wall-clock 与最终能力,而不只比较 learner steps。
Partial rollout
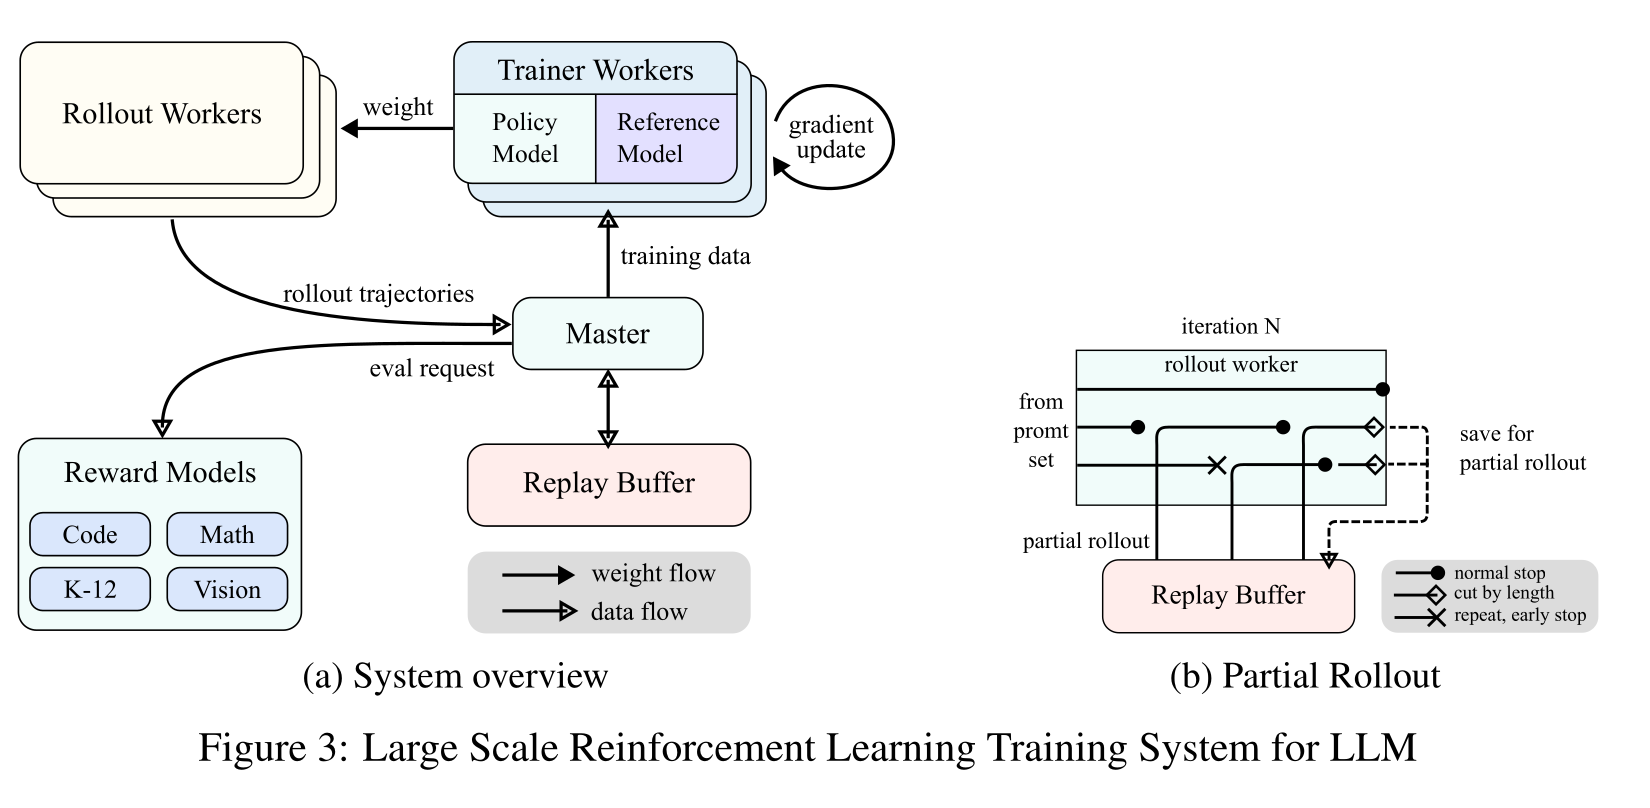
长轨迹的尾延迟会让同步 batch 长时间等待。部分 rollout 可以对 \(N\) 个 prompt 各计划 \(K\) 条轨迹,在累计完成 \(\lambda NK\) 条后开始 learner step;尚未完成的轨迹进入 paused,下一轮从已保存状态继续。Kimi K3 技术报告给出了这一机制的工程实例,完整上下文见 Kimi K3。
paused 不是 truncated:前者仍属于同一 episode,后者由预算或协议结束。可恢复记录至少包含 environment snapshot、KV/sampler 状态、工具调用游标、behavior revision、已产生 token 的 log-prob 与当前 reward 状态。它缩短 barrier,却会引入两类新偏差:
- 先完成轨迹更早进入训练,数据分布与长度、环境速度相关;
- 暂停轨迹恢复时,current policy 已更新,旧 token 与新 token 可能来自不同版本。
因此 \(\lambda\)、pause age、完成/暂停长度分布和版本跨度都应入账;若一个 episode 允许跨版本继续,必须逐 token 保存 behavior identity,并采用明确的 off-policy 校正或丢弃规则。
Reward 与 verifier
可验证任务通常把最终答案、测试或环境状态转成 reward。必须区分:
infra error 不应自动记为零 reward;否则策略会学习规避某些机器或工具状态。reward 还应分解为任务、格式、长度、成本和安全项,并保留未加权原值。
reward model 的校准与不可辨识性见奖励建模,推理任务中的 verifier 设计见推理后训练。
Effort 与长度约束
固定最大 token 只给出硬上限,不能表达“这道题应花多少推理成本”。可为 prompt \(x\) 建立基准预算 \(b_0(x)\),再按 effort condition 和课程系数 \(\tau\) 形成阈值;例如
一般推理任务可只计 reasoning token;agent 任务则还要声明是否计入工具参数、工具结果和最终响应。预算惩罚必须与正确性 reward 分开报告,否则模型可能通过短而错误的回答“优化成本”。K3 报告还采用 generative reward model 的分步协议:先阅读候选、构造任务相关 rubric,再评分并保存 scorepad,同时用相对基准长度限制无效冗长。可迁移的是让评分依据和长度分量可审计;模型裁判本身仍需独立校准与隐藏 verifier。
正确性与失效
- old/ref 混淆:PPO ratio 与 KL penalty 使用错误概率。
- 训练模板重算 old log-prob:重算结果不再是 behavior probability。
- prompt 与 observation 进入 action loss:优化非策略生成内容。
- terminal/truncated 合并:value target 错误。
- 组内 std 为零:NaN 或噪声被放大。
- 把缺失 reward 当失败:基础设施故障污染策略。
- sequence reward 复制到每个 token 后再求和:长回答被重复加权。
- 只监控 mean reward:reward hacking、长度漂移和多样性坍缩被掩盖。
- 异步数据无限复用:importance ratio 极端,更新由过时策略主导。
- 新 recipe 缺少同预算基线:收益混入更多 rollout、过滤或调参。
何时不应在线 RL
高质量示范或离线 pair 已覆盖目标、reward 无法可靠判断核心正确性、环境昂贵且不可重放、或高风险动作缺少外部权限控制时,不应先上在线 RL。Rejection sampling、Best-of-\(N\)、SFT 或离线偏好往往是更容易验证的基线。
验证
- 当 \(\pi_\theta=\pi_{\text{old}}\) 时,所有有效 action 的 \(\rho_t=1\)。
- 保持 action-state 输入不变、只修改被 action mask 排除的 prompt/padding log-prob 张量时,policy loss 不变。
- 用两三步轨迹手算 return、GAE、terminal 与 truncated。
- RLOO 检查 \(K<2\);GRPO 检查全同 reward、极小 std 和缺失结果。
- 按 policy lag、ratio、长度、group success rate 和 verifier 状态分层。
- 固定生成 token、样本数、训练 token 和调参预算比较 PPO、RLOO、GRPO 与 rejection sampling。
- 对 reward 高但人工或隐藏 verifier 失败的轨迹优先审计。
- save/resume 后 behavior revision/log-prob、old-training revision/recomputed log-prob、data cursor 和 reference 必须连续。
目标函数的最小实现见手撕 LLM 策略优化,多步动作与异步轨迹见轨迹与策略契约。