Kimi / Moonshot AI:模型、机制与系统的家族地图
Kimi 的技术线很难用一串版本号概括。最早公开成体系的工作首先回答长上下文怎样被服务,随后才分别沿着长程强化学习、稀疏模型、视觉与音频、形式化推理、软件工程 Agent、线性注意力和分布式系统展开;K2 系列把其中多条支线合并,K3 又把 sequence、depth 与 expert 三种信息通路放进同一个训练—部署闭环。
因此,本页不把所有 Moonshot AI 仓库都称作“模型”,也不把产品名称、API 模型 ID 与公开 checkpoint 混在一起。这里区分六类对象:
paper / technical report
checkpoint / weights / model card
training or inference code
dataset / evaluation harness
API / product
license
具体发布日期与版本继承见 Kimi 技术谱系;K3 的结构、训练、系统、评测与附录见 Kimi K3 工作深读,其 150 项参考文献如何组成论证链见 K3 引用图谱。本页负责回答更高一层的问题:整个公开家族有哪些分支,它们怎样汇合,又有哪些内容仍未公开。
家族地图
一条主干,六组互相牵引的支线
| 分支 | 关键公开节点 | 它真正改变的问题 | 汇入主干的位置 |
|---|---|---|---|
| 长上下文与服务 | Mooncake → MoBA → Kimi Linear | KV 状态放在哪里、全注意力怎样稀疏化、序列状态能否固定大小递推 | K3 的 KDA / Gated MLA、KDA Context Parallelism 与 hybrid prefix cache |
| 优化与规模训练 | Moonlight / scalable Muon → K2 → K3 | 矩阵参数怎样更新、attention logit 怎样稳定、规模实验怎样反推 recipe | Muon → MuonClip → Per-Head Muon |
| 长推理与 Agentic RL | Kimi k1.5 → Kimi-Researcher → K2 Thinking → K2.5 | 长轨迹怎样采样、续跑、评分并在动态工具环境中训练 | partial rollout、general critic、multimodal RL、persistent rollout 与 MOPD |
| 多模态与专门模型 | Kimi-VL、Kimi-Audio、Kimina-Prover、Kimi-Dev | 视觉、音频、形式证明和软件修复分别需要什么表示、数据与反馈 | K2.5 / K2.6 / K2.7 Code 的视觉 Agent,以及 K3 的 MoonViT-V2 与专业任务环境 |
| 稀疏结构与高性能实现 | LatentMoE、FlashKDA、Attention Residuals、MoonEP | 宽度、序列和深度的稀疏性怎样真正落到 kernel、通信和流水线 | K3 的 Stable LatentMoE、Block AttnRes、FlashKDA 与动态冗余专家 |
| Agent 与验证工具 | Kimi Code、Agent SDK、K2 专项 Vendor Verifier 与当前 Kimi Vendor Verifier | checkpoint 怎样获得工具、权限、状态、协议与可重复的服务质量 | coding / research harness、typed tool call、跨供应商 API contract;两个 verifier 是前后两套评测面,不是模型版本节点 |
这些箭头表示公开材料支持的技术承接关系,不表示后一节点完整继承了前一项目的代码。例如 K3 使用 KDA,却不是把 48B Kimi Linear 机械放大;K2.5 把 Agent Swarm 作为系统能力,不能据此断言公开权重在任意本地 harness 中都会自行产生同样的并发拓扑;Kimi Code 能调用 K3,也不因此成为 K3 checkpoint 的组成部分。
第一阶段:先让长上下文成为可运营的系统
Mooncake 把长上下文首先表述为服务系统问题:prefill 与 decode 分离,GPU 集群之外的 CPU、DRAM 和 SSD 组成分布式 KV cache,调度器在 goodput 与 SLO 之间选择。它公开的是论文、代码与 trace/data,而不是一个 Kimi 模型 checkpoint。由此可见,支持长输入从来不只等于扩大 RoPE 范围;状态放置、传输、复用与过载控制同样决定用户最终看到的上下文能力。
MoBA 随后把问题推回模型内部:将上下文切成 block,让 query 自己选择 top-\(k\) KV blocks,同时保留从 full attention 平滑过渡到 sparse attention 的训练路径。它需要继续训练,不能像推理插件一样无损套在任意既有模型上。再往后,Kimi Linear 用 Kimi Delta Attention(KDA)把一部分 token 历史压进递推状态,并周期性插入全局 MLA;K3 才把这条算法路线与 kernel、context parallelism、prefix-state cache 一起放大到 1M context。
这三步对应三种不同的“长”:
- Mooncake 解决服务端如何承载和复用长 KV;
- MoBA 解决 token 应该稀疏读取哪些历史 block;
- KDA 解决一部分历史能否压缩成固定大小的递推状态。
它们可以组合,却不是同一种复杂度优化。进一步比较可回到长上下文、注意力变体、状态空间与线性注意力、KV Cache 与推理分离。
第二阶段:优化器、长轨迹与专门模型同时分叉
Moonlight 用 16B 总参数、约 3B activated 的 MoE checkpoint 验证大规模 Muon,并公开 base、instruct、中间 checkpoint 与分布式实现。它的历史作用不只是又一个小模型,而是把矩阵正交化更新、参数尺度和 weight decay 变成可做 scaling-law 对照的训练变量。K2 在此基础上面对更大模型的 attention-logit explosion,引入 MuonClip;K3 又把矩阵块进一步切到 attention head,形成 Per-Head Muon。
与此同时,Kimi k1.5 把长 chain-of-thought、128K RL context、partial rollout 和 long2short 放进同一训练叙事。这里的关键不是“生成更长”,而是 episode 的生命周期发生变化:未完成轨迹可以暂停、续跑和进入下一轮数据消费,而不必在同步 barrier 前被截断为失败样本。后来 K2.5 和 K3 延续了这条状态语义,但算法、环境与系统规模并不相同。
2025 年春夏的公开项目则像一组受控探针:
- Kimi-VL 研究原生分辨率视觉编码、稀疏语言主干、128K 视觉上下文与多模态 reasoning;
- Kimi-Audio 用连续声学特征作为输入、12.5 Hz 离散语义 token 作为输出,并以 flow-matching streaming detokenizer 接回语音波形;
- Kimina-Prover Preview 在 Lean 4 whole-proof generation 上研究大规模 RL、formal reasoning pattern 与采样计算扩展;
- Kimi-Dev 把真实仓库、Docker test suite 与代码修复 reward 结合起来,后续报告再把 Agentless skill prior 与 SWE-Agent 适配联系起来;
- Kimi-Researcher 把搜索、浏览、代码执行和终止动作放在单条 end-to-end RL 轨迹中,公开方法页面与线上 Deep Research 产品,但没有把“计划开放”当成已经发布的权重。
这些支线说明,专业能力的差异不只来自 prompt:观察空间、action grammar、验证器、环境可恢复性、数据合成与评测 harness 都在改变优化问题。
第三阶段:K2 把稀疏规模与 Agentic 训练合流
Kimi K2 以 1T 总参数、32B activated 的 MoE 为主干,将 15.5T token 预训练、MuonClip、agentic data synthesis、可验证与不可验证任务的通用 critic,以及 checkpoint-engine 权重热更新放到同一系统中。初始公开的 Base / Instruct 是 non-thinking 路线;后续版本不是简单改名:
- K2-Instruct-0905 把上下文从 128K 扩到 256K,并加强 coding 与 tool use;
- K2 Thinking 转向 interleaved thinking 与多步工具调用,并在 post-training 中采用 native INT4 QAT;
- K2.5 在 K2-Base 上做约 15T mixed visual-text continual pretraining,把 vision、thinking / instant、joint multimodal RL 与 Agent Swarm 放入同一模型和系统;
- K2.6 沿用 K2.5 报告所描述的 1T / 32B、MoonViT、256K 架构面,重点公开新的 coding、long-horizon execution 与 swarm post-training / 产品能力;
- K2.7 Code 继续沿用 K2.5 / K2.6 架构,专门优化长程软件工程,并强制 thinking 与 preserved thinking。
这条线最容易产生两个误读。第一,K2.6 与 K2.7 Code 的官方模型卡仍把 K2.5 报告作为论文入口,因此它们是有独立权重与模型卡、但没有新 full technical report 的后训练发布。第二,Agent Swarm 的并发数量、step 上限、工具权限和 context management 属于完整在线系统协议;checkpoint 只提供做决策的 policy,不自动携带整个运行时。
第四阶段:K3 把三种信息通路与系统状态合成
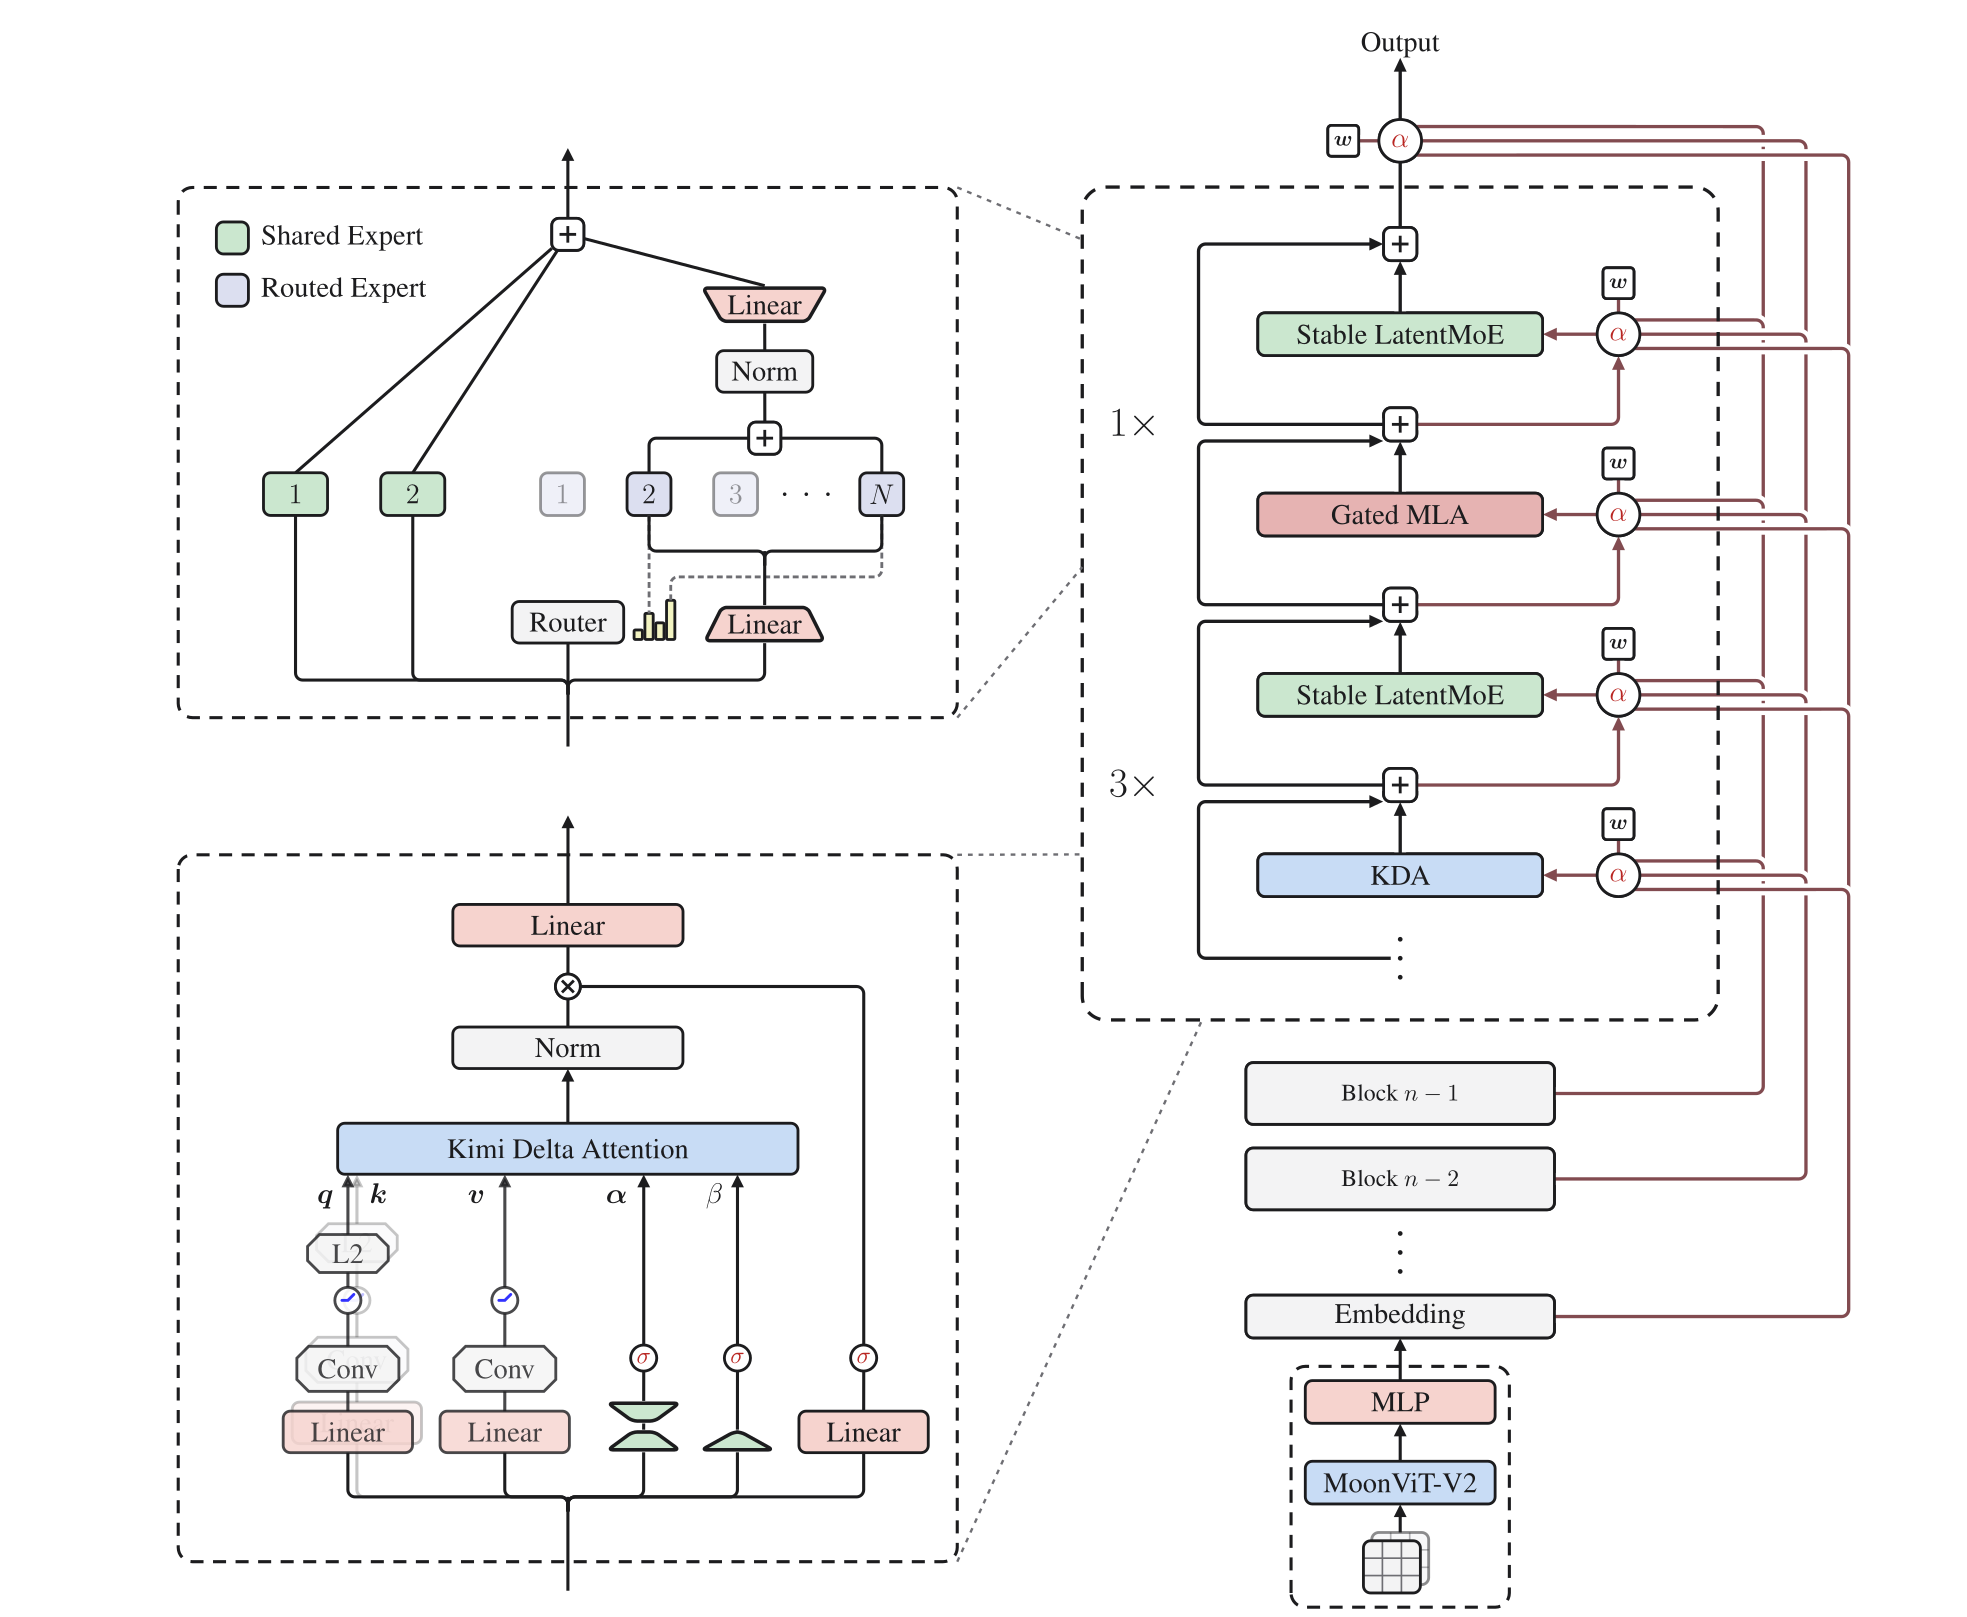
Kimi K3 不是只把 K2 的专家数放大。它同时重新组织:
- sequence:69 层 KDA 与 24 层 Gated MLA;
- depth:8 个 Block Attention Residuals block;
- channel:Stable LatentMoE 中 896 个 routed experts 选 16 个,并保留 2 个 shared experts。
MoonViT-V2、Per-Head Muon、Quantile Balancing、Multi-Teacher On-Policy Distillation、MXFP4 / MXFP8 QAT、EAGLE draft、MoonEP、persistent AgentENV、hybrid prefix cache 与 XTML 则把模型结构接回训练和服务。其 2.8T 总参数、104B activated 与 1M context 是具体 checkpoint 口径,不能反向覆盖 K2 系列,也不能由 API 名称推断本地权重与线上服务完全一致。
公开产物账本
下表核验到 2026-07-28。日期指最早可核验的对应公开物;博客、论文、权重、代码与 API 可以不同日上线。未公开 只表示在所列第一方入口中没有找到相应产物,不表示内部不存在。
模型与 checkpoint
| 节点 | 日期与对象 | 已公开的表面 | 证据边界 |
|---|---|---|---|
| Kimi k1.5 | 2025-01-22 报告与官方仓库 | 报告、说明与图表 | 没有稳定的一手发布页可支撑更早的日级产品日期;仓库未随附 checkpoint、完整训练代码或模型许可证 |
| Moonlight | 2025-02-24 论文;2025-03-03 技术文章 | Base、Instruct、中间 checkpoint、分布式 Muon 代码;仓库 MIT | 论文首次提交与后续技术文章是两种日期口径;它仍是研究 checkpoint,不应自动写成 Kimi 商业 API 型号 |
| Kimi-VL | 2025-04-10 报告 | MoonViT-SO-400M、A3B-Instruct、A3B-Thinking 与 Thinking-2506;代码;MIT | 权重、推理代码和完整训练栈是三种开放层级;K3 的 MoonViT-V2 不是 MoonViT 的同名复用 |
| Kimina-Prover | 2025-04-15 Preview 报告;2025-07-10 72B 更新 | distilled 1.5B / 7B 与 autoformalization 权重、后续 72B;rectified miniF2F;Lean server | Moonshot AI 与 Numina 的专门分支,基座和每个 checkpoint 许可证应分别查看模型卡 |
| Kimi-Audio | 2025-04-25 报告 | Base、Instruct、推理 / finetune 代码与评测工具 | 仓库中 Qwen 派生代码为 Apache-2.0,其余代码为 MIT;模型卡仍需单独核验 |
| Kimi-Dev | 2025-06-17 模型发布;2025-09-27 报告 | 72B 权重、workflow / rollout 代码 | 基于 Qwen2.5-72B;许可证受 Qwen agreement 约束,其余标为 MIT |
| Kimi-Researcher | 2025-06-20 方法页 | end-to-end Agentic RL 方法、实验与线上 Deep Research 产品 | 官方仓库只是项目页入口;公开页面曾写“计划开放”,截至核验日不能据此记为已发布权重 |
| K2 Base / Instruct | 2025-07-11 发布;2025-07-28 报告 | Base、Instruct、部署资料、API;Modified MIT | 初始 Instruct 是 non-thinking;训练数据和完整 RL 系统未开放 |
| K2-Instruct-0905 | 2025-09-05 checkpoint 更新 | 权重与模型卡、API;该 checkpoint 的 Modified MIT | 独立发布面是模型卡和权重,没有新的 full report |
| Kimi Linear | 2025-10-30 报告 | 48B-A3B Base、Instruct、KDA / FLA 实现;MIT | 研究模型;K3 修改 decay、MLA、residual、MoE 与系统实现,不能视作同一 checkpoint 的规模扩展 |
| K2 Thinking | 2025-11-06 发布 | 权重 / 模型卡、API、native INT4;该 checkpoint 的 Modified MIT | 无独立 full report;产品 chat mode、agent harness 与报告分数的 step / tool 配置并不相同 |
| K2.5 | 2026-01-27 发布;2026-02-02 报告 | 权重、仓库、API / 产品;Modified MIT | checkpoint 可本地部署,但 Agent Swarm 的在线编排和完整 RL 环境不是权重文件 |
| K2.6 | 2026-04-20 发布 | 权重 / 模型卡、API / 产品;该 checkpoint 的 Modified MIT | 模型卡仍关联 K2.5 报告;没有公开新的完整预训练与后训练配方 |
| K2.7 Code | 2026-06-12 发布记录 | 权重 / 模型卡、Kimi Code / API;该 checkpoint 的 Modified MIT | 基于 K2.6、架构沿用 K2.5 家族;只支持 thinking,独立 full report 未见公开 |
| K3 | 2026-07-16 发布文章;2026-07-27 报告与权重 | 2.8T / 104B activated 权重与模型卡、报告、部署入口、API / 产品;Kimi K3 License | 完整预训练代码、全部数据配比与 RL 环境未开放;API 还受到 effort、tool protocol、cache 与服务端版本影响 |
许可证链接必须落到具体对象。K2 系列的 Modified MIT 都沿用 MIT 主体,并在产品达到相应规模门槛时增加界面显著标注要求,但要求展示的型号随 checkpoint 改变,不能只读一个泛化标签。K3 则不是这份文本的改名版:其自定义许可全文覆盖权重、参数、配置、训练与推理代码等“Software”,允许使用、修改、再分发与创建衍生物,同时加入适用法律和版权声明。若使用 K3 的商业产品或服务超过 1 亿月活,或月收入超过 2,000 万美元,界面需要显著展示 Kimi K3;另有一项面向 Model as a Service 的商业边界。该术语在许可中指向让第三方能够对输入、参数或训练数据施加实质控制的推理 / 微调服务,不包括仅把能力嵌入特定功能或 harness 的终端产品,也不包括单纯转发至他方托管模型。当被许可方及关联方在任一连续 12 个月内合计收入超过 2,000 万美元,经营该类服务并将 K3 用于商业目的前需要另行与 Moonshot AI 达成协议。内部使用和经 Moonshot 官方产品或认证推理伙伴访问的情形另有例外。这里仅解释公开文本的技术采用边界,不构成法律意见;部署、微调、再分发或商业服务前仍应阅读对应 checkpoint 的完整许可并获得专业法律判断。
机制、训练与推理系统
| 公开物 | 类型与许可证 | 在家族中的角色 | 它不是什么 |
|---|---|---|---|
| Mooncake | serving system、code / trace / paper | KV-centric disaggregated serving、cache pool、SLO-aware scheduling | 不是 checkpoint,也不是长上下文训练算法 |
| MoBA | attention paper + reference / efficient code;MIT | 可训练的 block-sparse attention | 不是无需训练即可替换全注意力的插件 |
| Moonlight | optimizer paper + checkpoints + distributed code;MIT | 证明 Muon 的尺度调整、weight decay 与分布式实现可进入大模型训练 | 不只是 K2 的小尺寸版本 |
| checkpoint-engine | RL weight-update middleware;MIT | 在训练与不同分片的推理实例间做 broadcast / P2P 热更新 | 不是 checkpoint 存储格式,也不是完整 RL framework |
| Kimi Linear / KDA | architecture report + weights + code;MIT | 在 recurrent、chunkwise parallel 与 hybrid global attention 间建立同一语义 | 不等于 K3 的完整 architecture |
| Attention Residuals | architecture paper / figures | 沿 depth 对历史层表示做内容相关聚合 | 仓库当前不是完整训练 reference implementation |
| FlashKDA | CUTLASS kernel;MIT | 把 KDA chunkwise algebra 落到 tile、decay 与 recurrent state 管理 | 不是另一个 Kimi 模型 |
| MoonEP | expert-parallel library;MIT | 依据实际路由复制远端专家,使 rank token load 固定化 | 不是 MoE router 的训练目标,也不替代 checkpoint license |
| K2 Vendor Verifier | K2 专项 tool-call vendor harness;仓库未单列 LICENSE | 以官方 API 为参照,比较 trigger similarity、schema accuracy 与特定推理栈 / checkpoint 约束 | 是早期专项方法和历史结果;README 已指向更新后的 Kimi Vendor Verifier,不能当作当前通用协议 |
| Kimi Vendor Verifier | 跨版本 API contract 与 benchmark suite;MIT | 面向 K3 扩展 OCRBench、MMMU-Pro Vision、BEAM 1M、DeepSWE,并检查参数、tool schema、dynamic tools、thinking effort 与 token accounting | 是独立的新仓库和更宽的评测面,不是旧 K2 仓库的改名,也不是对模型整体质量或安全性的认证 |
| PerceptionBench | 视觉 perception benchmark、dataset 与 evaluator;Apache-2.0 | 把视觉感知错误与 reasoning / knowledge 错误拆开 | 排名随模型版本与 judge 协议变化,不是训练方法 |
| WorldVQA | visual world-knowledge benchmark、dataset 与 code | 测量视觉实体的 grounding / naming 和长尾知识 | 不能单独解释多步视觉 reasoning |
| CombiBench | Lean combinatorial benchmark;MIT | 检验形式化组合数学与 theorem-proving 系统 | 不是 Kimina-Prover 训练集的完整公开替代 |
Agent、协议与开发工具
模型给出下一步 action,运行时决定 action 能否安全而可重复地发生。这一层的第一方公开物应作为软件项目阅读:
| 公开物 | 类型 | 主要接口 | 许可证 / 状态 |
|---|---|---|---|
| Kimi Code | coding-agent CLI / TUI | tools、MCP、subagents、hooks、ACP、session lifecycle | MIT,当前主线 |
| Kimi CLI | 早期 Python agent runtime | tools、MCP、wire protocol、Kosong / KAOS | Apache-2.0,官方说明正在迁移到 Kimi Code |
| Kimi Agent SDK | Go / Node / Python client libraries | 复用 Kimi CLI 的 configuration、tools、skills、MCP 与 approval stream | Apache-2.0 |
| kimi-agent-rs | Rust wire-compatible agent server | JSON-RPC、Kosong、KAOS、MCP | Apache-2.0;Python runtime 是其兼容基准 |
| walle | JSON Schema validator | structured generation 的 schema parse、canonicalization 与 validation levels | MIT |
| moonpalace | API debugging tool | request / response 调试 | GPL-3.0 |
kosong 与 pykaos 的独立仓库已经把开发入口迁入 Kimi CLI monorepo;它们分别抽象 model provider 与 operating-system / sandbox surface。仓库迁移是软件组织变化,不代表模型架构变化。
官方 GitHub 公共仓库快照:43 / 43
截至 2026-07-28,MoonshotAI 官方组织的 GitHub public-repository API 返回 43 个仓库,均不是 fork,也没有标记 archived。下面把 43 个逐一归档且只计一次;分类描述的是公开物角色,不是 checkpoint lineage。Hugging Face 权重、Kimi 产品与 API 型号不在这 43 个 GitHub 仓库数内;Mooncake 位于 kvcache-ai 组织,也因此在家族叙事中收录、在本快照计数中排除。
模型与研究:13
| 仓库 | 公开物边界 | 账本处理 |
|---|---|---|
| Attention-Residuals | depth residual 架构论文、图表与说明 | 纳入结构谱系;不登记为 checkpoint 或完整训练实现 |
| Kimi-Audio | 音频模型、权重入口、推理 / 微调代码 | 纳入音频分支;模型卡与代码许可证分别核验 |
| Kimi-Dev | SWE 专门模型、rollout / workflow 代码 | 纳入 coding / Agentic RL 分支;保留 Qwen 基座许可边界 |
| Kimi-k1.5 | 长推理 RL 报告、图表与说明 | 纳入方法谱系;没有据此登记开放 checkpoint |
| Kimi-K2 | K2 家族报告、部署说明与权重入口 | 纳入 K2 主干;具体 checkpoint 仍以模型卡分列 |
| Kimi-K2.5 | K2.5 报告、视觉 Agent 说明与权重入口 | 纳入 K2.5 主干;Agent Swarm runtime 不并入权重 |
| Kimi-K3 | K3 报告、模型卡镜像、部署入口与许可 | 纳入 K3 主干;报告、权重、API 与产品日期分列 |
| Kimi-Linear | KDA 报告、研究权重与实现 | 纳入线性注意力分支;不画成 K3 checkpoint 的直接父节点 |
| Kimi-Researcher | end-to-end research-agent RL 项目页 | 纳入 Agentic RL 方法;公开计划不记作已发布权重 |
| Kimi-VL | MoonViT、视觉语言模型权重与代码 | 纳入视觉分支;不把 MoonViT 与 K3 的 MoonViT-V2 合并 |
| Kimina-Prover-Preview | Lean 4 形式证明报告与公开物入口 | 纳入 formal reasoning 分支;后续 AI-MO checkpoint 独立核验 |
| MoBA | block-sparse attention 论文与实现 | 纳入长上下文机制;不是通用推理插件 |
| Moonlight | scalable Muon 论文、权重与分布式实现 | 纳入优化器谱系;不登记为 K2 的小型 checkpoint |
系统与 kernel:3
| 仓库 | 公开物边界 | 账本处理 |
|---|---|---|
| checkpoint-engine | 训练与 rollout engine 间的权重热更新 middleware | 纳入 Agentic RL 系统;不是模型格式或完整 RL framework |
| FlashKDA | KDA 的高性能 CUTLASS kernel | 纳入 kernel 路线;不登记为模型 |
| MoonEP | dynamic redundant experts 的 expert-parallel library | 纳入 MoE systems;不等同于路由训练目标 |
Agent 与 API 软件:11
| 仓库 | 公开物边界 | 账本处理 |
|---|---|---|
| kimi-agent-rs | wire-compatible Rust agent server | 纳入 runtime / protocol;不是 checkpoint |
| kimi-agent-sdk | Go、Node、Python agent clients | 纳入 SDK;能力上限不能反推模型权重 |
| kimi-cli | 早期 Python agent runtime 与 monorepo | 纳入 runtime;保留迁往 Kimi Code 的状态 |
| kimi-code | 当前 coding-agent CLI / TUI | 纳入 Agent scaffold;与所路由模型分列 |
| kimi-code-zed-extension | Zed 的 ACP 集成 | 纳入 IDE adapter;不进入模型谱系 |
| koishi-plugin-moonshot-api | Koishi 的 Moonshot API 插件 | 纳入早期 API integration;不进入模型谱系 |
| koishi-plugin-moonshot-api-plus | Koishi 的扩展 API 插件 | 纳入早期 API integration;不进入模型谱系 |
| kosong | model-provider abstraction,已迁入 kimi-cli |
登记迁移状态;不重复计算为一套新模型系统 |
| moonpalace | Moonshot API 调试工具 | 纳入开发工具;不把调试行为视为 API 能力保证 |
| pykaos | agent OS / sandbox abstraction,已迁入 kimi-cli |
登记迁移状态;不进入模型谱系 |
| walle | Moonshot-flavored JSON Schema validator | 纳入 structured-generation contract;不是生成模型或 verifier 榜单 |
评测与验证:7
| 仓库 | 公开物边界 | 账本处理 |
|---|---|---|
| batched-benchmark | vLLM / serving 批量测速脚本 | 纳入系统评测工具;结果需要固定硬件、模型和 workload |
| CombiBench | Lean combinatorial benchmark | 纳入 formal reasoning 评测;不是训练集完整替代 |
| K2-Vendor-Verifier | K2 tool-call vendor 精度专项 | 保留为历史评测面;其 README 明确转向新的 verifier |
| Kimi-Audio-Evalkit | 音频理解 / 生成评测工具 | 纳入音频证据;不与 Kimi-Audio 模型仓库合并 |
| Kimi-Vendor-Verifier | 当前以 K3 为主、并保留 K2.6 及更早说明的跨供应商 API contract 与 benchmark suite | 纳入当前评测面;不覆盖供应商整体质量与安全 |
| PerceptionBench | atomic visual perception dataset 与 evaluator | 纳入视觉评测;作者报告与独立复现分列 |
| WorldVQA | visual world-knowledge dataset 与 code | 纳入视觉知识评测;不代替多步视觉 reasoning 评估 |
支持、聚合与演示:9
| 仓库 | 公开物边界 | 账本处理 |
|---|---|---|
| .github | 组织级 profile / community 配置 | 计入公开仓库总数;排除出技术 lineage |
| awesome-moonshot-api | Moonshot API 生态项目聚合 | 计入生态索引;第三方条目不当作官方实现 |
| Branding-Guide | 品牌资产与使用规范 | 计入组织公开面;排除出技术 lineage |
| kimi-help-center | 帮助中心多语言内容源 | 用于核产品 / API 行为;不登记为模型或论文 |
| minitriton | K3 构建的教学型 tile compiler 与评测 | 纳入能力案例;README 明示不是 Moonshot 产品且不建议生产使用 |
| MoonshotAI-Cookbook | Moonshot API 示例与指南 | 纳入使用示例;不当作模型或 API 规范本身 |
| moonshotai.github.io | 组织 GitHub Pages 内容 | 计入发布基础设施;排除出技术 lineage |
| nano-kpu | K3 构建的 nano-scale KPU RTL 演示 | 纳入能力案例;README 明示不是 Moonshot AI 官方项目 |
| zsh-kimi-cli | Kimi CLI 的 Zsh 交互插件 | 纳入开发体验;排除出模型与 Agent runtime 主线 |
这个快照的计数是组织资产审计,不是技术贡献排名。后续若仓库新增、改名、迁移、归档或转移组织,应先更新快照日期与 43 / 43 分母,再判断它属于模型事件、系统实现、评测协议还是外围软件;不能把 GitHub 列表顺序直接画成模型继承箭头。
贯穿家族的六条技术线
长上下文:容量、选择、状态与缓存必须分开
“支持 1M”至少包含四层:
- 训练或位置编码能否稳定到达该长度;
- token 是否以 full、block-sparse、linear state 或 hybrid attention 交互;
- KV / recurrent state 如何切分、传输、复用和失效;
- benchmark 是否真的要求跨距离检索、组合与执行,而不是只容纳长输入。
Mooncake、MoBA、Kimi Linear 与 K3 分别落在不同层。对外比较时,应同时固定有效输入长度、输出与 reasoning budget、cache 状态、prefill / decode 拓扑和任务的证据距离。
优化器:从矩阵几何一路走到 attention head
Moonlight 的 Muon 路线先用 Newton–Schulz 型正交化处理二维参数更新,再通过 weight decay 与 update RMS scaling 解决跨形状一致性。K2 的 MuonClip 观察到 attention logit 爆炸与 \(W_Q,W_K\) 更新直接相关,于每步后约束二者乘积尺度。K3 的 Per-Head Muon 则承认 fused projection 中不同 head 不是一个自然的单矩阵块,按 head 分组做更新。
这里的共同线索是:optimizer state、参数分组与模型语义不能彼此独立设计。完整推导与比较见优化器家族和 K2 工作深读。
强化学习:轨迹越来越长,状态也越来越“物理”
k1.5 的 partial rollout 保存未完成 token 轨迹;Kimi-Researcher 把 search / browser / code tool observation 纳入 state;K2 把 agentic data synthesis 与通用 critic 接起来;K2 Thinking 放大 interleaved reasoning / tool steps;K2.5 让 vision 与 swarm action 进入联合 RL;K3 则继续保存 KV state、sandbox state 与跨 iteration episode。
因此,长程 RL 的瓶颈逐步从“怎样算 advantage”扩展成:
policy freshness
trajectory lifecycle
environment persistence
verifier reliability
weight dissemination
context and KV ownership
这些问题分别连接在线强化学习、推理后训练、Agentic RL 训练系统与长程轨迹。
多模态:视觉主干合流,音频仍保持独立生成路径
Kimi 多模态分支展示了从 Kimi-VL 的 MoonViT 与稀疏 language decoder,到 K2.5 的 early fusion / MoonViT-3D,再到 K3 MoonViT-V2 与原生视觉预训练的变化。K2.6 和 K2.7 Code 继承 K2.5 家族的 MoonViT 架构面,并把 image / video 输入接入 coding 与 Agent 场景。
Kimi-Audio 则没有简单接到视觉 token 管线上:它同时使用连续声学特征与离散语义 token,并需要 streaming detokenizer 把生成状态还原成波形。理解这条分支应进入音频语言模型,而不是把所有模态统一写成“经过 projector 送入 LLM”。
稀疏:token、expert 与 depth 是三种不同选择
- MoBA 在 token blocks 中选择;
- MoE router 在 experts 中选择;
- Attention Residuals 在历史 depth representations 中选择;
- KDA 则不是 top-\(k\) 选择,而是对递推状态做带遗忘的 associative update。
K3 把后三者同时放进一个模型,才会产生新的系统耦合:KDA state 进入 prefix cache,AttnRes block summary 进入 pipeline communication,expert routing 进入 MoonEP load plan。更一般的比较见 Mixture of Experts、MoE 系统与注意力 kernel。
Agent:模型分数必须与 scaffold 分列
Kimi-Researcher、Kimi Code、Agent Swarm 与 K3 white-box harness 代表四个不同层次:专门训练的研究 policy、通用 coding runtime、由模型产生并行拓扑的产品模式,以及训练 / 评测使用的 environment distribution。它们共同决定任务成功率,却不能互相替代。
任何 Agent 结果至少应保留:
- checkpoint 与 chat / tool template;
- thinking budget、context management 与 preserved-thinking 规则;
- tools、权限、sandbox 和网络可达性;
- 最大 steps、并发宽度、重试与中断策略;
- verifier / judge、重复次数、cost 与评测日期。
缺少这些字段时,分数只是一套系统配置的快照。通用方法见 Agent 应用、Coding Agents 与 Agent 工具评测。
站内阅读路径
先按版本进入
- 长推理起点:Kimi k1.5
- 1T MoE、MuonClip 与 Agentic 训练:Kimi K2
- 原生多模态、联合 RL 与 Agent Swarm:Kimi K2.5
- 三条信息流与完整系统:Kimi K3
- 逐版本日期、权重、代码、API 与许可证:Kimi 技术谱系
- K3 的全部直接引用与归因边界:K3 引用图谱
再沿机制拆开
- recurrent state、chunkwise algebra 与 kernel:Kimi Linear / FlashKDA
- depth mixing、online softmax 与 pipeline cache:Attention Residuals
- LatentMoE、SiTU-GLU 与 Quantile Balancing:Stable LatentMoE
- dynamic redundant experts 与固定 rank load:MoonEP
- 视觉家族总览:Kimi 多模态分支
- MoonViT、128K 视觉上下文与多模态后训练:Kimi-VL
最后回到 canonical 主干
| 想解决的问题 | 推荐入口 |
|---|---|
| KDA、MoBA 与 full attention 如何比较 | 线性时间序列模型谱系 · 注意力变体 |
| 1M context 的训练、测量与服务分别意味着什么 | Scaling 与上下文谱系 · 长上下文 · Cache 复用 |
| 1T / 2.8T 为什么不等于每 token 计算量 | 条件计算谱系 · MoE |
| partial rollout、critic、MOPD 怎样区分 | 推理策略优化谱系 · LLM 强化学习 |
| checkpoint 如何在训练与 rollout engine 间更新 | Agentic RL 训练系统 · 分布式训练系统谱系 |
| FlashKDA、MoonEP 与 speculative draft 怎样落到硬件 | Kernel 与性能 · Speculative Decoding |
| 视觉、视频和音频怎样进入模型 | 多模态架构与训练 · 音频与视频 |
| 开放权重、代码、数据与 API 如何比较 | 开放模型生态 |
仍然未知
公开材料已经足以重建许多机制,却不足以把任何一版训练完整复现。当前最重要的空白包括:
- 数据:K2、K2.5 与 K3 披露了总量、阶段和若干 domain,但没有公开可复现的全量语料、去重规则、采样权重、污染审计和每阶段数据快照。
- 训练配方:K2 的 MuonClip 与 K3 的 Per-Head Muon 有公式和系统描述,完整超参数 schedule、故障恢复策略、所有消融与完整训练代码仍未公开。
- 后训练 lineage:K2-Instruct-0905、K2 Thinking、K2.6 与 K2.7 Code 都有独立模型卡 / 权重,却没有与 K2 / K2.5 同等粒度的 full report;不能用相邻版本配方填补。
- Agent 环境:Kimi-Researcher、Agent Swarm 与 K3 的任务生成、sandbox image、tool distribution、verifier 和 context manager 只公开了部分设计,线上系统还会持续变化。
- API 等价性:同名 API、Kimi.com 产品、Kimi Code 路由与公开 safetensors 可能具有不同的模板、effort、fallback、cache、tool 与 safety layer。
- 独立复现:大部分 benchmark 是作者报告或动态 leaderboard;长程任务尤其受 harness、网络、judge、重试和预算影响,需要固定日期与协议后再比较。
- 安全:开放权重、长上下文与长程工具使用扩大了部署风险面,但家族各版本的系统化安全报告、训练数据风险和外部复现覆盖仍不均衡。
- K3 视频输入证据面:官方仓库 README、发布文章和 K3 的 API / Hermes 接入指南将能力表述为 text、image 与 video;API 的文件接口也提供
purpose="video"的服务端上传与预处理。与此同时,Hugging Face 模型卡的结构化pipeline_tag是image-text-to-text,Model Summary 写的是Text, Image,公开本地示例也只展示 text + image。两组证据共同确认了产品 / 服务端视频理解表面,却还不足以证明开放 checkpoint 已公开一个可复现的“原始视频容器 → 本地 processor → 时序视觉 token”原生路径;服务端抽帧或其他视频预处理能力不能直接外推成开放权重接口。 - 许可证组合:模型、派生基座、代码、kernel、dataset 与在线服务使用条款可能不同;组件采用 MIT / Apache-2.0 不会自动改变 checkpoint 的 Modified MIT 或 Kimi K3 License。
这些空白不是待填的故事。新的模型卡、报告修订、代码或独立复现出现时,应先更新具体对象和日期,再判断它改变的是家族事件、工作深读还是 canonical 机制。
Reference
- Moonshot AI official research index
- Moonshot AI official GitHub organization
- Moonshot AI official model collection
- Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving
- Kimi k1.5: Scaling Reinforcement Learning with LLMs
- MoBA: Mixture of Block Attention for Long-Context LLMs
- Muon is Scalable for LLM Training
- Kimi-VL Technical Report
- Kimina-Prover Preview
- Kimi-Audio Technical Report
- Kimi-Researcher: End-to-End RL Training for Emerging Agentic Capabilities
- Kimi K2: Open Agentic Intelligence
- Kimi-Dev: Agentless Training as Skill Prior for SWE-Agents
- Kimi Linear: An Expressive, Efficient Attention Architecture
- Kimi K2 Thinking official model card
- Kimi K2.5: Visual Agentic Intelligence
- Attention Residuals
- Kimi K2.6 official model card
- Kimi K2.7 Code official model card
- Kimi K3 official repository, report and license
- Kimi K3 official model card and structured modality metadata
- Kimi API file upload and video-processing contract
- Checkpoint Engine
- FlashKDA
- MoonEP
- Kimi Code
- Kimi Agent SDK
- K2 Vendor Verifier
- Kimi Vendor Verifier
- WorldVQA
- PerceptionBench official repository and report