Agentic RL 的算法决策
Agentic RL 不是把 PPO、GRPO 或 DPO 接到更长的文本上。模型的动作会改变后续观察,工具执行有真实成本,任务可能只在很久以后给出结果,而 rollout 时长又常呈长尾分布。算法选择因此应从训练契约出发:反馈从哪里来,数据由谁产生,哪些 token 是动作,奖励怎样回传,以及 rollout 与 learner 如何协同。
经典策略梯度、Bellman 递推、GAE 和重要性采样的完整推导分别见策略梯度、Actor–Critic、多步回报与 GAE 和 Off-policy 校正。本页关心的是另一件事:面对一个具体的 agent 训练任务,应怎样组合这些工具。
六个先于算法名的问题
| 决策轴 | 需要先回答的问题 | 它直接决定什么 |
|---|---|---|
| 反馈来源 | 有专家示范、成对偏好、程序 verifier,还是环境终态? | SFT、偏好优化或在线 RL 的数据入口 |
| 数据与策略 | 数据固定、按轮刷新,还是持续由 rollout worker 产生?behavior policy 与当前 policy 相差多远? | 是否需要探索、重要性校正和版本治理 |
| 动作粒度 | 一个动作是 token、span、turn、tool call,还是完整 episode? | action mask、log-probability、ratio 与 loss 分母 |
| 信用分配 | 奖励落在终局、中间步骤还是每个环境转移? | Monte Carlo、组内基线、critic、GAE 或过程奖励 |
| Critic | 能否可靠学习状态价值?同一状态能否便宜地采多条轨迹? | 用计算换 value,还是用额外 rollout 换 baseline |
| 执行时序 | rollout 是否有明显长尾?同步 barrier 是否真的限制利用率? | 同步批训练、异步队列、staleness 控制 |
这六条轴彼此不能替代。RLHF、RLAIF、RLVR 描述的是反馈怎样产生;PPO、RLOO、GRPO 描述的是如何估计和约束更新;同步或异步描述的是系统何时消费轨迹。把它们压成一条“算法排行榜”,通常会选错问题。
六种常见起点并不处于同一层级
| 方法 | 直接需要的数据 | 是否依赖新 rollout | Learned critic | 信用粒度 | 主要同步约束 |
|---|---|---|---|---|---|
| SFT | 专家或筛选后的动作序列 | 否 | 否 | 对示范 action 做局部似然学习 | 普通数据并行 |
| DPO | 同一条件下的偏好对 | 每轮内不需要 | 否 | 通常比较完整 response / trajectory | 普通数据并行 |
| PPO | rollout、reward、旧策略概率 | 通常需要 | 通常需要 | token / turn 级 advantage | 采样—训练批次边界 |
| RLOO | 同一 prompt 的 \(K\ge2\) 条带分轨迹 | 是 | 否 | response / episode 级相对优势 | 必须等同组候选 |
| GRPO | 同一 prompt 的 \(K\ge2\) 条带分轨迹 | 是 | 否 | 组内标准化后常广播到 action token | 必须等同组候选 |
| Critic-based async | 持续到达的 rollout、行为概率、reward | 是 | 是 | token / turn 级 advantage | 无 prompt 组 barrier,但有 policy lag |
SFT 不是强化学习,DPO 也不等于“离线 PPO”。RLOO 与 GRPO 都没有 learned critic,却仍然有 baseline。所谓 critic-based asynchronous method 更不是一个固定目标函数:它通常把 PPO 或 actor–critic estimator 与异步队列、行为概率记录、陈旧度控制组合起来。先分清这些层级,才知道实验中的收益来自哪一处。
反馈来源:先判断信号是否值得优化
有高质量示范
SFT 最小化示范动作的负对数似然:
其中 \(m_t\) 只覆盖示范中的可学习动作。它适合建立格式、工具协议和基本任务能力,也能为后续 RL 提供更好的初始状态分布。它的上限受示范覆盖约束:只模仿成功轨迹不会自动学会失败恢复,也不会主动发现示范之外的更优策略。模仿学习与 Offline RL 进一步讨论 covariate shift。
相对判断比绝对打分可靠
DPO 直接使用偏好对 \((y_w,y_l)\)。令
则
它省去了显式 reward model 与在线 rollout 闭环,适合主观质量、风格和安全偏好较稳定的场景。对于多轮 agent,完整轨迹偏好只能说明“哪条更好”,不能自然指出哪次工具调用造成差异;固定数据也无法覆盖新策略将访问的新状态。周期性重采样可以让数据更新,但不会自动解决状态覆盖和信用分配。
结果可以程序化核验
数学答案、单元测试、证明 kernel 和环境成功状态能给出可扩展的 outcome reward。这类 RLVR 任务适合在线探索,但“可验证”只说明评分规则能执行,不说明它覆盖完整目标:
- 测试通过不等于程序可靠、可维护;
- 最终答案正确不等于中间推理可信;
- 格式合法不等于工具动作安全;
- verifier 可见的漏洞会成为策略可优化的捷径。
因此训练 verifier、模型选择 evaluator、隐藏终测与部署门禁应尽量使用不同证据通道。若 reward 本身错了,更低方差的 estimator 只会更稳定地优化错误目标。
中间过程也能被可靠评价
过程 reward 可以缩短信号路径,但 learned process score 会引入新的代理目标。只有形如
的 potential-based shaping 在标准条件下保持最优策略不变;一般的“进度分”没有这一保证。设计细节见 Verifier、过程奖励与 Reward Shaping。权限、不可逆操作等约束通常更适合硬门禁或 constrained objective,而不是允许高任务分抵消违规。
数据与策略:online/offline 不等于 on/off-policy
两组概念回答不同问题:
- online / offline:训练期间是否继续从 policy 或环境获得新数据;
- on-policy / off-policy:数据的行为策略 \(\mu\) 是否与待优化策略 \(\pi_\theta\) 一致。
持续在线系统也可能消费陈旧轨迹;周期式 PPO 的 rollout 刚产生时接近 on-policy,对同一批数据做多轮更新后便逐渐 off-policy。DPO 可以周期性生成新偏好对,但每一轮仍在固定 pair 上优化。
对已采样动作,局部重要性比为
这里至少要区分四个角色:
- \(\pi_\theta\):learner 当前策略;
- \(\mu\):真正产生动作的 behavior distribution;
- \(\pi_{\mathrm{old}}\):某些 PPO 实现冻结的更新基准;
- \(\pi_{\mathrm{ref}}\):KL 正则或 DPO 中的参考策略。
它们可能在同步小实验里碰巧相同,在异步系统中通常不同。temperature、top-\(p\)、grammar mask 与 constrained decoding 都会改变 \(\mu\);只保存变换前 logits 不能完整表示实际采样分布。
更重要的是,逐 token ratio 只在旧数据已经覆盖的动作上修正概率。多轮 agent 的旧动作还改变了后续状态访问分布;旧轨迹从未到达的状态,不能靠局部 ratio 补出来。重要性采样、Retrace、V-trace 和 policy lag 的边界见 Off-policy 校正。
动作粒度:环境一步与模型一个 token 不是一回事
语言 agent 常在多个尺度上同时运转:
| 尺度 | 典型对象 | 适合承载什么 | 容易犯的错误 |
|---|---|---|---|
| Token | 自回归采样位置 | log-prob、ratio、细粒度 loss | 把 observation token 当动作 |
| Span | reasoning 段、JSON 参数 | 局部 credit 与结构约束 | 边界由字符串格式偶然决定 |
| Turn / tool call | 一次可观察的环境决策 | transition、成本、过程 reward | turn 内所有 token 被视作同等贡献 |
| Episode | 完整任务 | 终局 reward 与成功定义 | 方差大,早期错误难定位 |
设 \(m_t\) 是 action mask,\(w_t\) 包含 advantage 与 ratio 等权重。一个常见 policy loss 写成
分母 \(D\) 是目标定义的一部分:
- 取有效 token 数,表示每个 action token 等权;
- 先对 response 求均值,表示每条 response 等权;
- 先对 prompt group 求均值,表示每个问题等权;
- 先对 episode 求均值,表示长短任务等权。
这四种 reduction 会产生不同的长度偏好,不能只当成数值实现差异。system、user、外部 observation、padding 和复制进来的历史通常不进入 action loss;由 policy 主动生成并影响后续决策的 summary 则可能是动作。完整的数据契约见语言模型作为策略和轨迹与策略契约。
信用分配:结果应当改动哪些决策
终局奖励与 Monte Carlo
只有最终 reward \(R(\tau)\) 时,最直接的做法是把
回传到先前动作。它不要求学习中间 reward,但长轨迹中的环境随机性和无关决策会同时进入估计量。baseline 降低方差,却不能告诉模型哪一步真正造成成功。
Critic 与 GAE
critic 估计 \(V_\phi(h_t)\),再以
在 bootstrap bias 与 Monte Carlo variance 之间折中。GAE 对长程任务的关键不只是调 \(\lambda\),而是先明确一个“时间步”究竟对应 token、action span 还是环境 turn。外部 observation 会改变下一个 value 的条件,但它不是 policy action,不应仅因文本很长就机械增加折扣步数。
同 prompt 的相对 baseline
同一 prompt 采样 \(K\) 条轨迹时,RLOO 使用
而 GRPO 的常见形式为
RLOO 的 baseline 不包含当前样本;GRPO 的标准化进一步让不同 prompt 的尺度更接近。代价是 \(K=1\) 时无法构造组信号,all-correct 或 all-wrong 组的优势为零,且整组必须等待最慢 rollout。它们的公式、分母与 Dr. GRPO、DAPO 等修正见无 learned critic 的策略梯度。
压缩、分段与层级决策
长任务一旦经过摘要或上下文压缩,一条 episode 可能变成多个独立训练 segment。此时必须说明:
- 最终 reward 是否只计一次;
- 早期 segment 到终局的真实距离怎样恢复;
- summary token 是否由 policy 采样并参与优化;
- segment 数是否改变一条 episode 的总体权重。
CompactionRL 处理的是这种跨段表示与信用问题,不是异步调度本身。若任务天然含子目标,还可以把高层 option 与低层执行拆开,但子目标边界、终止条件和两层 reward 都需要独立定义,详见模型、规划与层级决策。
Critic:用 value 计算,还是用额外 rollout 比较
“有无 critic”不是先进与落后的分界,而是两种成本结构。
| 条件 | Critic-free 更自然 | Learned critic 更自然 |
|---|---|---|
| 同一 prompt 的候选 | 便宜、可并行、\(K\ge2\) | 每个状态只有一条或极少轨迹 |
| Reward | 终局 reward 可靠且组内有方差 | 稀疏、延迟,需要状态相关 baseline |
| Horizon | 较短或长度相近 | 很长、需要 bootstrap 或 turn-level credit |
| 系统 | 能承受 group barrier | 希望完成即消费或持续异步 |
| 主要成本 | 额外 rollout、无信号组、等待长尾 | value 参数、预训练、更新与校准 |
critic 的价值不应只看 value loss。至少还要按 horizon、终止类型和 policy version 检查:
- explained variance 与 return variance;
- value 对 realized return 的校准;
- actor 与 critic 的更新速度;
- 早期状态是否被系统性高估或低估;
- truncated episode 是否按契约 bootstrap。
critic 过慢会制造带偏 advantage;critic-free 方法则可能把大量预算花在组内重复采样和无信号候选上。公平比较必须同时报告 environment episode、rollout token、进入反向传播的 action token 与 wall-clock。
同步与异步:吞吐提升会交换成统计偏差
成组方法对同一 prompt 的完成时间为 \(t_1,\ldots,t_K\) 时,最早只能在
之后构造组内优势。工具慢调用、编译、浏览器任务和长推理会使这道 barrier 尤其明显。
异步系统让已完成轨迹进入 learner 队列,可以减少等待,但 learner 更新会使后到数据逐渐陈旧。可靠实现至少需要:
- 保存实际 behavior log-probability 与 action token;
- 为轨迹绑定 policy、tokenizer、模板、环境和 verifier 版本;
- 按 ratio、KL、queue time 与 version lag 分层监控;
- 使用受控的重要性修正、截断或 trust gate;
- 对过旧或无法重建的轨迹明确丢弃,而不是静默混入;
- 将环境故障与策略失败分开。
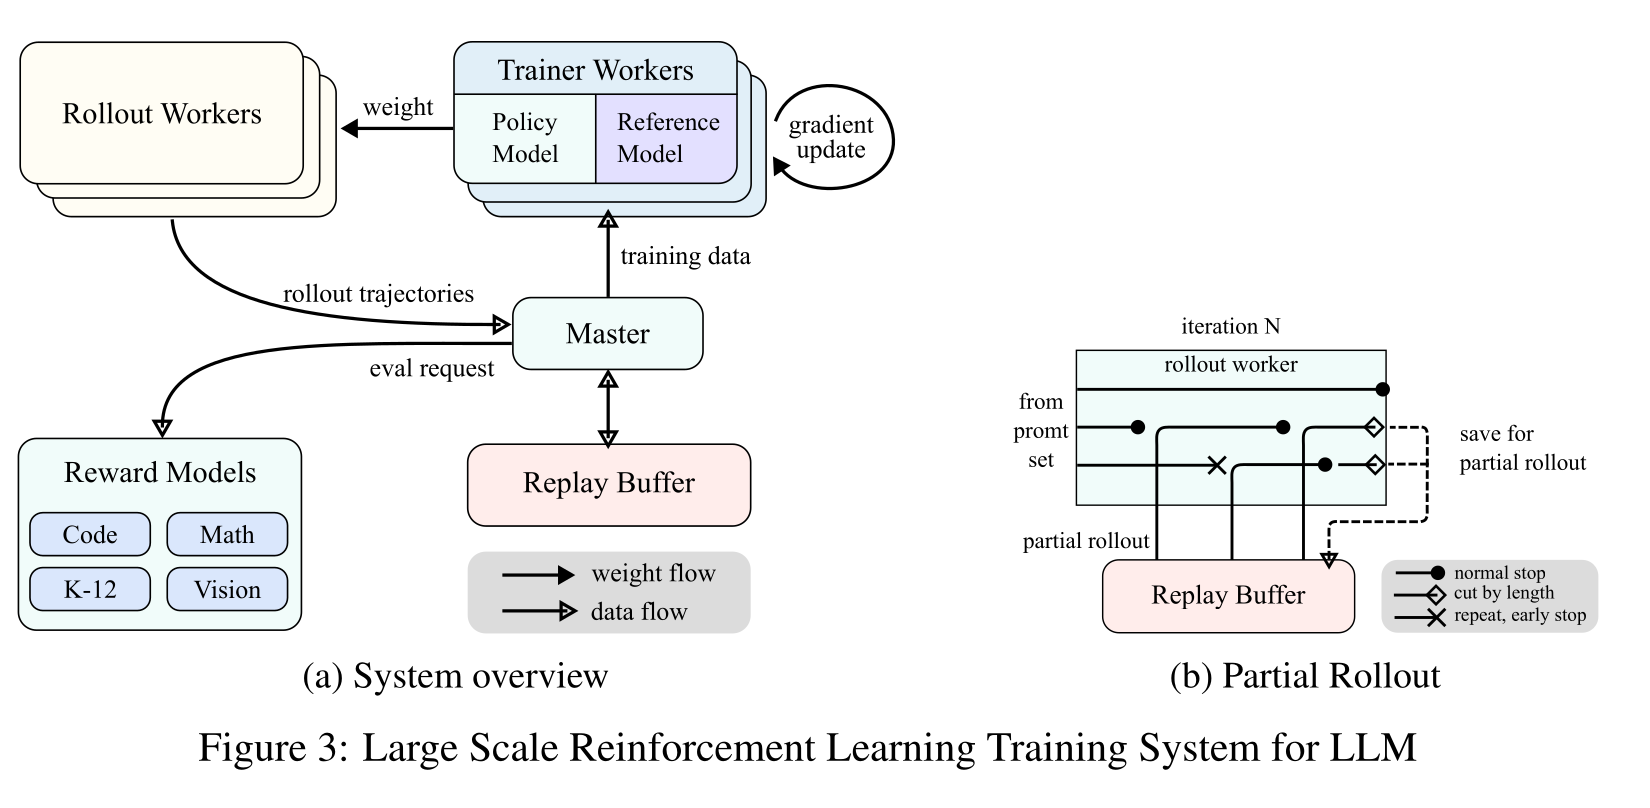
IMPALA 的 V-trace 是经典异步 actor–learner 校正;AReaL 讨论了大模型 RL 的异步训练系统;SAO 进一步面向长尾 agent rollout,使用单 rollout、critic 与 token 级行为概率控制更新。异步解决的是调度等待,不会自动解决稀疏奖励、状态覆盖或长时信用。若没有 wall-clock、利用率和 staleness 的共同证据,不能把训练步数提升解释成系统更快。
各方法的决策边界
SFT
适合作为工具协议、输出结构和基本行为的起点,也适合把搜索或人工筛选出的可靠轨迹蒸馏回模型。若部署时错误会把 agent 带到示范未覆盖的状态,仅靠 SFT 往往缺少恢复能力。最低限度应评测 closed-loop 成功率,而不只看示范集 token loss。
DPO
适合稳定的成对偏好、昂贵或高风险的在线环境。它对 reference policy、pair 构造方式和长度偏差敏感;完整 trajectory pair 还会把多次决策压成一个比较。若目标主要由可执行 verifier 决定,DPO 往往不是利用在线探索的最直接方式。
PPO
PPO 以旧策略概率比和 clipped surrogate 限制单批更新:
它适合需要 learned value、细粒度 advantage 和批内适度复用的任务。代价是 critic、旧策略概率、KL、终止语义与 batch reduction 必须同时正确。clip 约束的是 surrogate,不保证全局 KL、状态分布或安全动作都在界内;完整解释见 TRPO 与 PPO。
RLOO
适合同一 prompt 可生成少量可比候选、希望避免 learned critic 的情形。它比组均值 baseline 更清楚地区分当前样本和其他样本,但仍需 \(K\ge2\),也仍承受最慢候选 barrier。随机环境中,各候选的初始状态必须可比,否则环境噪声会被误当作策略差异。
GRPO
适合 reward 可验证、同 prompt 多采样便宜且 mixed-reward group 足够多的任务。组标准差有助于 prompt 间尺度统一,也会让低方差组退化。训练中应报告 all-correct、all-wrong、mixed group 比例,以及过滤无信号组消耗的全部 rollout token。
Critic-based asynchronous methods
适合每个环境状态只返回一条轨迹、episode 时长重尾、group barrier 已被 profiling 证实为主要瓶颈的系统。它用 critic 和行为概率治理换取流式消费能力。主要风险是 critic cold start、policy lag、陈旧数据选择偏差,以及采样处理器与 learner 重算分布不一致。它是一套联合设计,不是“把 PPO 队列改成异步”就完成了。
长程 Agent 的选择矩阵
| 任务形态 | 更自然的第一版 | 必须同时补上的设计 | 何时应换方向 |
|---|---|---|---|
| 专家轨迹丰富,工具协议尚未学会 | SFT | action mask、失败样本与闭环评测 | 开环模仿好但闭环错误累积 |
| 主观质量为主,在线试错昂贵 | DPO | pair 来源、reference、长度与覆盖审计 | 新策略频繁进入离线数据外状态 |
| 终态可精确验证,同题多候选便宜 | RLOO / GRPO | mixed-group 比例、完整采样预算 | 组内长期无方差或 barrier 过重 |
| 每个状态只能采一条,奖励很迟 | PPO / actor–critic | value pretraining、GAE 时间尺度、bootstrap | critic 长期失准且可靠组采样可得 |
| 工具调用时长重尾,learner 经常空转 | Critic-based async | behavior log-prob、lag 分桶、丢弃策略 | profiling 显示 barrier 并非主要成本 |
| 中间状态可独立核验 | Outcome + process signal | 独立终测、reward hacking 审计 | 过程分上涨而最终成功率下降 |
| 上下文频繁溢出 | 压缩或结构化 memory + 跨段 credit | summary 动作语义、segment 权重、信息保真 | 关闭压缩评测显著更强或关键信息丢失 |
| 行为具有不可逆风险 | 离线数据、sandbox、硬约束 | 权限门禁与人工审批 | 不应以扩大在线探索解决 |
一种常见但并非强制的路径是:先以 SFT 建立可执行行为,再以偏好数据校正主观质量,最后只在 reward 可靠、环境可控的部分引入在线 RL。每一步都应以独立评测决定是否继续,而不是把训练阶段越多视为越完整。
失败模式应沿轴定位
| 现象 | 更可能的原因 | 优先检查 |
|---|---|---|
| 训练 reward 上升,隐藏成功率下降 | verifier 漏洞、judge 耦合、过程奖励替代了终局目标 | 独立 evaluator、失败轨迹、高分错误四象限 |
| GRPO 梯度频繁接近零 | all-correct / all-wrong、组太小、reward 离散 | 组内方差、mixed-group 比例、采样温度 |
| PPO 初期稳定,随后突然漂移 | critic 落后、重复 epoch、KL 或 ratio 尾部失控 | advantage 分层、policy/behavior KL、clip fraction |
| 异步吞吐提高但能力不升 | 陈旧轨迹被大量截断或丢弃、状态分布偏移 | accepted token 比例、lag 分桶、有效训练 token |
| 长回答得到异常大权重 | sequence sum、segment 重复计数、错误分母 | token/response/prompt/episode 四种 reduction |
| 工具输出长度改变后 loss 改变 | observation 进入 action mask 或折扣时间轴 | token 对齐、mask、动作索引 |
| 长任务偏向提前终止 | timeout 当 terminal、成本惩罚过强、远端信用衰减 | 终止类型、bootstrap、按 horizon 的 advantage |
| 压缩后短期变强、关闭压缩变弱 | train–test representation mismatch | compacted / single-window 成对评测 |
完整的预算、数据漏斗和回归测试见强化学习实验与诊断。算法比较至少固定或报告 base checkpoint、prompt、环境、verifier、采样参数、rollout token、train token、过滤率、更新次数、超参数搜索预算与 wall-clock;只对齐 optimizer step 通常没有可比性。
一套可执行的选择顺序
- 定义成功与禁区:写清终态、失败、截断、环境故障和不可补偿约束。
- 验证反馈:先测 verifier / preference 与独立 outcome 的一致性,再优化它。
- 标出动作:确定 token、span、turn、tool call 与 observation 的边界。
- 确认数据制度:记录 behavior、current、old 与 reference policy 各自是谁。
- 按采样结构选 baseline:多候选便宜时先测 RLOO / GRPO;单轨迹或长时信用明显时引入 critic。
- 按真实瓶颈选时序:只有 profiling 证实同步等待主导成本时,才为异步承担 staleness 治理。
- 用受控基线否证复杂度:SFT、rejection sampling、同步实现和简单 Monte Carlo baseline 应与复杂方案共享预算比较。
- 逐轴做消融:不要同时更换 reward、denominator、group size、clip、数据过滤和系统并行度后,把总差异归给某个算法名。
算法最终还要与数据与环境、训练系统、评测与安全共同闭环。一个数学上合理的 estimator,如果没有可重建的 behavior distribution、稳定的环境语义和独立评测,仍然不是可验证的 Agentic RL 方法。
Reference
- Williams, Simple Statistical Gradient-Following Algorithms for Connectionist Reinforcement Learning。
- Schulman et al., High-Dimensional Continuous Control Using Generalized Advantage Estimation。
- Schulman et al., Proximal Policy Optimization Algorithms。
- Espeholt et al., IMPALA: Scalable Distributed Deep-RL with Importance Weighted Actor-Learner Architectures。
- Ng, Harada, and Russell, Policy Invariance under Reward Transformations。
- Ouyang et al., Training Language Models to Follow Instructions with Human Feedback。
- Rafailov et al., Direct Preference Optimization。
- Lightman et al., Let’s Verify Step by Step。
- Ahmadian et al., Back to Basics: Revisiting REINFORCE Style Optimization for Learning from Human Feedback。
- Shao et al., DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models。
- Fu et al., AReaL: A Large-Scale Asynchronous Reinforcement Learning System for Language Reasoning。
- Hou et al., Single-Rollout Asynchronous Optimization for Agentic Reinforcement Learning。
- Li et al., CompactionRL: Reinforcement Learning with Context Compaction for Long-Horizon Agents。