预测表征与生成世界
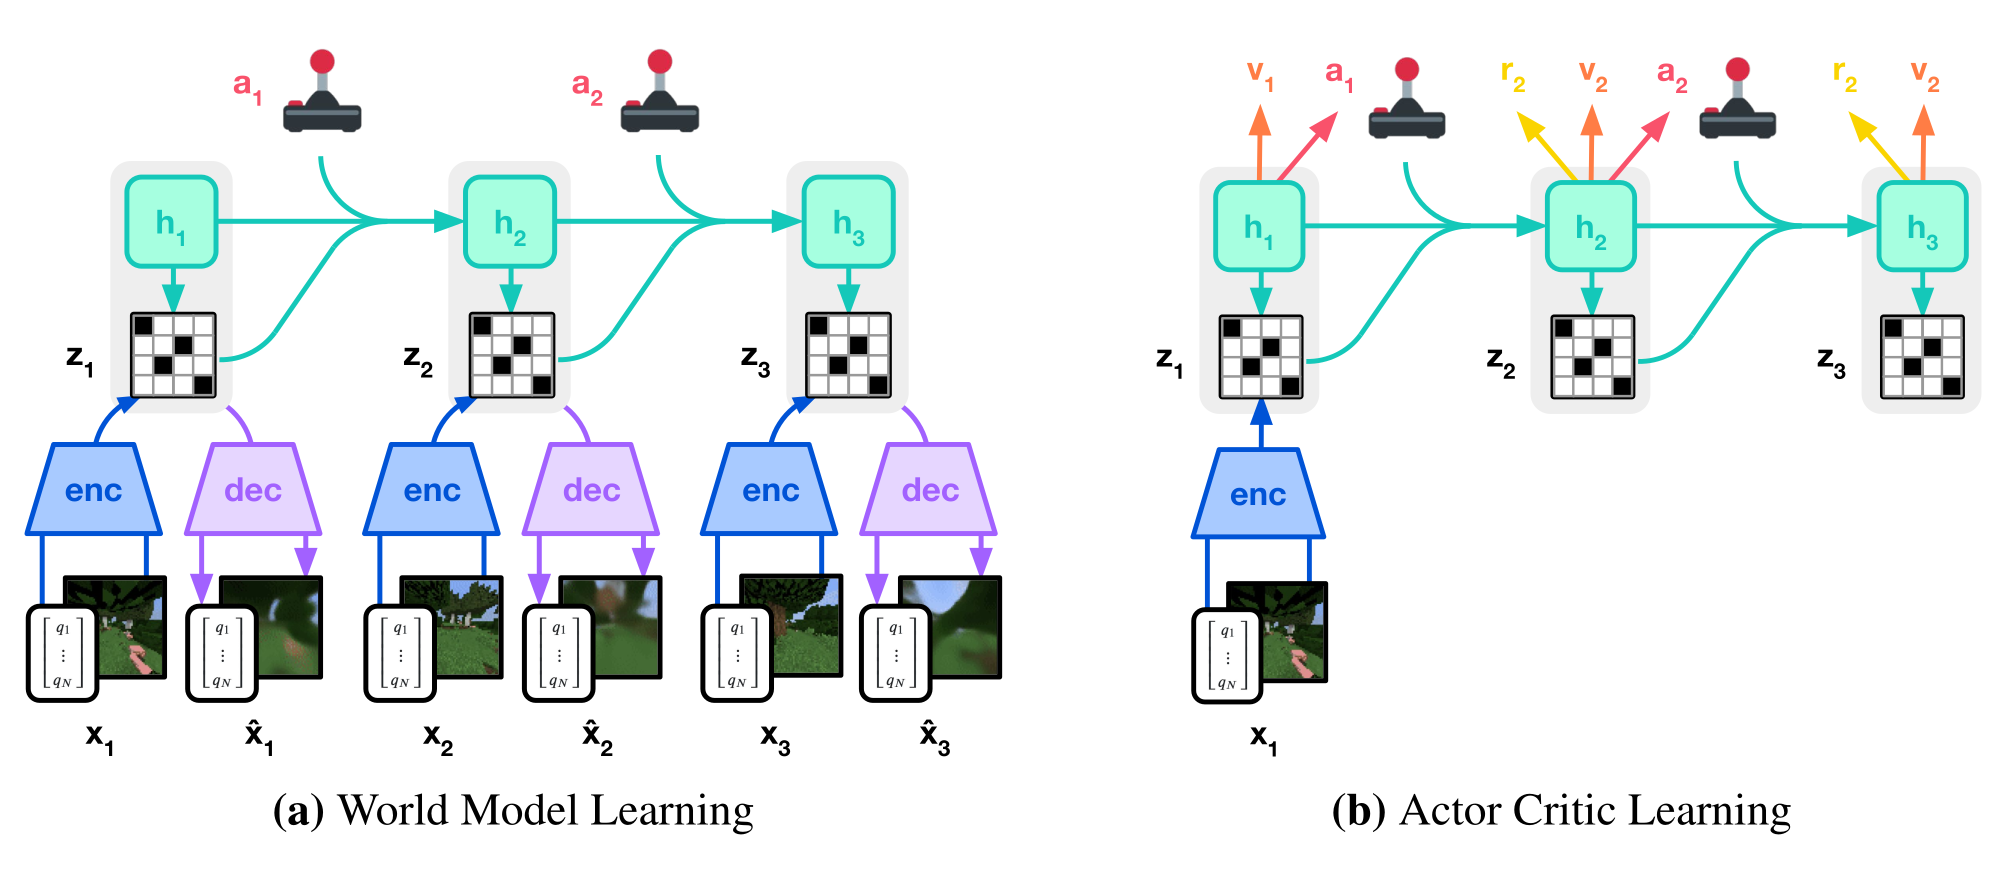
从互联网视频学习世界规律有一个诱人的前提:相机已经记录了海量运动、交互和事件结果。但视频只显示“发生了什么”,通常没有告诉模型“谁采取了什么动作”。这一页沿两条路线展开:
- 不重建全部像素,而预测对理解和规划有用的表示;
- 从无动作视频中推断 latent action,进一步生成可交互世界。
两条路线共同扩大数据规模,也共同面对因果不可识别与闭环验证。
像素预测为什么不是唯一答案
给定上下文 \(x_{\mathcal V}\) 与被遮区域 \(\mathcal M\),像素重建优化
它会为纹理、光照、传感器噪声和多个同样合理的未来付出损失。对于决策,很多细节并不重要;另一方面,抓取接触点、细小障碍和物体姿态又不能被“语义上差不多”替代。
因此预测空间是一种信息取舍:
| 目标 | 优势 | 容易丢掉 |
|---|---|---|
| pixel | 可视化直接、保留局部细节 | 多峰未来、计算量、不可预测纹理 |
| 离散视觉 token | 可用自回归或 masked modeling | tokenizer 量化与重建上限 |
| 连续 feature | 聚焦稳定语义、计算较轻 | feature 未编码的几何与接触 |
| 对象/3D 状态 | 结构清晰、利于组合规划 | 检测、跟踪和开放集误差 |
| reward/value | 决策直接 | 不支持目标外反事实与解释 |
不存在脱离任务的“最佳 latent”。应同时检查 reconstruction/probe、动作反事实和真实决策。
JEPA:预测目标编码器中的表示
I-JEPA 与 V-JEPA 不要求恢复目标像素,而让 context encoder 与 predictor 逼近 target encoder 的表示:
target encoder 常由 context encoder 的指数移动平均更新:
目标分支 stop-gradient、遮蔽策略和 predictor 容量共同防止退化解。低 loss 只说明 predictor 接近当前 target representation;若 encoder 没有表示速度、深度或接触,世界模型也无法凭空恢复它们。
从 action-free 到 action-conditioned
V-JEPA 2 先在超过一百万小时互联网视频与图像上做 action-free 表示学习,再冻结视频 encoder,用不足 62 小时的 DROID 机器人视频训练约 300M 的 action-conditioned predictor。论文中的 teacher-forcing 目标为
并加入短 autoregressive rollout:
论文训练 teacher forcing 时使用 15 个 transition,rollout loss 实际使用两步;部署时用 CEM 优化动作,并在 MPC 中每次只执行第一步。这些数字是该实现协议,不是 JEPA 的普遍常数。
最小 action-conditioned latent rollout
下面把复杂的 block-causal predictor 压成 step(z,s,a),只保留一个关键差别:teacher forcing 总是读取真实前一 latent,rollout 则读取自己的预测。真实 V-JEPA 2-AC 还读取完整历史与 spatial token。
import torch
import torch.nn.functional as F
def action_conditioned_loss(step, z, state, action, rollout_steps=2):
    if z.size(1) != action.size(1) + 1 or state.shape[:2] != action.shape[:2]:
        raise ValueError("expected z=[B,T+1,D], state/action=[B,T,*]")
    teacher = torch.stack(
        [step(z[:, t], state[:, t], action[:, t]) for t in range(action.size(1))],
        dim=1,
    )
    tf_loss = F.l1_loss(teacher, z[:, 1:])
    steps, current = min(rollout_steps, action.size(1)), z[:, 0]
    for t in range(steps):
        current = step(current, state[:, t], action[:, t])
    rollout_loss = F.l1_loss(current, z[:, steps])
    return tf_loss + rollout_loss
step = lambda z, s, a: z + a
z = torch.tensor([[[0.], [1.], [3.]]])
state = torch.zeros(1, 2, 1)
action = torch.tensor([[[1.], [2.]]])
assert action_conditioned_loss(step, z, state, action).item() == 0
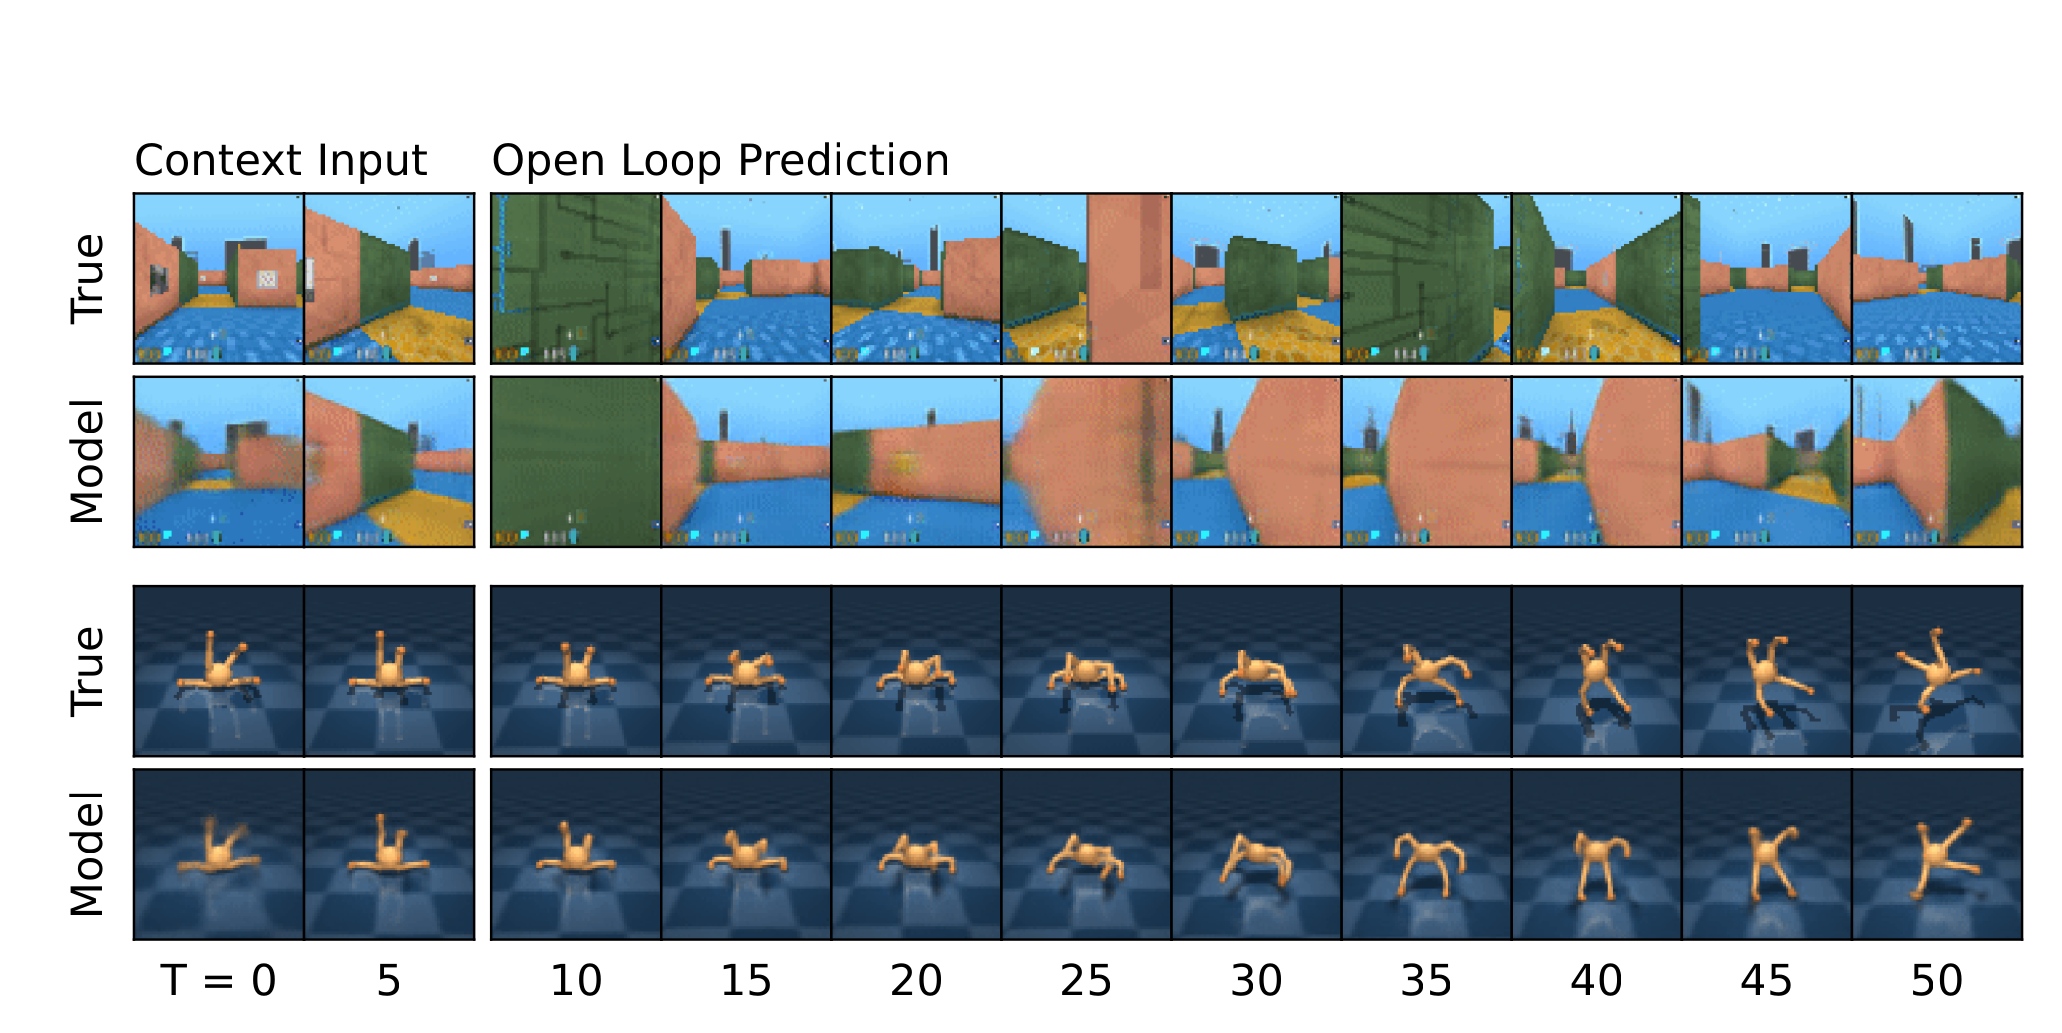
当 teacher-forcing loss 很低而 rollout loss 快速增长时,问题不是“再加一点数据”这么简单;需要检查状态充分性、预测随机性、历史长度、action timestamp 与 exposure bias。
V-JEPA 2.1:预测更稠密的空间状态
V-JEPA 2.1 于 2026 年公开,进一步对被遮和可见 patch 都施加 dense predictive loss,并加入深层自监督与 2D/3D 多模态 tokenizer。论文报告了更强的密集视觉与机器人规划结果,但这些仍是作者在特定数据和任务协议中的结果;新版本的独立复现和跨硬件鲁棒性不能由论文表格代替。
Latent action:从变化中猜测“做了什么”
无标签视频通常只有 \((x_t,x_{t+1})\),没有可执行动作 \(a_t\)。latent action model 尝试学习离散或连续变量
使 dynamics 能够重建变化:
Genie 用 latent action 表示可控游戏变化;LAPA 以 VQ 风格 action quantizer 先在无动作视频上预训练,再用少量机器人数据把 latent action 映射为真实动作。
这里存在三种不可识别性:
- 多个真实动作可能产生相同视觉变化;
- 相机运动、剪辑和环境外力可能被误当作 agent action;
- 同一 latent code 在不同机器人和坐标系中未必有一致语义。
因此 \(u_t\) 更准确的名称是“可控变化因子”。只有经过 embodiment-specific grounding
并在闭环中验证后,才能称为可执行动作。重建好邻帧不证明 action code 可组合、可持续或跨机器人迁移。
从视频生成到交互世界
Genie:把无标签游戏视频变成可操纵环境
Genie 1 组合时空 tokenizer、latent action model 与 autoregressive dynamics。它的重要转折是:训练视频不需要显式动作标签,也能产生有限的交互控制接口。
Genie 2 由 Google DeepMind 在 2024 年通过官方文章介绍为大规模 foundation world model,强调动作控制、长时一致和 3D 环境能力;公开材料不足以复原完整训练配方。
Genie 3 在 2025 年的官方研究预览中报告 720p、24 fps、数分钟实时交互,并允许 promptable world events。截至 2026-07-28,它仍是 limited research preview。官方同时列出限制:直接动作空间有限,多智能体交互、地理一致性、清晰文字和持续时长仍不足。没有公开 checkpoint 和完整 benchmark 时,应把数字写成发布方报告,而不是独立验证事实。
Cosmos:从视频平台走向全模态物理 AI
Cosmos World Foundation Model Platform 在 2025 年把视频 tokenizer、数据 curation、预训练与后训练组成一套 physical-AI 平台。Cosmos Predict 后续版本继续统一 Text2World、Image2World 与 Video2World。
Cosmos 3 于 2026 年 6 月公开,官方将其描述为语言、图像、视频、音频与动作统一的 omnimodal world model,覆盖理解、生成、policy 与 forward dynamics。它已有论文、代码、模型和数据入口,但发布时间很近;代码、权重和数据受 OpenMDW-1.1 等对应条款约束,不能统一简写为 Apache 或 MIT。
3D 世界不是长视频的自然副产品
显式 3D 场景需要相机、几何、遮挡与跨视角一致性。World Labs 在 2025 年公开的 Marble 提供从文本、图像、视频和粗 3D 输入生成、编辑并导出 3D 世界的产品接口。公开产品能力可以作为空间世界生成的一条证据,但其未公开训练数据、失败分布和内部模型保持未知。
怎样比较交互式世界
不能只比较分辨率和视频美感。更有效的矩阵是:
| 维度 | 问题 |
|---|---|
| Action control | 动作是否显式、延迟多大、同一动作是否可重复 |
| Counterfactual | 改变动作后,只有应改变的对象与状态发生变化吗 |
| Persistence | 对象、数量、属性、遮挡后重现能维持多久 |
| Geometry | 相机运动、深度、碰撞、拓扑是否一致 |
| Causality | 接触、重力、开关和不可逆事件是否延续 |
| Planning utility | 在模型中选出的动作能否改善真实/保留环境任务 |
| Runtime | fps、端到端交互延迟、硬件和上下文成本 |
| Reset/API | 状态能否保存、恢复、分支与复现 |
| Openness | 论文、代码、权重、数据、许可证分别公开到哪一层 |
一段成功 rollout 主要说明 existence,不说明成功概率。应报告随机种子、失败样例、交互时长分布、动作覆盖和用户挑选规则。
生成质量与世界一致性是不同坐标
文本到视频模型可写为
或在时空 latent 上用 diffusion/flow 联合生成。它可以产生逼真的运动,却仍可能:
- 让对象数量和身份漂移;
- 在遮挡后改变几何;
- 把相机运动误认为物体运动;
- 对同一动作给出不一致结果;
- 违反不可逆状态;
- 没有可查询的 reward、termination 与 reset。
因此 Sora、Veo 等视频生成工作可为视觉建模和物理现象提供材料,但“world simulator”应由动作干预、反事实、闭环规划和可恢复状态来验证。视频 diffusion、flow 与长时生成机制见生成建模和视频理解。
失效与评测
| 失效 | 需要的测试 |
|---|---|
| feature 丢掉几何 | position/depth/contact probe 与真实控制 |
| latent collapse | code usage、action diversity、干预 |
| camera/action 混淆 | 固定场景移动相机;固定相机改变动作 |
| rollout 累积 | one-step 与 free-rollout error–horizon |
| 背景跟随动作 | 局部动作反事实与非交互对象恒常性 |
| 逼真但不可控 | action replay、重复性、closed-loop success |
| demo cherry-picking | 完整 trial 分布、失败样例、固定 seeds |
| 系统不可交互 | 输入到画面延迟、jitter、持续时长 |
对于 action-conditioned 模型,还要明确动作发生在 \(o_t\) 之前还是之后、控制周期、坐标系与相机标定。V-JEPA 2 论文自己报告了对相机位置的敏感性,这正说明“从单目画面隐式推断机器人动作轴”不是天然稳健的接口。
动作怎样在真实机器人数据和策略中落地,见状态、动作与策略;视频、人类示范与机器人轨迹怎样连接,见 VLA 与数据谱系。
时空表示与 rollout 的组合测试见多模态手撕实现,规划语义见强化学习手撕实现。
Reference
- Assran et al., Self-Supervised Learning from Images with a Joint-Embedding Predictive Architecture
- Bardes et al., V-JEPA: Feature Prediction for Video Pre-Training
- Assran et al., V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning
- Bardes et al., V-JEPA 2.1: Unlocking Dense Features in Video Self-Supervised Learning
- Bruce et al., Genie: Generative Interactive Environments
- Ye et al., Latent Action Pretraining from Videos
- Google DeepMind, Genie 2: A Large-Scale Foundation World Model
- Google DeepMind, Genie 3: A New Frontier for World Models
- Agarwal et al., Cosmos World Foundation Model Platform for Physical AI
- NVIDIA, Cosmos 3: An Omnimodal World Model
- World Labs, Marble: A Multimodal World Model